
Tutorial
flux-3-video Anwendungsszenarien in der Praxis: 5 wertvolle Einsatzmöglichkeiten und Umsetzungshinweise
Von drei Eingabemodi zu 5 Praxisszenarien – inklusive Kosten- und Fehlerbehebungs-Checkliste
Warum man die drei Videogenerierungsmodi bereits in der Auswahlphase unterscheiden sollte
Auf den ersten Blick wirkt ein Videomodell wie „eine Beschreibung eingeben, ein Video ausgeben“, doch flux-3-video bietet gleichzeitig drei Eingabemodi: text-to-video, image-to-video und video-to-video. Diese drei Wege unterscheiden sich erheblich in Produktsemantik, Materialanforderungen, Fehlermustern und Kostenstruktur. Wenn man in der Auswahlphase nicht sauber trennt, ist die häufigste Folge: Die Schnittstelle ist angebunden, die Demo läuft, aber erst bei der echten Integration in das Geschäft stellt man fest, dass die Materialkette nicht passt – und muss alles neu aufsetzen.
Eingabe- und Ausgabevertrag der drei Modi
- text-to-video: Die Eingabe ist ein reiner Text-Prompt, die Ausgabe ein vom Modell frei generiertes Video. Es braucht keinerlei Vorlagen, die kreative Obergrenze ist hoch, aber die Kontrollierbarkeit am geringsten – bei mehrfachem Aufruf desselben Prompts divergiert der Bildinhalt naturgemäß. Geeignet für Szenarien, in denen „kein Material verfügbar ist“ oder „viele nicht wiederholende Bilder benötigt werden“.
- image-to-video: Die Eingabe ist ein (oder eine Gruppe von) Referenzbild(ern) plus Text-Prompt, die Ausgabe ein Video mit diesem Bild als visuellem Anker. Die Kontrollierbarkeit kommt aus dem Bild selbst: Bildsubjekt, Komposition und Farbton sind durch das Bild fixiert, das Modell verleiht die Bewegung. Geeignet für Teams mit bestehendem Bildarchiv, die eine konsistente Markenvisualität wahren müssen.
- video-to-video: Die Eingabe ist ein Quellvideo plus Konvertierungsanweisung, die Ausgabe behält die zeitliche Struktur und den Bewegungsrhythmus des Quellvideos bei, schreibt aber Stil oder Spezifikation um. Es ist der am stärksten „engineering-orientierte“ Weg, weil die Dauerstruktur von Ein- und Ausgabe vorhersehbar ist und sich gut für Stapelverarbeitung und Abnahme eignet.
Die Frage „Existiert Material?“ als erste Weichenstellung
Die schnellste Weichenstellung in der Praxis ist nicht die technische Fähigkeit, sondern die Frage: Welches Material hat das Geschäft aktuell zur Hand?
Wenn kein Material vorhanden ist und nur Texte und kreative Richtung existieren, ist text-to-video der kostengünstigste Einstieg; gibt es statische Assets wie Produktbilder, Poster oder Illustrationen, lässt sich mit image-to-video die Wiederverwendungsrate dieser Assets deutlich erhöhen; erst wenn fertige Filme existieren und eine Mehrkanal-Anpassung oder Stilvereinheitlichung nötig ist, ist video-to-video das richtige Feld. Umgekehrt gilt: Wenn ein Team nur Text hat und trotzdem auf video-to-video setzt, oder nur fertige Filme hat und bestehende Inhalte mit text-to-video nachbilden will, kommt es in der Abnahme zu wiederholten Nacharbeiten.
Abwägung zwischen Kontrollierbarkeit und Iterationskosten
Die Iterationskosten der drei Modi sind unterschiedlich. Bei text-to-video erfordert jede Anpassung eine Neugenerierung über geänderte Prompts – hohe Fehlerkosten, aber niedrige Einstiegshürde pro Aufruf; bei image-to-video liegt der Anpassungshebel im Bild, ein Bildwechsel ist oft wirksamer als eine Textänderung; bei video-to-video ist die Anpassung am lokalsten, meist muss nur angegeben werden, was geändert werden soll. Wenn man bei der Auswahl berücksichtigt, „wie viele Runden ein Material voraussichtlich durchläuft“, kommt man den realen Umsetzungskosten näher als beim reinen Wirkungsvergleich.
Nachdem diese drei Grenzen klar sind, lassen sich die folgenden fünf Szenarien jeweils zuordnen.
Szenario 1: Massenproduktion von Produkt- und Marketing-Kurzvideos
Dies ist die Szenarioklasse mit dem direktesten Input-Output-Verhältnis für Videomodelle: Produktmaterial und Marketingtexte in großem Umfang in Kurzvideos umwandeln, für Feed-Werbung, Produktdetailseiten und Social-Media-Distribution. Der traditionelle Prozess erfordert mehrere Schritte – Dreh, Schnitt, Vertonung –, die Modellgenerierung komprimiert diese Kette zu „Material + Prompt → fertiges Video“.
Welchen Modus wählen
Teams mit Produktbildern nutzen vorzugsweise image-to-video: Das Produkt-Hauptbild dient als Anker, die Szene erzeugt langsame Umkreisung, Licht- und Schattenfluss oder Szenenwechsel, das Produktsubjekt verformt sich nicht, die Markenvisualität bleibt konsistent. Bei reinen Neuprodukten oder Konzeptmodellen, für die nicht einmal Bilder existieren, erzeugt man mit text-to-video zunächst ein Konzept-Stimmungsvideo als Präsentation vor dem Dreh.
Engineering-Punkte für die Batch-Verarbeitung
Das Wesen der Batch-Verarbeitung ist nicht der „Schleifenaufruf“, sondern die Parametrisierung der variablen Teile. Empfohlen wird, ein Produktvideo in drei Schichten zu zerlegen:
- Unveränderliche Schicht: Markenfarbton, Bildformat, verbotene Elemente – in einen einheitlichen Prompt-Präfix schreiben.
- Variable Schicht: Produktname, Verkaufsargumente, Szenenbeschreibung – zeilenweise aus der Produktdatentabelle injiziert.
- Nachbearbeitungsschicht: Intro/Outro, Untertitel, Wasserzeichen – besser nach der Generierung auflegen, um nicht bei jeder Generierung erneut Dauer zu verbrauchen.
Batch-Aufgaben über eine Warteschlange steuern; ein fehlgeschlagener einzelner Auftrag darf nicht den gesamten Batch blockieren; für jeden Datensatz Prompt, Materialkennung und Ausgabeadresse speichern, um nachvollziehen zu können, welche Materialversion besser wirkt.
Abnahmekriterien
Die Abnahme der Massenproduktion muss quantifizierbar sein: Ist das Produktsubjekt erkennbar, gibt es offensichtliche Verformungen, erscheinen unerwünschte Textfehler im Bild, entspricht die Dauer den Limits der Werbeplattform. Empfohlen wird, zunächst eine kleine Charge manuell zu prüfen, die Prompt-Vorlage als stabil zu bestätigen und erst dann die Menge freizugeben.
Szenario 2: Image-to-Video zur Animierung statischer Materialien
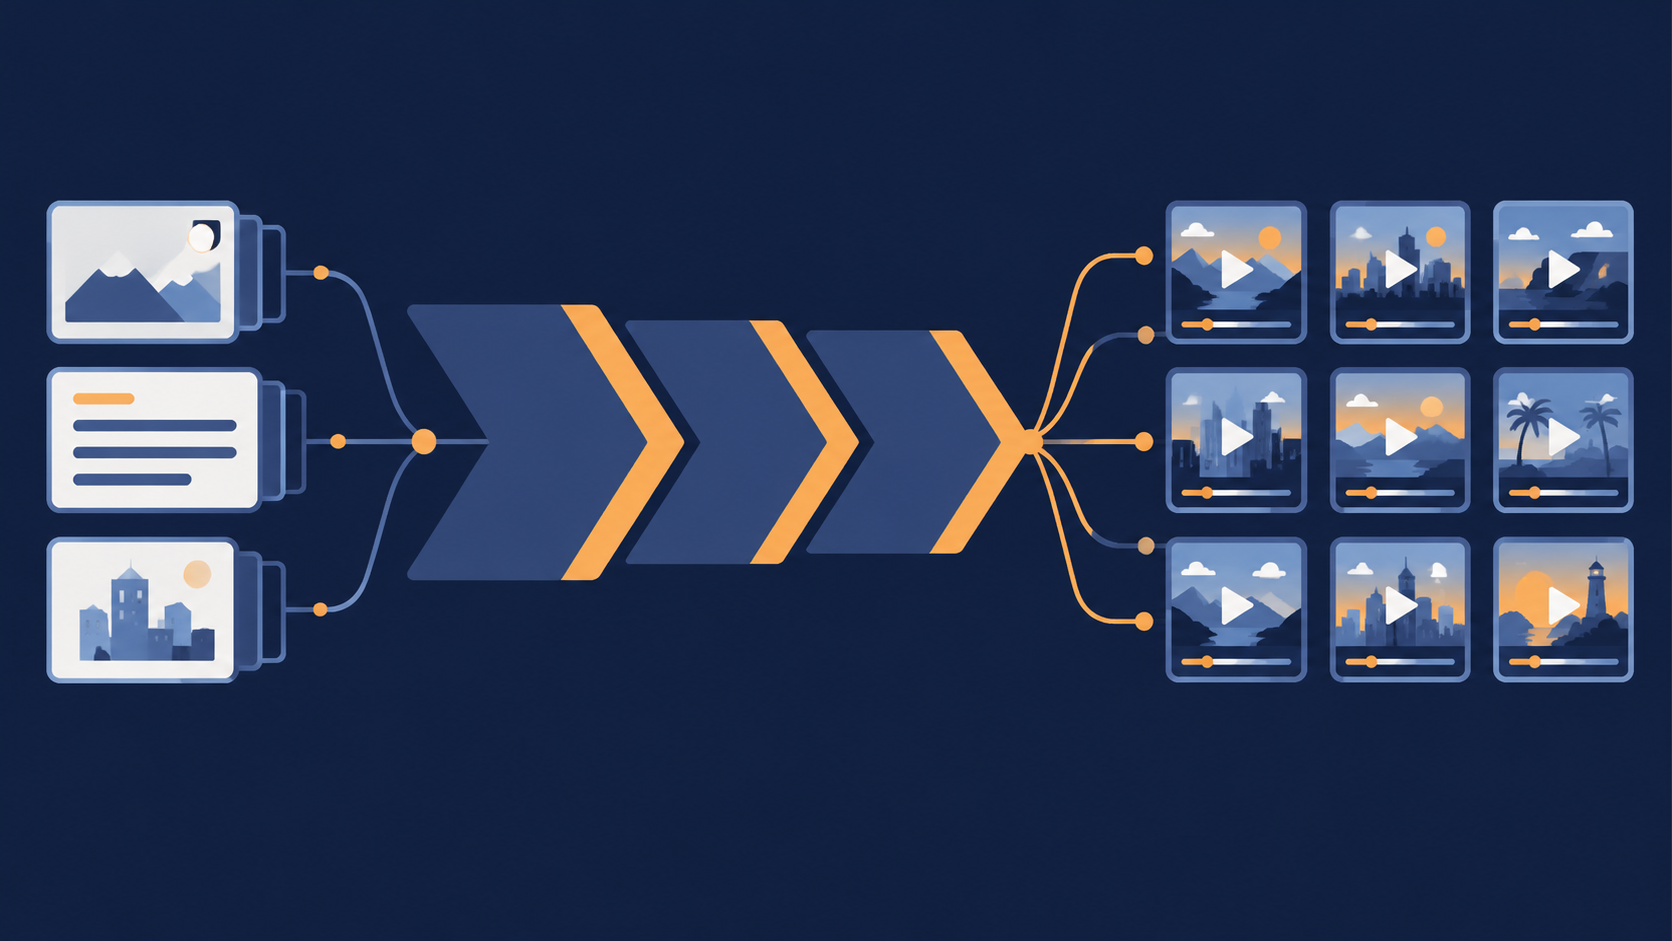
Viele Teams haben keine Videomaterialien, aber ein großes Archiv statischer Assets: Produktbilder, Illustrationen, Poster, Kurscover, Kampagnen-Keyvisuals. Diese Materialien sind in Feeds naturgemäß im Nachteil – statische Bilder werden in automatisch abspielenden Feeds oft einfach überscrollt. Sie zu animieren ist die Einsatzmöglichkeit mit dem geringsten Aufwand und dem schnellsten Effekt.
Wo der Wert liegt
Der Kernnutzen der Animierung ist nicht „es sieht besser aus“, sondern die Erhöhung von Verweildauer und Klicks im Feed. Ein aus demselben Hauptbild abgeleitetes Kurzvideo kann eigenständig als Werbematerial am AB-Test teilnehmen und erschließt damit auf demselben Material-Asset eine zusätzliche Testdimension. Für bildarchivbasierte Geschäfte (E-Commerce, Content, Bildung) bedeutet das, den Restwert historischer Materialien neu freizusetzen.
Umsetzungshinweise
- Bewegungsamplitude zurückhaltend. Die häufigste Panne bei Image-to-Video ist eine zu große Amplitude, die das Subjekt verzerrt. Im Prompt sollten Einschränkungen wie „leicht“, „langsam“ explizit stehen und die Bewegungsquelle beschrieben werden (Kamerafahrt, Licht- und Schattenwechsel, lokales Schweben von Elementen), statt pauschal „es soll sich bewegen“ zu verlangen.
- Das erste Frame ist das Cover. Im Feed wird zuerst das erste Videoframe gesehen; bei der Bildauswahl sollte man deshalb danach filtern, „ob dieses Bild allein als Cover funktioniert“, nicht nach einem Bild, das erst in Bewegung gut aussieht.
- Komposition mit Freiraum. Ist das Originalbild voll ausgefüllt, werden nach der Bewegung leicht Randinformationen abgeschnitten; bevorzugt Materialien mit zentriertem Subjekt und Randreserve wählen.
Wie der Nutzen bewertet wird
Empfohlen wird eine Bewertung anhand zweier Dimensionen: „Material-Wiederverwendungsrate“ und „Testkosten pro Material“ – welcher Anteil eines Bestandsbilderpools sich für die Animierung eignet, und um wie viel die Generierungskosten pro animiertem Material im Vergleich zu einer Neuproduktion gesunken sind. Sobald diese beiden Zahlen stimmen, machen bildarchivbasierte Teams daraus meist einen regulären Materialproduktionsprozess statt eines einmaligen Experiments.
Szenario 3: Video-to-Video zur Stil- und Formatadaption von Material
Wenn ein Team bereits ein starkes Videomaterial hat, wird die eigentliche Frage oft: Wie passt man es an alle Kanäle an. Querformat zu Hochformat, Langfilm zu Kurzclip, einheitlicher visueller Stil, lokalisierte Versionen für verschiedene Regionen – diese Arbeiten erledigt traditionell ein Cutter Stück für Stück, video-to-video macht diesen Schritt zu einer orchestrierbaren Stapelverarbeitung.
Typische Einsatzmöglichkeiten
- Ein Master, viele Kanäle: Ein Hauptfilm als Quelle, batchweise Versionen für verschiedene Werbeplätze erzeugen, Rhythmus und Erzählstruktur des Originals beibehalten, nur Bildformat und Kompositionsschwerpunkt ändern.
- Stilvereinheitlichung: Historische Materialien mit uneinheitlicher Tonalität auf den aktuellen Markenstil vereinheitlichen, um visuelle Brüche im Materialarchiv zu reduzieren.
- Formatadaption: Einheitliche Umschreibung für die Anforderungen verschiedener Plattformen an Dauer, Bildformat und Auflösung.
Einschränkungen vorab klären
Die Ausgabe von video-to-video unterliegt der stärksten Bindung an das Quellvideo: Dauer, Bewegungskomplexität und Bildqualität der Quelle übertragen sich auf die Ausgabe. Daher muss vor dem Go-live zuerst die Anforderung des Geschäfts an maximale Ausgabedauer und Bildformat geklärt werden, bevor entschieden wird, wie die Quelle geschnitten wird. Besonders beim Kürzen von Lang- zu Kurzfilmen sollte man zuerst auf der Quellseite grob schneiden, statt den ganzen Langfilm an das Modell zu geben, damit es selbst auswählt – das Modell versteht deine Erzählschwerpunkte nicht.
Batch-Design
Eine Konvertierung als Tripel „Quellvideo-ID + Zielformat + Stilanweisung“ abstrahieren und in eine Aufgabentabelle überführen. Jeder Zielkanal eine Zeile, die Generierungsergebnisse kanalweise benannt archivieren. So ist ein neuer Kanal nur eine zusätzliche Konfigurationszeile, statt den Schnittprozess erneut zu durchlaufen. Gleichzeitig die Zuordnung von Quelle zu Ausgabe erhalten, um bei schlechtem Kanal-Feedback lokalisieren zu können, welche Art der Umschreibung das Problem verursacht hat.
Szenario 4: Schnelle Videoproduktion für Produktdemos und Feature-Ankündigungen
SaaS- und Tool-Teams haben einen langjährigen Schmerzpunkt: Bei jedem Release muss ein Demo-Video her, aber Screencast-Material muss oft warten, bis das Produkt stabil ist, das Skript bis zur Marketing-Freigabe – am Ende verzögert das Video den Release. Videomodelle können die erste Version eines „Demovideos“ von Tagen auf Stunden komprimieren.
Empfohlener Ablauf
- Skript in Einstellungen zerlegen: Eine Produktdemo in mehrere Einstellungen von etwa 5 Sekunden zerlegen, jede Einstellung entspricht einem Feature oder einem Nutzungsszenario. Die Zerlegung in Einstellungen ist hier der Schlüssel, weil das Modell kurze Einstellungen deutlich besser inhaltlich kontrolliert als lange Erzählungen.
- Text- und Bild-Mix zur Videogenerierung: Abstrakte Funktionen (z. B. Datenfluss, Kollaborationsprozesse) mit text-to-video als Konzeptbilder erzeugen; echte Oberflächen und Produktformen mit image-to-video, mit Screenshot oder Designentwurf als Anker, um das nach außen gezeigte Produktbild nicht zu verfälschen.
- Zusammenfügen und Vertonen: Die generierten Segmente in der Postproduktion zusammenfügen, mit Voiceover, Untertiteln und Übergängen versehen. In der Generierungsphase nicht „alles in einem Durchgang“ anstreben – das ist schwer kontrollierbar und teuer.
Manuelle Prüfung ist unverzichtbar
Die erste Pflicht eines Produktdemovideos ist, Nutzer nicht in die Irre zu führen. Vom Modell generierte Bilder können nicht existierende Buttons, falsche Oberflächenlayouts oder erfundene Funktionen zeigen. Daher muss jede generierte Version manuell durch das Produktteam geprüft werden, um zu bestätigen, dass die im Bild erscheinenden Elemente im echten Produkt existieren oder ausdrücklich als schematisch gekennzeichnet sind. Empfohlen wird, „Prüfung der Bildelemente“ als festen Prüfpunkt zu formulieren, statt beim Schnitt beiläufig einen Blick darauf zu werfen.
Grenzen der Eignung
Dieser Weg eignet sich für Feature-Ankündigungen, Konzeptdemos, Countdown-Material für Releases und interne Präsentationsfilme; nicht für Tutorials, die Bedienschritte exakt nachbilden müssen. Tutorial-Inhalte sollten weiterhin auf echten Screencasts basieren, die Modellgenerierung nur für Verpackung und Übergänge genutzt werden.
Szenario 5: Dynamisches Material und kreative Experimente für Content-Plattformen
Content- und Growth-Teams haben einen anderen Bedarf als die ersten vier Klassen: Ihnen fehlt nicht ein gutes Material, sondern viele testbare Richtungen. Die sekundengenaue Abrechnung von Videomodellen passt genau zu diesem Rhythmus des kleinformatigen Ausprobierens – kurze Segmente, viele Richtungen, schnelles Aussortieren.
Experimente als geschlossenen Kreis gestalten
Ein nachhaltiger kreativer Experimentierprozess sieht meist so aus: Ausgehend von einem Thema oder Trend mehrere Kurzsegmente auf einmal generieren, jedes für eine andere visuelle Richtung oder Erzählperspektive; nach der Auslieferung die frühen Daten betrachten, Richtungen mit Ansatz weiter iterieren, den Rest direkt verwerfen. Entscheidend ist, dass die Batch-Größe pro Experimentrunde klein und jedes Segment kurz ist, damit die Kosten pro Runde niedrig genug sind, um hochfrequent zu wiederholen.
Drei Engineering-Empfehlungen
- Variablen fixieren: Pro Experimentrunde nur eine Dimension ändern (Bildstil, Eröffnungsweise oder Rhythmus), sonst lassen sich die Daten nicht zuordnen.
- Prompts protokollieren: Für jedes Segment Prompt und Parameter archivieren – bei gutem Effekt reproduzierbar, bei schlechtem Effekt ausschließbar.
- Kurze Segmente bevorzugen: In der Experimentphase kurze Dauern generieren; erst wenn eine Richtung bestätigt ist, die Gewinnerrichtung verlängern und ausweiten.
Geeignet und ungeeignet
Geeignet für Eröffnungshooks, Stimmungssegmente, Themenvisuals, Cover-Animationen; ungeeignet für lange Inhalte mit durchgängiger Erzählung. Wenn man das Modell als „kreative Sonde“ statt als „Content-Produktionslinie“ positioniert, sind Erwartungen und Abnahmekriterien des Teams gesünder.
Kostenschätzung und Aufrufstrategie bei sekundengenauer Abrechnung
Die Abrechnung von Videomodellen erfolgt nach ausgegebenen Sekunden, das heißt, die Kosten hängen direkt an „Dauer × Anzahl“. Die konkreten Preise entnimmt man bitte dem Preispaneel der Website; hier geht es nur um Umrechnungsmethoden und Steuerungsmaßnahmen.
Abrechnung in Kosten pro Geschäftsvorgang umrechnen
Die Formel ist einfach: Kosten pro Stück = Ausgabesekunden × Preis pro Sekunde. Darauf multipliziert man den geschäftsseitigen Faktor – ein Werbematerial läuft meist in mehreren Versionen für AB-Tests, die tatsächlichen Kosten sind „Kosten pro Stück × Versionszahl × Iterationsrunden“. Genau die letzten beiden Multiplikatoren werden von den meisten Teams unterschätzt: wiederholte Generierungen vor der Finalisierung des Effekts sind oft viel teurer als die wenigen final gelieferten Stücke.
Vier Hebel zur Kostenkontrolle
- Dauer drücken: Zuerst mit kurzen Segmenten die Richtung validieren, nach der Finalisierung die volle Dauer generieren. Das ist das wirksamste Sparmittel, weil die Kosten linear zur Dauer sind.
- Iterationen kontrollieren: Die Prompt-Vorlage zuerst in kleinen Chargen stabilisieren, dann skalieren. Batch-Generierung mit instabiler Vorlage ist nahezu reine Verschwendung.
- Phasenweise: In der Explorationsphase ist Divergenz erlaubt, in der Produktionsphase müssen Parameter fixiert sein. Beide Phasen nutzen unterschiedliche Chargengrößen und Abnahmekriterien.
- Parallelität berechnen: Das Parallelitätslimit von Batch-Aufgaben sollte mit einem Budgetlimit kombiniert werden; für jede Charge einen Kostenschwellenwert setzen, bei Überschreitung pausieren und manuell bestätigen, um aus dem Ruder laufende Skripte zu vermeiden.
Aufrufstrategie festlegen
Empfohlen wird, im Geschäftscode sowohl „Dauer“ als auch „Anzahl“ als konfigurierbare Werte zu gestalten statt fest zu verdrahten. So kann man bei knapperem Werbebudget die Kosten pro Charge allein durch Konfigurationsänderung senken, ohne Code zu ändern. Gleichzeitig Dauer und Anzahl jedes Aufrufs ins Log schreiben, um eine prüfbare Kostenabrechnung zu erhalten, die sich nach Projekt oder Kanal aufteilen lässt.
Integrations-Fehlerbehebung und Checkliste vor dem Go-live
Fehler bei Video-Schnittstellen sind oft nicht „Fehlermeldungen“, sondern „Langsamkeit“ und „Instabilität“. Geht man vor dem Go-live die folgenden Punkte durch, lassen sich die meisten Online-Probleme abfangen.
Häufige Fehlermuster
- Timeouts: Die Videogenerierung dauert deutlich länger als Text und Bild, der Standard-Timeout des Clients reicht leicht nicht aus. Das Request-Timeout sollte auf eine zur Videodauer passende Größenordnung gesetzt und statt synchronem Warten ein asynchrones Aufgaben- + Polling-Modell verwendet werden.
- Doppelte Übermittlung: Automatische Wiederholungen bei Netzwerkschwankungen können doppelte Generierungen verursachen und die Kosten direkt vervielfachen. Für jede Aufgabe einen Idempotenzschlüssel erzeugen, der Server dedupliziert nach Idempotenzschlüssel.
- Inhalte nicht regelkonform oder unbrauchbar: Die Ausgabe kann Subjektverformungen, fehlerhaften Text oder nicht geschäftskonforme Bilder enthalten. Solche Probleme werfen keine Ausnahme, sie lassen sich nur in der Abnahmephase abfangen.
- Probleme mit Eingabematerial: Zu geringe Auflösung oder zu volle Komposition der Referenzbilder bei Image-to-Video, zu geringe Bitrate der Quelle bei Video-to-Video – all das senkt die Ausgabequalität deutlich. Die Materialseite sollte vor dem Eintritt in die Warteschlange validieren.
Design von Timeout, Retry und Degradation
Retries brauchen Grenzen: Nur bei eindeutigen Netzwerkfehlern und 5xx wiederholen, mit maximaler Anzahl und Backoff-Intervall; bei inhaltlichen Fehlern kein automatisches Retry, sondern manuelle Übergabe. Degradationspläne müssen vorab durchdacht sein – ob bei Generierungsfehler auf statisches Material, auf die letzte brauchbare Version zurückgegriffen oder die Aufgabe einfach übersprungen wird, ist je nach Geschäftslinie unterschiedlich, sollte aber in der Designphase festgelegt werden.
Checkliste vor dem Go-live
- Ist die asynchrone Aufgabenkette vollständig: Übermittlung, Polling, Timeout, Idempotenz, Ergebnispersistenz.
- Sind Dauer und Anzahl konfigurierbar, gibt es einen Kostenschwellenwert pro Charge.
- Wurden Eingabematerialien auf Auflösung und Format validiert.
- Gibt es eine manuelle oder automatische Abnahmephase für die Ausgabe, sind die Abnahmekriterien quantifiziert.
- Protokollieren die Logs Prompt, Parameter, Dauer und Aufgabenstatus, ist eine Rückverfolgung möglich.
- Wurde der Degradationspfad geübt, statt nur in der Dokumentation zu stehen.
Behandelt man diese Checkliste als Release-Gate, ist der Go-live-Rhythmus von Videofunktionen deutlich stabiler als beim Reparieren während des Laufs. Wer die Fähigkeitsgrenzen von flux-3-video weiter erkunden möchte, kann zunächst auf der Modellseite eine minimale Kette zum Laufen bringen und dann entsprechend den obigen Szenarien schrittweise erweitern.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses