
Tutoriale
flux-3-video in scenari reali: 5 utilizzi ad alto valore e punti chiave per l'implementazione
Dalle tre modalità di input a 5 scenari applicativi, con checklist di costi e troubleshooting
Perché distinguere le tre modalità di generazione video già in fase di selezione
Un modello video sembra solo «dai un prompt, ottieni un video», ma flux-3-video offre contemporaneamente tre modalità di input: text-to-video, image-to-video e video-to-video. Questi tre percorsi differiscono molto per semantica di prodotto, requisiti dei materiali, modalità di fallimento e struttura dei costi. Se in fase di selezione non si distinguono, la conseguenza più frequente è: l'API è collegata, la demo funziona, ma quando si integra davvero nel business ci si accorge che la pipeline dei materiali non corrisponde e bisogna ricominciare da capo.
Il contratto di input e output delle tre modalità
- text-to-video: l'input è un prompt puramente testuale, l'output è un video generato liberamente dal modello. Non richiede alcun materiale preliminare, il limite creativo è alto ma la controllabilità è minima: chiamando più volte lo stesso prompt, il contenuto visivo diverge naturalmente. Adatto a scenari in cui «non ci sono materiali disponibili» o «servono molte immagini non ripetute».
- image-to-video: l'input è una (o un set di) immagine di riferimento più un prompt testuale, l'output è un video che usa quell'immagine come ancora visiva. La controllabilità deriva dall'immagine stessa: soggetto, composizione e tonalità sono bloccati dall'immagine, il modello si occupa di dare movimento. Adatto a team che hanno già una libreria di immagini e vogliono mantenere la coerenza visiva del brand.
- video-to-video: l'input è un video sorgente più istruzioni di conversione, l'output conserva la struttura temporale e il ritmo di movimento del video sorgente, ma riscrive stile o specifiche. È il percorso più «ingegnerizzato», perché la struttura di durata di input e output è prevedibile, il che facilita l'elaborazione in batch e la validazione.
Usare «il materiale esiste già?» come primo filtro
In pratica il filtro più rapido non è guardare le capacità tecniche, ma chiedere: quali materiali ha ora in mano il business?
Senza alcun materiale, solo copy e direzione creativa, partire con text-to-video è la soluzione meno costosa; con immagini prodotto, poster, illustrazioni e altri asset statici, image-to-video può aumentare sensibilmente il riutilizzo di questi asset; con filmati già pronti di cui serve l'adattamento multicanale o l'uniformazione dello stile, allora è il terreno di video-to-video. Viceversa, se il team ha solo testo ma forza video-to-video, o ha solo filmati pronti ma spera di replicare contenuti esistenti con text-to-video, si finirà per rifare più volte la validazione.
Il compromesso tra controllabilità e costo di iterazione
I costi di iterazione dei tre non sono uguali. Con text-to-video ogni aggiustamento richiede di cambiare il prompt e rigenerare: alto costo di tentativi ed errori ma bassa soglia per la singola chiamata; con image-to-video la leva di aggiustamento è l'immagine, cambiare immagine è spesso più efficace che cambiare parole; con video-to-video l'aggiustamento è il più localizzato, di solito basta indicare cosa modificare. Includere nel processo di selezione «quanti giri di modifica prevediamo per un materiale» avvicina di più al costo reale di implementazione che confrontare solo i risultati.
Chiariti questi tre confini, i cinque scenari seguenti possono trovare ciascuno il proprio posto.
Scenario 1: produzione in batch di video brevi per prodotto e marketing
Questo è lo scenario in cui il rapporto tra investimento e resa del modello video è più diretto: convertire in batch materiali prodotto e copy di marketing in video brevi, da usare per campagne a pagamento, pagine di dettaglio prodotto e distribuzione sui social. Il processo tradizionale richiede ripresa, montaggio e musica in più fasi, mentre la generazione con il modello comprime la catena in «materiale + prompt → video».
Quale modalità usare
I team con immagini prodotto usano preferibilmente image-to-video: con l'immagine principale del prodotto come ancora, si fa generare alla scena una lenta rotazione, un flusso di luce o un cambio di ambientazione, il soggetto del prodotto non si deforma e la visione del brand resta coerente. Per prodotti del tutto nuovi o concept, quando non c'è nemmeno un'immagine, si usa text-to-video per generare prima un video d'atmosfera concettuale, come presentazione del piano prima delle riprese.
Punti ingegneristici della batch
L'essenza del batch non è «chiamare in loop», ma parametrizzare le parti variabili. Si consiglia di scomporre un video prodotto in tre livelli:
- Livello immutabile: tonalità del brand, proporzioni dell'immagine, elementi vietati, scritti in un prefisso di prompt unificato.
- Livello variabile: nome del prodotto, punti di forza, descrizione dello scenario, iniettati riga per riga dalla tabella dati prodotto.
- Livello di post-produzione: sigla iniziale e finale, sottotitoli, watermark, da sovrapporre preferibilmente dopo la generazione, per evitare di consumare durata inutilmente a ogni generazione.
Guidare i task in batch con una coda: il fallimento di un singolo task non deve bloccare l'intero batch; per ogni record salvare prompt, identificativo del materiale di input e indirizzo di output, per poter risalire a quale versione del materiale ha funzionato meglio.
Criteri di validazione
La validazione della produzione in batch deve essere quantificabile: il soggetto del prodotto è riconoscibile, ci sono deformazioni evidenti, compaiono testo illeggibile indesiderato, la durata rispetta i limiti della piattaforma di destinazione. Si consiglia di eseguire prima un piccolo lotto con campionamento manuale, confermare la stabilità del template di prompt, poi aumentare i volumi.
Scenario 2: image-to-video per animare materiali statici
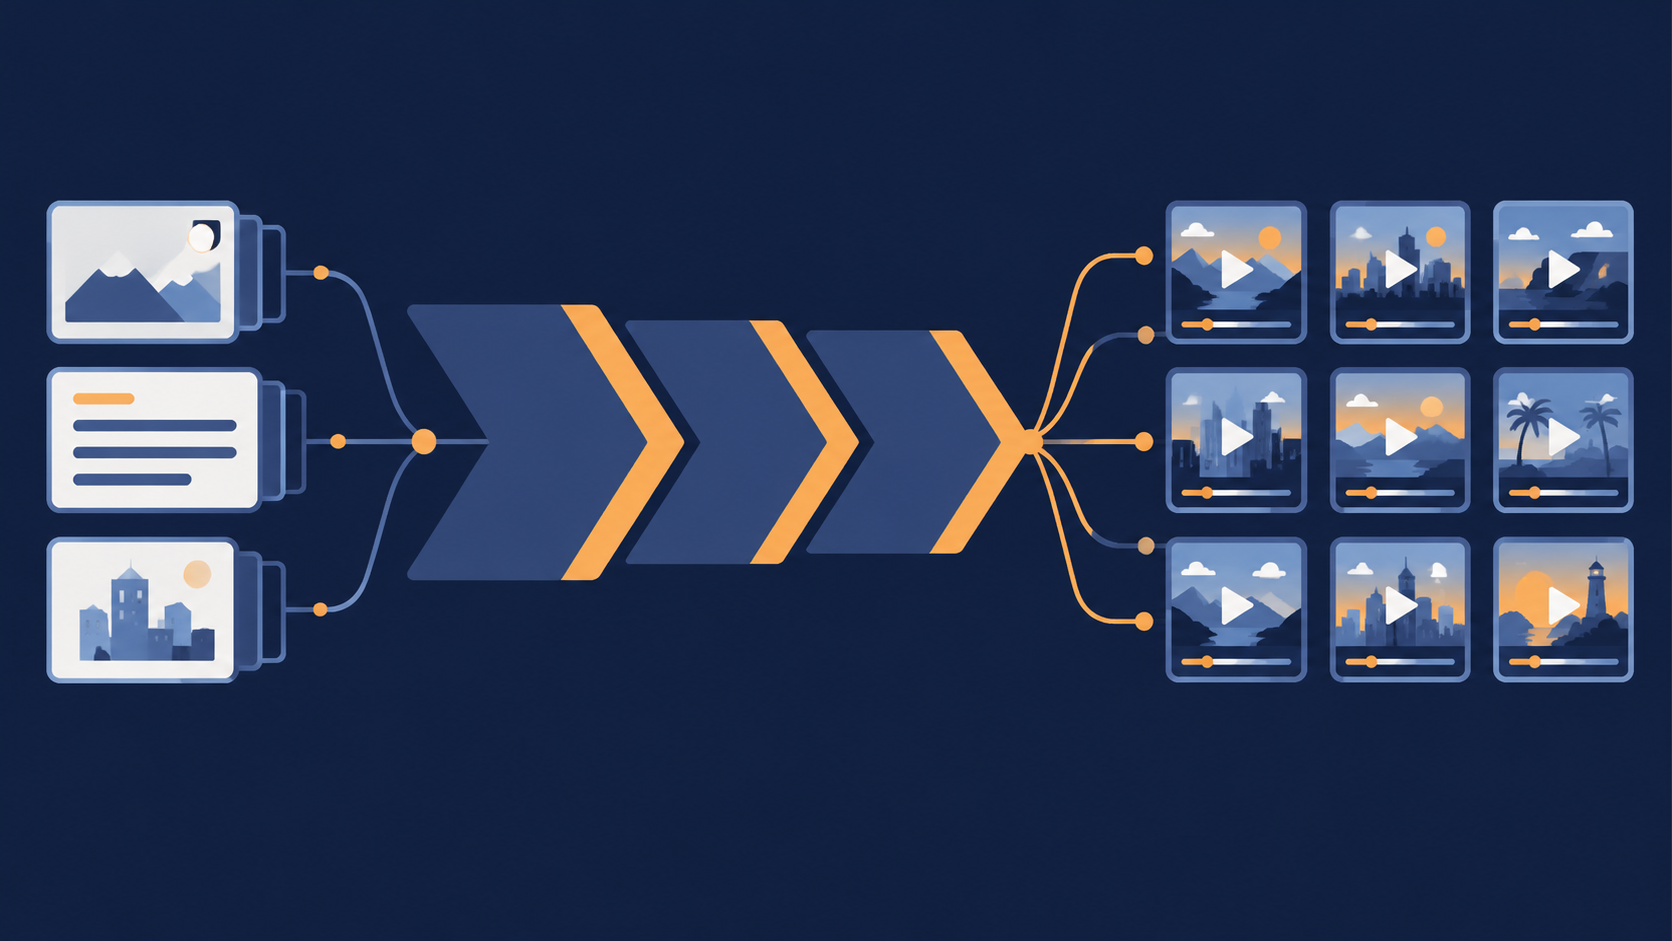
Molti team non hanno materiali video, ma accumulano molti asset statici: immagini prodotto, illustrazioni, poster, copertine di corsi, key visual di eventi. Questi materiali nei feed perdono naturalmente: le immagini statiche spesso vengono saltate nei feed a riproduzione automatica. Animarli è il tipo di utilizzo con l'investimento minimo e l'effetto più rapido.
Dove sta il valore
Il beneficio principale dell'animazione non è «diventare più bello», ma aumentare permanenza e clic dei materiali nei feed. Il video breve derivato dalla stessa immagine principale può partecipare autonomamente come materiale pubblicitario a un test AB, aggiungendo così una dimensione di test allo stesso asset. Per le attività basate su librerie di immagini (e-commerce, contenuti, formazione) significa liberare di nuovo il valore residuale dei materiali storici.
Punti di attenzione nell'implementazione
- Ampiezza del movimento contenuta. Il punto in cui image-to-video fallisce più facilmente è l'ampiezza eccessiva che deforma il soggetto. Nel prompt vanno esplicitati limiti come «lieve», «lento» e descritta la fonte del movimento (movimento di camera, variazione di luce, oscillazione di elementi locali), invece di chiedere genericamente di «muoversi».
- Il primo fotogramma è la copertina. Nei feed ciò che si vede per primo è il primo fotogramma del video: al momento di scegliere l'immagine si deve selezionare in base a «funziona da sola come copertina?», non scegliere un'immagine che è bella solo quando si muove.
- Spazio nella composizione. Se l'immagine originale è a composizione piena, dopo il movimento è facile tagliare informazioni ai bordi; preferire materiali con soggetto centrato e margini ai lati.
Come valutare i benefici
Si consiglia di valutare secondo due dimensioni: «tasso di riutilizzo dei materiali» e «costo di test per materiale»: quale percentuale di un lotto di immagini esistenti è adatta all'animazione, quanto si riduce il costo di generazione di un singolo materiale animato rispetto a una nuova ripresa. Una volta stabiliti questi due numeri, i team basati su librerie di immagini di solito trasformano questo in un processo di produzione di materiali continuativo, non in un esperimento una tantum.
Scenario 3: adattamento di stile e specifiche con video-to-video
Quando un team ha già un materiale video efficace, il vero problema diventa spesso: come adattarlo a tutti i canali. Orizzontale in verticale, lungo in breve, stile visivo uniforme, versioni localizzate per diverse aree: tradizionalmente questi lavori richiedono un montatore che li gestisca uno per uno, video-to-video trasforma questo passaggio in un'elaborazione batch programmabile.
Utilizzi tipici
- Un master, più canali: con un video principale come sorgente, produrre in batch versioni adatte alle diverse posizioni pubblicitarie, conservando ritmo e struttura narrativa del master, cambiando solo proporzioni e baricentro della composizione.
- Uniformare lo stile: uniformare materiali storici con toni incoerenti allo stile attuale del brand, riducendo la frammentazione visiva nella libreria.
- Adattamento alle specifiche: riscrivere in modo uniforme in base ai requisiti di durata, formato e definizione delle diverse piattaforme.
Confermare i vincoli in anticipo
L'output di video-to-video è fortemente vincolato al video sorgente: durata, complessità del movimento e qualità dell'immagine del sorgente si trasmettono all'output. Prima del lancio bisogna quindi chiarire i requisiti di business su durata massima dell'output e formato, poi decidere come tagliare il sorgente. Soprattutto per trasformare un filmato lungo in uno breve, si consiglia di fare un pre-montaggio sul sorgente, invece di dare l'intero filmato lungo al modello lasciandogli scegliere: il modello non capisce qual è il punto focale della tua narrazione.
Progettazione del batch
Astrarre una conversione come terna «ID sorgente + specifiche target + istruzioni di stile» e inserirla in una tabella di task. Una riga per ogni canale target, risultati archiviati per nome canale. Così aggiungere un canale significa solo aggiungere una riga di configurazione, non rifare tutto il processo di montaggio. Allo stesso tempo conservare la corrispondenza tra sorgente e output, per poter individuare, quando un canale segnala risultati scarsi, quale tipo di riscrittura ha creato il problema.
Scenario 4: produzione rapida di demo prodotto e anteprime di funzionalità
I team SaaS e di strumenti hanno un problema ricorrente: ogni rilascio richiede un video demo, ma le registrazioni schermo spesso aspettano la stabilità del prodotto e lo script l'approvazione del marketing, e alla fine la data di pubblicazione è bloccata dal video. Il modello video può comprimere da giorni a ore la prima versione di un «video demo».
Flusso consigliato
- Scomporre lo script in inquadrature: dividere una demo prodotto in diverse inquadrature da circa 5 secondi, ognuna corrispondente a una funzionalità o a uno scenario d'uso. L'inquadratura è il punto chiave di questo passaggio, perché il modello controlla il contenuto delle inquadrature brevi molto meglio delle narrazioni lunghe.
- Generare combinando testo e immagini: per funzionalità astratte (flusso dati, processi collaborativi) usare text-to-video per generare scene concettuali; per interfacce reali e forme del prodotto usare image-to-video con screenshot o bozze di design come ancora, per garantire che l'immagine del prodotto presentata all'esterno non si discosti.
- Montaggio e voce: montare i frammenti generati in post-produzione, aggiungendo voce fuori campo, sottotitoli e transizioni. Non cercare di ottenere «tutto in una ripresa» in fase di generazione: è difficile da controllare e costoso.
La revisione manuale è indispensabile
La priorità assoluta di un video demo prodotto è non fuorviare l'utente. Le scene generate dal modello possono mostrare pulsanti inesistenti, layout di interfaccia errati o funzionalità inventate. Ogni versione dei frammenti generati deve quindi passare una revisione manuale lato prodotto, per confermare che gli elementi presenti nell'immagine esistano nel prodotto reale o siano chiaramente marcati come illustrativi. Si consiglia di inserire «verifica degli elementi visivi» come voce fissa di controllo, invece di dare un'occhiata di sfuggita durante il montaggio.
Limiti di applicabilità
Questo percorso è adatto per anteprime di funzionalità, demo concettuali, materiali per il conto alla rovescia del rilascio e video per report interni; non è adatto per tutorial che richiedono la riproduzione precisa dei passaggi operativi. I contenuti tutorial dovrebbero continuare a basarsi su registrazioni reali dello schermo, con la generazione del modello usata solo per confezione e transizioni.
Scenario 5: materiali dinamici e sperimentazione creativa per piattaforme di contenuti
Le esigenze dei team contenuti e crescita sono diverse dalle prime quattro categorie: non mancano di un buon materiale, mancano di molte direzioni testabili. La tariffazione al secondo dei modelli video si adatta proprio a questo ritmo di sperimentazione in piccoli lotti: frammenti brevi, più direzioni, eliminazione rapida.
Rendere l'esperimento un ciclo chiuso
Un processo di sperimentazione creativa sostenibile di solito funziona così: partendo da un tema o da un trend, generare in una volta diversi frammenti brevi, ognuno rappresentante una diversa direzione visiva o angolazione narrativa; dopo la pubblicazione osservare i dati iniziali, tenere le direzioni promettenti per ulteriori iterazioni, scartare direttamente le altre. La chiave è piccoli lotti per ogni esperimento, frammenti singoli brevi, così che il costo di un singolo ciclo di tentativi sia abbastanza basso da poter essere ripetuto ad alta frequenza.
Tre consigli ingegneristici
- Variabili fisse: in un ciclo di esperimenti cambiare solo una dimensione (stile visivo, modalità di apertura o ritmo), altrimenti i dati non sono attribuibili.
- Registrare i prompt: archiviare prompt e parametri di ogni frammento, per poter riprodurre in caso di successo ed escludere in caso di risultato scarso.
- Preferire i frammenti brevi: in fase sperimentale generare con durate brevi, dopo aver verificato la direzione allungare e aumentare i volumi della direzione vincente.
Adatto e non adatto
Adatto per hook di apertura, frammenti d'atmosfera, visual legati a temi, animazioni di copertina; non adatto per contenuti lunghi che richiedono narrazione coerente. Posizionare il modello come «sonda creativa» invece che «linea di produzione di contenuti» rende più sani sia le aspettative che i criteri di validazione del team.
Stima dei costi e strategia di chiamata con tariffazione al secondo
La metrica di fatturazione dei modelli video è al secondo di output, il che significa che il costo è direttamente legato a «durata × numero di pezzi». Per il prezzo unitario concreto fare riferimento al pannello prezzi del sito; qui si parla solo di metodo di conversione e strumenti di controllo.
Convertire la fatturazione in costo per singolo pezzo di business
La formula di conversione è semplice: costo per pezzo = secondi di output × prezzo al secondo. Su questa base si moltiplica per il fattore lato business: un materiale pubblicitario di solito richiede più versioni per i test AB, quindi il costo reale è «costo per pezzo × numero di versioni × numero di iterazioni». Sono proprio gli ultimi due moltiplicatori che molti team sottovalutano: le generate ripetute prima della definizione del risultato costano spesso molto più dei pochi pezzi finali consegnati.
Quattro leve per controllare i costi
- Ridurre la durata: verificare prima la direzione con frammenti brevi, generare la durata completa solo dopo la definizione. È il mezzo di risparmio più efficace, perché il costo è lineare rispetto alla durata.
- Controllare le iterazioni: stabilizzare prima il template di prompt su piccoli lotti, poi aumentare i volumi. La generazione in batch con template instabili è quasi puro spreco.
- Per fasi: in fase esplorativa permettere la divergenza, in fase produttiva fissare i parametri. Le due fasi usano dimensioni di lotto e criteri di validazione diversi.
- Calcolare la concorrenza: il limite di concorrenza dei task batch va impostato insieme al limite di budget, definendo una soglia di costo per ogni lotto, oltre la quale sospendere e confermare manualmente, per evitare che gli script vadano fuori controllo.
Definire la strategia di chiamata
Si consiglia di rendere «durata» e «numero di pezzi» elementi configurabili nel codice di business, invece che hardcoded. Così quando il budget pubblicitario si stringe basta modificare la configurazione per abbassare il costo del singolo lotto, senza toccare il codice. Allo stesso tempo registrare durata e numero di pezzi di ogni chiamata nei log, formando un conto spese consultabile, comodo per la ripartizione per progetto o canale.
Troubleshooting dell'integrazione e checklist pre-lancio
I fallimenti delle API video spesso non sono «errori», ma «lentezza» e «instabilità». Passare in rassegna questi punti prima del lancio permette di intercettare la maggior parte dei problemi in produzione.
Modalità di fallimento comuni
- Timeout: la generazione video richiede molto più tempo di testo e immagini, il timeout predefinito del client è facilmente insufficiente. Impostare il timeout della richiesta a un ordine di grandezza coerente con la durata del video e passare al modello task asincrono + polling, invece dell'attesa sincrona.
- Invii duplicati: i retry automatici in caso di instabilità di rete possono causare generazioni duplicate, aumentando direttamente i costi. Generare una chiave di idempotenza per ogni task, con deduplicazione lato server basata su di essa.
- Contenuti non conformi o inutilizzabili: l'output può presentare deformazioni del soggetto, testo illeggibile, scene non conformi ai requisiti di business. Questi problemi non generano eccezioni, si possono fermare solo in fase di validazione.
- Problemi con i materiali di input: risoluzione troppo bassa o composizione troppo piena dell'immagine di riferimento in image-to-video, bitrate insufficiente del video sorgente in video-to-video, peggiorano visibilmente la qualità dell'output. Il lato materiali deve eseguire controlli prima dell'ingresso in coda.
Progettazione di timeout, retry e degrado
I retry devono avere limiti: solo per errori di rete evidenti e 5xx, con numero massimo e intervallo di backoff; per i fallimenti di contenuto nessun retry automatico, passaggio a gestione manuale. Le soluzioni di degrado vanno pensate in anticipo: in caso di fallimento della generazione, tornare a materiale statico, tornare all'ultima versione utilizzabile o saltare direttamente il task? La risposta varia per linea di business, ma va determinata in fase di progettazione.
Checklist pre-lancio
- La catena dei task asincroni è completa: invio, polling, timeout, idempotenza, salvataggio dei risultati.
- Durata e numero di pezzi sono configurabili, esiste una soglia di costo per singolo lotto.
- I materiali di input sono soggetti a controlli di risoluzione e formato.
- L'output ha una fase di validazione manuale o automatica, con criteri quantificabili.
- I log registrano prompt, parametri, durata e stato del task, ed è possibile risalire.
- I percorsi di degrado sono stati provati, non solo scritti nella documentazione.
Trattare questa checklist come gate di rilascio rende il ritmo di lancio delle funzionalità video molto più stabile rispetto a sistemare le cose mentre si va. Per approfondire i confini di capacità di flux-3-video, si può prima far funzionare una catena minima nella pagina del modello, poi espandere strato per strato secondo gli scenari sopra.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato