
Comparatif et évaluation
gpt-image-2.6-sunburst/image-to-image comparaison transversale : comment choisir et migrer vers un modèle image-to-image
Des frontières de capacités au coût unitaire et au coût de migration, une liste de sélection pour les équipes d'ingénierie
Sur cette page
Commencer par lire à fond les informations connues : ce que ce modèle permet de confirmer
Avant de discuter du « faut-il le choisir ou non », commençons par décortiquer proprement les informations de la fiche de ce modèle gpt-image-2.6-sunburst/image-to-image. Actuellement, seuls quatre éléments peuvent être confirmés : le fournisseur est OpenAI ; le type de sortie est l'image ; l'étiquette de capacité est image-to-image ; la tarification est à l'image.
Ces quatre éléments correspondent chacun à un type de décision d'ingénierie :
- Fournisseur = écosystème et attentes de conformité. OpenAI comme fournisseur signifie que vous pourrez très probablement réutiliser vos méthodes d'authentification, le style de vos codes d'erreur et vos habitudes SDK existantes, mais la nomination exacte des paramètres doit toujours se baser sur la documentation d'interface au moment de l'intégration, sans supposer par expérience.
- Type de sortie = image. Il ne renvoie ni texte ni JSON structuré, donc votre chaîne de traitement doit concevoir des stratégies de stockage, de distribution CDN et de cache pour des résultats binaires, plutôt que de suivre l'approche de post-traitement textuel.
- image-to-image = l'entrée est une image. Cela détermine qu'il s'agit d'un modèle d'édition/transformation, pas de génération purement texte-vers-image. Les dimensions, le format et la conformité du contenu de l'image d'entrée entrent directement dans votre logique de validation.
- Tarification à l'image = modèle de coût simple. Contrairement à une facturation par token ou par seconde de sortie, la courbe de coût d'une tarification à l'image est linéaire et facile à estimer ; mais le prix unitaire lui-même doit se référer au panneau de prix du site, cet article ne donne pas de chiffres concrets.
Conclusions à ne pas en tirer
La fiche modèle ne vous dit pas la fidélité d'édition, la force du suivi d'instructions, la résolution d'entrée maximale, le nombre de zones modifiables par édition, la limite de concurrence, la latence P99. Ces six éléments sont précisément les clés de la mise en production de l'image-to-image. Voir « image-to-image » et en déduire qu'il peut gérer le changement d'arrière-plan, le repeint local, le transfert de style ou le remplacement de texte n'est pas rigoureux — ces capacités varient énormément et doivent être validées avec votre propre jeu d'échantillons.
En une phrase pour résumer cette section : les informations connues suffisent à le placer dans le vivier de candidats, mais pas à décider directement.
Quelles dimensions comparer pour choisir un image-to-image
Face à n'importe quel modèle image-to-image, il est recommandé d'utiliser systématiquement le même ensemble de dimensions de notation, plutôt que de choisir à chaque fois à l'impression. Les six dimensions ci-dessous couvrent les principaux risques, de l'efficacité à l'exploitation.
1. Fidélité d'édition
Le modèle peut-il « ne modifier que ce qui doit l'être ». Méthode de test : préparer un lot d'images d'entrée contenant des visages, du texte, des textures fines (tissus, cheveux), effectuer une édition locale et vérifier si les zones non éditées ont été modifiées en silence. Une mauvaise fidélité entraîne une dérive des détails des images produits, ce qui est un critère éliminatoire dans le commerce en ligne.
2. Suivi des instructions
La cohérence entre les instructions en langage naturel et la sortie. Surveiller trois points : la quantité (« remplacer par trois vases » en donne-t-il vraiment trois), la position (« ajouter une marque en haut à gauche » est-elle bien en haut à gauche), les instructions négatives (« ne pas changer l'arrière-plan » est-il respecté). Les instructions négatives sont un bon révélateur de la maturité d'un modèle.
3. Stabilité de sortie
Pour une même entrée + mêmes paramètres, quelle est la variance des résultats sur plusieurs appels. Pour les pipelines nécessitant reproductibilité (par exemple générer en lot une même série de contenus), une variance trop élevée fait exploser les coûts de validation en aval.
4. Latence et débit
Ne pas regarder seulement la moyenne, mais P95/P99, ainsi que la courbe de dégradation de la latence lorsque la concurrence augmente. L'image-to-image est généralement plus lent que le texte-vers-image, car il ajoute une étape d'encodage de l'entrée.
5. Coût unitaire et base de facturation
Pour un modèle tarifé à l'image, coût = nombre d'images appelées × prix unitaire. Mais il faut demander clairement : les requêtes échouées sont-elles facturées, le retour de plusieurs candidats est-il compté à l'image, existe-t-il des paliers selon la taille de l'image d'entrée.
6. Maturité de l'écosystème
Complétude de la documentation, lisibilité des codes d'erreur, présence d'un identifiant de version stable, quantité de retours d'expérience communautaires. Cet élément n'apparaît pas dans les benchmarks, mais détermine si le dépannage prendra des jours ou des heures.
Recommandation de notation
Attribuer des poids aux six dimensions puis agréger, les poids étant décidés par le métier : pour les scénarios d'images produits, augmenter la fidélité et la stabilité ; pour les scénarios d'outils créatifs, augmenter le suivi des instructions et la latence. Ne pas utiliser un seul jeu de poids pour tout.
Le coût réel derrière un prix à l'image
Le tarif à l'image semble propre, mais le coût métier n'est jamais « nombre de requêtes × prix unitaire ». Entre les deux s'interposent trois couches de pertes : échecs, reprises et éditions multiples.
Entonnoir de coût
Décomposons un besoin métier en entonnoir :
- Nombre de requêtes d'édition initiées par l'utilisateur/système — c'est votre volume initial.
- Nombre d'échecs au premier appel — timeout, limitation de débit, entrée non conforme, refus du modèle consomment chacun un appel. Si les échecs sont facturés, cette part est une perte pure.
- Amplification par reprise — la reprise après échec et la « régénération pour insatisfaction » sont deux types de reprise de nature différente, la seconde représentant souvent la majeure partie. Dans les scénarios créatifs, derrière une image finale il peut y avoir de quelques à une dizaine de générations.
- Éditions multiples — un flux de travail réel se termine rarement en un tour : d'abord changer l'arrière-plan, puis ajuster les couleurs, puis retoucher les détails. Chaque tour est un appel facturé.
- Nombre final d'images livrables — c'est le dénominateur.
Coût réel par image livrable = nombre total d'images appelées × prix unitaire ÷ nombre final d'images livrables.
Comment réduire ce ratio
- Réduire les reprises inutiles : effectuer une pré-validation de l'image d'entrée avant l'appel (dimensions, format, conformité du contenu) pour bloquer hors facturation les requêtes vouées à l'échec.
- Figer des modèles de prompts : capitaliser les opérations d'édition fréquentes en modèles, pour réduire la régénération aléatoire « par essais ».
- Distinguer exploration et production : en phase d'exploration, utiliser basse résolution et paliers rapides ; en phase de finalisation, recourir aux appels de haute qualité.
- Enregistrer l'appartenance métier de chaque appel : sans facturation ventilée par scénario, vous ne saurez jamais où va l'argent.
Le prix unitaire concret doit se référer au panneau de prix du site ; c'est en appliquant l'entonnoir ci-dessus que vous obtiendrez un chiffre utilisable pour le budget.
Conclusions par scénario : quand cela vaut la peine de le choisir
Les jugements ci-dessous reposent sur le groupe de conditions connues « fournisseur OpenAI + sortie image + image-to-image + tarification à l'image », ce sont des recommandations directionnelles, à confirmer en dernier ressort par vos propres tests.
Traitement d'images produits en lot : mérite d'entrer dans les candidats
Le modèle de coût linéaire à l'image est favorable aux scénarios en lot, le budget est prévisible. À condition de valider par test deux points : la fidélité des zones non éditées est conforme, et les résultats de traitements multiples d'un même SKU sont suffisamment cohérents. Si la fidélité n'est pas au niveau, même moins cher il ne faut pas l'utiliser, car le coût de reprise dépasse le coût d'appel.
Itération créative et assistance à la conception : optimisme prudent
Ces scénarios exigent beaucoup du suivi des instructions et des « bons résultats inattendus », peu de la stabilité absolue, avec une grande marge de tolérance. Il convient de commencer par un test à faible volume, en notant avec le taux d'adoption de vrais designers plutôt qu'en regardant les images de démo. Attention : le volume d'appels ici sera amplifié par les éditions multiples, il faut impérativement faire d'abord une estimation par entonnoir de coût.
Sortie stable de production (API externe / pipeline automatisé) : compléter la validation avant de mettre en production
Si la génération d'images est le maillon central de votre produit, le risque de dépendance à un seul modèle est élevé. Avant de confirmer la latence P99, la limite de concurrence et le taux d'erreur, ne l'établissez pas comme canal unique. Il est recommandé de l'intégrer selon une structure « principal + secours ».
Cas explicitement déconseillés
- Le besoin inclut une composition typographique précise ou la reproduction d'une police de marque — les modèles image-to-image y sont généralement peu performants, validez avant de promettre.
- Besoin de sorties de type audit strictement reproductibles — ne pas intégrer au circuit de conformité avant validation de la stabilité de sortie.
- Les spécifications de l'image d'entrée dépassent la plage prise en charge et ne peuvent être prétraitées — résoudre d'abord le prétraitement, puis parler de sélection.
Liste à valider avant l'intégration
Considérez la liste ci-dessous comme le seuil d'admission avant mise en ligne, à cocher point par point.
Côté entrée
- Formats d'image d'entrée pris en charge et résolution maximale ; en cas de dépassement, erreur ou compression silencieuse.
- Stratégie de traitement du ratio d'aspect : étirement, recadrage ou ajout de bords, et impact éventuel sur la fidélité.
- Conditions de déclenchement du blocage de conformité du contenu et forme de retour, identifiable par programme plutôt qu'un simple message d'erreur vague.
Côté appel
- Limite de concurrence et stratégie de limitation de débit : limite QPS stricte ou système de quotas, quel code d'état en cas de dépassement.
- Réglage des timeouts : l'image-to-image a une durée très variable, le timeout client doit être supérieur au P99 serveur, sinon vous générez une double facturation « en fait réussi mais client abandonné ».
- Idempotence : les reprises entraînent-elles une double facturation, peut-on dédupliquer par ID de requête.
Gestion des erreurs
- Distinguer les erreurs réessayables (timeout, limitation de débit) des erreurs non réessayables (entrée non conforme, erreur de paramètre).
- Concevoir pour les erreurs non réessayables des messages lisibles par l'utilisateur, plutôt que de renvoyer le code d'erreur brut au frontend.
- Fixer une limite de reprise et une stratégie de backoff, pour éviter qu'une tempête de reprises en cas de panne amplifie les coûts.
Côté résultat
- Solution de stockage des images de sortie : stockage objet + CDN, ou retour direct en base64. Pour les grandes images, attention à la taille du corps de réponse.
- Stratégie de cache : les résultats sont-ils réutilisables pour une même entrée + mêmes paramètres, existe-t-il une fenêtre de cache autorisée par le métier.
- Conservation des métadonnées : enregistrer l'identifiant du modèle, les paramètres, la durée, s'il y a eu reprise, pour faciliter l'attribution ultérieure et la comparaison de migration.
Tant que la liste n'est pas entièrement parcourue, aucune conclusion du type « ça produit déjà des images » ne compte.
Chemin de migration depuis un modèle existant et retour arrière
Le risque de la migration ne réside pas dans « le nouveau modèle peut-il être utilisé », mais dans « peut-on revenir à l'ancien modèle ». Suivez les quatre étapes ci-dessous pour transformer le basculement en opération réversible.
Étape 1 : constituer un jeu d'évaluation de référence
Prélever par échantillonnage dans l'activité réelle, couvrant cinq catégories : édition simple, édition complexe multi-zones, image avec texte, image avec visage, ratio d'aspect extrême. Définir pour chaque catégorie des critères de réussite quantifiables (par exemple notation humaine de la fidélité, taux de respect des instructions). Ce jeu doit être constitué avant la migration, ne pas chercher des échantillons à la hâte au moment du basculement.
Étape 2 : double exécution comparative
Faire tourner en parallèle ancien et nouveau modèle sur le même lot d'échantillons, avec évaluation en aveugle. Surveiller trois choses : la qualité globale est-elle égale ou meilleure, les modes d'échec changent-ils (le nouveau modèle échoue-t-il là où l'ancien ne le faisait pas), le ratio de l'entonnoir de coût est-il acceptable.
Étape 3 : déploiement progressif
Basculer progressivement par proportion de trafic : 1 % → 10 % → 50 % → 100 %. À chaque palier, observer le même ensemble d'indicateurs : taux d'erreur, latence P99, taux d'adoption côté utilisateur, coût par image livrable. Arrêter si un indicateur se dégrade au-delà du seuil prédéfini. Pendant le déploiement progressif, conserver la double voie, ne pas retirer l'ancien modèle par avance.
Étape 4 : plan de retour arrière
Le retour arrière doit être un changement de configuration, pas une publication de code. Méthode : au niveau métier, utiliser une abstraction unifiée d'appel de modèle, l'identifiant du modèle passant par la configuration ; retour arrière = modifier la configuration + rafraîchir, en quelques minutes. Confirmer en même temps deux choses : les droits d'accès à l'ancien modèle restent conservés pendant un certain temps après la migration ; les métadonnées de résultats générées pendant la migration suffisent à déterminer quelles requêtes ont été affectées.
Ne pas se presser de supprimer l'ancien code après la migration
Conserver au moins un cycle métier complet. Les problèmes de qualité de l'image-to-image ne se révèlent souvent que sous certaines distributions d'entrée, une observation de courte durée ne suffit pas.
Utilisation combinée sur une plateforme d'agrégation
La dépendance à un seul modèle est le risque le plus souvent négligé dans l'activité image-to-image : instabilité du modèle, ajustement des limitations de débit, évolution des frontières de capacités, chacun de ces éléments frappe directement votre chaîne produit. En intégrant simultanément plusieurs modèles d'image via une interface unifiée, ces risques deviennent des éléments configurables.
Trois combinaisons pratiques
- Répartition A/B : diriger le trafic vers différents modèles selon l'utilisateur ou le scénario, et décider du modèle principal avec le taux d'adoption réel plutôt qu'avec des évaluations hors ligne. L'interface unifiée permet de ne changer qu'un champ pour la répartition.
- Routage par capacité : dispatcher les tâches d'édition par type — un modèle pour la sensibilité à la fidélité, un autre pour l'exploration créative. La logique de routage est centralisée, facilitant les ajustements.
- Repli de secours : basculer automatiquement vers le modèle de secours lorsque le taux d'erreur ou la latence du modèle principal dépasse le seuil, garantissant la continuité de la chaîne. Le repli doit être envisagé avec l'adaptation des prompts, car différents modèles peuvent réagir différemment à une même instruction.
Bénéfices d'ingénierie
Une interface unifiée signifie que l'authentification, la facturation, les journaux et la stratégie de reprise ne sont implémentés qu'une fois ; ajouter ou remplacer un modèle devient un changement de configuration et non un travail d'intégration. Pour les équipes qui doivent continuellement faire de la sélection de modèles, c'est un coût d'intégration à long terme économisé, et pas seulement un temps de raccordement ponctuel.
Que vous choisissiez finalement gpt-image-2.6-sunburst/image-to-image ou non, ce n'est qu'en l'évaluant dans le même cadre de comparaison, le même entonnoir de coût et le même mécanisme de déploiement progressif que la conclusion tiendra. Faire tourner côte à côte les modèles candidats via une interface unifiée est plus convaincant que de lire dix évaluations.
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Liste de contrôle pour le choix de Gemini Omni 1.2 Flash : modes d'entrée, spécifications et budget
Vérifier les modes d'entrée, les spécifications, le budget et les limites d'effet, puis finaliser le choix avec vos propres échantillons
-
Comparatif et évaluation
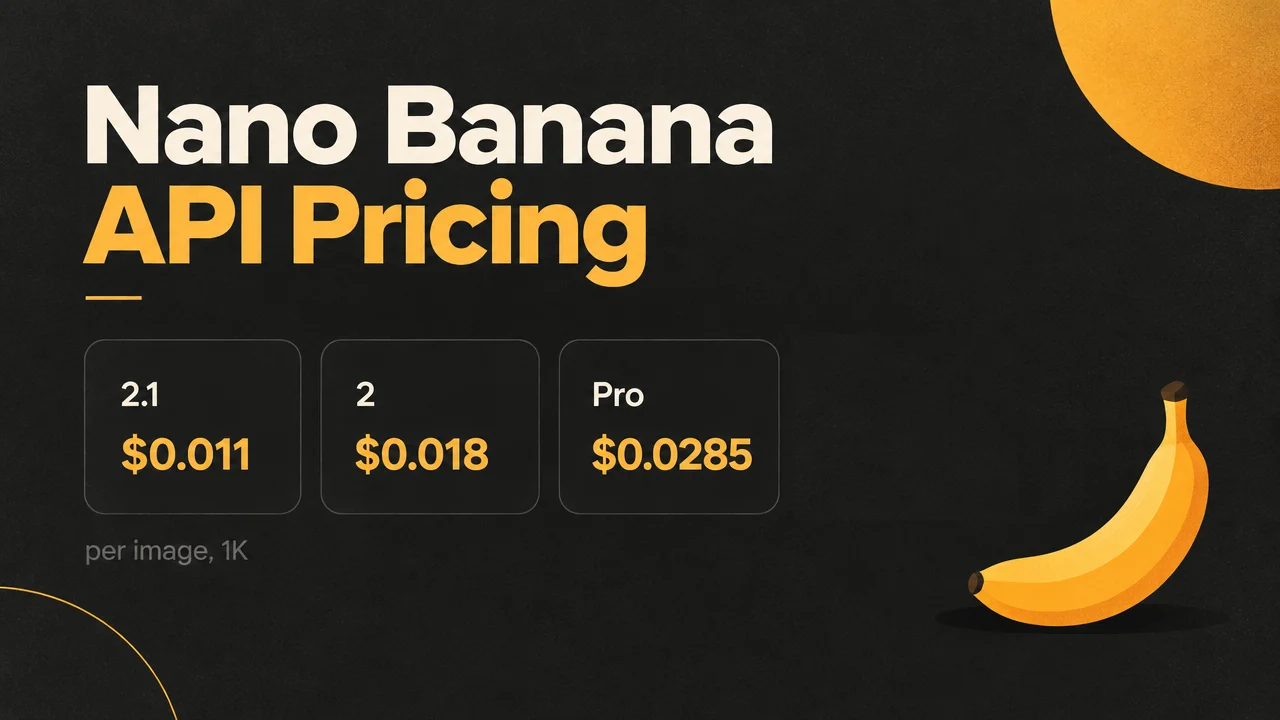
Nano Banana Black Friday : moins de 1 centime par image — comparaison de 2.1, 2 et Pro sur un même prompt
Prix normaux et prix Black Friday des trois versions 2.1, 2 et Pro, avec des images générées à partir du même prompt
-
Comparatif et évaluation
Prix des API de vidéo IA pour le Black Friday : jusqu'à environ 23 % d'économie par seconde avec Veo, Seedance et Kling
Prix à la seconde et à la vidéo de Veo 3.1, Seedance et Kling 3.0, et tarifs convertis pour le Black Friday