
Vergleichstest
gpt-image-2.6-sunburst/image-to-image im Quervergleich: Wie man Bild-zu-Bild-Modelle auswählt und migriert
Von Fähigkeitsgrenzen über Einzelbildkosten bis zu Migrationskosten: eine Auswahlliste für Engineering-Teams
Auf dieser Seite
Zunächst die bekannten Informationen gründlich lesen: Was dieses Modell bestätigen kann
Bevor man diskutiert, „ob man es wählt oder nicht“, sollte man die Informationen auf der Modellkarte von gpt-image-2.6-sunburst/image-to-image sauber auseinandernehmen. Derzeit lassen sich nur vier Punkte bestätigen: Der Anbieter ist OpenAI; der Ausgabetyp ist Bild; das Fähigkeitslabel ist image-to-image; die Preislogik ist eine Abrechnung pro Bild.
Diese vier Punkte entsprechen jeweils einer Art von Engineering-Entscheidung:
- Anbieter = Ökosystem- und Compliance-Erwartungen. OpenAI als Anbieter bedeutet, dass du wahrscheinlich die bestehende Authentifizierungsmethode, den Stil der Fehlercodes und die SDK-Gewohnheiten wiederverwenden kannst. Die konkreten Parameternamen richten sich jedoch weiterhin nach der Schnittstellendokumentation zum Zeitpunkt der Integration; verlasse dich nicht auf Annahmen aus Erfahrung.
- Ausgabetyp = Bild. Es werden keine Texte oder strukturierten JSON-Daten zurückgegeben. Deine Verarbeitungskette muss daher Speicherung, CDN-Verteilung und Caching-Strategien für binäre Ergebnisse vorsehen, statt auf Text-Nachverarbeitung zu setzen.
- image-to-image = Die Eingabe ist ein Bild. Das legt fest, dass es sich um ein Bearbeitungs-/Transformationsmodell handelt, nicht um reine Text-zu-Bild-Generierung. Größe, Format und inhaltliche Konformität des Eingabebilds fließen direkt in deine Validierungslogik ein.
- Abrechnung pro Bild = einfaches Kostenmodell. Im Vergleich zur Abrechnung pro Token oder pro Ausgabesekunde ist die Kostenkurve bei Abrechnung pro Bild linear und leicht zu schätzen; der Stückpreis selbst richtet sich jedoch nach dem Preispaneel der Website, konkrete Zahlen werden in diesem Artikel nicht genannt.
Schlussfolgerungen, die sich daraus nicht ziehen lassen
Die Modellkarte sagt dir nicht, wie es um Bearbeitungstreue, Stärke der Instruktionsbefolgung, maximale Eingangsauflösung, wie viele Bereiche eine einzelne Bearbeitung ändern kann, Obergrenze der Parallelität und P99-Latenz steht. Genau diese sechs Punkte sind entscheidend für die Praxistauglichkeit von Bild-zu-Bild. Aus „image-to-image“ zu schließen, dass es Hintergrundwechsel, partielle Neuzeichnung, Stilübertragung und Textersetzung beherrscht, ist nicht stichhaltig – diese Fähigkeiten unterscheiden sich stark und müssen mit deinem eigenen Beispieldatensatz validiert werden.
Zusammenfassung dieses Abschnitts: Die bekannten Informationen reichen aus, um es in den Kandidatenpool aufzunehmen, aber nicht für eine endgültige Entscheidung.
Welche Dimensionen ein Bild-zu-Bild-Vergleich betrachten sollte
Bei jedem image-to-image-Modell empfiehlt es sich, konsequent dieselben Dimensionen zur Bewertung zu verwenden, statt jedes Mal aus dem Bauch heraus zu entscheiden. Die folgenden sechs Dimensionen decken die wesentlichen Risikobereiche von der Wirkung bis zum Betrieb ab.
1. Bearbeitungstreue
Ob das Modell „nur das ändern kann, was geändert werden soll“. Testmethode: Bereite eine Charge von Eingabebildern mit Gesichtern, Text und feinen Texturen (Stoff, Haare) vor, führe lokale Bearbeitungen durch und prüfe, ob nicht bearbeitete Bereiche heimlich verändert wurden. Geringe Treue führt zu Drift von Produktbilddetails – ein Ausschlusskriterium im E-Commerce.
2. Instruktionsbefolgung
Die Übereinstimmung von natürlichsprachlichen Instruktionen und Ausgabe. Achte auf drei Punkte: Anzahl (ob „ersetze durch drei Vasen“ wirklich drei ergibt), Position (ob „füge oben links eine Markierung hinzu“ oben links liegt) und Negativinstruktionen (ob „verändere den Hintergrund nicht“ eingehalten wird). Negativinstruktionen sind eine gute Sonde zur Unterscheidung der Modellreife.
3. Ausgabestabilität
Wie groß die Varianz der Ergebnisse bei mehrfachem Aufruf mit derselben Eingabe und denselben Parametern ist. Für Pipelines, die Reproduzierbarkeit benötigen (z. B. Massengenerierung derselben Materialserie), treibt eine zu große Varianz die Kosten der nachgelagerten Prüfung in die Höhe.
4. Latenz und Durchsatz
Nicht nur den Durchschnitt betrachten, sondern P95/P99 sowie die Verschlechterungskurve der Latenz bei steigender Parallelität. Bild-zu-Bild ist in der Regel langsamer als Text-zu-Bild, weil eine zusätzliche Eingabekodierung erfolgt.
5. Kosten pro Bild und Abrechnungslogik
Bei Modellen mit Abrechnung pro Bild gilt: Kosten = Anzahl der Aufrufe × Stückpreis. Aber man sollte klären: Werden fehlgeschlagene Anfragen abgerechnet, werden mehrere zurückgegebene Kandidaten pro Bild berechnet, gibt es Unterschiede nach Größenstufen des Eingabebilds?
6. Ökosystemreife
Vollständigkeit der Dokumentation, Lesbarkeit der Fehlercodes, ob es stabile Versionskennungen gibt, wie viele Erfahrungsberichte aus der Community vorliegen. Dieser Punkt zeigt sich nicht in Benchmarks, entscheidet aber, ob die Fehlersuche Tage oder Stunden dauert.
Bewertungsempfehlung
Gewichte die sechs Dimensionen und aggregiere sie; die Gewichte bestimmt das Geschäft: Produktbildszenarien gewichten Treue und Stabilität höher; Kreativwerkzeug-Szenarien gewichten Instruktionsbefolgung und Latenz höher. Verwende nicht ein einziges Gewichtungsschema für alles.
Die realen Kosten hinter dem Einzelbildpreis
Ein Preis pro Bild wirkt sauber, aber die Geschäftskosten sind nie „Anzahl der Anfragen × Stückpreis“. Dazwischen liegen drei Verlustebenen: Fehler, Wiederholungen und mehrstufige Bearbeitung.
Der Kosten-Trichter
Betrachte einen Geschäftsbedarf als Trichter:
- Anzahl der von Nutzern/Systemen ausgelösten Bearbeitungsanfragen – das ist deine Ausgangsmenge.
- Anzahl der fehlgeschlagenen Erstaufrufe – Timeouts, Ratenbegrenzungen, nicht konforme Eingaben und Modellablehnungen verbrauchen jeweils einen Aufruf. Wenn Fehler ebenfalls abgerechnet werden, ist dieser Teil reiner Verlust.
- Verstärkung durch Wiederholungen – Wiederholungen nach Fehlern und „Neugenerierung wegen unzufriedenstellendem Ergebnis“ sind zwei unterschiedliche Arten von Wiederholungen; letztere machen oft den größten Anteil aus. In kreativen Szenarien können hinter einem finalen Ergebnis mehrere bis ein Dutzend Generierungen stecken.
- Mehrstufige Bearbeitung – reale Workflows enden selten nach einer Runde: erst Hintergrund ändern, dann Farben abstimmen, dann Details korrigieren. Jede Runde ist ein abgerechneter Aufruf.
- Anzahl der final lieferbaren Bilder – das ist der Nenner.
Reale Kosten pro lieferbarem Bild = Gesamtzahl der Aufrufe × Stückpreis ÷ Anzahl der final lieferbaren Bilder.
Wie man dieses Verhältnis senkt
- Ineffektive Wiederholungen reduzieren: Vor dem Aufruf eine Vorvalidierung des Eingabebilds durchführen (Größe, Format, inhaltliche Konformität), um zum Scheitern verurteilte Anfragen vor der Abrechnung abzufangen.
- Prompt-Vorlagen festigen: Häufige Bearbeitungsvorgänge in Vorlagen überführen, um zufällige Neugenerierungen durch „Ausprobieren“ zu verringern.
- Exploration und Produktion trennen: In der Explorationsphase niedrige Auflösung und schnelle Stufe verwenden; erst in der Finalisierungsphase hochwertige Aufrufe machen.
- Geschäftszuordnung jedes Aufrufs erfassen: Ohne nach Szenario aufgeschlüsselte Abrechnung weißt du nie, wohin das Geld fließt.
Konkrete Stückpreise richten sich nach dem Preispaneel der Website; erst wenn du den obigen Trichter darauf anwendest, erhältst du budgettaugliche Zahlen.
Szenariobasierte Schlussfolgerungen: Wann es sich lohnt, es zu wählen
Die folgenden Einschätzungen basieren auf der bekannten Bedingung „Anbieter OpenAI + Bildausgabe + image-to-image + Abrechnung pro Bild“ und sind richtungsweisende Empfehlungen; letztlich ist eine eigene Validierung erforderlich.
Massenverarbeitung von Produktbildern: Aufnahme in die Kandidatenliste lohnt
Das lineare Kostenmodell der Abrechnung pro Bild ist für Massenszenarien günstig; das Budget ist planbar. Voraussetzung ist, dass zwei Punkte im Selbsttest bestehen: Die Treue nicht bearbeiteter Bereiche erfüllt die Anforderungen, und die Ergebnisse mehrfacher Verarbeitung derselben SKU sind ausreichend konsistent. Wenn die Treue nicht besteht, ist es selbst dann unbrauchbar, wenn es billig ist, denn die Nacharbeitskosten übersteigen die Aufrufkosten.
Kreative Iteration und Designunterstützung: vorsichtig optimistisch
Diese Szenarien stellen hohe Anforderungen an Instruktionsbefolgung und „zufällig gute Ergebnisse“, weniger an absolute Stabilität, und die Fehlertoleranz ist groß. Geeignet für einen ersten Testlauf mit geringem Verkehr, bewertet anhand der Übernahmequote echter Designer statt anhand von Demo-Bildern. Beachte, dass die Aufrufmenge hier durch mehrstufige Bearbeitung vervielfacht wird; führe unbedingt zuerst eine Kosten-Trichter-Kalkulation durch.
Produktionsreife stabile Ausgabe (externe API / automatisierte Pipeline): erst Validierung ergänzen, dann einsetzen
Wenn die Bildgenerierung der Kernpfad deines Produkts ist, ist das Risiko einer Abhängigkeit von einem einzigen Modell hoch. Setze es erst als einzigen Kanal ein, nachdem P99-Latenz, Parallelitätsobergrenze und Fehlerrate bestätigt sind. Empfohlen wird eine Struktur „primär + Backup“.
Fälle, die ausdrücklich nicht empfohlen werden
- Wenn die Anforderung präzises Textlayout und die Reproduktion von Markenschriften umfasst – Bild-zu-Bild-Modelle sind darin generell schwach; erst validieren, dann zusagen.
- Wenn streng reproduzierbare, auditierbare Ausgaben erforderlich sind – erst nach Validierung der Ausgabestabilität in Compliance-Ketten integrieren.
- Wenn die Spezifikationen der Eingabebilder den unterstützten Bereich des Modells überschreiten und keine Vorverarbeitung möglich ist – erst die Vorverarbeitung lösen, dann über die Auswahl sprechen.
Checkliste zur Validierung vor der Integration
Behandle die folgende Liste als Eintrittsschwelle vor dem Go-live und hake jeden Punkt ab.
Eingabeseite
- Unterstützte Eingabebildformate und maximale Auflösung; ob bei Überschreitung ein Fehler gemeldet oder stillschweigend komprimiert wird.
- Strategie zur Behandlung von Seitenverhältnissen: Strecken, Zuschneiden oder Auffüllen, und ob dies die Treue beeinflusst.
- Auslösebedingungen und Rückgabeform von Inhaltskonformitäts-Blockierungen; ob sie programmatisch erkennbar sind oder nur vage Fehler zurückgeben werden.
Aufrufseite
- Parallelitätsobergrenze und Ratenbegrenzungsstrategie: harte QPS-Begrenzung oder Quotenregelung, welcher Statuscode bei Überschreitung zurückgegeben wird.
- Timeout-Einstellung: Bild-zu-Bild schwankt stark in der Dauer; der Client-Timeout sollte größer als der Server-P99 sein, sonst entstehen doppelte Abrechnungen durch „eigentlich erfolgreich, aber Client gibt auf“.
- Idempotenz: ob Wiederholungen doppelte Belastungen erzeugen und ob eine Deduplizierung über Request-IDs möglich ist.
Fehlerbehandlung
- Unterscheidung zwischen wiederholbaren Fehlern (Timeout, Ratenbegrenzung) und nicht wiederholbaren Fehlern (nicht konforme Eingabe, Parameterfehler).
- Für nicht wiederholbare Fehler nutzerlesbare Hinweise gestalten, statt rohe Fehlercodes ans Frontend zu werfen.
- Obergrenzen und Backoff-Strategien für Wiederholungen festlegen, um bei Störungen einen Wiederholungssturm und damit Kostenspiralen zu vermeiden.
Ergebnisseite
- Speicherlösung für Ausgabebilder: Objektspeicher + CDN oder direkte Rückgabe als Base64. Bei großen Bildern ist auf die Größe des Antwortkörpers zu achten.
- Caching-Strategie: ob Ergebnisse bei gleicher Eingabe und gleichen Parametern wiederverwendet werden können und ob es ein geschäftlich zulässiges Cache-Fenster gibt.
- Aufbewahrung von Metadaten: Modellkennung, Parameter, Dauer, ob wiederholt wurde, für spätere Zuordnung und Migrationsvergleiche festhalten.
Bevor die Liste abgearbeitet ist, zählt keine Schlussfolgerung wie „es kann bereits Bilder ausgeben“.
Migrationspfad von bestehenden Modellen und Rollback
Das Risiko der Migration liegt nicht darin, „ob das neue Modell funktioniert“, sondern „ob man zum alten Modell zurückkehren kann“. Gehe die folgenden vier Schritte, um den Wechsel zu einer umkehrbaren Operation zu machen.
Schritt 1: Vergleichs-Evaluationsset aufbauen
Aus dem realen Geschäft Stichproben ziehen, die fünf Kategorien abdecken: einfache Bearbeitung, komplexe Bearbeitung mehrerer Bereiche, Bilder mit Text, Bilder mit Gesichtern, extreme Seitenverhältnisse. Für jede Kategorie quantifizierbare Bestehensstandards definieren (z. B. manuelle Treuebewertung, Trefferquote der Instruktionsbefolgung). Dieses Set vor der Migration aufbauen, nicht erst beim Wechsel spontan Beispiele suchen.
Schritt 2: Parallellauf als Vergleich
Altes und neues Modell parallel auf derselben Stichprobe laufen lassen und die Ausgaben blind bewerten. Auf drei Dinge achten: ob die Gesamtqualität gleichbleibt oder sich verbessert, ob sich die Fehlermuster ändern (ob das neue Modell dort Fehler macht, wo das alte keinen machte) und ob das Kosten-Trichter-Verhältnis akzeptabel ist.
Schritt 3: Graustufen-Rollout
Schrittweise nach Verkehrsanteil umstellen: 1 % → 10 % → 50 % → 100 %. Auf jeder Stufe dieselben Kennzahlen beobachten: Fehlerrate, P99-Latenz, Übernahmequote auf Nutzerseite, Kosten pro lieferbarem Bild. Bei Verschlechterung einer Kennzahl über einen vordefinierten Schwellenwert stoppen. Während der Graustufenphase beide Kanäle beibehalten und das alte Modell nicht vorzeitig abschalten.
Schritt 4: Rollback-Plan
Ein Rollback muss eine Konfigurationsänderung sein, nicht ein Code-Release. Vorgehen: In der Geschäftslogik eine einheitliche Modellaufruf-Abstraktion verwenden, die Modellkennung über Konfiguration steuern; Rollback = Konfiguration ändern + neu laden, in Minuten erledigt. Gleichzeitig zwei Dinge sicherstellen: Die Zugriffsrechte auf das alte Modell bleiben für eine gewisse Zeit nach der Migration erhalten; die während der Migration erzeugten Ergebnis-Metadaten reichen aus, um zu bestimmen, welche Anfragen betroffen waren.
Alten Code nach der Migration nicht vorschnell löschen
Mindestens einen vollständigen Geschäftszyklus beibehalten. Qualitätsprobleme bei Bild-zu-Bild zeigen sich oft erst bei bestimmten Eingabeverteilungen; eine kurze Beobachtungsphase reicht nicht aus.
Kombinierte Nutzung auf einer Aggregationsplattform
Die Abhängigkeit von einem einzigen Modell ist das am leichtesten übersehene Risiko im Bild-zu-Bild-Geschäft: Modellschwankungen, Anpassungen der Ratenbegrenzung, Änderungen der Fähigkeitsgrenzen – jedes davon trifft direkt deine Produktkette. Wenn du über eine einheitliche Schnittstelle mehrere Bildmodelle gleichzeitig anbindest, werden diese Risiken zu konfigurierbaren Größen.
Drei praktische Kombinationen
- A/B-Aufteilung: Verkehr nach Nutzer oder Szenario auf verschiedene Modelle verteilen und anhand echter Übernahmequoten statt Offline-Evaluationen das Hauptmodell bestimmen. Die einheitliche Schnittstelle macht die Aufteilung zu einer Änderung eines einzigen Felds.
- Fähigkeits-Routing: Bearbeitungsaufgaben nach Typ zuweisen – treueempfindliche an ein Modell, kreative Exploration an ein anderes. Die Routing-Logik ist zentralisiert und leicht anzupassen.
- Fallback-Absicherung: Bei Überschreitung von Fehlerrate oder Latenz des Hauptmodells automatisch auf ein Backup-Modell wechseln, damit die Kette nicht unterbrochen wird. Beim Fallback ist die Anpassung der Prompts mitzudenken; verschiedene Modelle können auf dieselbe Instruktion unterschiedlich reagieren.
Der technische Nutzen
Eine einheitliche Schnittstelle bedeutet, dass Authentifizierung, Abrechnung, Logging und Wiederholungsstrategien nur einmal implementiert werden müssen; das Hinzufügen oder Ersetzen von Modellen ist eine Konfigurationsänderung statt Integrationsarbeit. Für Teams, die kontinuierlich Modellauswahl betreiben, spart das langfristige Integrationskosten, nicht nur einmaligen Anbindungsaufwand.
Ob man sich letztlich für gpt-image-2.6-sunburst/image-to-image entscheidet oder nicht – nur wenn man es in dasselbe Vergleichsraster, denselben Kosten-Trichter und denselben Graustufen-Mechanismus einordnet, ist die Schlussfolgerung belastbar. Kandidatenmodelle über eine einheitliche Schnittstelle nebeneinander laufen zu lassen, überzeugt mehr als zehn Testberichte zu lesen.
Ähnliche Artikel
Alle Artikel ansehen →-

Vergleichstest
Gemini Omni 1.2 Flash Auswahl-Checkliste: Eingabemodi, Spezifikationen und Budget
Eingabemodi, Spezifikationen, Budget und Effektgrenzen prüfen und die Auswahl mit eigenen Stichproben abnehmen
-
Vergleichstest
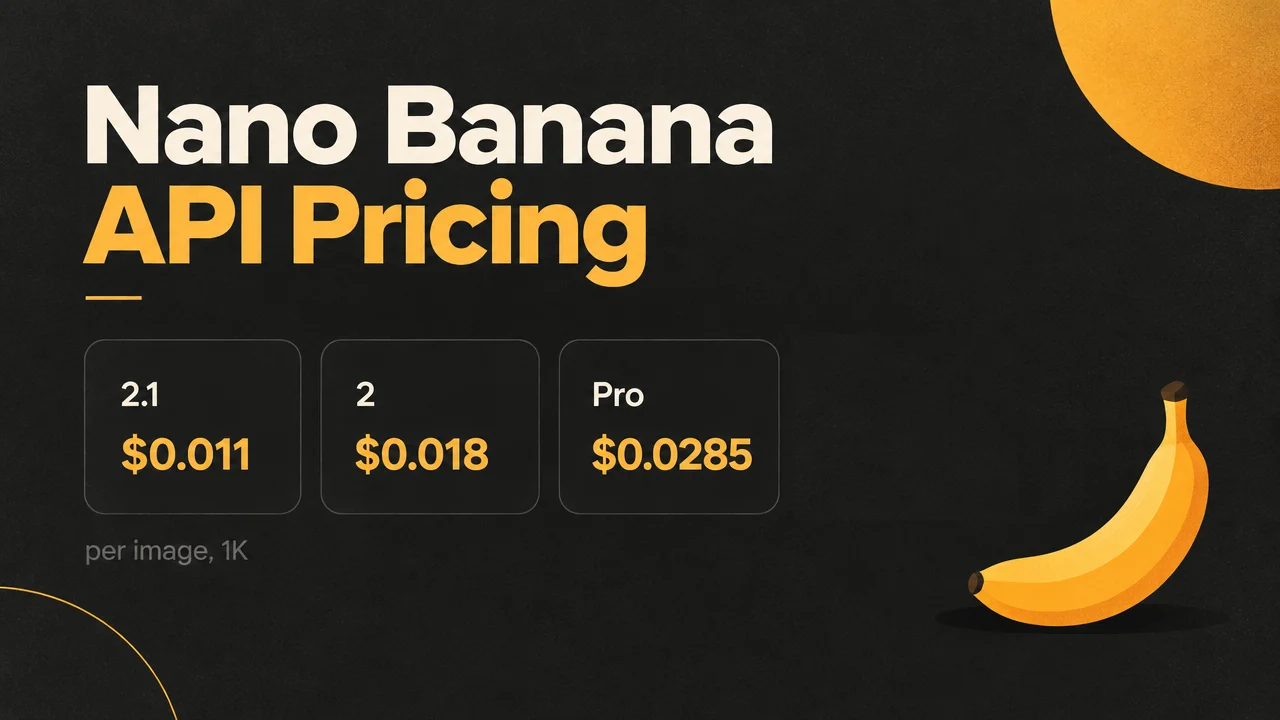
Nano Banana Black Friday: unter 1 Cent pro Bild – Vergleich von 2.1, 2 und Pro mit demselben Prompt
Reguläre Preise und Black-Friday-Preise der drei Versionen 2.1, 2 und Pro, Bildvergleich mit demselben Prompt
-
Vergleichstest
Black Friday AI-Video-API-Preise: Bei Veo, Seedance und Kling bis zu ca. 23 % pro Sekunde sparen
Veo 3.1, Seedance und Kling 3.0: Preise pro Sekunde, pro Clip und Black-Friday-Umrechnungspreis