
Confronto e valutazione
gpt-image-2.6-sunburst/image-to-image confronto orizzontale: come scegliere un modello image-to-image e migrare
Dai confini di capacità al costo per immagine fino al costo di migrazione: la checklist di scelta per i team di ingegneria
In questa pagina
Prima leggiamo a fondo le informazioni note: cosa si può confermare di questo modello
Prima di discutere «se sceglierlo o no», analizziamo a fondo le informazioni presenti sulla scheda del modello gpt-image-2.6-sunburst/image-to-image. Al momento si possono confermare solo quattro elementi: il fornitore è OpenAI; il tipo di output è immagine; il tag di capacità è image-to-image; il criterio di prezzo è a tariffa per immagine.
Questi quattro elementi corrispondono ciascuno a un tipo di decisione ingegneristica:
- Fornitore = ecosistema e aspettative di conformità. OpenAI come fornitore significa che con ogni probabilità puoi riutilizzare i metodi di autenticazione, lo stile dei codici di errore e le abitudini SDK già esistenti, ma la denominazione specifica dei parametri va comunque verificata sulla documentazione dell'interfaccia al momento dell'integrazione, senza dare per scontato nulla in base all'esperienza.
- Tipo di output = immagine. Non restituisce testo o JSON strutturato, quindi la tua catena di elaborazione deve progettare strategie di archiviazione, distribuzione CDN e caching per risultati binari, non il classico post-processing testuale.
- image-to-image = l'input è un'immagine. Questo lo identifica come modello di editing/trasformazione, non di pura generazione testo-immagine. Dimensioni, formato e conformità dei contenuti dell'immagine di input entrano direttamente nella tua logica di validazione.
- Prezzo per immagine = modello di costo semplice. Rispetto alla fatturazione per token o per secondi di output, la curva di costo a prezzo per immagine è lineare e facile da stimare; ma il prezzo unitario stesso va verificato sul pannello prezzi del sito, in questo articolo non scriviamo cifre specifiche.
Conclusioni che non si possono trarre
La scheda del modello non ti dice fedeltà di editing, forza nel seguire le istruzioni, risoluzione massima di input, quante aree si possono modificare in una singola modifica, limite di concorrenza, latenza P99. Questi sei elementi sono proprio i punti chiave per mettere in produzione l'image-to-image. Vedere «image-to-image» e pensare che sia in grado di cambiare sfondo, fare inpainting locale, trasferimento di stile, sostituzione di testo non è rigoroso — queste capacità variano enormemente e vanno verificate con il tuo set di campioni.
In sintesi di questa sezione: le informazioni note bastano per inserirlo nel pool dei candidati, ma non per decidere direttamente.
Quali dimensioni confrontare nella scelta di un image-to-image
Di fronte a qualsiasi modello image-to-image, consigliamo di valutare sempre con lo stesso insieme fisso di dimensioni, invece di scegliere ogni volta a impressione. Le sei dimensioni seguenti coprono le principali aree di rischio, dall'efficacia alle operazioni.
1. Fedeltà di editing
Se il modello riesce a «modificare solo ciò che va modificato». Metodo di test: preparare un lotto di immagini di input contenenti volti, testo, texture fini (tessuti, peli), eseguire modifiche locali e verificare se le aree non modificate sono state silenziosamente alterate. Una scarsa fedeltà provoca la deriva dei dettagli nelle immagini prodotto, ed è un criterio di esclusione assoluto per l'e-commerce.
2. Aderenza alle istruzioni
La coerenza tra istruzioni in linguaggio naturale e output. Tre punti da osservare: quantità («sostituisci con tre vasi» restituisce davvero tre?), posizione («aggiungi un contrassegno nell'angolo in alto a sinistra» è davvero in alto a sinistra?), istruzioni negative («non cambiare lo sfondo» viene rispettato?). Le istruzioni negative sono un ottimo indicatore per distinguere la maturità di un modello.
3. Stabilità dell'output
Con lo stesso input + gli stessi parametri, quanto varia il risultato su più chiamate. Per pipeline che richiedono riproducibilità (ad esempio la generazione in batch della stessa serie di materiali), una varianza eccessiva fa schizzare i costi di revisione a valle.
4. Latenza e throughput
Non guardare solo la media, ma P95/P99 e la curva di degrado della latenza all'aumentare della concorrenza. L'image-to-image è di solito più lento del testo-immagine, perché c'è una codifica dell'input in più.
5. Costo per immagine e criterio di fatturazione
Per un modello a prezzo per immagine, costo = numero di immagini chiamate × prezzo unitario. Ma bisogna chiedere chiaramente: le richieste fallite vengono fatturate? Se vengono restituite più candidate si contano per immagine? Ci sono differenze di fascia per le dimensioni dell'immagine di input?
6. Maturità dell'ecosistema
Completezza della documentazione, leggibilità dei codici di errore, presenza di un identificatore di versione stabile, quantità di materiale della community sulle insidie. Questa dimensione non appare nei benchmark, ma determina se il debug ti costerà giorni o ore.
Suggerimenti per la valutazione
Assegna un peso alle sei dimensioni e poi aggrega; i pesi li decide il business: negli scenari di immagini prodotto alza fedeltà e stabilità; negli strumenti creativi alza aderenza alle istruzioni e latenza. Non usare un unico set di pesi per tutto.
Il costo reale dietro il prezzo per immagine
Il prezzo per immagine sembra pulito, ma il costo aziendale non è mai «numero di richieste × prezzo unitario». In mezzo ci sono tre livelli di perdita: fallimenti, retry e modifiche multi-round.
L'imbuto dei costi
Scomponi una richiesta di business in un imbuto:
- Numero di richieste di modifica avviate da utenti/sistema — è il volume iniziale.
- Numero di fallimenti alla prima chiamata — timeout, rate limiting, input non conformi, rifiuto del modello consumano una chiamata. Se anche i fallimenti vengono fatturati, questa parte è perdita pura.
- Amplificazione dei retry — i retry per fallimento e la «rigenerazione per insoddisfazione» sono due tipi diversi di retry, e il secondo spesso pesa di più. In scenari creativi, dietro un risultato finale possono esserci da qualche a una dozzina di generazioni.
- Modifiche multi-round — i flussi di lavoro reali raramente finiscono in un round: prima cambio lo sfondo, poi regolo il colore, poi correggo i dettagli. Ogni round è una chiamata fatturata.
- Numero finale di immagini consegnabili — questo è il denominatore.
Costo reale per immagine consegnabile = numero totale di immagini chiamate × prezzo unitario ÷ numero finale di immagini consegnabili.
Come abbassare questo rapporto
- Ridurre i retry inutili: fare una pre-validazione dell'immagine di input (dimensioni, formato, conformità dei contenuti) prima della chiamata, bloccando fuori dalla fatturazione le richieste destinate a fallire.
- Consolidare template di prompt: trasformare le operazioni di modifica frequenti in template, riducendo le rigenerazioni casuali «provate e riprovate».
- Distinguere esplorazione e produzione: in fase esplorativa usare bassa risoluzione e modalità rapida; solo in fase di finalizzazione passare a chiamate di alta qualità.
- Registrare l'appartenenza business di ogni chiamata: senza una fatturazione suddivisa per scenario, non saprai mai dove vanno i soldi.
Per il prezzo unitario specifico fai riferimento al pannello prezzi del sito; solo inserendo questo imbuto otterrai numeri utilizzabili per il budget.
Conclusioni per scenario: quando vale la pena sceglierlo
Le valutazioni seguenti si basano sull'insieme di condizioni note «fornitore OpenAI + output immagine + image-to-image + prezzo per immagine», sono suggerimenti orientativi e richiedono comunque una verifica autonoma finale.
Elaborazione in batch di immagini prodotto: vale la pena inserirlo tra i candidati
Il modello di costo lineare a prezzo per immagine è favorevole agli scenari batch, il budget è prevedibile. Il presupposto è superare due autotest: fedeltà delle aree non modificate adeguata e risultati sufficientemente coerenti su elaborazioni multiple dello stesso SKU. Se la fedeltà non è adeguata, per quanto economico non si può usare, perché il costo di rilavorazione supera quello della chiamata.
Iterazione creativa e supporto al design: cauto ottimismo
Questi scenari richiedono molto in termini di aderenza alle istruzioni e di «risultati inaspettatamente buoni», poco in termini di stabilità assoluta, con ampio margine di tolleranza. Adatti a un avvio pilota a basso traffico, valutando con il tasso di adozione dei designer reali, non con le immagini demo. Attenzione: qui il volume di chiamate si amplifica per le modifiche multi-round, quindi fai prima il calcolo dell'imbuto dei costi.
Output stabile di livello produttivo (API esterna / pipeline automatizzate): completa prima le verifiche
Se la generazione di immagini è il percorso centrale del tuo prodotto, il rischio di dipendenza da un singolo modello è alto. Prima di confermare latenza P99, limite di concorrenza e tasso di errore, non impostarlo come canale unico. Consigliamo un'architettura «principale + backup».
Casi esplicitamente sconsigliati
- Requisiti che includono composizione tipografica precisa e riproduzione del font del brand — i modelli image-to-image generalmente non sono bravi in questo, verifica prima di promettere.
- Output di tipo audit con riproducibilità rigorosa — non integrare nella catena di conformità prima di aver verificato la stabilità dell'output.
- Specifiche dell'immagine di input oltre il supporto del modello e non preprocessabili — risolvi prima il preprocessing, poi parla di scelta del modello.
Checklist da verificare prima dell'integrazione
Considera questa checklist come soglia di accesso prima del lancio, spunta ogni voce.
Lato input
- Formati di immagine di input supportati e risoluzione massima; in caso di superamento si ha errore o compressione silenziosa.
- Strategia di gestione del rapporto d'aspetto: stretching, ritaglio o riempimento dei bordi, e se influisce sulla fedeltà.
- Condizioni di attivazione e forma di restituzione del blocco per conformità dei contenuti, se è riconoscibile dal programma e non solo un errore vago.
Lato chiamata
- Limite di concorrenza e strategia di rate limiting: limite QPS rigido o sistema a quote, quale codice di stato viene restituito al superamento.
- Impostazione dei timeout: l'image-to-image ha tempi molto variabili, il timeout lato client deve essere maggiore del P99 lato server, altrimenti si producono addebiti duplicati per «in realtà riuscito ma il client ha rinunciato».
- Idempotenza: i retry producono addebiti duplicati, si può deduplicare con l'ID richiesta.
Gestione degli errori
- Distinguere errori ritentabili (timeout, rate limiting) da errori non ritentabili (input non conforme, parametri errati).
- Progettare messaggi leggibili dall'utente per gli errori non ritentabili, invece di lanciare il codice di errore grezzo al frontend.
- Impostare limite massimo di retry e strategia di backoff, per evitare che una tempesta di retry in caso di guasto amplifichi i costi.
Lato risultati
- Soluzione di archiviazione delle immagini di output: object storage + CDN, oppure restituzione diretta base64. Per le immagini grandi attenzione alla dimensione del corpo della risposta.
- Strategia di cache: se lo stesso input + gli stessi parametri possono riutilizzare il risultato, e se esiste una finestra di cache consentita dal business.
- Conservazione dei metadati: registrare identificatore del modello, parametri, tempo impiegato, se è stato un retry, per facilitare l'attribuzione successiva e il confronto in migrazione.
Prima di completare la checklist, qualsiasi conclusione del tipo «ormai riesce a generare immagini» non vale.
Percorso di migrazione da un modello esistente e rollback
Il rischio della migrazione non è «se il nuovo modello funziona», ma «se si può tornare indietro al vecchio». Segui questi quattro passi per rendere il passaggio un'operazione reversibile.
Primo passo: costruire un set di valutazione comparativa
Campionare dal business reale, coprendo cinque categorie: modifiche semplici, modifiche complesse multi-area, immagini con testo, immagini con volti, rapporti d'aspetto estremi. Definire per ciascuna categoria criteri di superamento quantificabili (ad esempio punteggio manuale di fedeltà, tasso di successo nell'aderenza alle istruzioni). Questo set va costruito prima della migrazione, non cercare campioni all'ultimo momento al momento del passaggio.
Secondo passo: doppia esecuzione comparativa
Eseguire in parallelo vecchio e nuovo modello sullo stesso lotto di campioni, con valutazione cieca dell'output. Osservare tre cose: se la qualità complessiva è pari o migliorata, se cambiano le modalità di fallimento (dove il vecchio modello non sbagliava, il nuovo sbaglia?), se il rapporto dell'imbuto dei costi è accettabile.
Terzo passo: rilascio graduale
Passare gradualmente per percentuale di traffico: 1% → 10% → 50% → 100%. A ogni livello osservare lo stesso set di indicatori: tasso di errore, latenza P99, tasso di adozione lato utente, costo per immagine consegnabile. Fermarsi se un indicatore peggiora oltre la soglia prestabilita. Durante il rilascio graduale mantenere il doppio canale, non disattivare in anticipo il vecchio modello.
Quarto passo: piano di rollback
Il rollback deve essere una modifica di configurazione, non un rilascio di codice. Approccio: a livello di business usare un'astrazione unificata per le chiamate ai modelli, con l'identificatore del modello in configurazione; rollback = modifica della configurazione + refresh, completato in pochi minuti. Confermare anche due cose: i permessi di accesso al vecchio modello restano validi per un certo periodo dopo la migrazione; i metadati dei risultati prodotti durante la migrazione sono sufficienti per capire quali richieste sono state influenzate.
Dopo la migrazione non affrettarti a cancellare il vecchio codice
Conservalo per almeno un ciclo di business completo. I problemi di qualità dell'image-to-image spesso emergono solo con particolari distribuzioni di input, un periodo di osservazione breve non basta a coprirle.
Uso combinato su una piattaforma aggregata
La dipendenza da un singolo modello è il rischio più facilmente trascurato nel business dell'image-to-image: fluttuazioni del modello, aggiustamenti del rate limiting, cambiamenti dei confini di capacità, ognuno di questi colpisce direttamente la catena del tuo prodotto. Integrare contemporaneamente più modelli di immagine tramite un'interfaccia unificata trasforma questi rischi in voci configurabili.
Tre combinazioni pratiche
- Suddivisione A/B: distribuire il traffico a modelli diversi per utente o per scenario, decidendo il modello principale con il tasso di adozione reale invece che con valutazioni offline. L'interfaccia unificata permette di cambiare la suddivisione modificando un solo campo.
- Routing per capacità: assegnare i compiti di modifica per tipo — quelli sensibili alla fedeltà a un modello, l'esplorazione creativa a un altro. La logica di routing è centralizzata in un unico punto, facile da regolare.
- Fallback di degrado: quando il tasso di errore o la latenza del modello principale supera la soglia, passare automaticamente al modello di riserva, garantendo la continuità della catena. Il degrado va considerato insieme all'adattamento dei prompt, perché modelli diversi possono rispondere diversamente allo stesso comando.
Vantaggi ingegneristici
L'interfaccia unificata significa che autenticazione, fatturazione, log, strategie di retry vanno implementati una sola volta; aggiungere o sostituire modelli è una modifica di configurazione, non un lavoro di integrazione. Per i team che devono continuamente selezionare modelli, questo risparmia costi di integrazione a lungo termine, non solo il tempo di un singolo collegamento.
Indipendentemente dal fatto che alla fine si scelga gpt-image-2.6-sunburst/image-to-image, solo valutandolo all'interno dello stesso framework di confronto, dello stesso imbuto dei costi e dello stesso meccanismo di rilascio graduale la conclusione sarà solida. Mettere i modelli candidati fianco a fianco tramite un'interfaccia unificata è più convincente che leggere dieci recensioni.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Checklist di selezione di Gemini Omni 1.2 Flash: modalità di input, specifiche e budget
Verifica modalità di input, specifiche, budget e confini degli effetti, e completa la validazione di selezione con i tuoi campioni
-
Confronto e valutazione
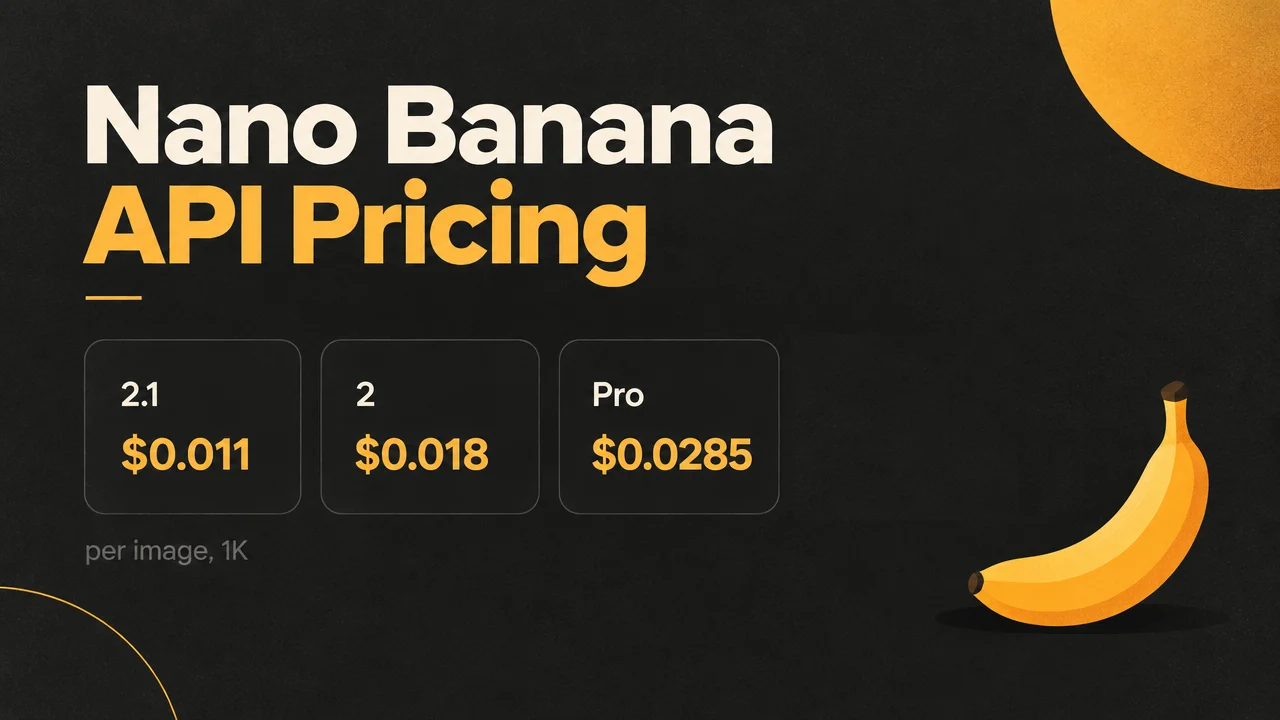
Nano Banana Black Friday, meno di 1 centesimo per immagine: confronto tra 2.1, 2 e Pro con lo stesso prompt
Prezzo pieno e prezzo Black Friday delle tre versioni 2.1, 2 e Pro, con confronto delle immagini generate dallo stesso prompt
-
Confronto e valutazione
Prezzi delle API video AI per il Black Friday: Veo, Seedance e Kling costano fino al 23% in meno al secondo
Prezzi al secondo e per video di Veo 3.1, Seedance e Kling 3.0, con i prezzi scontati del Black Friday