
Avaliação comparativa
gpt-image-2.6-sunburst/image-to-image comparação lateral: como escolher e migrar modelos de imagem para imagem
Das fronteiras de capacidade ao custo por imagem e custo de migração, uma checklist de seleção para equipes de engenharia
Nesta página
Primeiro leia a fundo as informações conhecidas: o que este modelo permite confirmar
Antes de discutir "escolher ou não", é preciso destrinchar completamente as informações do cartão do modelo gpt-image-2.6-sunburst/image-to-image. Atualmente, só é possível confirmar quatro itens: o fornecedor é OpenAI; o tipo de saída é imagem; o rótulo de capacidade é image-to-image; o critério de precificação é por imagem.
Cada um desses quatro itens corresponde a um tipo de decisão de engenharia:
- Fornecedor = expectativas de ecossistema e conformidade. Sendo a OpenAI o fornecedor, isso significa que você provavelmente pode reutilizar os métodos de autenticação, o estilo de códigos de erro e os costumes de SDK já existentes, mas a nomenclatura específica dos parâmetros ainda deve seguir a documentação da interface no momento da integração; não presuma com base em experiência.
- Tipo de saída = imagem. Ele não retorna texto nem JSON estruturado, portanto seu pipeline de processamento precisa projetar armazenamento, distribuição via CDN e estratégias de cache para resultados binários, em vez de usar o pós-processamento de texto.
- image-to-image = a entrada é uma imagem. Isso o define como um modelo de edição/transformação, não de geração puramente por texto. As dimensões, o formato e a conformidade de conteúdo da imagem de entrada entram diretamente na sua lógica de validação.
- Precificação por imagem = modelo de custo simples. Comparado à cobrança por token ou por segundo de saída, a curva de custo por imagem é linear e fácil de estimar; mas o preço unitário em si deve seguir o painel de preços do site, e este artigo não traz números específicos.
Conclusões que não se pode tirar disso
O cartão do modelo não informa fidelidade de edição, intensidade de aderência a instruções, resolução máxima de entrada, quantas regiões uma única edição consegue alterar, limite de concorrência, latência P99. Esses seis itens são justamente os pontos críticos para colocar imagem-para-imagem em produção. Ver "image-to-image" e assumir que ele dá conta de troca de fundo, repintura local, transferência de estilo e substituição de texto é imprudente — essas capacidades variam enormemente e precisam ser verificadas com seu próprio conjunto de amostras.
Resumindo esta seção em uma frase: as informações conhecidas bastam para colocá-lo no pool de candidatos, mas não para você decidir diretamente.
Quais dimensões comparar na seleção de imagem para imagem
Diante de qualquer modelo image-to-image, recomenda-se pontuar sempre com o mesmo conjunto fixo de dimensões, em vez de escolher por impressão a cada vez. As seis dimensões abaixo cobrem os principais riscos, do efeito à operação.
1. Fidelidade de edição
Se o modelo consegue "alterar apenas o que deve ser alterado". Método de teste: prepare um lote de imagens de entrada contendo rostos, texto e texturas finas (tecidos, pelos), faça edições locais e verifique se as áreas não editadas foram alteradas silenciosamente. Fidelidade ruim causa deriva de detalhes em imagens de produto, o que é um item eliminatório no cenário de e-commerce.
2. Aderência a instruções
A consistência entre instruções em linguagem natural e a saída. Observe três pontos: quantidade ("troque por três vasos" realmente entrega três), posição ("adicione uma marca no canto superior esquerdo" fica no canto superior esquerdo), instruções negativas ("não altere o fundo" é respeitado). Instruções negativas são uma boa sonda para distinguir a maturidade do modelo.
3. Estabilidade da saída
Com a mesma entrada + os mesmos parâmetros em múltiplas chamadas, qual é a variância do resultado. Para pipelines que exigem reprodutibilidade (como geração em lote de materiais da mesma série), variância excessiva dispara o custo de revisão a jusante.
4. Latência e throughput
Não olhe apenas a média, mas P95/P99 e a curva de degradação da latência com o aumento da concorrência. Imagem-para-imagem costuma ser mais lento que texto-para-imagem, porque há uma codificação extra da entrada.
5. Custo por imagem e critério de cobrança
Para modelos com precificação por imagem, custo = número de imagens chamadas × preço unitário. Mas é preciso esclarecer: requisições com falha são cobradas, múltiplos candidatos retornados contam por imagem, há diferença de faixa por dimensão da imagem de entrada.
6. Maturidade do ecossistema
Completude da documentação, legibilidade dos códigos de erro, existência de identificação estável de versão, quantidade de material da comunidade sobre armadilhas. Este item não aparece em benchmarks, mas determina se a solução de problemas levará dias ou horas.
Sugestão de pontuação
Defina pesos para as seis dimensões e agregue; os pesos são determinados pelo negócio: no cenário de imagens de produto, eleve fidelidade e estabilidade; no cenário de ferramentas criativas, eleve aderência a instruções e latência. Não use um único conjunto de pesos para tudo.
O custo real por trás do preço por imagem
A cotação por imagem parece limpa, mas o custo de negócio nunca é "número de requisições × preço unitário". No meio há três camadas de perda: falhas, retentativas e edições em múltiplas rodadas.
Funil de custo
Desmembre uma necessidade de negócio em um funil:
- Número de requisições de edição iniciadas por usuário/sistema — este é o seu volume inicial.
- Número de falhas na primeira chamada — timeout, limitação de taxa, entrada não conforme e recusa do modelo consomem uma chamada. Se falhas também são cobradas, essa parte é perda pura.
- Amplificação por retentativas — retentativa por falha e regeneração por "resultado insatisfatório" são naturezas diferentes; a segunda costuma dominar. Em cenários criativos, uma peça final pode estar por trás de várias a mais de dez gerações.
- Edições em múltiplas rodadas — fluxos reais raramente terminam em uma rodada: primeiro troca o fundo, depois ajusta a cor, depois retoca detalhes. Cada rodada é uma chamada cobrada.
- Número final de imagens entregáveis — este é o denominador.
Custo real por imagem entregável = total de imagens chamadas × preço unitário ÷ total de imagens finalmente entregáveis.
Como reduzir essa razão
- Reduzir retentativas inválidas: faça pré-validação da imagem de entrada antes da chamada (dimensões, formato, conformidade de conteúdo), bloqueando fora da cobrança as requisições fadadas ao fracasso.
- Fixar modelos de prompt: sedimente operações de edição frequentes em templates, reduzindo regenerações aleatórias por "tentativa e erro".
- Separar exploração de produção: na fase de exploração, use baixa resolução e modo rápido; só na fase de definição final faça chamadas de alta qualidade.
- Registrar a atribuição de negócio de cada chamada: sem faturas separadas por cenário, você nunca saberá onde o dinheiro foi gasto.
Consulte o painel de preços do site para o preço unitário específico; só aplicando o funil acima você chega a números utilizáveis para orçamento.
Conclusões por cenário: quando vale a pena escolhê-lo
Os julgamentos abaixo baseiam-se no conjunto de condições conhecidas "fornecedor OpenAI + saída de imagem + image-to-image + precificação por imagem" e são recomendações direcionais; a confirmação final ainda depende de testes próprios.
Processamento em lote de imagens de produto: vale entrar como candidato
O modelo linear de custo por imagem é amigável para cenários em lote, com orçamento previsível. O pré-requisito é passar em dois testes: fidelidade das áreas não editadas dentro do padrão e resultados suficientemente consistentes ao processar o mesmo SKU várias vezes. Se a fidelidade não passar, nem mais barato serve, porque o custo de retrabalho supera o custo de chamada.
Iteração criativa e apoio a design: otimismo cauteloso
Esses cenários exigem muito de aderência a instruções e de "bons resultados inesperados", e pouco de estabilidade absoluta, com ampla margem de erro. Convém começar com pouco tráfego e pontuar pela taxa de adoção de designers reais, não por imagens de demonstração. Atenção: o volume de chamadas aqui será amplificado por edições em múltiplas rodadas; faça primeiro o cálculo do funil de custo.
Saída estável em nível de produção (API externa / pipeline automatizado): complete as validações antes de subir
Se a geração de imagens é o elo central do seu produto, o risco de depender de um único modelo é alto. Antes de confirmar latência P99, limite de concorrência e taxa de erro, não o defina como canal único. Recomenda-se integrar com estrutura "principal + backup".
Situações claramente não recomendadas
- Requisitos que incluem tipografia precisa de texto e reprodução de fontes de marca — modelos imagem-para-imagem geralmente não são bons nisso; verifique antes de prometer.
- Necessidade de saídas auditáveis estritamente reprodutíveis — não integre ao pipeline de conformidade antes de validar a estabilidade da saída.
- Especificações da imagem de entrada fora do suporte do modelo e sem possibilidade de pré-processamento — resolva o pré-processamento antes de discutir seleção.
Checklist a validar antes da integração
Trate a lista abaixo como critério de entrada antes do lançamento e marque item por item.
Lado da entrada
- Formatos de imagem de entrada suportados e resolução máxima; ao exceder, há erro ou compressão silenciosa.
- Estratégia de tratamento de proporção: esticar, cortar ou preencher bordas, e se isso afeta a fidelidade.
- Condições de acionamento e forma de retorno do bloqueio de conformidade de conteúdo; se é identificável por programa em vez de retornar apenas um erro vago.
Lado da chamada
- Limite de concorrência e política de limitação de taxa: é limite rígido de QPS ou sistema de cota, e qual código de status é retornado ao exceder.
- Configuração de timeout: o tempo de imagem-para-imagem varia muito; o timeout do cliente deve ser maior que o P99 do servidor, caso contrário haverá cobrança duplicada por "sucesso no servidor, desistência no cliente".
- Idempotência: retentativas geram cobrança duplicada, e se é possível deduplicar por request ID.
Tratamento de erros
- Distinguir erros retentáveis (timeout, limitação de taxa) de erros não retentáveis (entrada não conforme, erro de parâmetro).
- Projetar mensagens legíveis para o usuário em erros não retentáveis, em vez de lançar o código de erro bruto ao frontend.
- Definir limite máximo de retentativas e estratégia de backoff, evitando que uma tempestade de retentativas em falhas amplie o custo.
Lado do resultado
- Solução de armazenamento da imagem de saída: object storage + CDN, ou retorno direto em base64. No retorno de imagens grandes, atenção ao tamanho do corpo da resposta.
- Estratégia de cache: se mesma entrada + mesmos parâmetros podem reutilizar resultado e se há janela de cache permitida pelo negócio.
- Retenção de metadados: registrar identificação do modelo, parâmetros, tempo gasto e se houve retentativa, facilitando atribuição posterior e comparação de migração.
Antes de concluir a lista, qualquer conclusão de "já consegue gerar imagem" não vale.
Caminho de migração a partir de modelos existentes e rollback
O risco da migração não está em "se o novo modelo funciona", mas em "se o modelo antigo pode ser restaurado". Siga os quatro passos abaixo para tornar a troca uma operação reversível.
Primeiro passo: construir conjunto de avaliação comparativa
Amostre do negócio real, cobrindo cinco categorias: edição simples, edição complexa com múltiplas regiões, imagens com texto, imagens com rostos e proporções extremas. Defina critérios quantificáveis de aprovação para cada categoria (como pontuação humana de fidelidade e taxa de acerto de aderência a instruções). Construa esse conjunto antes da migração; não procure amostras às pressas na hora da troca.
Segundo passo: execução dupla em paralelo
Rode modelos novo e antigo em paralelo sobre o mesmo lote de amostras e faça avaliação cega. Observe três coisas: se a qualidade geral se mantém ou melhora, se os modos de falha mudam (onde o modelo antigo não errava, o novo erra) e se a razão do funil de custo é aceitável.
Terceiro passo: liberação gradual
Mude progressivamente por proporção de tráfego: 1% → 10% → 50% → 100%. Em cada faixa, observe o mesmo conjunto de indicadores: taxa de erro, latência P99, taxa de adoção no lado do usuário e custo por imagem entregável. Pare se qualquer indicador degradar além do limite predefinido. Durante o período gradual, mantenha os dois canais; não desative o modelo antigo antecipadamente.
Quarto passo: plano de rollback
O rollback deve ser uma mudança de configuração, não um deploy de código. Faça assim: na camada de negócio, use uma abstração unificada de chamada de modelo, com o identificador do modelo vindo de configuração; rollback = alterar configuração + recarregar, concluído em minutos. Ao mesmo tempo, confirme duas coisas: as permissões de acesso ao modelo antigo permanecem por um período após a migração; os metadados de resultados gerados durante a migração bastam para você julgar quais requisições foram afetadas.
Não apague o código antigo com pressa após a migração
Mantenha-o por pelo menos um ciclo completo de negócio. Problemas de qualidade em imagem-para-imagem costumam aparecer apenas sob distribuições específicas de entrada; observação de curto prazo não cobre isso.
Uso combinado em plataformas agregadoras
A dependência de um único modelo é o risco mais negligenciado no negócio de imagem-para-imagem: instabilidade do modelo, ajuste de limitação de taxa, mudança de fronteiras de capacidade — qualquer um atinge diretamente o pipeline do seu produto. Integrar simultaneamente vários modelos de imagem por uma interface unificada transforma esses riscos em itens configuráveis.
Três combinações práticas
- Distribuição A/B: direcionar o tráfego a modelos diferentes por usuário ou por cenário, decidindo o modelo principal pela taxa real de adoção e não por avaliação offline. A interface unificada faz a distribuição mudar apenas um campo.
- Roteamento por capacidade: despachar tarefas de edição por tipo — um modelo para sensibilidade à fidelidade, outro para exploração criativa. A lógica de roteamento fica concentrada em um lugar, facilitando ajustes.
- Fallback de degradação: alternar automaticamente para o modelo de backup quando a taxa de erro ou a latência do principal exceder o limite, garantindo que o pipeline não pare. A degradação deve considerar também a adaptação de prompts, pois modelos diferentes podem responder de forma distinta à mesma instrução.
Ganhos de engenharia
Interface unificada significa que autenticação, cobrança, logs e estratégias de retentativa precisam ser implementados apenas uma vez; adicionar ou substituir modelos é mudança de configuração, não trabalho de integração. Para equipes que precisam fazer seleção contínua de modelos, isso economiza custo de integração de longo prazo, não apenas tempo de conexão pontual.
Independentemente de escolher ou não gpt-image-2.6-sunburst/image-to-image no final, só se sustenta uma conclusão avaliando-o dentro do mesmo framework de comparação, do mesmo funil de custo e do mesmo mecanismo de liberação gradual. Rodar os modelos candidatos lado a lado por uma interface unificada convence mais do que ler dez avaliações.
Artigos relacionados
Ver todos os artigos →-

Avaliação comparativa
Lista de verificação de seleção do Gemini Omni 1.2 Flash: modos de entrada, especificações e orçamento
Verifique modos de entrada, especificações, orçamento e limites de efeito, e conclua a validação de seleção com seus próprios exemplos
-
Avaliação comparativa
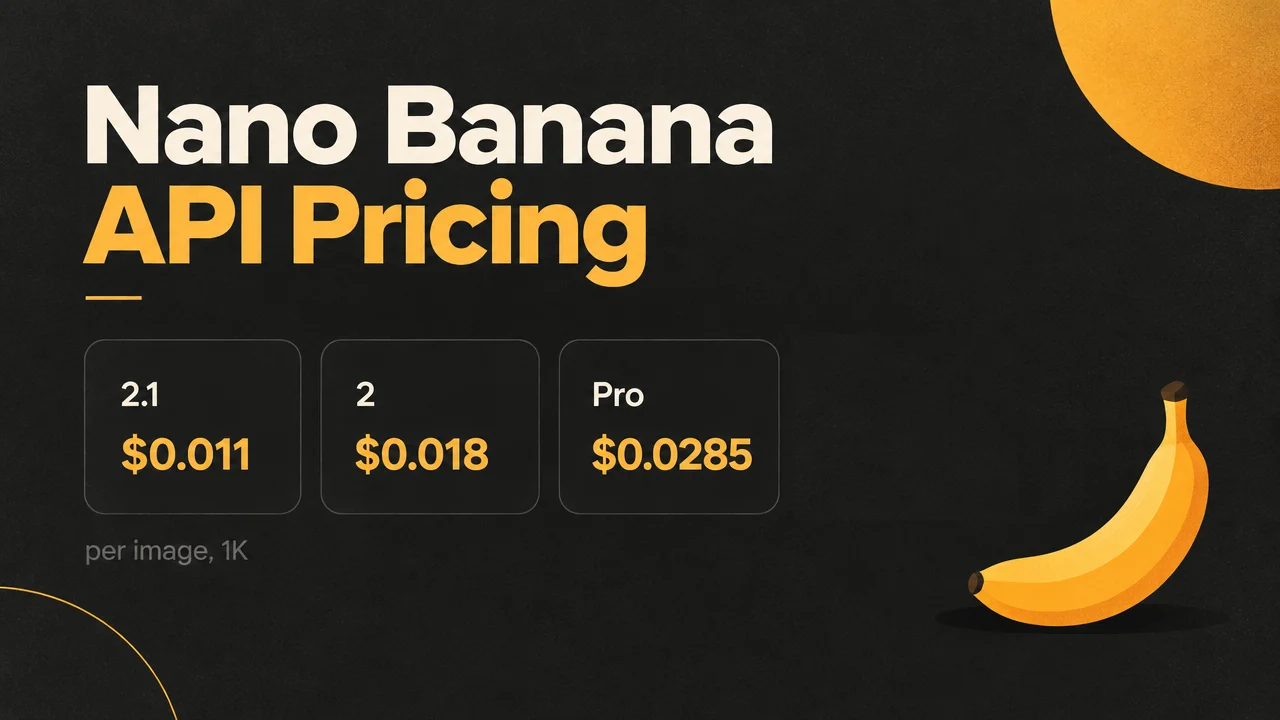
Nano Banana na Black Friday: menos de 1 centavo por imagem — comparação de 2.1, 2 e Pro com o mesmo prompt
Preços originais e de Black Friday das três versões 2.1, 2 e Pro, com comparação de imagens geradas a partir do mesmo prompt
-
Avaliação comparativa
Preços da API de vídeo de IA na Black Friday: Veo, Seedance e Kling economizam até cerca de 23% por segundo
Preços por segundo, por clipe e com desconto de Black Friday do Veo 3.1, Seedance e Kling 3.0