
Guide d'utilisation
API de génération d'images et de vidéos hiapi : guide complet de la plateforme
Ce que propose réellement hiapi — chaque modèle d'image et de vidéo du catalogue, une tarification unifiée par tâche, un point de terminaison /v1/tasks unique, et un extrait de code Python prêt à copier pour démarrer.
Aperçu rapide
hiapi est une passerelle d'API de génération d'images et de vidéos qui rassemble plus d'une dizaine de modèles de production sous un seul contrat HTTP. Si vous avez déjà dû intégrer trois SDK génératifs différents juste pour livrer une fonctionnalité, cette page est faite pour vous. En résumé :
- Un seul point de terminaison, plusieurs modèles. Toutes les capacités — texte-vers-image, image-vers-image, texte-vers-vidéo, image-vers-vidéo — passent par le point de terminaison asynchrone
POST /v1/tasks. Ce que vous changez, c'est le champmodel, pas le SDK. - Modèles d'image actuellement au catalogue :
nano-banana,nano-banana-2,nano-banana-pro,flux-1.1-pro,gpt-image-2(plus les variantes-betaet-pro),gpt-image-2/image-to-image(plus-pro),qwen-image-2.0. - Modèles vidéo actuellement au catalogue :
wan2.7-video/text-to-video,wan2.7-video/image-to-video,seedance-2.0,happyhorse-1.0. Résolutions de 480p à 1080p. - Facturation à la tâche terminée, pas au token. 0,02 $ génère un rendu
gpt-image-2/text-to-image@beta; 0,05 $ génère une image Nano-Banana ou FLUX 1.1 Pro à prix uniforme ; 0,729 $ la seconde génère une séquence vidéo Seedance en 1080p. - Pas de roulette russe des niveaux de qualité. Les tarifs sont publiés en temps réel sur
/api/pricing, avec un hachage de version, ce qui permet à votre code de facturation de s'épingler à une version connue et de lever une erreur explicite dès que l'amont change.
Il s'agit de la page de résultats de recherche de la marque — une présentation complète de ce qu'est réellement la plateforme, à qui elle s'adresse et combien elle coûte. Les quatre images de cet article ont été rendues par quatre modèles hébergés par hiapi, afin que vous puissiez voir à quoi ressemble le résultat final.
Qu'est-ce que hiapi
hiapi est une passerelle hébergée. Vous pointez un client HTTP authentifié par jeton Bearer vers api.hiapi.ai, envoyez une tâche asynchrone, puis recevez une URL CDN contenant l'image ou la vidéo rendue. Derrière ce contrat unique se trouvent plusieurs fournisseurs de modèles — la gamme FLUX de Black Forest Labs, la ligne de produits Nano-Banana construite sur les modèles d'image Google Gemini, la gamme gpt-image-2 d'OpenAI, les modèles vidéo Qwen-Image et Wan2.7 d'Alibaba, les modèles vidéo Seedance de ByteDance, ainsi que HappyHorse.
Ainsi, hiapi ne vend pas « un modèle » — elle vend « une forme d'intégration ». Si vous avez une application interne qui doit générer des visuels marketing, des maquettes de produits ou de courtes vidéos promotionnelles, vous pouvez tester en A/B deux modèles complètement différents en changeant une chaîne de caractères, le reste du code fonctionnel restant inchangé.
L'autre chose que hiapi vend, de toute évidence, c'est la facturation en un seul endroit. Une facture, un solde, une limite de débit — au lieu de trois.
Modèles d'image
Voici le catalogue d'images complet au moment de la rédaction, récupéré en direct depuis /api/pricing :
| Modèle | Catégorie | Prix du palier le plus bas | Remarques |
|---|---|---|---|
nano-banana |
texte-vers-image | 0,05 $ prix uniforme | Itération rapide ; prend uniquement en charge le format d'image, sans multiplicateur de résolution |
nano-banana-2 |
texte-vers-image | 0,057 $ (2K) — 0,036 $ (1K) — 0,086 $ (4K) | Sortie 4K ; rendu de texte précis |
nano-banana-pro |
texte-vers-image | 0,057 $ (1K/2K) — 0,10 $ (4K) | La meilleure qualité de la gamme Banana |
flux-1.1-pro |
texte-vers-image | 0,05 $ prix uniforme | Portraits photoréalistes, rendu de courts textes |
gpt-image-2 |
texte-vers-image | 0,03 $ (1K) — 0,04 $ (2K) — 0,06 $ (4K) | Le cheval de trait du quotidien |
gpt-image-2/text-to-image@beta |
texte-vers-image | 0,02 $ | Brouillons à bas coût |
gpt-image-2.5-flare@pro |
texte-vers-image | 0,0172 $ (bas) — 0,7143 $ (max), tarif selon le niveau de qualité | Visuels principaux haute fidélité |
gpt-image-2/image-to-image |
image-vers-image | 0,03 $ → 0,06 $ | Même tarif que les variantes t2i |
qwen-image-2.0 |
texte-vers-image | 0,0422 $ prix uniforme | Excellent rendu de texte en chinois, japonais et coréen, structure de requête de style DashScope |
Quelques précisions que le tableau ne montre pas :
La catégorie de tarification est un prix forfaitaire par appel, et non par token. Vous payez une fois pour une image terminée. La longueur du prompt n'a aucune importance. Cela rend les traitements par lots prévisibles : 10 000 appels à gpt-image-2 coûtent 300 $, sans condition supplémentaire.
nano-banana et flux-1.1-pro sont à prix uniforme pour tous les formats d'image. Pas de supplément 16:9, pas de remise portrait — que ce soit un avatar carré ou une image fixe de film en 21:9, vous payez les mêmes 0,05 $.
Les modèles qui acceptent le paramètre resolution utilisent le image_quality_price_ratio que vous voyez dans la tarification en direct. Ne codez pas les prix en dur dans votre logique de facturation — lisez le bloc de politique.
Le schéma est propre à chaque modèle, pas uniforme. La plupart des modèles d'image acceptent input.prompt plus input.aspect_ratio. qwen-image-2.0 est de style DashScope — ses entrées se trouvent sous input.input.messages[].content[].text, et les dimensions sont transmises sous forme de chaînes de pixels littérales, comme 1328*1328. Nous avons rencontré ce problème dans notre propre code de production ; construisez un adaptateur modèle→charge utile dès le premier jour.
Le rendu de « FLUX 1.1 Pro » via hiapi
Ce portrait a été généré par flux-1.1-pro au format 3:2, au prix uniforme de 0,05 $. Sans retouche, sans agrandissement.
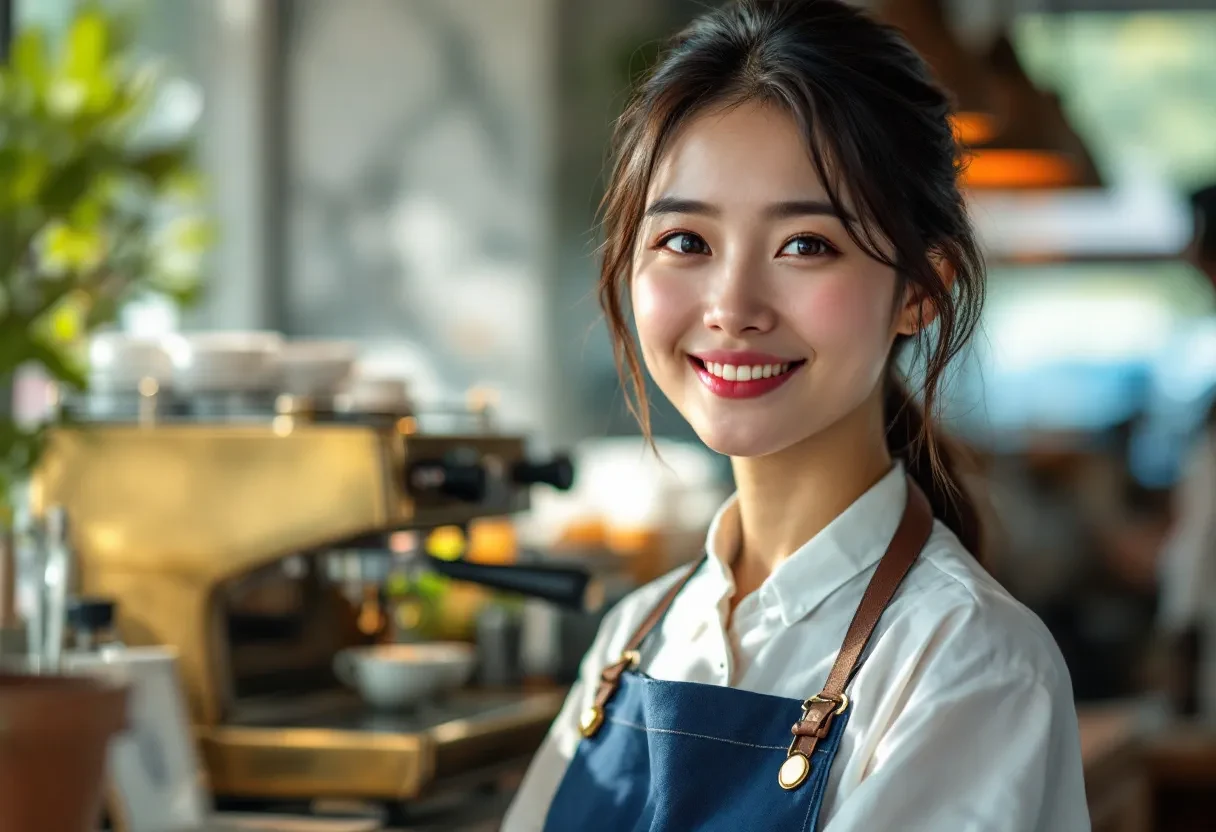
FLUX 1.1 Pro est le choix par défaut pour le photoréalisme sur la plateforme. Les visages, les textures de peau, la lumière directionnelle douce et les courts textes dans l'image sont les domaines où il surpasse régulièrement les paliers moins chers.
Le rendu de qwen-image-2.0 sur hiapi
Voici qwen-image-2.0, au prix actuellement estimé à 0,0422 $ — plus cher que GPT Image 2 en 1K (0,03 $). Les quatre caractères chinois « 陆羽茶馆 » ont été spécifiés dans le prompt et rendus correctement, avec le bon ordre des traits. C'est exactement le type d'image pour lequel Qwen-Image justifie son prix.
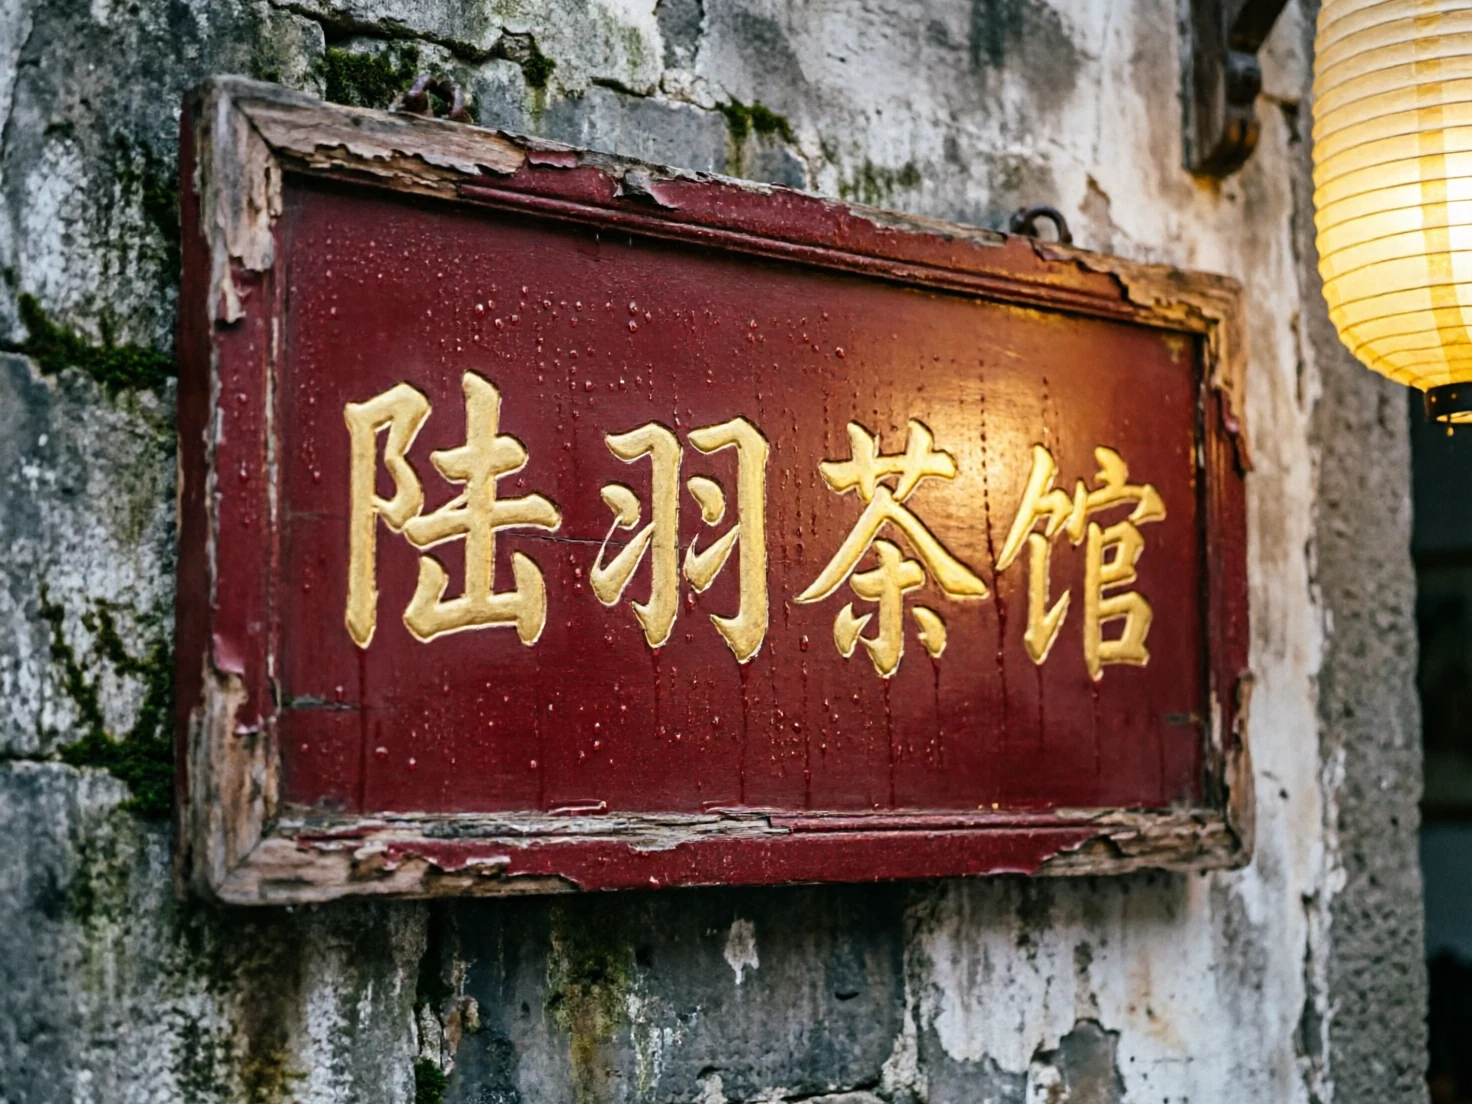
Si votre cas d'usage concerne des fiches produit ou des publications sociales pour les marchés chinois, japonais et coréen, ce palier à 0,0422 $ est difficile à battre en termes de fidélité des glyphes.
Le rendu de gpt-image-2 sur une affiche à forte densité typographique
Cette affiche est issue de gpt-image-2 en 1K (format 3:4, 0,03 $). Un seul aller-retour, sans retouche. Le titre et le sous-titre sont rendus exactement comme spécifié.
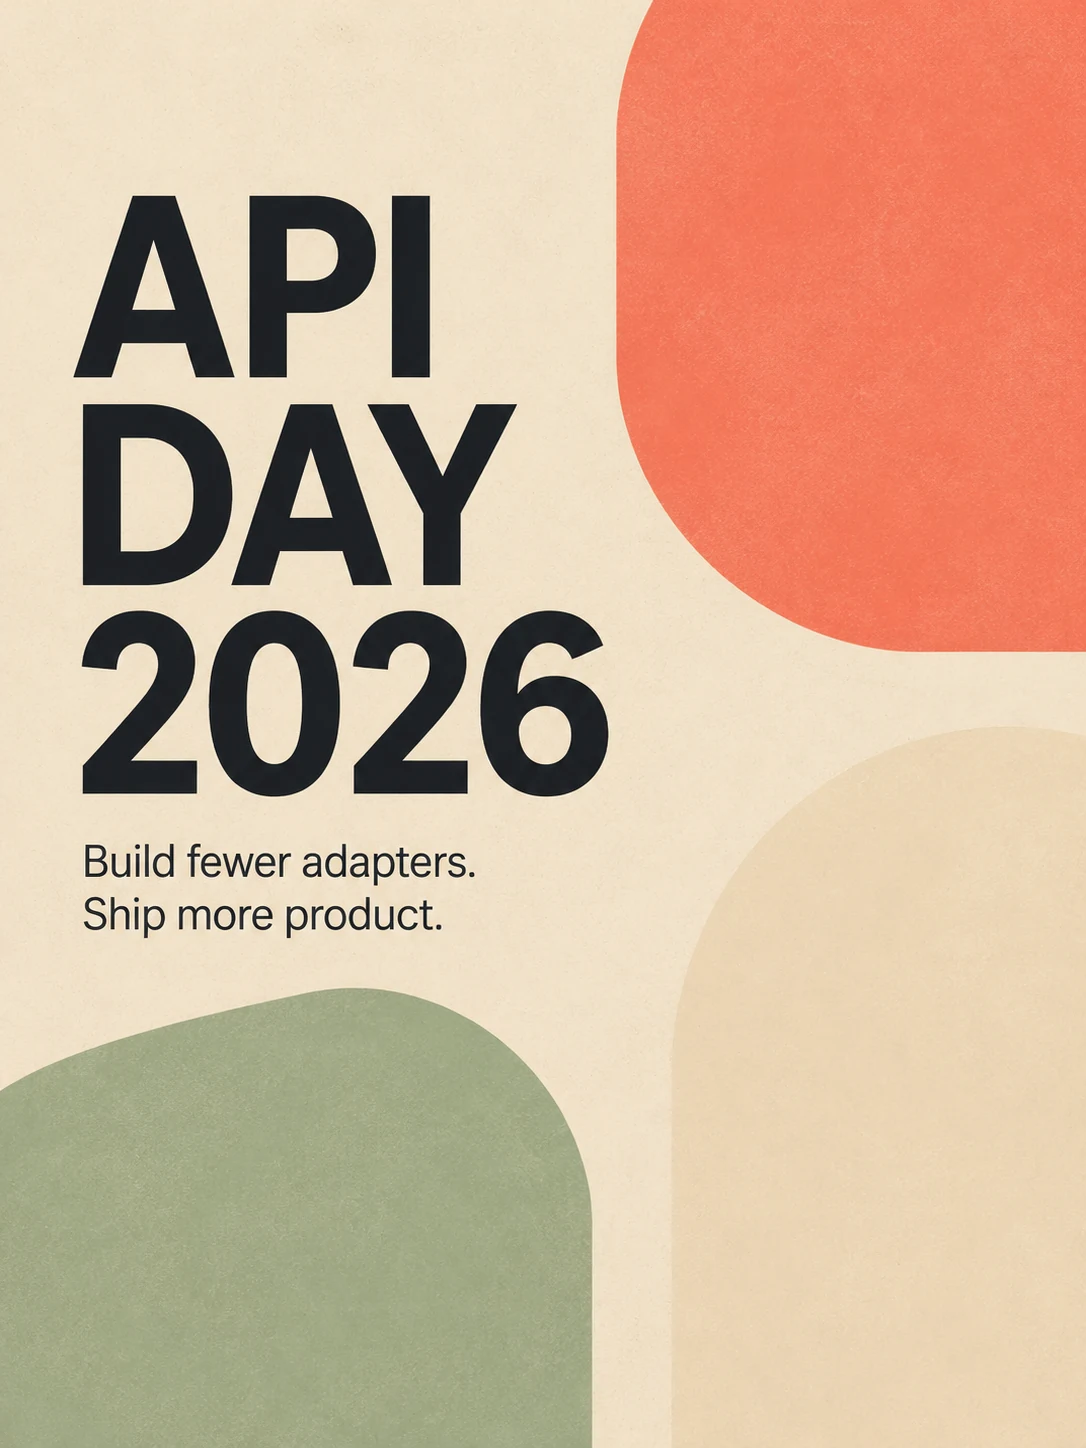
Si vous construisez des outils génératifs pour une équipe marketing — affiches d'événement, cartes sociales, bannières publicitaires — gpt-image-2 est le point de départ par défaut. Il gère de manière fiable des titres de 4 à 6 mots et suit les indications de mise en page de base du prompt.
Modèles vidéo
La vidéo est la moitié la plus récente du catalogue. Au moment de la rédaction :
| Modèle | Catégorie | Prix du palier le plus bas | Prix du palier le plus haut |
|---|---|---|---|
wan2.7-video/text-to-video |
texte-vers-vidéo | 0,10 $ (720P) | 0,167 $ (1080P) |
wan2.7-video/image-to-video |
image-vers-vidéo | 0,10 $ (720P) | 0,167 $ (1080P) |
seedance-2.0 |
texte-vers-vidéo | 0,136 $ (480p) | 0,729 $ (1080p) |
happyhorse-1.0 |
texte-vers-vidéo | 0,168 $ (720p) | 0,288 $ (1080p) |
Deux remarques pratiques :
Wan2.7 est l'option au meilleur rapport qualité-prix pour les courtes boucles produit et les animations conditionnées par image. À 0,10 $ la seconde en 720P, c'est l'une des options vidéo les moins chères de la plateforme.
Seedance 1080p est le palier premium — le saut de 0,136 $ à 0,729 $ reflète la puissance de calcul, pas une marge. Si vous construisez une véritable chaîne de production vidéo plutôt qu'une démo personnelle, vous voudrez réserver le budget Seedance aux plans principaux et confier le reste à Wan2.7.
Les quatre modèles vidéo passent par le même point de terminaison POST /v1/tasks, avec output_type: video — le même schéma d'interrogation répétée puis de téléchargement que les tâches d'image.
Modèle de tarification
Quelques détails que la plupart des équipes découvrent la première fois :
Prix forfaitaire par appel, avec multiplicateur de résolution optionnel. Aucune facturation au token pour les tâches d'image ou de vidéo. Un appel à gpt-image-2 coûte 0,03 $ — que votre prompt fasse 8 mots ou 800. Lorsque le modèle propose plusieurs résolutions, le supplément est intégré dans le tableau policies de la réponse de tarification en direct, allant jusqu'à environ 2 fois le prix de base pour une sortie d'image 4K et environ 5,4 fois pour une vidéo 1080p.
Les tarifs sont versionnés. Chaque modèle dans /api/pricing porte un hachage pricing_version. Si vous déployez un worker de génération, épinglez la version de tarification du modèle dans la configuration et alertez en cas de non-concordance — vous découvrirez ainsi qu'un modèle a été retarifé avant le prochain cycle de facturation, et non après.
Pas de tarification régionale, pas de supplément aux heures de pointe. Le même modèle coûte le même prix quelle que soit la région d'appel et le moment de l'appel. Il n'y a rien de malin à optimiser ici.
Récupérez toujours les tarifs à nouveau. Ne codez pas les prix en dur dans la logique métier. Le point de terminaison /api/pricing est la source de vérité — de même forme que le catalogue public, sans authentification. Nous l'avons récupéré à nouveau au moment de la rédaction, et les prix du tableau proviennent de là.
Architecture des points de terminaison
Tout sur la plateforme — image ou vidéo, texte-vers-X ou X-vers-X — fonctionne via un seul contrat de tâche asynchrone :
POST /v1/tasks
GET  /v1/tasks/{taskId}
Le déroulement :
- Appelez
POST /v1/tasksavec{ "model": "...", "input": { ... } }. Vous recevez immédiatement untaskId. - Interrogez
GET /v1/tasks/{taskId}toutes les quelques secondes. Surveillezdata.status— il passe dependingàsuccess(oufailavec un bloc d'erreur). - En cas de
success, lisezdata.output[0].url. C'est une URL CDN hiapi avec un horodatageexpireAtlimité. Si vous devez conserver la ressource, téléchargez-la et réhébergez-la.
Les anciennes formes /v1/chat/completions et /v1/images/generations ne fournissent plus le service de génération d'images. Si votre code les appelle encore, il faut migrer vers /v1/tasks.
C'est le genre de décision que vous apprécierez plus tard. Le mode tâche vous offre des réessais naturels, des connexions HTTP longue durée sans surveillance, et une forme unifiée pour les images et les vidéos. Vous pouvez lancer 200 soumissions de tâches en 1 seconde et les interroger par lots.
Démarrage rapide en Python (directement exécutable)
Client minimal, sans dépendance SDK. Uniquement la bibliothèque standard :
import json, os, time, urllib.request

TOKEN = os.environ["HIAPI_API_KEY"]
BASE  = "https://api.hiapi.ai"

def submit(model: str, input_payload: dict) -> str:
    body = json.dumps({"model": model, "input": input_payload}).encode()
    req = urllib.request.Request(
        f"{BASE}/v1/tasks",
        data=body,
        headers={
            "Authorization": f"Bearer {TOKEN}",
            "Content-Type":  "application/json",
        },
    )
    with urllib.request.urlopen(req, timeout=60) as r:
        data = json.loads(r.read())
    if data.get("code") != 200:
        raise RuntimeError(f"submit failed: {data}")
    return data["data"]["taskId"]

def wait_for(task_id: str, timeout_s: int = 240) -> str:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        time.sleep(5)
        req = urllib.request.Request(
            f"{BASE}/v1/tasks/{task_id}",
            headers={"Authorization": f"Bearer {TOKEN}"},
        )
        with urllib.request.urlopen(req, timeout=30) as r:
            data = json.loads(r.read())
        task = data.get("data") or {}
        if task.get("status") == "success":
            return task["output"][0]["url"]
        if task.get("status") == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
    raise TimeoutError(f"{task_id} did not finish in {timeout_s}s")

# Image — nano-banana flat $0.05
task_id = submit("nano-banana", {"prompt": "a quiet bookshop at dusk", "aspect_ratio": "3:2"})
print(wait_for(task_id))

# Image — flux-1.1-pro flat $0.05
task_id = submit("flux-1.1-pro", {"prompt": "studio portrait, 50mm lens", "aspect_ratio": "1:1"})
print(wait_for(task_id))

# Video — wan2.7-video/text-to-video at 720P, $0.10 per second
task_id = submit("wan2.7-video/text-to-video", {"prompt": "a koi pond at dawn, gentle ripples", "resolution": "720P"})
print(wait_for(task_id, timeout_s=600))
Avant que ce code soit prêt pour la production, plusieurs choses doivent être intégrées :
- Enveloppez
submitetwait_fordans des réessais avec backoff exponentiel. Les aléas du réseau arrivent toujours. - Utilisez un
poll_intervald'au moins 5 secondes. Interroger plus fréquemment que cela est du travail gaspillé — les tâches d'image se terminent en 10 à 60 secondes, les tâches vidéo en 60 à 180 secondes. - Traitez les URL de sortie comme des ressources temporaires. Les URL CDN ont un
expireAt; si la ressource a une quelconque durée de vie après la requête, téléchargez les octets et stockez-les dans votre propre bucket. - Épinglez une table de correspondance des adaptateurs de modèles.
qwen-image-2.0et quelques modèles vidéo ont des formes d'entrée différentes de celles des formats d'image par défaut — centralisez cette connaissance en un seul endroit.
À qui s'adresse hiapi
Globalement, hiapi s'adresse à trois types d'équipes :
Les équipes lassées d'intégrer un SDK par modèle. Si vous avez déjà maintenu un adaptateur pour les images OpenAI, un autre pour FLUX de Black Forest Labs, et un autre encore pour DashScope d'Alibaba, vous avez ressenti la taxe de productivité qu'imposent N SDK différents. hiapi la réduit à un seul client.
Les équipes qui ont besoin d'une tarification prévisible. La forme du prix forfaitaire par appel vous permet de construire un worker de génération, de consulter le nombre de tâches du mois dernier et de prévoir la facture du mois suivant. C'est difficile à faire avec n'importe quel modèle facturé au token.
Les équipes qui veulent une solution tout-en-un pour l'image et la vidéo. Une fois que votre produit couvre les deux — par exemple un outil marketing qui génère une image de couverture et une boucle de 10 secondes à partir d'un brief — regrouper les deux derrière un seul point de terminaison et un seul solde vaut plus que les économies par image réalisées en s'intégrant directement.
Si vous êtes un amateur qui fait tourner un bot Discord personnel, utiliser directement les API amont ne pose aucun problème. Dès que vous publiez un vrai produit avec de vrais utilisateurs, l'arithmétique de l'intégration penche en faveur de la passerelle.
Questions fréquentes
Y a-t-il un quota gratuit ? Les nouveaux comptes disposent d'un petit crédit de démarrage, pour que vous puissiez tester le point de terminaison sans engagement. Une fois épuisé, vous rechargez votre solde et payez par tâche terminée.
Quels formats d'image sont pris en charge ?
Les ratios courants — 1:1, 3:2, 2:3, 4:3, 3:4, 5:4, 4:5, 16:9, 9:16 et 21:9 — sont disponibles sur la plupart des modèles d'image. qwen-image-2.0, en revanche, utilise une liste fixe de dimensions en pixels littérales ; voir la note sur le schéma du modèle ci-dessus.
Les ressources sont-elles filigranées ? Non. Les sorties sont des fichiers image/vidéo propres, sans identité visuelle hiapi.
Et les limites de débit ? Le mode tâche asynchrone signifie que vous pouvez soumettre un très grand nombre de travaux très rapidement. Il existe des limites par compte pour garantir la stabilité de la plateforme ; si vous avez besoin de plafonds plus élevés, demandez-les avant un pic de lancement — il est bien plus facile d'augmenter une limite un mardi qu'en pleine période de lancement.
Où consulter les tarifs actuels ?
https://www.hiapi.ai/api/pricing. Mise en cache une heure au maximum, avec un pricing_version épinglé pour chaque modèle, de sorte que vous remarquerez tout changement.
Les sorties sont-elles utilisables à des fins commerciales ?
La plupart des modèles de la plateforme disposent en amont d'une licence d'usage commercial — c'est explicitement le cas de la gamme Nano-Banana, de FLUX 1.1 Pro et de Qwen-Image — mais vérifiez l'étiquette de licence du modèle que vous utilisez (le champ tags) dans votre réponse de tarification en direct, car quelques modèles spécialisés ont des conditions plus strictes.
Par où commencer
Si vous voulez essayer depuis zéro :
- Obtenez une clé API depuis votre tableau de bord hiapi.
- Appelez une fois
/api/pricingpour consulter le catalogue de modèles et les tarifs actuels. - Copiez l'extrait Python ci-dessus et exécutez-le sur
nano-bananaougpt-image-2/text-to-image@beta— deux modèles à bas coût, idéaux pour un test de bon fonctionnement. Vous obtiendrez une boucle de bout en bout fonctionnelle pour quelques centimes. - Branchez cette boucle sur ce que vous construisez. Même forme pour la vidéo. Même forme pour l'image-vers-image. Même forme pour le prochain modèle ajouté au catalogue.
C'est tout l'argument de vente : un point de terminaison, un solde, un modèle mental. Les quatre images de cet article — l'illustration de couverture, le portrait photoréaliste, l'enseigne de calligraphie chinoise, l'affiche typographique — ont toutes été rendues avec l'extrait ci-dessus, en ne changeant que la chaîne model et la forme input correcte pour chaque modèle. Le budget actuellement estimé pour ces quatre images est de 0,172 $.
Lorsque le prochain modèle d'image ou de vidéo à la pointe de la technologie arrivera sur la plateforme, votre worker n'aura pas besoin de nouveau code. Il vous suffira de changer une chaîne de caractères.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax