
Benutzerhandbuch
hiapi API für Bild- und Videogenerierung: Der vollständige Plattformleitfaden
Was hiapi tatsächlich bietet – jedes Bild- und Videomodell im Katalog, ein einheitliches Preismodell pro Aufgabe, einen einheitlichen /v1/tasks-Endpunkt und einen Python-Schnellstartcode zum direkten Kopieren.
Auf einen Blick
hiapi ist ein API-Gateway für Bild- und Videogenerierung, das über einen einzigen HTTP-Vertrag mehr als ein Dutzend produktionsreifer Modelle anbindet. Wenn Sie schon einmal drei verschiedene generative SDKs integriert haben, nur um ein einziges Feature live zu schalten, sind Sie auf dieser Seite genau richtig. Die Kurzfassung:
- Ein Endpunkt, viele Modelle. Alle Funktionen – Text-zu-Bild, Bild-zu-Bild, Text-zu-Video, Bild-zu-Video – laufen über den asynchronen
POST /v1/tasks-Endpunkt. Sie ändern das Feldmodel, nicht das SDK. - Bildmodelle im aktuellen Katalog:
nano-banana,nano-banana-2,nano-banana-pro,flux-1.1-pro,gpt-image-2(plus die Varianten-betaund-pro),gpt-image-2/image-to-image(plus-pro),qwen-image-2.0. - Videomodelle im aktuellen Katalog:
wan2.7-video/text-to-video,wan2.7-video/image-to-video,seedance-2.0,happyhorse-1.0. Auflösungen von 480p bis 1080p. - Abrechnung nach abgeschlossenen Aufgaben, nicht nach Tokens. Für $0.02 erhalten Sie ein gerendertes Bild von
gpt-image-2/text-to-image@beta; für $0.05 ein Bild von Nano-Banana oder FLUX 1.1 Pro zum Einheitspreis; für $0.729 pro Sekunde 1080p-Seedance-Videomaterial. - Kein Glücksspiel mit Qualitätsstufen. Die Preise werden live unter
/api/pricingveröffentlicht und mit einem Hash versehen, sodass Ihr Abrechnungscode an eine bekannte Version gebunden werden kann und bei Upstream-Änderungen explizit einen Fehler meldet.
Dies ist eine Marken-Suchergebnisseite – eine vollständige Einführung dazu, was die Plattform ist, für wen sie gedacht ist und was sie kostet. Die vier Bilder in diesem Artikel wurden von vier verschiedenen, von hiapi gehosteten Modellen gerendert, damit Sie sehen, wie die Endergebnisse aussehen.
Was hiapi ist
hiapi ist ein gehostetes Gateway. Sie richten einen HTTP-Client mit Bearer-Token-Authentifizierung auf api.hiapi.ai, senden eine asynchrone Aufgabe ab und erhalten eine CDN-URL mit dem gerenderten Bild oder Video zurück. Hinter diesem einzigen Vertrag stehen mehrere Modellanbieter – die FLUX-Reihe von Black Forest Labs, die auf Googles Gemini-Bildmodellen basierende Nano-Banana-Produktlinie, die gpt-image-2-Reihe von OpenAI, die Qwen-Image- und Wan2.7-Videomodelle von Alibaba, die Seedance-Videomodelle von ByteDance sowie HappyHorse.
hiapi verkauft also nicht „ein Modell“ – es verkauft „eine Integrationsform“. Wenn Sie eine interne Anwendung haben, die Marketingvisuals, Produkt-Mockups oder kurze Werbevideos generieren muss, können Sie zwei völlig unterschiedliche Modelle per A/B-Test vergleichen, indem Sie einen String ändern, während der restliche Arbeitscode unverändert bleibt.
Die andere offensichtliche Sache, die hiapi verkauft, ist Abrechnung an einem Ort. Eine Rechnung, ein Guthaben, ein Rate Limit – statt drei.
Bildmodelle
Hier ist der vollständige Bildkatalog zum Zeitpunkt der Erstellung dieses Artikels, live abgerufen von /api/pricing:
| Modell | Kategorie | Preis der niedrigsten Stufe | Anmerkungen |
|---|---|---|---|
nano-banana |
Text-zu-Bild | $0.05 Einheitspreis | Schnelle Iteration; nur Seitenverhältnisse, keine Auflösungsmultiplikatoren |
nano-banana-2 |
Text-zu-Bild | $0.057 (2K) — $0.036 (1K) — $0.086 (4K) | 4K-Ausgabe; präzise Textdarstellung |
nano-banana-pro |
Text-zu-Bild | $0.057 (1K/2K) — $0.10 (4K) | Höchste Qualität der Banana-Reihe |
flux-1.1-pro |
Text-zu-Bild | $0.05 Einheitspreis | Fotorealistische Porträts, Textdarstellung für kurze Strings |
gpt-image-2 |
Text-zu-Bild | $0.03 (1K) — $0.04 (2K) — $0.06 (4K) | Das Arbeitspferd für den Alltag |
gpt-image-2/text-to-image@beta |
Text-zu-Bild | $0.02 | Kostengünstige Entwürfe |
gpt-image-2.5-flare@pro |
Text-zu-Bild | $0.0172 (niedrig) — $0.7143 (höchste), Preis nach Qualitätsstufe | Hochauflösende Key Visuals |
gpt-image-2/image-to-image |
Bild-zu-Bild | $0.03 → $0.06 | Gleicher Preis wie die t2i-Varianten |
qwen-image-2.0 |
Text-zu-Bild | $0.0422 Einheitspreis | Starke Darstellung chinesischer, japanischer und koreanischer Schrift, DashScope-artige Anfragestruktur |
Einige Punkte, die die Tabelle nicht zeigt:
Preiskategorien sind Pauschalgebühren pro Aufruf, nicht pro Token. Sie zahlen einmal für ein fertiges Bild. Die Länge des Prompts spielt keine Rolle. Das macht Batch-Aufgaben planbar: 10.000 gpt-image-2-Aufrufe kosten $300, ohne Wenn und Aber.
nano-banana und flux-1.1-pro haben bei allen Seitenverhältnissen einen Einheitspreis. Kein 16:9-Aufschlag, kein Hochformat-Rabatt – ob quadratischer Avatar oder 21:9-Kinostandbild, Sie zahlen immer dieselben $0.05.
Modelle, die den Parameter resolution akzeptieren, verwenden die in der Live-Preisliste angegebene image_quality_price_ratio. Hardcodieren Sie keine Preise in Ihrem Abrechnungscode – lesen Sie den Policy-Block.
Das Schema ist modellspezifisch, nicht einheitlich. Die meisten Bildmodelle akzeptieren input.prompt plus input.aspect_ratio. qwen-image-2.0 ist ein DashScope-artiges Modell – seine Eingaben liegen unter input.input.messages[].content[].text, und die Abmessungen werden als wörtliche Pixel-Strings wie 1328*1328 übergeben. Wir sind in unserem eigenen Produktionscode darauf gestoßen; bauen Sie vom ersten Tag an einen Modell-zu-Payload-Adapter.
Wie „FLUX 1.1 Pro“ über hiapi aussieht
Dieses Porträt wurde von flux-1.1-pro im Seitenverhältnis 3:2 erzeugt, zum Einheitspreis von $0.05. Keine Retusche, kein Upscaling.
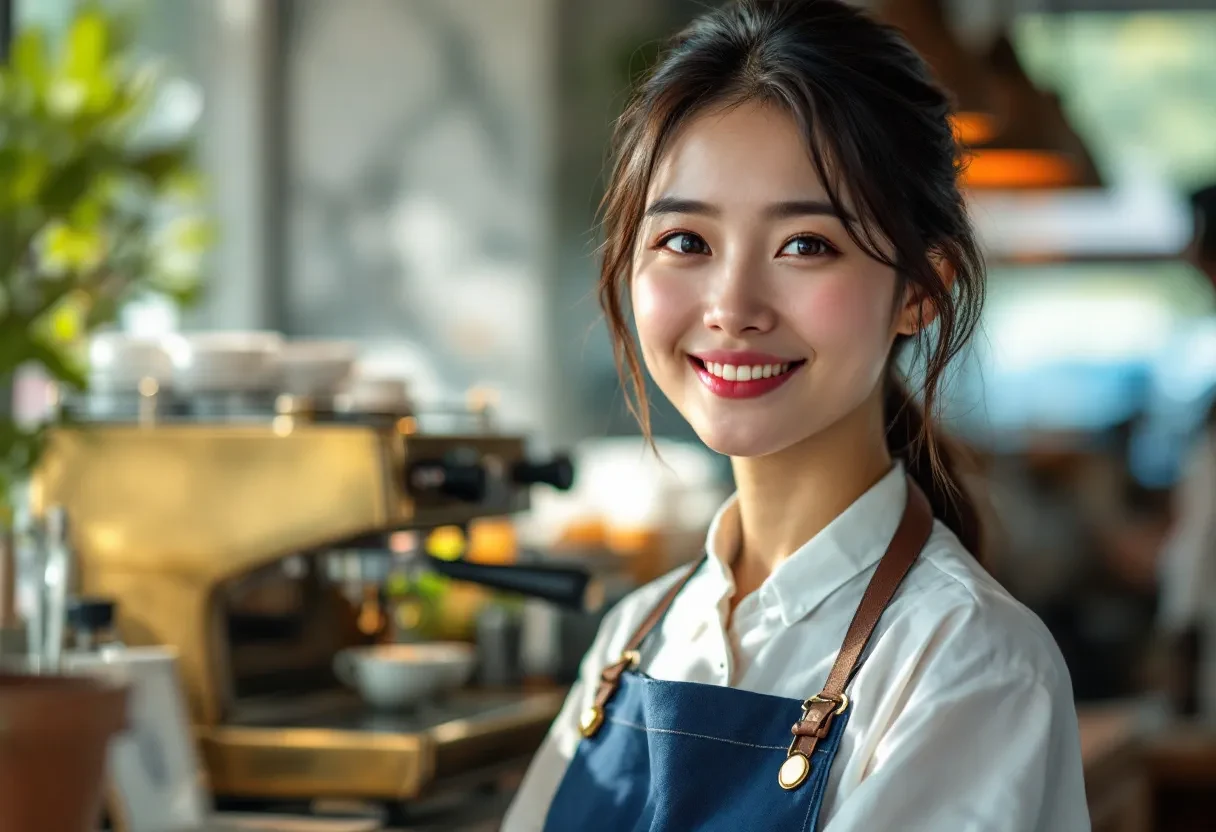
FLUX 1.1 Pro ist die fotorealistische Standardwahl auf der Plattform. Gesichter, Hauttexturen, weiches gerichtetes Licht und kurzer Text im Bild sind die Bereiche, in denen es durchgängig die günstigeren Stufen übertrifft.
Wie qwen-image-2.0 über hiapi aussieht
Das hier ist qwen-image-2.0, aktuell geschätzt auf $0.0422 – teurer als GPT Image 2 in 1K ($0.03). Die vier chinesischen Schriftzeichen „陆羽茶馆“ wurden im Prompt vorgegeben und korrekt gerendert, mit richtiger Strichreihenfolge. Genau das sind die Bilder, bei denen Qwen-Image seinen Preis wert ist.
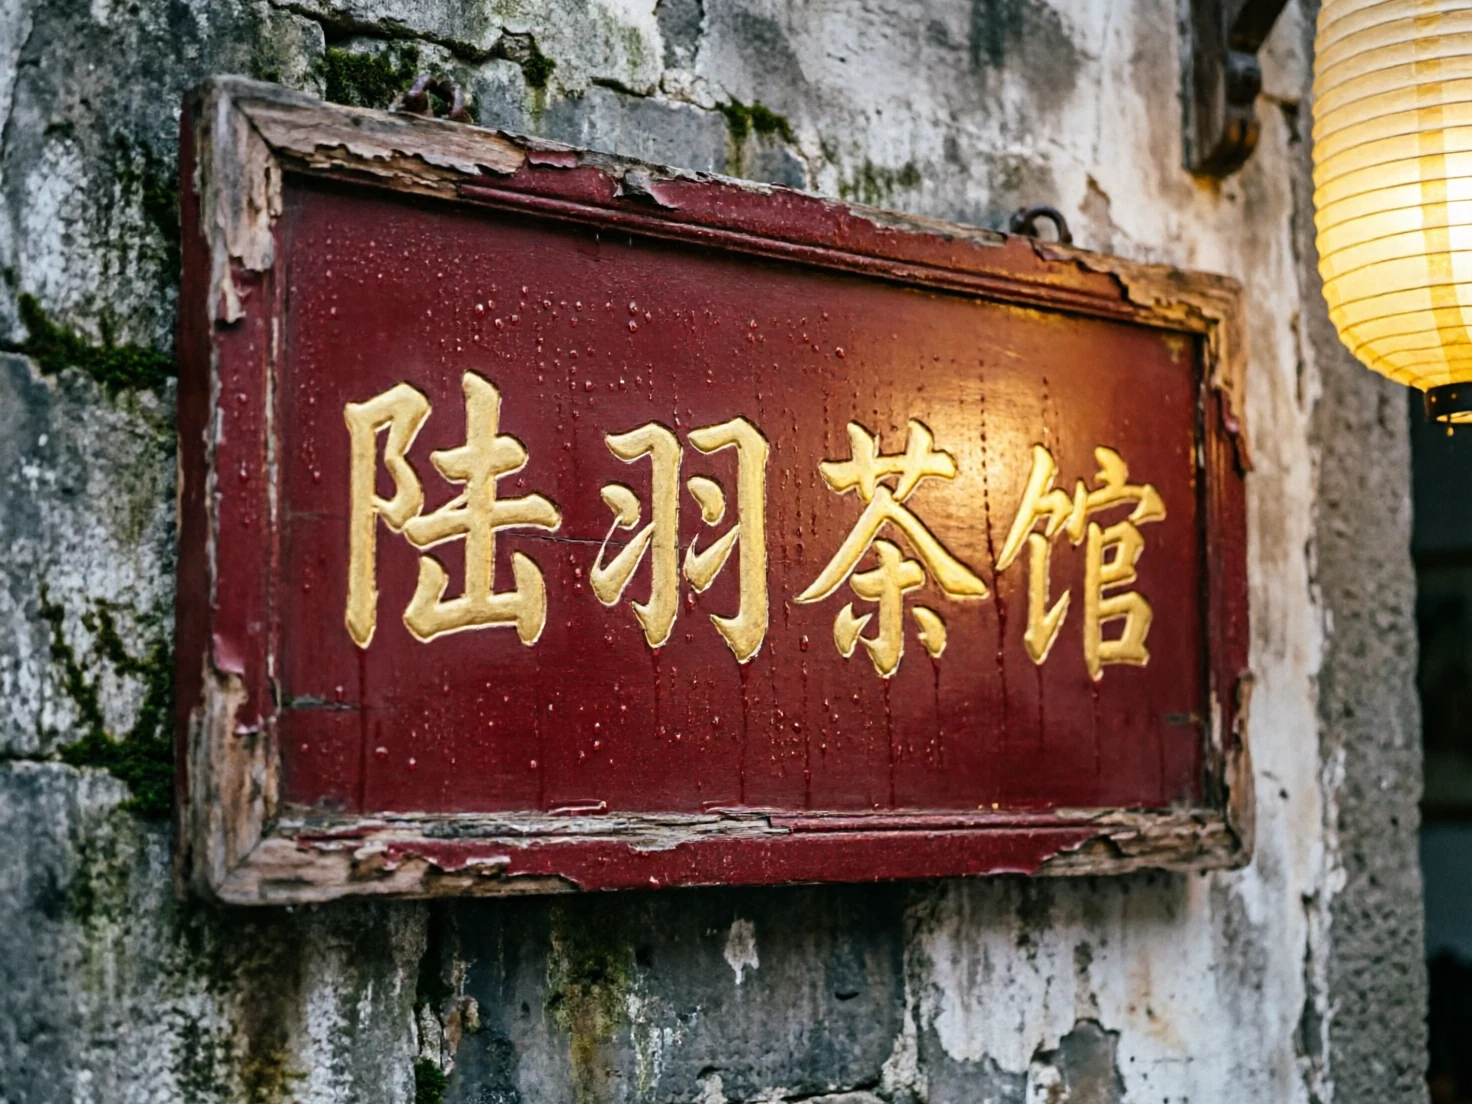
Wenn Ihr Anwendungsfall Produktkarten oder Social-Media-Posts für den chinesischen, japanischen oder koreanischen Markt sind, ist die Stufe zu $0.0422 in puncto rohe Glyphengenauigkeit kaum zu übertreffen.
Wie gpt-image-2 bei typografielastigen Postern aussieht
Dieses Poster stammt von gpt-image-2 in 1K (Seitenverhältnis 3:4, $0.03). Ein Durchlauf, keine Retusche. Titel und Untertitel wurden genau wie angegeben gerendert.
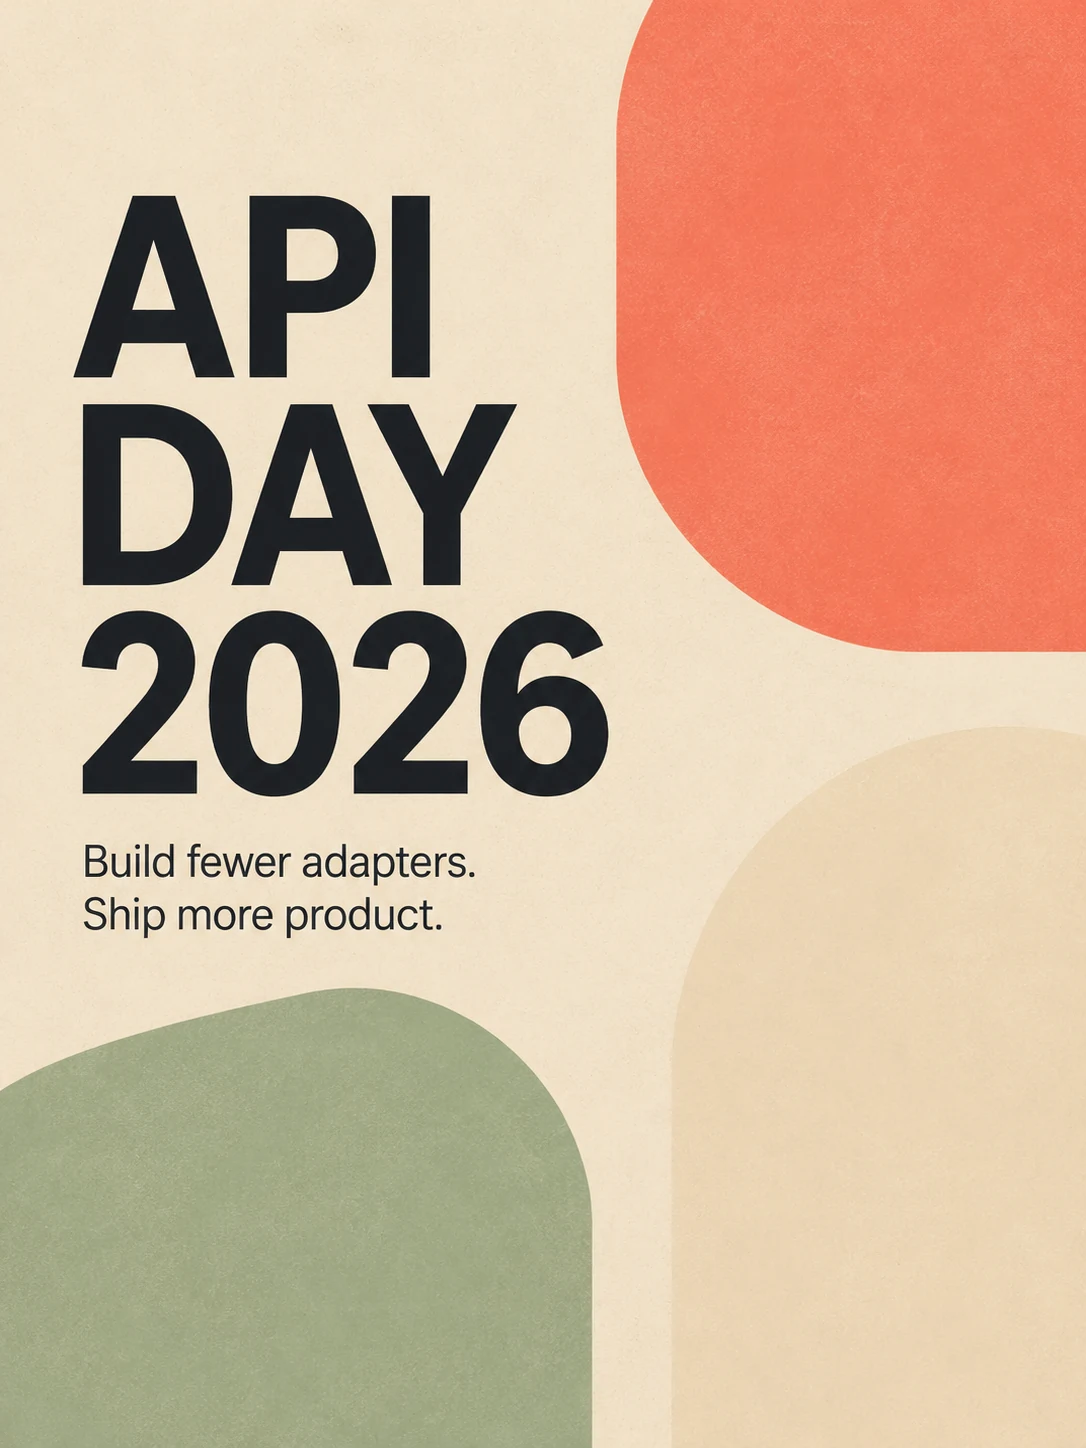
Wenn Sie generative Tools für ein Marketingteam bauen – Event-Poster, Social Cards, Bannerwerbung – ist gpt-image-2 der Standardausgangspunkt. Es fasst zuverlässig Überschriften mit 4–6 Wörtern und folgt grundlegenden Layoutvorgaben im Prompt.
Videomodelle
Video ist die neuere Hälfte des Katalogs. Zum Zeitpunkt der Erstellung dieses Artikels:
| Modell | Kategorie | Preis der niedrigsten Stufe | Preis der höchsten Stufe |
|---|---|---|---|
wan2.7-video/text-to-video |
Text-zu-Video | $0.10 (720P) | $0.167 (1080P) |
wan2.7-video/image-to-video |
Bild-zu-Video | $0.10 (720P) | $0.167 (1080P) |
seedance-2.0 |
Text-zu-Video | $0.136 (480p) | $0.729 (1080p) |
happyhorse-1.0 |
Text-zu-Video | $0.168 (720p) | $0.288 (1080p) |
Zwei praktische Hinweise:
Wan2.7 ist die preisgünstige Wahl für kurze Produkt-Loops und bildkonditionierte Animationen. 720P kostet $0.10 pro Sekunde und ist damit eine der kostengünstigeren Videooptionen der Plattform.
Seedance 1080p ist die Premium-Stufe – der Sprung von $0.136 auf $0.729 spiegelt Rechenleistung wider, keinen Aufschlag. Wenn Sie eine echte Produktvideo-Pipeline statt einer Demo für den Eigengebrauch bauen, sollten Sie das Seedance-Budget für Key-Visual-Aufnahmen reservieren und den Rest Wan2.7 überlassen.
Alle vier Videomodelle werden über denselben POST /v1/tasks-Endpunkt mit output_type: video bereitgestellt – dasselbe Muster aus erst Abfragen, dann Herunterladen wie bei Bildaufgaben.
Das Preismodell
Einige Details, auf die die meisten Teams beim ersten Mal stoßen:
Pauschalgebühr pro Aufruf, optionale Auflösungsmultiplikatoren. Bei Bild- und Videoaufgaben gibt es keine Token-Abrechnung. Ein gpt-image-2-Aufruf kostet $0.03 – egal, ob Ihr Prompt 8 Wörter oder 800 Wörter lang ist. Wenn ein Modell mehrere Auflösungen bietet, sind die Aufschläge bereits im policies-Array der Live-Preisantwort enthalten; 4K-Bildausgaben kosten bis zu etwa das 2-Fache des Basispreises, 1080p-Video etwa das 5,4-Fache.
Die Preise sind versioniert. Jedes Modell in /api/pricing trägt einen pricing_version-Hash. Wenn Sie einen Generierungs-Worker live schalten, binden Sie die Preisversion des Modells in Ihrer Konfiguration und lösen Sie bei Abweichung einen Alarm aus – so erfahren Sie von einer Preisänderung eines Modells vor dem nächsten Abrechnungszeitraum, nicht danach.
Keine regionsabhängigen Preise, keine Stoßzeiten-Aufschläge. Dasselbe Modell kostet gleich viel, egal aus welcher Region und zu welcher Uhrzeit Sie es aufrufen. Hier gibt es nichts Cleveres zu optimieren.
Sie rufen die Preise immer neu ab. Hardcodieren Sie keine Preise in Ihrer Geschäftslogik. Der /api/pricing-Endpunkt ist die Quelle der Wahrheit – mit derselben Form wie der öffentliche Katalog, ohne Authentifizierung. Wir haben ihn zum Zeitpunkt der Erstellung dieses Artikels neu abgerufen, und die Preise in den Tabellen stammen von dort.
Die Endpunkt-Architektur
Alles auf der Plattform – Bild oder Video, Text-zu-X oder X-zu-X – läuft über einen asynchronen Aufgabenvertrag:
POST /v1/tasks
GET  /v1/tasks/{taskId}
Der Ablauf:
- Rufen Sie
POST /v1/tasksmit{ "model": "...", "input": { ... } }auf. Sie erhalten sofort einetaskId. - Fragen Sie alle paar Sekunden
GET /v1/tasks/{taskId}ab. Beobachten Siedata.status– es wechselt vonpendingzusuccess(oder zufailmit einem Fehlerblock). - Bei
successlesen Siedata.output[0].url. Das ist eine hiapi-CDN-URL mit einem begrenztenexpireAt-Zeitstempel. Wenn Sie die Ressource behalten müssen, laden Sie sie herunter und hosten Sie sie erneut.
Die alten Formen /v1/chat/completions und /v1/images/generations bieten keine Bildgenerierung mehr an. Wenn Ihr Code sie noch aufruft, müssen Sie zu /v1/tasks migrieren.
Das ist eine dieser Entscheidungen, für die Sie später dankbar sein werden. Das Aufgabenmodell bietet Ihnen natürliche Wiederholungsversuche, lang laufende HTTP-Verbindungen ohne Betreuung und eine einheitliche Form für Bilder und Videos. Sie können 200 Aufgabenübermittlungen in 1 Sekunde ausstreuen und sie im Batch abfragen.
Python-Schnellstart (direkt ausführbar)
Minimaler Client, keine SDK-Abhängigkeit. Nur die Standardbibliothek:
import json, os, time, urllib.request

TOKEN = os.environ["HIAPI_API_KEY"]
BASE  = "https://api.hiapi.ai"

def submit(model: str, input_payload: dict) -> str:
    body = json.dumps({"model": model, "input": input_payload}).encode()
    req = urllib.request.Request(
        f"{BASE}/v1/tasks",
        data=body,
        headers={
            "Authorization": f"Bearer {TOKEN}",
            "Content-Type":  "application/json",
        },
    )
    with urllib.request.urlopen(req, timeout=60) as r:
        data = json.loads(r.read())
    if data.get("code") != 200:
        raise RuntimeError(f"submit failed: {data}")
    return data["data"]["taskId"]

def wait_for(task_id: str, timeout_s: int = 240) -> str:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        time.sleep(5)
        req = urllib.request.Request(
            f"{BASE}/v1/tasks/{task_id}",
            headers={"Authorization": f"Bearer {TOKEN}"},
        )
        with urllib.request.urlopen(req, timeout=30) as r:
            data = json.loads(r.read())
        task = data.get("data") or {}
        if task.get("status") == "success":
            return task["output"][0]["url"]
        if task.get("status") == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
    raise TimeoutError(f"{task_id} did not finish in {timeout_s}s")

# Image — nano-banana flat $0.05
task_id = submit("nano-banana", {"prompt": "a quiet bookshop at dusk", "aspect_ratio": "3:2"})
print(wait_for(task_id))

# Image — flux-1.1-pro flat $0.05
task_id = submit("flux-1.1-pro", {"prompt": "studio portrait, 50mm lens", "aspect_ratio": "1:1"})
print(wait_for(task_id))

# Video — wan2.7-video/text-to-video at 720P, $0.10 per second
task_id = submit("wan2.7-video/text-to-video", {"prompt": "a koi pond at dawn, gentle ripples", "resolution": "720P"})
print(wait_for(task_id, timeout_s=600))
Bevor dieser Code produktionsreif ist, sollten einige Dinge fest eingebaut werden:
- Umschließen Sie
submitundwait_formit Wiederholungsversuchen und exponentiellem Backoff. Netzwerkaussetzer passieren immer wieder. - Verwenden Sie ein
poll_intervalvon mindestens 5 Sekunden. Häufigeres Abfragen ist verschwendete Arbeit – Bildaufgaben sind in 10–60 Sekunden fertig, Videoaufgaben in 60–180 Sekunden. - Behandeln Sie Ausgabe-URLs als temporäre Ressourcen. CDN-URLs haben ein
expireAt; wenn die Ressource nach der Anfrage noch eine Lebensdauer haben soll, laden Sie die Bytes herunter und speichern Sie sie in Ihrem eigenen Bucket. - Legen Sie eine Modell-Adapter-Zuordnung fest.
qwen-image-2.0und einige Videomodelle haben andere Eingabeformen als die standardmäßigen Bildseitenverhältnisse – bündeln Sie dieses Wissen an einer Stelle.
Für wen hiapi geeignet ist
Grob gesagt ist hiapi für drei Arten von Teams geeignet:
Teams, die es leid sind, für jedes Modell ein eigenes SDK zu integrieren. Wenn Sie schon einmal einen Adapter für OpenAI-Bilder, einen für Black Forest Labs FLUX und einen für Alibabas DashScope gepflegt haben, kennen Sie die Produktivitätssteuer, die N verschiedene SDKs mit sich bringen. hiapi reduziert sie auf einen einzigen Client.
Teams, die planbare Preise brauchen. Die einheitliche Form pro Aufruf ermöglicht es Ihnen, einen Generierungs-Worker zu bauen, die Aufgabenanzahl des letzten Monats anzusehen und die Rechnung des nächsten Monats vorherzusagen. Mit tokenbasierten Modellen ist das kaum möglich.
Teams, die Bildund Video aus einer Hand wollen. Sobald Ihr Produkt beides umfasst – etwa ein Marketingtool, das aus einem Briefing ein Titelbild und einen 10-Sekunden-Loop generiert –, ist es mehr wert, beides hinter einem Endpunkt und einem Guthaben zu haben, als die pro Bild eingesparten Kosten durch direkte Anbindung zu erzielen.
Wenn Sie ein Hobbyist sind, der einen persönlichen Discord-Bot betreibt, ist die direkte Nutzung der Upstream-APIs in Ordnung. Sobald Sie jedoch ein echtes Produkt mit echten Nutzern ausliefern, spricht die Integrationsrechnung für das Gateway.
Häufig gestellte Fragen
Gibt es ein kostenloses Kontingent? Neue Konten erhalten ein kleines Startguthaben, damit Sie den Endpunkt testen können, ohne sich festzulegen. Danach laden Sie Ihr Guthaben auf und zahlen pro abgeschlossener Aufgabe.
Welche Seitenverhältnisse werden unterstützt?
Gängige Verhältnisse – 1:1, 3:2, 2:3, 4:3, 3:4, 5:4, 4:5, 16:9, 9:16 und 21:9 – sind bei den meisten Bildmodellen verfügbar. qwen-image-2.0 verwendet dagegen eine feste Liste wörtlicher Pixelabmessungen; siehe die Schema-Hinweise zum Modell oben.
Haben die Ressourcen ein Wasserzeichen? Nein. Die Ausgaben sind saubere Bild-/Videodateien ohne hiapi-Branding.
Was ist mit Rate Limits? Das asynchrone Aufgabenmodell bedeutet, dass Sie sehr schnell sehr viel Arbeit einreichen können. Es gibt kontobezogene Limits, um die Plattform stabil zu halten; wenn Sie höhere Obergrenzen benötigen, fragen Sie vor einem Release-Höhepunkt an – eine Obergrenze am Dienstag zu erhöhen ist viel einfacher als während eines Releases.
Wo sehe ich die aktuellen Preise?
https://www.hiapi.ai/api/pricing. Höchstens eine Stunde gecacht und mit der pricing_version jedes Modells versehen, sodass Sie Änderungen bemerken.
Sind die Ausgaben kommerziell nutzbar?
Die meisten Modelle auf der Plattform verfügen upstream über eine kommerzielle Nutzungslizenz – die Nano-Banana-Reihe, FLUX 1.1 Pro und Qwen-Image ausdrücklich –, aber prüfen Sie das Lizenz-Tag des von Ihnen verwendeten Modells (das Feld tags) in Ihrer Live-Preisantwort, da einige spezialisierte Modelle strengere Bedingungen haben.
Wo Sie anfangen sollten
Wenn Sie von null anfangen möchten:
- Holen Sie sich einen API-Schlüssel aus Ihrem hiapi-Dashboard.
- Rufen Sie einmal
/api/pricingauf, um den aktuellen Modellkatalog und die Preise zu sehen. - Kopieren Sie den Python-Schnipsel oben und führen Sie ihn mit
nano-bananaodergpt-image-2/text-to-image@betaaus – beides kostengünstige Modelle, ideal für einen Plausibilitätstest. Für ein paar Cent erhalten Sie einen funktionierenden End-to-End-Zyklus. - Binden Sie diesen Zyklus in das ein, was Sie gerade bauen. Gleiche Form für Video. Gleiche Form für Bild-zu-Bild. Gleiche Form für das nächste Modell, das in den Katalog kommt.
Das ist das ganze Verkaufsargument: ein Endpunkt, ein Guthaben, ein mentales Modell. Die vier Bilder in diesem Artikel – die Titelillustration, das fotorealistische Porträt, das chinesische Kalligrafieschild und das Typografie-Poster – wurden alle mit dem obigen Schnipsel gerendert, nur mit unterschiedlichen model-Strings und der jeweils korrekten input-Form. Das aktuelle geschätzte Budget für diese vier Bilder beträgt $0.172.
Wenn das nächste hochmoderne Bild- oder Videomodell auf der Plattform landet, braucht Ihr Worker keinen neuen Code. Sie ändern nur einen String.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte