
Guía de uso
API de generación de imágenes y vídeo de hiapi: guía completa de la plataforma
Qué ofrece exactamente hiapi: cada modelo de imagen y vídeo del catálogo, un modelo de precios unificado por tarea, el endpoint unificado /v1/tasks y un fragmento de código Python listo para copiar y poner en marcha.
Visión rápida
hiapi es una puerta de enlace de API de generación de imágenes y vídeo que integra más de una docena de modelos de nivel de producción bajo un único contrato HTTP. Si alguna vez has tenido que integrar tres SDK generativos distintos solo para lanzar una función, esta página es para ti. Resumen rápido:
- Un endpoint, muchos modelos. Todas las capacidades —texto a imagen, imagen a imagen, texto a vídeo, imagen a vídeo— se ejecutan a través del endpoint asíncrono
POST /v1/tasks. Lo que cambias es el campomodel, no el SDK. - Modelos de imagen en el catálogo actual:
nano-banana,nano-banana-2,nano-banana-pro,flux-1.1-pro,gpt-image-2(más las variantes-betay-pro),gpt-image-2/image-to-image(más-pro) yqwen-image-2.0. - Modelos de vídeo en el catálogo actual:
wan2.7-video/text-to-video,wan2.7-video/image-to-video,seedance-2.0,happyhorse-1.0. Resoluciones de 480p a 1080p. - Se factura por tarea completada, no por token. $0.02 generan una imagen renderizada con
gpt-image-2/text-to-image@beta; $0.05 generan una imagen de Nano-Banana o FLUX 1.1 Pro a precio único; $0.729 por segundo generan material de vídeo Seedance en 1080p. - Sin ruleta de niveles de calidad. Los precios se publican en tiempo real en
/api/pricing, con una versión con hash, de modo que tu código de facturación puede fijarse a una versión conocida y fallar de forma explícita en cuanto cambie el proveedor.
Esta es la página de resultados de búsqueda de la marca: una presentación completa de qué es exactamente la plataforma, para quién es y cuánto cuesta. Las cuatro imágenes de este artículo han sido renderizadas por cuatro modelos distintos alojados en hiapi, para que puedas ver cómo es el resultado final.
Qué es hiapi
hiapi es una puerta de enlace gestionada. Apuntas un cliente HTTP con autenticación Bearer a api.hiapi.ai, envías una tarea asíncrona y recibes una URL de CDN con la imagen o el vídeo renderizado. Detrás de ese único contrato conviven varios proveedores de modelos: la familia FLUX de Black Forest Labs, la línea Nano-Banana construida sobre los modelos de imagen de Google Gemini, la familia gpt-image-2 de OpenAI, los modelos de vídeo Qwen-Image y Wan2.7 de Alibaba, los modelos de vídeo Seedance de ByteDance y HappyHorse.
Por tanto, hiapi no vende «un modelo»: vende «una forma de integración». Si tienes una aplicación interna que necesita generar material visual de marketing, maquetas de producto o vídeos cortos promocionales, puedes hacer pruebas A/B entre dos modelos completamente distintos cambiando una cadena de texto, mientras el resto del código de trabajo permanece igual.
La otra cosa evidente que vende hiapi es la facturación en un solo lugar. Una factura, un saldo, un límite de tasa, en lugar de tres.
Modelos de imagen
A continuación, el catálogo completo de imágenes en el momento de redactar este artículo, obtenido en tiempo real de /api/pricing:
| Modelo | Categoría | Precio del nivel mínimo | Notas |
|---|---|---|---|
nano-banana |
Texto a imagen | $0.05 precio único | Iteración rápida; solo admite relación de aspecto, sin multiplicador de resolución |
nano-banana-2 |
Texto a imagen | $0.057 (2K) — $0.036 (1K) — $0.086 (4K) | Salida 4K; renderizado preciso de texto |
nano-banana-pro |
Texto a imagen | $0.057 (1K/2K) — $0.10 (4K) | La máxima calidad de la familia Banana |
flux-1.1-pro |
Texto a imagen | $0.05 precio único | Retratos fotorrealistas, renderizado de cadenas de texto cortas |
gpt-image-2 |
Texto a imagen | $0.03 (1K) — $0.04 (2K) — $0.06 (4K) | Caballo de batalla diario |
gpt-image-2/text-to-image@beta |
Texto a imagen | $0.02 | Borrador de bajo coste |
gpt-image-2.5-flare@pro |
Texto a imagen | $0.0172 (bajo) — $0.7143 (máximo), con precios por nivel de calidad | Imagen principal de alta fidelidad |
gpt-image-2/image-to-image |
Imagen a imagen | $0.03 → $0.06 | Mismo precio que las variantes t2i |
qwen-image-2.0 |
Texto a imagen | $0.0422 precio único | Potente renderizado de texto en chino, japonés y coreano; estructura de solicitud al estilo DashScope |
Algunas aclaraciones que no recoge la tabla:
La categoría de precios es una tarifa uniforme por llamada, no por token. Pagas una vez por una imagen completada. La longitud del prompt da igual. Esto hace predecibles las tareas por lotes: 10.000 llamadas a gpt-image-2 son $300, sin sorpresas.
nano-banana y flux-1.1-pro tienen precio único en todas las relaciones de aspecto. Sin recargo por 16:9, sin descuento por vertical: ya sea un avatar cuadrado o un fotograma cinematográfico en 21:9, pagas los mismos $0.05.
Los modelos que aceptan el parámetro resolution usan el image_quality_price_ratio que ves en los precios en tiempo real. No codifiques los precios en tu código de facturación: lee el bloque de políticas.
El esquema es específico de cada modelo, no uniforme. La mayoría de los modelos de imagen aceptan input.prompt más input.aspect_ratio. qwen-image-2.0 es un modelo al estilo DashScope: su entrada va bajo input.input.messages[].content[].text y el tamaño se pasa como cadena literal de píxeles, como 1328*1328. Nos topamos con esto en nuestro propio código de producción; construye un adaptador de modelo→carga útil desde el primer día.
Cómo se ve «FLUX 1.1 Pro» salido de hiapi
Este retrato lo generó flux-1.1-pro con relación de aspecto 3:2, a precio único de $0.05. Sin retoque, sin ampliación.
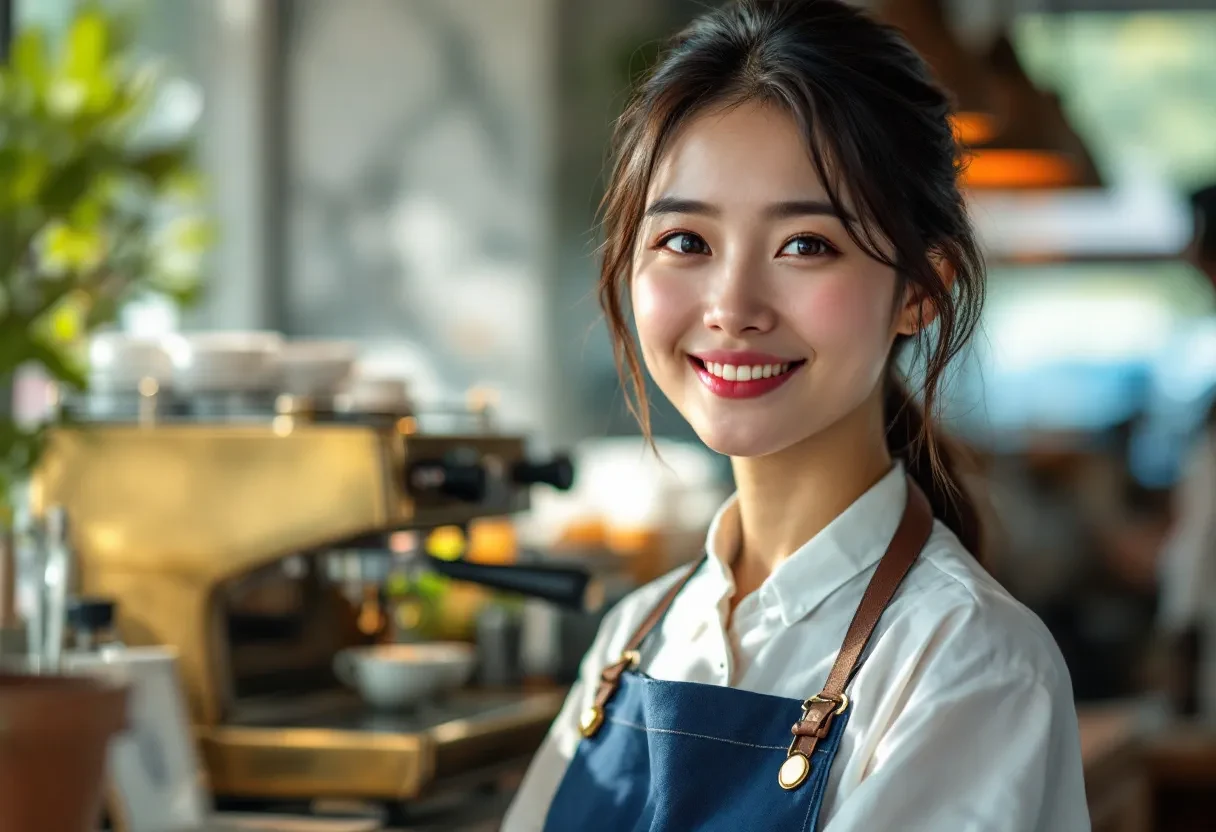
FLUX 1.1 Pro es la opción fotorrealista por defecto de la plataforma. Rostros, texturas de piel, luz direccional suave y texto corto dentro de la imagen son los terrenos donde supera de forma constante a los niveles más baratos.
Cómo se ve qwen-image-2.0 en hiapi
Esto es qwen-image-2.0, con un precio estimado actual de $0.0422, superior al GPT Image 2 en 1K ($0.03). Los cuatro caracteres chinos «陆羽茶馆» se especificaron en el prompt y se renderizaron correctamente, con el orden de trazos correcto. Este es justo el tipo de imagen en el que Qwen-Image vale lo que cuesta.
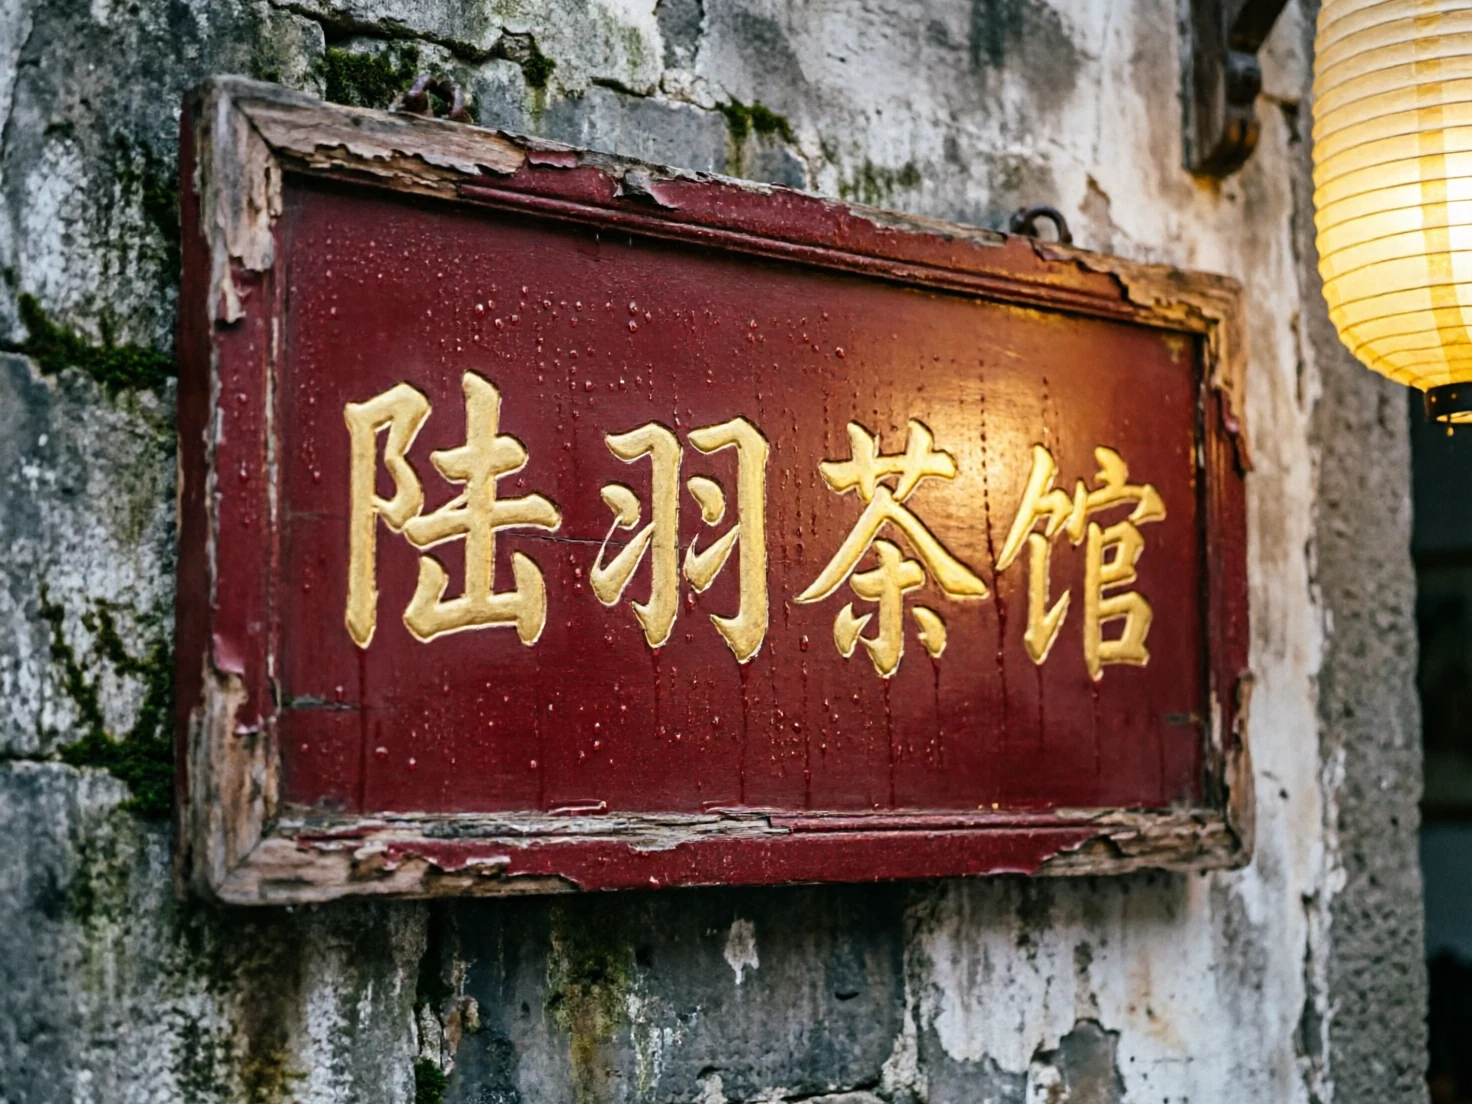
Si tu caso de uso son fichas de producto o publicaciones sociales para el mercado de chino, japonés y coreano, el nivel de $0.0422 es difícil de superar en cuanto a precisión de glifos originales.
Cómo se ve gpt-image-2 en un póster con mucho texto
Este póster salió de gpt-image-2 en 1K (relación de aspecto 3:4, $0.03). Una sola ida y vuelta, sin retoque. Tanto el titular como el subtítulo se renderizaron exactamente como se especificó.
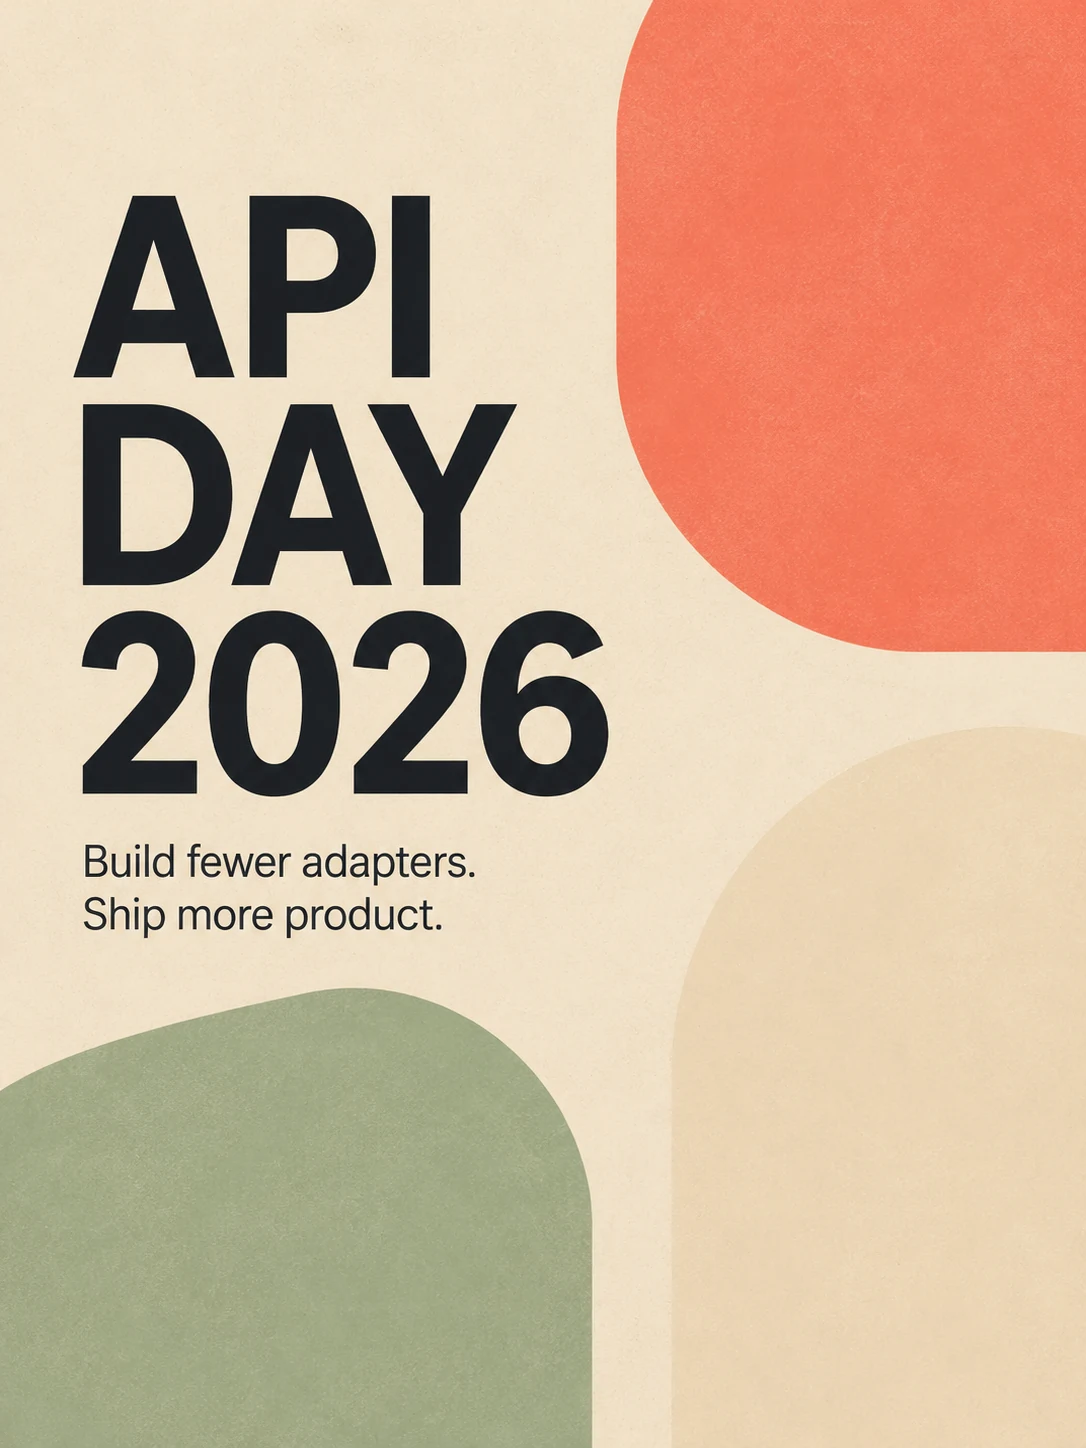
Si estás construyendo herramientas generativas para un equipo de marketing —pósteres de campaña, tarjetas sociales, banners publicitarios— gpt-image-2 es el punto de partida por defecto. Aloja de forma fiable titulares de 4 a 6 palabras y sigue indicaciones básicas de composición en el prompt.
Modelos de vídeo
El vídeo es la mitad más reciente del catálogo. En el momento de redactar este artículo:
| Modelo | Categoría | Precio del nivel mínimo | Precio del nivel máximo |
|---|---|---|---|
wan2.7-video/text-to-video |
Texto a vídeo | $0.10 (720P) | $0.167 (1080P) |
wan2.7-video/image-to-video |
Imagen a vídeo | $0.10 (720P) | $0.167 (1080P) |
seedance-2.0 |
Texto a vídeo | $0.136 (480p) | $0.729 (1080p) |
happyhorse-1.0 |
Texto a vídeo | $0.168 (720p) | $0.288 (1080p) |
Dos aclaraciones prácticas:
Wan2.7 es la opción con mejor relación calidad-precio para bucles cortos de producto y animación condicionada por imagen. A $0.10 por segundo en 720P, es una de las opciones de vídeo de menor coste de la plataforma.
Seedance 1080p es el nivel premium: el salto de $0.136 a $0.729 refleja potencia de cómputo, no un margen añadido. Si estás construyendo un verdadero flujo de producción de vídeo de producto y no una demostración personal, querrás reservar el presupuesto de Seedance para los planos principales y dejar el resto a Wan2.7.
Los cuatro modelos de vídeo se sirven a través del mismo endpoint POST /v1/tasks, con output_type: video: el mismo patrón de primero sondear y luego descargar que las tareas de imagen.
Modelo de precios
Hay varios detalles con los que la mayoría de los equipos se topan la primera vez:
Tarifa uniforme por llamada, con multiplicadores de resolución opcionales. Las tareas de imagen o vídeo no se facturan por token. Una llamada a gpt-image-2 cuesta $0.03, tanto si tu prompt tiene 8 palabras como 800. Cuando un modelo ofrece varias resoluciones, el recargo viene integrado en el array policies de la respuesta de precios en tiempo real: la salida de imagen en 4K llega a ser unas 2 veces el precio base, y el vídeo en 1080p unas 5,4 veces.
Los precios tienen versión. Cada modelo en /api/pricing lleva un hash pricing_version. Si lanzas un worker de generación, fija la versión de precios del modelo en la configuración y alerta cuando no coincida; así descubrirás que un modelo ha cambiado de precio antes del siguiente ciclo de facturación, y no después.
Sin precios por región ni recargos en horas punta. El mismo modelo cuesta lo mismo independientemente de la región desde la que llames y del momento en que llames. Aquí no hay nada inteligente que optimizar.
Siempre vuelves a obtener los precios. No codifiques los precios en la lógica de negocio. El endpoint /api/pricing es la fuente de verdad: misma forma que el catálogo público, sin autenticación. Lo volvimos a obtener al redactar este artículo, y los precios de las tablas provienen de ahí.
Arquitectura de endpoints
Todo en la plataforma —imagen o vídeo, texto a X o X a X— funciona mediante un único contrato de tareas asíncronas:
POST /v1/tasks
GET  /v1/tasks/{taskId}
Flujo:
- Llama a
POST /v1/taskscon{ "model": "...", "input": { ... } }. Recibes inmediatamente untaskId. - Sondea
GET /v1/tasks/{taskId}cada pocos segundos. Observadata.status: pasará dependingasuccess(o afailcon un bloque de error). - En
success, leedata.output[0].url. Es una URL de CDN de hiapi con una marca de tiempoexpireAtlimitada. Si necesitas conservar ese recurso, descárgalo y vuelve a alojarlo.
Las antiguas formas /v1/chat/completions y /v1/images/generations ya no ofrecen generación de imágenes. Si tu código aún las llama, tienes que migrar a /v1/tasks.
Es de esas decisiones que agradecerás más adelante. El modo de tareas te da reintentos naturales, conexiones HTTP de larga duración sin supervisión y una forma unificada para imagen y vídeo. Puedes enviar 200 tareas en abanico en 1 segundo y sondearlas en lote.
Inicio rápido en Python (ejecutable directamente)
Cliente mínimo, sin dependencias de SDK. Solo biblioteca estándar:
import json, os, time, urllib.request

TOKEN = os.environ["HIAPI_API_KEY"]
BASE  = "https://api.hiapi.ai"

def submit(model: str, input_payload: dict) -> str:
    body = json.dumps({"model": model, "input": input_payload}).encode()
    req = urllib.request.Request(
        f"{BASE}/v1/tasks",
        data=body,
        headers={
            "Authorization": f"Bearer {TOKEN}",
            "Content-Type":  "application/json",
        },
    )
    with urllib.request.urlopen(req, timeout=60) as r:
        data = json.loads(r.read())
    if data.get("code") != 200:
        raise RuntimeError(f"submit failed: {data}")
    return data["data"]["taskId"]

def wait_for(task_id: str, timeout_s: int = 240) -> str:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        time.sleep(5)
        req = urllib.request.Request(
            f"{BASE}/v1/tasks/{task_id}",
            headers={"Authorization": f"Bearer {TOKEN}"},
        )
        with urllib.request.urlopen(req, timeout=30) as r:
            data = json.loads(r.read())
        task = data.get("data") or {}
        if task.get("status") == "success":
            return task["output"][0]["url"]
        if task.get("status") == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
    raise TimeoutError(f"{task_id} did not finish in {timeout_s}s")

# Image — nano-banana flat $0.05
task_id = submit("nano-banana", {"prompt": "a quiet bookshop at dusk", "aspect_ratio": "3:2"})
print(wait_for(task_id))

# Image — flux-1.1-pro flat $0.05
task_id = submit("flux-1.1-pro", {"prompt": "studio portrait, 50mm lens", "aspect_ratio": "1:1"})
print(wait_for(task_id))

# Video — wan2.7-video/text-to-video at 720P, $0.10 per second
task_id = submit("wan2.7-video/text-to-video", {"prompt": "a koi pond at dawn, gentle ripples", "resolution": "720P"})
print(wait_for(task_id, timeout_s=600))
Antes de que este código esté listo para producción, hay que incorporar varias cosas:
- Envuelve
submitywait_foren reintentos con retroceso exponencial. Los problemas de red siempre ocurren. - Usa un
poll_intervalde al menos 5 segundos. Sondear con más frecuencia que eso es trabajo desperdiciado: las tareas de imagen se completan en 10–60 segundos y las de vídeo en 60–180 segundos. - Trata las URL de salida como recursos temporales. Las URL de CDN tienen
expireAt; si el recurso tiene cualquier vida útil después de la solicitud, descarga los bytes y guárdalos en tu propio bucket. - Fija un mapa de adaptadores de modelo.
qwen-image-2.0y algunos modelos de vídeo tienen formas de entrada distintas de la relación de aspecto de imagen por defecto: concentra ese conocimiento en un solo lugar.
Para quién es hiapi
En términos generales, hiapi encaja con tres tipos de equipos:
Equipos cansados de integrar un SDK por cada modelo. Si alguna vez has mantenido un adaptador para las imágenes de OpenAI, otro para FLUX de Black Forest Labs y otro para DashScope de Alibaba, has sufrido el impuesto de productividad de N SDK distintos. hiapi lo reduce a un solo cliente.
Equipos que necesitan precios predecibles. La forma de tarifa uniforme por llamada te permite construir un worker de generación, mirar el número de tareas del mes pasado y prever la factura del mes siguiente. Eso es difícil de hacer con cualquier modelo que cobre por token.
Equipos que quieren imagen y vídeo en un solo lugar. Una vez que tu producto abarca ambos —por ejemplo, una herramienta de marketing que a partir de un briefing genera una imagen de portada y un bucle de 10 segundos— tener ambos detrás de un endpoint y un saldo vale más que el coste por imagen que ahorras al integrarte directamente con los proveedores.
Si eres un aficionado que ejecuta un bot personal de Discord, usar directamente la API del proveedor está bien. En cuanto publicas un producto real con usuarios reales, la aritmética de la integración se inclina hacia la puerta de enlace.
Preguntas frecuentes
¿Hay cuota gratuita? Las cuentas nuevas reciben un pequeño crédito inicial para que puedas probar el endpoint sin compromiso. Cuando se agote, recargas saldo y pagas por las tareas completadas.
¿Qué relaciones de aspecto se admiten?
Las proporciones habituales —1:1, 3:2, 2:3, 4:3, 3:4, 5:4, 4:5, 16:9, 9:16 y 21:9— están disponibles en la mayoría de los modelos de imagen. qwen-image-2.0, en cambio, usa una lista fija de tamaños literales en píxeles; consulta la nota sobre el esquema del modelo más arriba.
¿Los recursos llevan marca de agua? No. La salida son archivos de imagen/vídeo limpios, sin la identidad de marca de hiapi.
¿Y los límites de tasa? El modo de tareas asíncronas significa que puedes enviar mucho trabajo muy rápido. Hay límites por cuenta para mantener la estabilidad de la plataforma; si necesitas límites más altos, solicítalos antes del pico de lanzamiento: subir un límite un martes es mucho más fácil que durante un lanzamiento.
¿Dónde puedo consultar los precios actuales?
https://www.hiapi.ai/api/pricing. Se almacena en caché como máximo una hora y fija el pricing_version de cada modelo, de modo que te darás cuenta cuando haya cambios.
¿Se puede usar la salida comercialmente?
La mayoría de los modelos de la plataforma tienen licencia de uso comercial en origen —la línea Nano-Banana, FLUX 1.1 Pro y Qwen-Image lo hacen explícitamente—, pero verifica la etiqueta de licencia del modelo que uses (campo tags) en tu respuesta de precios en tiempo real, porque algunos modelos especializados tienen condiciones más estrictas.
Por dónde empezar
Si vas a probar desde cero:
- Obtén una clave de API desde tu panel de hiapi.
- Llama una vez a
/api/pricingpara ver el catálogo de modelos y los precios actuales. - Copia el fragmento de Python de arriba y ejecútalo contra
nano-bananaogpt-image-2/text-to-image@beta: ambos son modelos de bajo coste, ideales para una comprobación de sanidad. Obtendrás un bucle de extremo a extremo funcional por unos céntimos. - Conecta ese bucle a lo que estés construyendo. La misma forma para vídeo. La misma forma para imagen a imagen. La misma forma para el próximo modelo que se añada al catálogo.
Ese es todo el argumento de venta: un endpoint, un saldo, un modelo mental. Las cuatro imágenes de este artículo —la ilustración de portada, el retrato fotorrealista, el letrero de caligrafía china, el póster tipográfico— se renderizaron con el fragmento de arriba, solo cambiando la cadena model y la forma correcta de input de cada modelo. El presupuesto estimado actual de estas cuatro imágenes es de $0.172.
Cuando el próximo modelo de imagen o vídeo de vanguardia llegue a la plataforma, tu worker no necesitará código nuevo. Solo tendrás que cambiar una cadena.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores