
Guia de uso
API de geração de imagens e vídeos hiapi: guia completo da plataforma
O que a hiapi realmente oferece — cada modelo de imagem e vídeo do catálogo, o modelo de precificação unificado por tarefa, o endpoint unificado /v1/tasks e um trecho de código Python pronto para copiar e começar a usar.
Visão geral rápida
hiapi é um gateway de API de geração de imagens e vídeos que integra mais de dez modelos de nível de produção sob um único contrato HTTP. Se você já teve que integrar três SDKs generativos diferentes só para colocar um recurso no ar, esta página é para você. Resumo rápido:
- Um endpoint, vários modelos. Todas as capacidades — texto para imagem, imagem para imagem, texto para vídeo, imagem para vídeo — rodam pelo endpoint assíncrono
POST /v1/tasks. Você muda o campomodel, não o SDK. - Modelos de imagem no catálogo atual:
nano-banana,nano-banana-2,nano-banana-pro,flux-1.1-pro,gpt-image-2(mais as variantes-betae-pro),gpt-image-2/image-to-image(mais-pro),qwen-image-2.0. - Modelos de vídeo no catálogo atual:
wan2.7-video/text-to-video,wan2.7-video/image-to-video,seedance-2.0,happyhorse-1.0. Resoluções de 480p a 1080p. - Cobrança por tarefa concluída, não por token. $0.02 gera uma imagem renderizada com
gpt-image-2/text-to-image@beta; $0.05 gera uma imagem Nano-Banana ou FLUX 1.1 Pro a preço único; $0.729 por segundo gera material de vídeo Seedance 1080p. - Sem roleta de níveis de qualidade. Os preços são publicados em tempo real em
/api/pricing, com uma versão em hash, para que seu código de cobrança possa ser fixado a uma versão conhecida e gerar erro explícito quando o upstream mudar.
Esta é a página de resultados de busca da marca — uma apresentação completa sobre o que a plataforma é, para quem se destina e quanto custa. As quatro imagens deste artigo foram renderizadas por quatro modelos hospedados diferentes da hiapi, para que você veja como é o resultado final.
O que é a hiapi
hiapi é um gateway hospedado. Você aponta um cliente HTTP autenticado com Bearer token para api.hiapi.ai, envia uma tarefa assíncrona e recebe uma URL de CDN contendo a imagem ou o vídeo renderizado. Por trás desse contrato único estão vários provedores de modelo — a linha FLUX da Black Forest Labs, a linha Nano-Banana construída sobre os modelos de imagem Gemini do Google, a linha gpt-image-2 da OpenAI, os modelos de vídeo Qwen-Image e Wan2.7 da Alibaba, os modelos de vídeo Seedance da ByteDance e o HappyHorse.
Então a hiapi não vende "um modelo" — ela vende "uma forma de integração". Se você tem um aplicativo interno que precisa gerar peças visuais de marketing, mockups de produto ou vídeos curtos de campanha, pode fazer um teste A/B entre dois modelos completamente diferentes mudando uma string, mantendo o restante do código de trabalho intacto.
Outra coisa evidentemente vendida pela hiapi é a cobrança em um só lugar. Uma fatura, um saldo, um limite de taxa — em vez de três.
Modelos de imagem
A seguir está o catálogo completo de imagens no momento da redação deste texto, obtido em tempo real de /api/pricing:
| Modelo | Categoria | Preço da faixa mais baixa | Observações |
|---|---|---|---|
nano-banana |
Texto para imagem | $0.05 preço único | Iteração rápida; suporta apenas proporção, sem multiplicador de resolução |
nano-banana-2 |
Texto para imagem | $0.057 (2K) — $0.036 (1K) — $0.086 (4K) | Saída em 4K; renderização precisa de texto |
nano-banana-pro |
Texto para imagem | $0.057 (1K/2K) — $0.10 (4K) | Maior qualidade da linha Banana |
flux-1.1-pro |
Texto para imagem | $0.05 preço único | Retratos fotorrealistas, renderização de textos curtos |
gpt-image-2 |
Texto para imagem | $0.03 (1K) — $0.04 (2K) — $0.06 (4K) | Cavalo de batalha do dia a dia |
gpt-image-2/text-to-image@beta |
Texto para imagem | $0.02 | Rascunho de baixo custo |
gpt-image-2.5-flare@pro |
Texto para imagem | $0.0172 (baixo) — $0.7143 (máximo), preço por nível de qualidade | Imagem principal de alta fidelidade |
gpt-image-2/image-to-image |
Imagem para imagem | $0.03 → $0.06 | Mesmo preço das variantes t2i |
qwen-image-2.0 |
Texto para imagem | $0.0422 preço único | Forte renderização de texto em chinês, japonês e coreano, estrutura de requisição no estilo DashScope |
Alguns esclarecimentos que a tabela não mostra:
A categoria de preço é cobrança única por chamada, não por token. Você paga uma vez por uma imagem concluída. O comprimento do prompt não importa. Isso torna as tarefas em lote previsíveis: 10.000 chamadas de gpt-image-2 custam $300, sem letras miúdas.
nano-banana e flux-1.1-pro têm preço único em todas as proporções. Sem sobretaxa para 16:9, sem desconto para retrato — seja um avatar quadrado ou um frame cinematográfico 21:9, você paga os mesmos $0.05.
Modelos que aceitam o parâmetro resolution usam o image_quality_price_ratio que você vê na precificação em tempo real. Não codifique preços diretamente no código de cobrança — leia o bloco de políticas.
O schema varia por modelo, não é unificado. A maioria dos modelos de imagem aceita input.prompt mais input.aspect_ratio. qwen-image-2.0 é um modelo no estilo DashScope — sua entrada fica em input.input.messages[].content[].text, e as dimensões são passadas como strings literais de pixels, como 1328*1328. Encontramos esse problema no nosso próprio código de produção; construa um adaptador de modelo→payload desde o primeiro dia.
Como fica o "FLUX 1.1 Pro" saindo da hiapi
Este retrato foi gerado por flux-1.1-pro na proporção 3:2, preço único de $0.05. Sem retoque, sem ampliação.
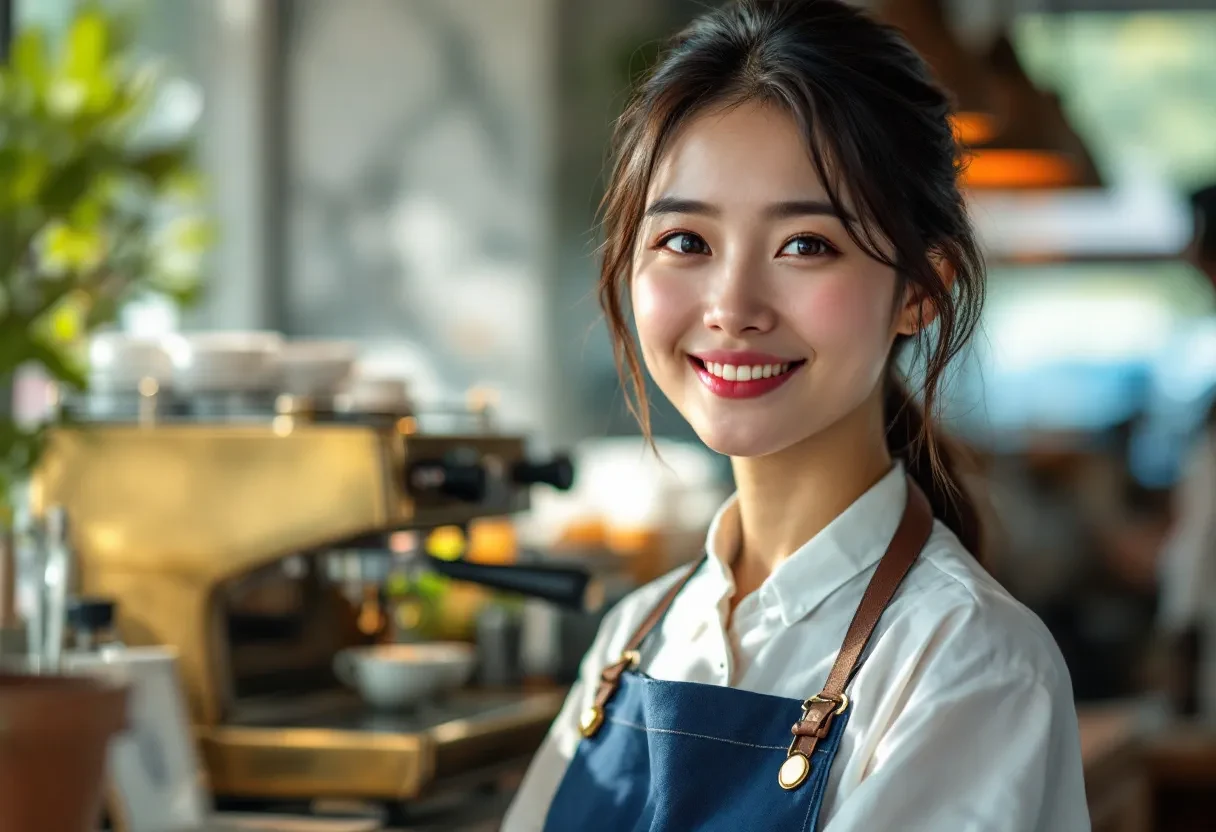
FLUX 1.1 Pro é a escolha padrão para fotorrealismo na plataforma. Rostos, textura de pele, luz direcional suave e textos curtos na imagem são onde ele supera consistentemente as faixas mais baratas.
Como fica o qwen-image-2.0 na hiapi
Este é o qwen-image-2.0, com preço estimado atual de $0.0422 — mais caro que o GPT Image 2 em 1K ($0.03). Os quatro caracteres chineses "陆羽茶馆" foram especificados no prompt e renderizados corretamente, com a ordem dos traços correta. Esse é exatamente o tipo de imagem em que o Qwen-Image vale o preço.
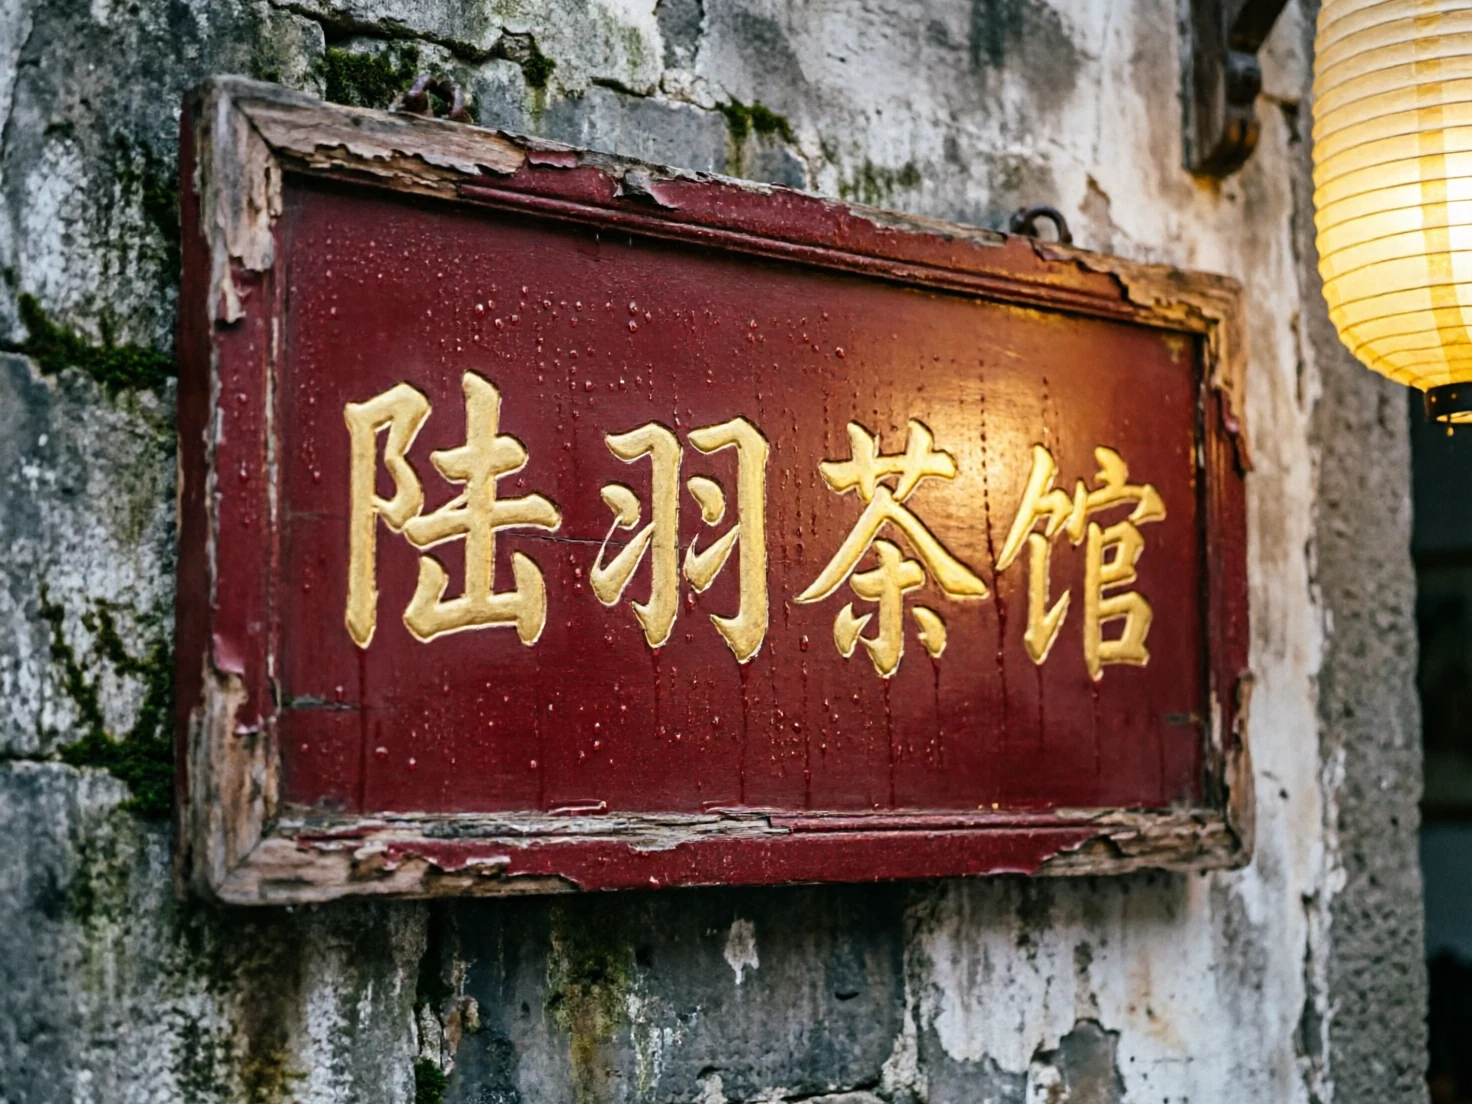
Se o seu caso de uso são cards de produto ou posts sociais para o mercado de chinês, japonês e coreano, a faixa de $0.0422 é difícil de superar em termos de precisão bruta dos glifos.
Como fica o gpt-image-2 em pôsteres com muito texto
Este pôster saiu do gpt-image-2 em 1K (proporção 3:4, $0.03). Uma única rodada, sem retoque. Título e subtítulo foram renderizados exatamente como especificado.
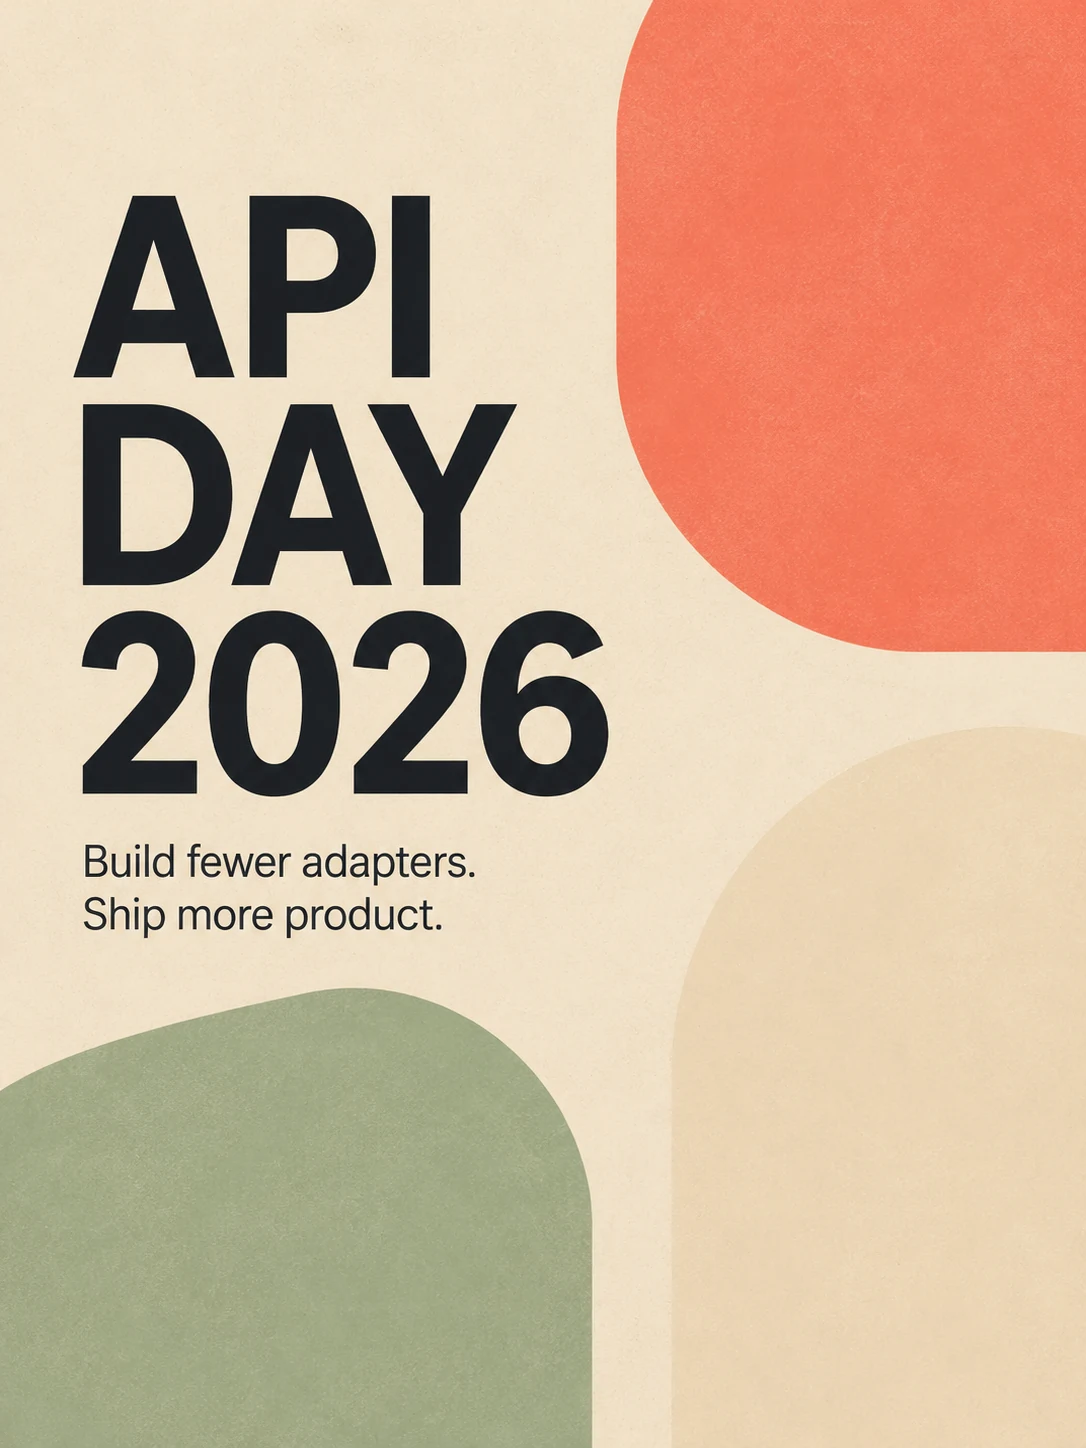
Se você está construindo ferramentas generativas para uma equipe de marketing — pôsteres de campanha, cards sociais, banners — o gpt-image-2 é o ponto de partida padrão. Ele acomoda de forma confiável títulos de 4 a 6 palavras e segue orientações básicas de layout no prompt.
Modelos de vídeo
Vídeo é a metade mais nova do catálogo. No momento da redação deste texto:
| Modelo | Categoria | Preço da faixa mais baixa | Preço da faixa mais alta |
|---|---|---|---|
wan2.7-video/text-to-video |
Texto para vídeo | $0.10 (720P) | $0.167 (1080P) |
wan2.7-video/image-to-video |
Imagem para vídeo | $0.10 (720P) | $0.167 (1080P) |
seedance-2.0 |
Texto para vídeo | $0.136 (480p) | $0.729 (1080p) |
happyhorse-1.0 |
Texto para vídeo | $0.168 (720p) | $0.288 (1080p) |
Duas observações práticas:
Wan2.7 é a opção com melhor custo-benefício, adequada para loops curtos de produto e animação condicionada por imagem. A $0.10 por segundo em 720P, é uma das opções de vídeo de menor custo da plataforma.
Seedance 1080p é a faixa premium — o salto de $0.136 para $0.729 reflete poder computacional, não margem. Se você está construindo um pipeline real de vídeo de produto em vez de uma demonstração de uso pessoal, vai querer reservar o orçamento do Seedance para os planos principais e deixar o restante com o Wan2.7.
Os quatro modelos de vídeo são oferecidos pelo mesmo endpoint POST /v1/tasks, usando output_type: video — o mesmo padrão de primeiro consultar depois baixar das tarefas de imagem.
Modelo de precificação
Alguns detalhes que a maioria das equipes encontra na primeira vez:
Cobrança única por chamada, com multiplicadores opcionais de resolução. Não há cobrança por token em tarefas de imagem ou vídeo. Uma chamada de gpt-image-2 custa $0.03 — não importa se seu prompt tem 8 palavras ou 800. Quando um modelo oferece várias resoluções, o acréscimo já está embutido no array policies da resposta de precificação em tempo real, com saída de imagem em 4K chegando a cerca de 2 vezes o preço base e vídeo em 1080p a cerca de 5,4 vezes.
A precificação tem versão. Cada modelo em /api/pricing traz um hash pricing_version. Se você colocar um worker de geração em produção, fixe a versão de precificação do modelo na configuração e alerte em caso de incompatibilidade — assim você descobre que um modelo foi reprecificado antes do próximo ciclo de cobrança, e não depois.
Sem precificação por região, sem acréscimo em horário de pico. O mesmo modelo custa o mesmo, independentemente da região de onde você chama e do momento em que chama. Não há nada de inteligente para otimizar aqui.
Você sempre busca de novo. Não codifique preços diretamente na lógica de negócio. O endpoint /api/pricing é a fonte da verdade — com o mesmo formato do catálogo público, sem necessidade de autenticação. Buscamos novamente ao escrever este texto, e os preços da tabela vieram de lá.
Arquitetura dos endpoints
Tudo na plataforma — imagem ou vídeo, texto para X ou X para X — roda por um único contrato de tarefa assíncrona:
POST /v1/tasks
GET  /v1/tasks/{taskId}
Fluxo:
- Chame
POST /v1/taskscom{ "model": "...", "input": { ... } }. Você recebe imediatamente umtaskId. - Consulte
GET /v1/tasks/{taskId}a cada poucos segundos. Observedata.status— ele passa dependingparasuccess(oufailcom um bloco de erro). - Em
success, leiadata.output[0].url. Essa é uma URL de CDN da hiapi com um timestampexpireAtlimitado. Se precisar manter o recurso, baixe-o e hospede-o novamente.
Os formatos antigos /v1/chat/completions e /v1/images/generations não oferecem mais serviço de geração de imagens. Se seu código ainda os chama, é preciso migrar para /v1/tasks.
É o tipo de decisão que você vai agradecer depois. O modo de tarefa oferece novas tentativas naturais, conexões HTTP de longa duração sem necessidade de supervisão e um formato unificado para imagem e vídeo. Você pode disparar 200 envios de tarefa em 1 segundo e consultá-los em lote.
Início rápido em Python (pronto para executar)
Cliente mínimo, sem dependência de SDK. Apenas biblioteca padrão:
import json, os, time, urllib.request

TOKEN = os.environ["HIAPI_API_KEY"]
BASE  = "https://api.hiapi.ai"

def submit(model: str, input_payload: dict) -> str:
    body = json.dumps({"model": model, "input": input_payload}).encode()
    req = urllib.request.Request(
        f"{BASE}/v1/tasks",
        data=body,
        headers={
            "Authorization": f"Bearer {TOKEN}",
            "Content-Type":  "application/json",
        },
    )
    with urllib.request.urlopen(req, timeout=60) as r:
        data = json.loads(r.read())
    if data.get("code") != 200:
        raise RuntimeError(f"submit failed: {data}")
    return data["data"]["taskId"]

def wait_for(task_id: str, timeout_s: int = 240) -> str:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        time.sleep(5)
        req = urllib.request.Request(
            f"{BASE}/v1/tasks/{task_id}",
            headers={"Authorization": f"Bearer {TOKEN}"},
        )
        with urllib.request.urlopen(req, timeout=30) as r:
            data = json.loads(r.read())
        task = data.get("data") or {}
        if task.get("status") == "success":
            return task["output"][0]["url"]
        if task.get("status") == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
    raise TimeoutError(f"{task_id} did not finish in {timeout_s}s")

# Image — nano-banana flat $0.05
task_id = submit("nano-banana", {"prompt": "a quiet bookshop at dusk", "aspect_ratio": "3:2"})
print(wait_for(task_id))

# Image — flux-1.1-pro flat $0.05
task_id = submit("flux-1.1-pro", {"prompt": "studio portrait, 50mm lens", "aspect_ratio": "1:1"})
print(wait_for(task_id))

# Video — wan2.7-video/text-to-video at 720P, $0.10 per second
task_id = submit("wan2.7-video/text-to-video", {"prompt": "a koi pond at dawn, gentle ripples", "resolution": "720P"})
print(wait_for(task_id, timeout_s=600))
Antes de este código estar pronto para produção, algumas coisas precisam ser incorporadas:
- Envolva
submitewait_forem novas tentativas com backoff exponencial. Instabilidades de rede sempre acontecem. - Use um
poll_intervalde pelo menos 5 segundos. Consultar mais densamente que isso é trabalho desperdiçado — tarefas de imagem concluem em 10–60 segundos, tarefas de vídeo em 60–180 segundos. - Trate as URLs de saída como recursos temporários. As URLs de CDN têm
expireAt; se o recurso tiver qualquer ciclo de vida após a requisição, baixe os bytes e armazene no seu próprio bucket. - Fixe um mapeamento de adaptadores de modelo. O
qwen-image-2.0e alguns modelos de vídeo têm formatos de entrada diferentes do padrão de proporção de imagem — concentre esse conhecimento em um único lugar.
Para quem a hiapi é indicada
De modo geral, a hiapi é indicada para três tipos de equipe:
Equipes cansadas de integrar um SDK para cada modelo. Se você já manteve um adaptador para imagens da OpenAI, outro para o FLUX da Black Forest Labs e outro para o DashScope da Alibaba, você sentiu o imposto de produtividade de N SDKs diferentes. A hiapi reduz isso a um único cliente.
Equipes que precisam de precificação previsível. O formato de cobrança única por chamada permite construir um worker de geração, olhar o número de tarefas do mês passado e prever a fatura do mês seguinte. Isso é difícil de fazer com qualquer modelo que cobre por token.
Equipes que querem imagem e vídeo em um só lugar. Quando seu produto abrange os dois — por exemplo, uma ferramenta de marketing que gera uma imagem de capa e um loop de 10 segundos a partir de um briefing — ter ambos por trás de um único endpoint e um único saldo vale mais do que a economia por imagem obtida ao integrar diretamente.
Se você é um entusiasta mantendo um bot pessoal do Discord, usar as APIs upstream diretamente funciona bem. Assim que você está lançando um produto real com usuários reais, a aritmética da integração favorece o gateway.
Perguntas frequentes
Há cota gratuita? Novas contas recebem uma pequena cota inicial, para que você possa testar o endpoint sem compromisso. Depois que ela acabar, você recarrega o saldo e paga pelas tarefas concluídas.
Quais proporções são suportadas?
Proporções comuns — 1:1, 3:2, 2:3, 4:3, 3:4, 5:4, 4:5, 16:9, 9:16 e 21:9 — estão disponíveis na maioria dos modelos de imagem. O qwen-image-2.0, por sua vez, usa uma lista fixa de dimensões literais em pixels; consulte a nota sobre o schema do modelo acima.
Os recursos têm marca d'água? Não. A saída são arquivos de imagem/vídeo limpos, sem a identidade visual da hiapi.
E os limites de taxa? O modo de tarefa assíncrona significa que você pode enviar muito trabalho muito rapidamente. Há limites por conta para manter a plataforma estável; se você precisar de limites maiores, solicite antes do pico de lançamento — aumentar o limite em uma terça-feira é muito mais fácil do que durante um lançamento.
Onde consultar os preços atuais?
https://www.hiapi.ai/api/pricing. No máximo uma hora de cache, com o pricing_version de cada modelo fixado, para que você perceba quando algo mudar.
As saídas podem ser usadas comercialmente?
A maioria dos modelos da plataforma tem licença de uso comercial no upstream — a linha Nano-Banana, o FLUX 1.1 Pro e o Qwen-Image são explicitamente assim —, mas verifique a tag de licença (campo tags) do modelo que você usa na resposta de precificação em tempo real, porque alguns modelos especializados têm termos mais restritivos.
Por onde começar
Se você quer experimentar do zero:
- Obtenha uma chave de API no seu painel da hiapi.
- Chame
/api/pricinguma vez para ver o catálogo de modelos e os preços atuais. - Copie o trecho Python acima e execute-o para
nano-bananaougpt-image-2/text-to-image@beta— ambos são modelos de baixo custo, adequados para uma verificação de sanidade. Você gastará alguns centavos e terá um ciclo ponta a ponta funcionando. - Conecte esse ciclo ao que você estiver construindo. O mesmo formato para vídeo. O mesmo formato para imagem para imagem. O mesmo formato para o próximo modelo que entrar no catálogo.
Esse é o argumento de venda completo: um endpoint, um saldo, um modelo mental. As quatro imagens deste artigo — a ilustração de capa, o retrato fotorrealista, a placa de caligrafia em chinês, japonês e coreano, e o pôster tipográfico — foram renderizadas usando o trecho acima, apenas com strings model diferentes e o formato input correto para cada modelo. O orçamento estimado atual para essas quatro imagens é de $0.172.
Quando o próximo modelo de imagem ou vídeo de ponta chegar à plataforma, seu worker não precisará de código novo. Você só muda uma string.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores