
使用ガイド
hiapi 画像・動画生成 API:完全プラットフォームガイド
hiapi が提供するものとは——カタログ内のすべての画像・動画モデル、タスク単位課金の統一定価モデル、統一された /v1/tasks エンドポイント、そしてそのままコピーできる Python クイックスタートコード。
概要
hiapi は画像・動画生成 API ゲートウェイであり、単一の HTTP 契約のもとで十数個の本番グレードモデルに接続します。ひとつの機能をリリースするために三つの異なる生成 SDK と連携した経験があるなら、このページはまさにあなたのためのものです。手短にまとめると:
- ひとつのエンドポイント、複数のモデル。 すべての機能——テキストから画像、画像から画像、テキストから動画、画像から動画——は非同期の
POST /v1/tasksエンドポイントを通じて実行されます。変更するのは SDK ではなくmodelフィールドです。 - 現在のカタログの画像モデル:
nano-banana、nano-banana-2、nano-banana-pro、flux-1.1-pro、gpt-image-2(および-betaと-proのバリアント)、gpt-image-2/image-to-image(および-pro)、qwen-image-2.0。 - 現在のカタログの動画モデル:
wan2.7-video/text-to-video、wan2.7-video/image-to-video、seedance-2.0、happyhorse-1.0。解像度は 480p から 1080p まで。 - 課金は token ではなく完了したタスク単位。 $0.02 で
gpt-image-2/text-to-image@betaのレンダリング画像が一枚生成できます。$0.05 で Nano-Banana または FLUX 1.1 Pro の画像が一枚統一定価で生成できます。$0.729 で 1080p の Seedance 動画素材が毎秒生成できます。 - 品質ティアのルーレットはなし。 価格はリアルタイムで
/api/pricingに公開され、ハッシュバージョンが付いているため、課金コードを既知のバージョンに固定でき、上流の変化があれば明示的にエラーを出せます。
これはブランド検索結果ページです——プラットフォームが何であり、誰に向けてあり、コストがいくらかについての完全な紹介です。この記事中の四枚の画像は四つの異なる hiapi ホストモデルでレンダリングされており、最終的なアウトプットがどのようなものかを見ることができます。
hiapi とは
hiapi はホスト型ゲートウェイです。Bearer token 認証を使用する HTTP クライアントを api.hiapi.ai に向け、非同期タスクを送信すると、レンダリング済みの画像または動画を含む CDN URL を受け取ります。この単一の契約の背後には、複数のモデルプロバイダーが座っています——Black Forest Labs の FLUX シリーズ、Google Gemini 画像モデルをベースに構築された Nano-Banana 製品ライン、OpenAI の gpt-image-2 シリーズ、Alibaba の Qwen-Image と Wan2.7 動画モデル、ByteDance の Seedance 動画モデル、そして HappyHorse です。
つまり、hiapi が売っているのは「ひとつのモデル」ではなく「ひとつの統合形態」です。マーケティングビジュアル、製品モックアップ、短いプロモーション動画を生成する必要がある社内アプリがあるなら、ひとつの文字列を変えるだけで二つのまったく異なるモデルを A/B テストでき、残りの作業コードはそのまま変わりません。
hiapi が売っているもう一つの明らかなものは一箇所での課金です。請求書一枚、残高一つ、レート制限一つ——三つではありません。
画像モデル
以下は執筆時点の完全な画像カタログで、/api/pricing からリアルタイムで取得したものです:
| モデル | カテゴリ | 最低ティア価格 | 備考 |
|---|---|---|---|
nano-banana |
テキストから画像 | $0.05 統一定価 | 高速イテレーション;アスペクト比のみ対応、解像度倍数なし |
nano-banana-2 |
テキストから画像 | $0.057(2K)— $0.036(1K)— $0.086(4K) | 4K 出力;正確なテキストレンダリング |
nano-banana-pro |
テキストから画像 | $0.057(1K/2K)— $0.10(4K) | Banana シリーズ中最高品質 |
flux-1.1-pro |
テキストから画像 | $0.05 統一定価 | 写真級ポートレート、短い文字列のテキストレンダリング |
gpt-image-2 |
テキストから画像 | $0.03(1K)— $0.04(2K)— $0.06(4K) | 日常の主力 |
gpt-image-2/text-to-image@beta |
テキストから画像 | $0.02 | 低コストのドラフト |
gpt-image-2.5-flare@pro |
テキストから画像 | $0.0172(低)— $0.7143(最高)、品質ティア別の価格設定 | 高忠実度のキービジュアル |
gpt-image-2/image-to-image |
画像から画像 | $0.03 → $0.06 | t2i バリアントと同じ価格 |
qwen-image-2.0 |
テキストから画像 | $0.0422 統一定価 | 強力な日中韓テキストレンダリング、DashScope スタイルのリクエスト構造 |
表では見えないいくつかの補足:
価格カテゴリは token ではなく呼び出し単位の定額課金。 完成した一枚の画像に対して一度だけ料金を支払います。プロンプトの長さは関係ありません。これによりバッチタスクが予測可能になります。10,000 回の gpt-image-2 呼び出しは $300 で、それ以上の条件はありません。
nano-banana と flux-1.1-pro はすべてのアスペクト比で統一定価。 16:9 の追加料金も、縦長の割引もありません——正方形のアバターでも 21:9 の映画スチルでも、同じ $0.05 を支払います。
resolution パラメータを受け入れるモデルは、リアルタイム価格で示される image_quality_price_ratio を使用します。 課金コードに価格をハードコーディングしないでください——ポリシーブロックを読み取ってください。
Schema はモデルごとに異なり、統一されていません。 ほとんどの画像モデルは input.prompt と input.aspect_ratio を受け入れます。qwen-image-2.0 は DashScope スタイルのモデルで、入力は input.input.messages[].content[].text の下に置かれ、サイズは 1328*1328 のようなリテラルピクセル文字列として渡されます。私たち自身の本番コードでもこの問題に遭遇しました。初日からモデル→ペイロードアダプターを構築してください。
hiapi から出力される「FLUX 1.1 Pro」の仕上がり
このポートレートは flux-1.1-pro で 3:2 のアスペクト比で生成され、統一定価は $0.05 です。レタッチなし、アップスケールなし。
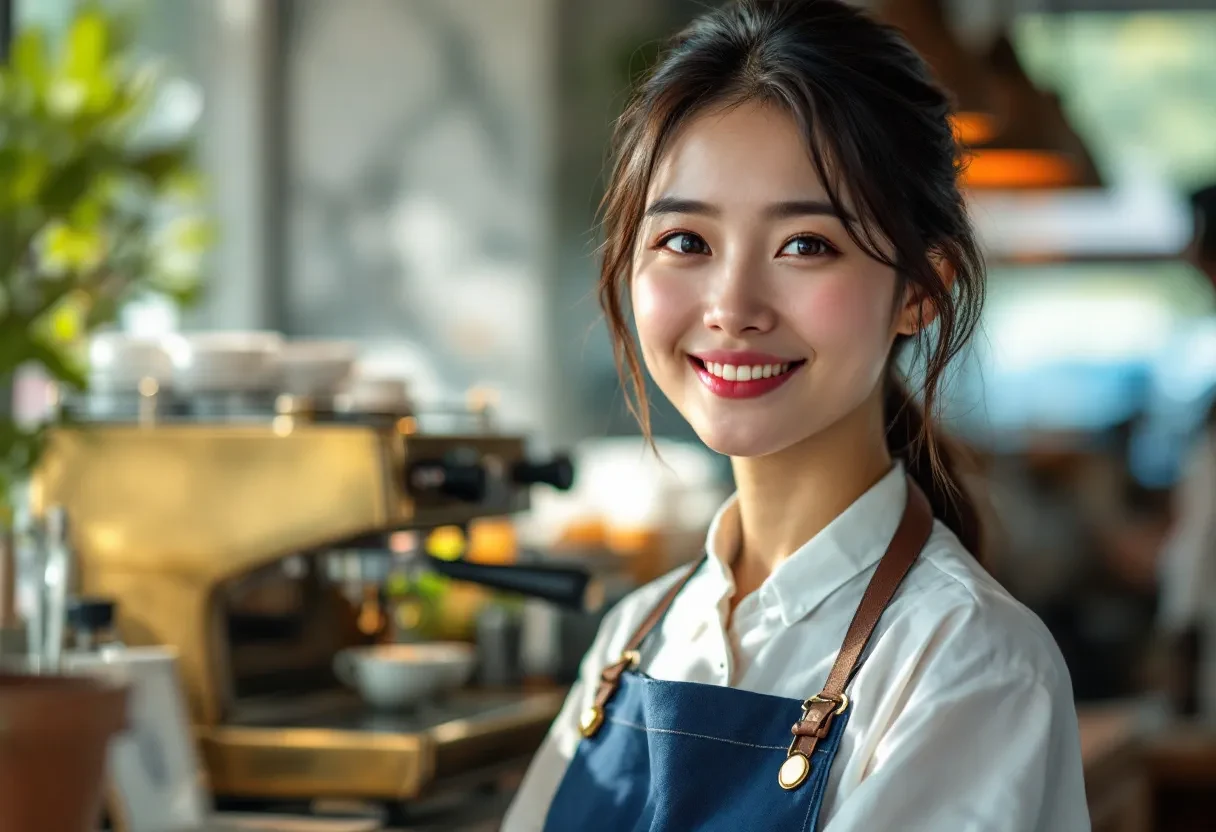
FLUX 1.1 Pro はプラットフォーム上の写真級のデフォルト選択です。顔、皮膚のテクスチャ、柔らかな方向性のある光、画像上の短いテキストは、より安価なティアと比べて一貫して優れている部分です。
hiapi 上の qwen-image-2.0 の仕上がり
これは qwen-image-2.0 で、現在の推定価格は $0.0422——1K の GPT Image 2($0.03)より高いです。プロンプトで指定された四つの漢字「陸羽茶館」が正しい筆順で正しくレンダリングされています。まさに Qwen-Image がその価値を発揮するタイプの画像です。
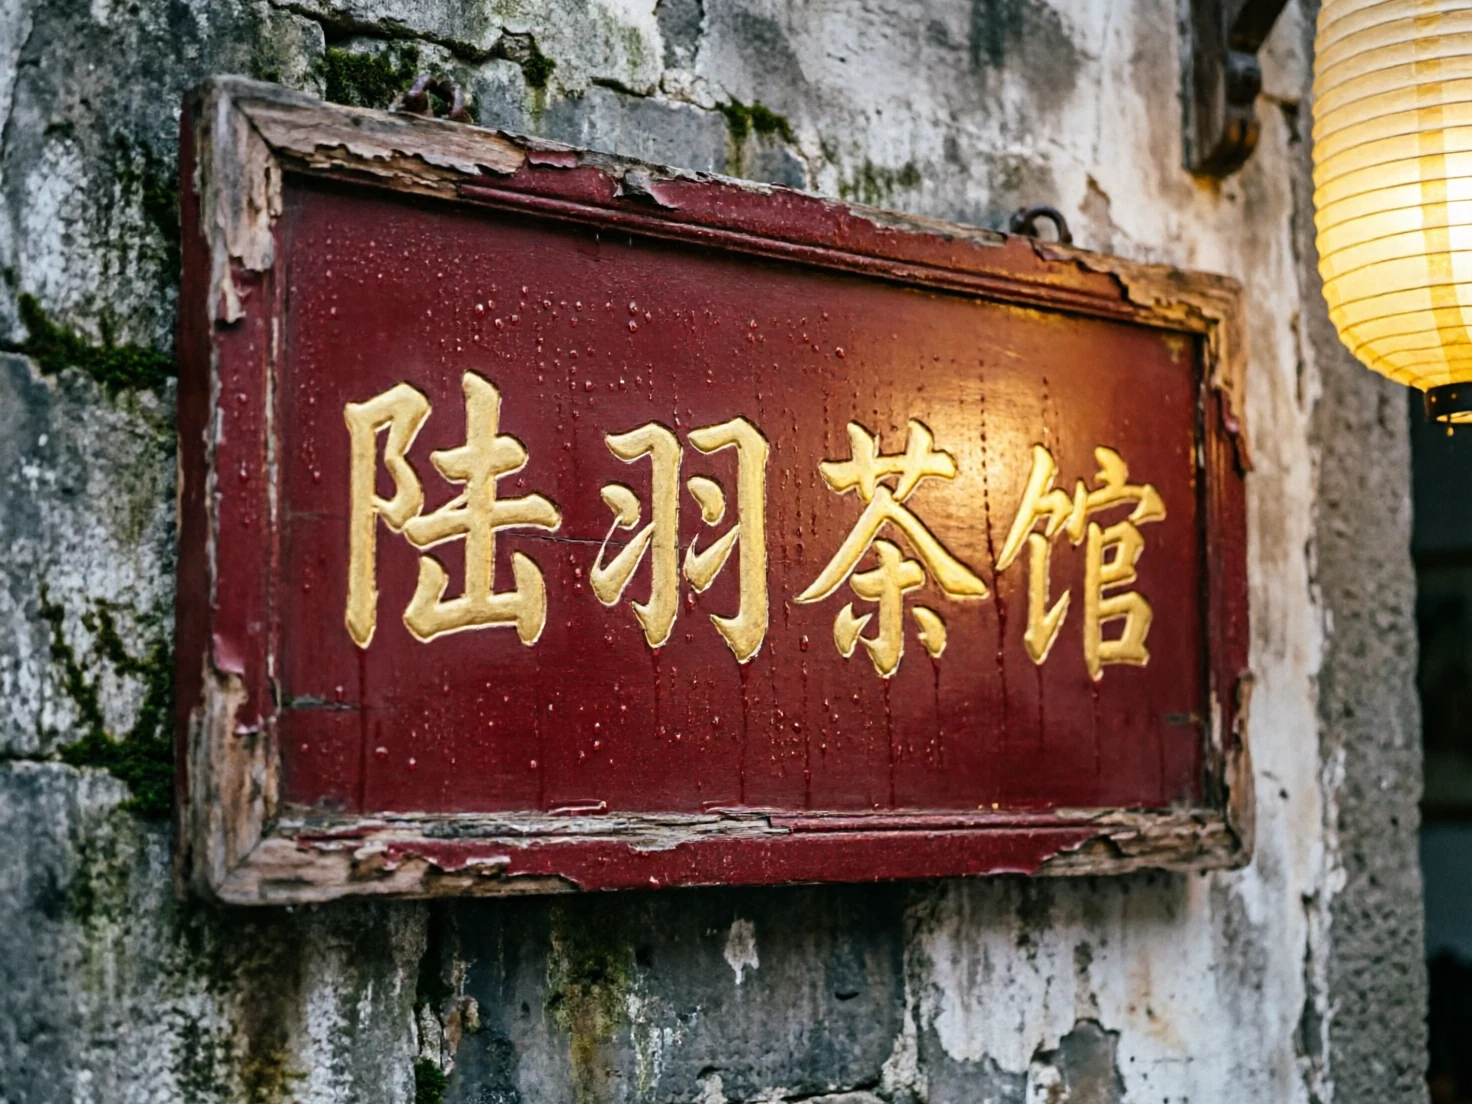
ユースケースが日中韓市場向けの商品カードやソーシャル投稿であれば、字形の正確さという点で $0.0422 のティアは他を凌駕しがたいでしょう。
タイポグラフィ主体のポスターでの gpt-image-2 の仕上がり
このポスターは 1K の gpt-image-2(3:4 アスペクト比、$0.03)によるものです。一往復で、レタッチなし。タイトルもサブタイトルも指定どおりに正確にレンダリングされています。
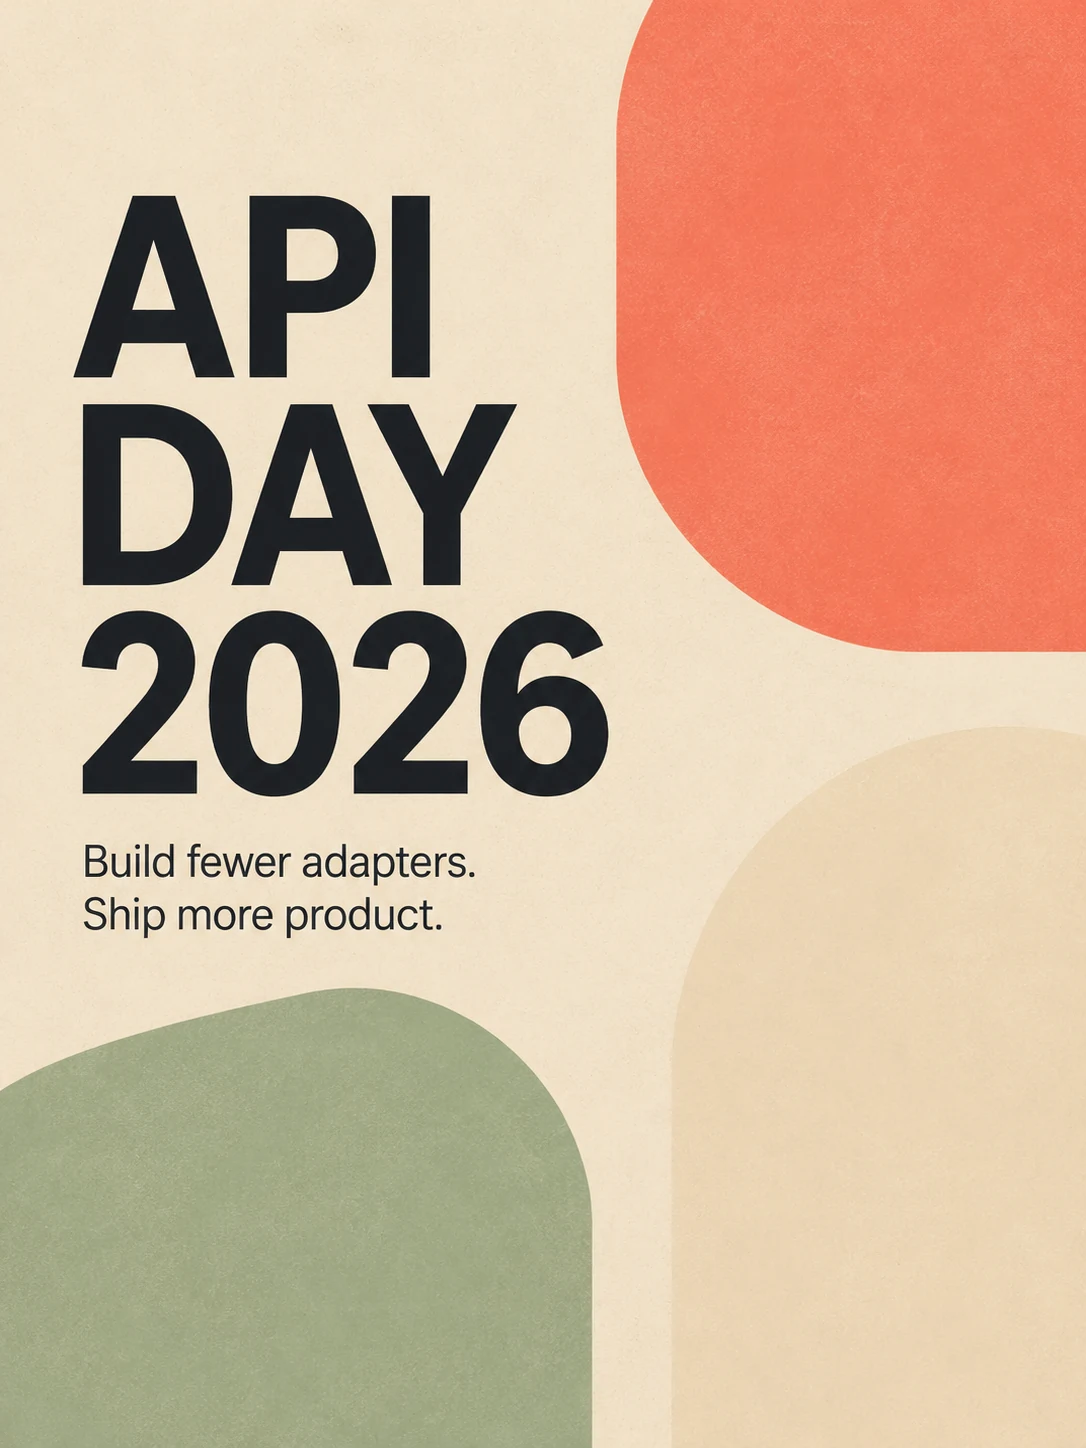
マーケティングチーム向けの生成ツール——イベントポスター、ソーシャルカード、バナー広告——を構築しているなら、gpt-image-2 がデフォルトの出発点です。4〜6 語の見出しを確実に収め、プロンプトの基本的なレイアウト指示に従います。
動画モデル
動画はカタログの新しい半分です。執筆時点では:
| モデル | カテゴリ | 最低ティア価格 | 最高ティア価格 |
|---|---|---|---|
wan2.7-video/text-to-video |
テキストから動画 | $0.10(720P) | $0.167(1080P) |
wan2.7-video/image-to-video |
画像から動画 | $0.10(720P) | $0.167(1080P) |
seedance-2.0 |
テキストから動画 | $0.136(480p) | $0.729(1080p) |
happyhorse-1.0 |
テキストから動画 | $0.168(720p) | $0.288(1080p) |
二つの実用的な補足:
Wan2.7 はコスト効率の良い選択肢で、短い製品ループや画像条件付きアニメーションに適しています。720P で毎秒 $0.10 は、プラットフォーム上で比較的低コストな動画オプションの一つです。
Seedance 1080p はプレミアムティア——$0.136 から $0.729 への跳ね上がりはマークアップではなく計算リソースを反映しています。個人利用のデモではなく本格的な製品動画パイプラインを構築しているなら、Seedance の予算はキービジュアルショットに残し、それ以外は Wan2.7 に任せたいでしょう。
四つの動画モデルはすべて、画像タスクと同じ「まずポーリングしてからダウンロード」パターンで、output_type: video を使って同じ POST /v1/tasks エンドポイントから提供されます。
価格モデル
ほとんどのチームが最初に遭遇するいくつかの細部:
呼び出し単位の定額課金、オプションの解像度倍数。 画像や動画のタスクに token 課金はありません。一回の gpt-image-2 呼び出しは $0.03 です——プロンプトが 8 語でも 800 語でも変わりません。モデルが複数の解像度を提供する場合、追加料金はリアルタイム価格レスポンスの policies 配列に組み込まれており、4K 画像出力は基本価格の約 2 倍、1080p 動画は約 5.4 倍になります。
価格にはバージョンがあります。 /api/pricing の各モデルには pricing_version ハッシュが付いています。生成ワーカーをリリースするなら、設定でモデルの価格バージョンを固定し、不一致時にアラートを出すようにしてください——そうすれば次の課金サイクルの前にモデルの価格改定を発見でき、後からではありません。
地域別価格もピーク時加価もありません。 同じモデルは、どの地域から呼び出しても、いつ呼び出しても同じ価格です。ここに賢く最適化できるものはありません。
常に再取得してください。 ビジネスロジックに価格をハードコーディングしないでください。/api/pricing エンドポイントが信頼できる情報源です——公開カタログと同じ形状で、認証不要です。執筆時に再取得し、表の価格はそこから来ています。
エンドポイントアーキテクチャ
プラットフォーム上のすべて——画像でも動画でも、テキストから X でも X から X でも——は一つの非同期タスク契約を通じて動作します:
POST /v1/tasks
GET  /v1/tasks/{taskId}
フロー:
{ "model": "...", "input": { ... } }でPOST /v1/tasksを呼び出します。すぐにtaskIdが返ります。- 数秒ごとに
GET /v1/tasks/{taskId}をポーリングします。data.statusを監視してください——pendingからsuccessに変わります(またはエラーブロック付きのfail)。 successになったらdata.output[0].urlを読み取ります。それは hiapi CDN URL で、限られたexpireAtタイムスタンプが付いています。そのリソースを保持する必要がある場合は、ダウンロードして再ホストしてください。
古い /v1/chat/completions と /v1/images/generations の形状はもはや画像生成を提供していません。コードがまだそれらを呼び出しているなら、/v1/tasks へ移行する必要があります。
これは後になって感謝する類の決定です。タスクモードは自然なリトライ、目を離せる長時間 HTTP 接続、そして画像と動画で統一された形状を提供します。1 秒以内に 200 個のタスク送信をファンアウトし、それらをまとめてポーリングできます。
Python クイックスタート(そのまま実行可能)
最小クライアント、SDK 依存なし。標準ライブラリのみを使用:
import json, os, time, urllib.request

TOKEN = os.environ["HIAPI_API_KEY"]
BASE  = "https://api.hiapi.ai"

def submit(model: str, input_payload: dict) -> str:
    body = json.dumps({"model": model, "input": input_payload}).encode()
    req = urllib.request.Request(
        f"{BASE}/v1/tasks",
        data=body,
        headers={
            "Authorization": f"Bearer {TOKEN}",
            "Content-Type":  "application/json",
        },
    )
    with urllib.request.urlopen(req, timeout=60) as r:
        data = json.loads(r.read())
    if data.get("code") != 200:
        raise RuntimeError(f"submit failed: {data}")
    return data["data"]["taskId"]

def wait_for(task_id: str, timeout_s: int = 240) -> str:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        time.sleep(5)
        req = urllib.request.Request(
            f"{BASE}/v1/tasks/{task_id}",
            headers={"Authorization": f"Bearer {TOKEN}"},
        )
        with urllib.request.urlopen(req, timeout=30) as r:
            data = json.loads(r.read())
        task = data.get("data") or {}
        if task.get("status") == "success":
            return task["output"][0]["url"]
        if task.get("status") == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
    raise TimeoutError(f"{task_id} did not finish in {timeout_s}s")

# Image — nano-banana flat $0.05
task_id = submit("nano-banana", {"prompt": "a quiet bookshop at dusk", "aspect_ratio": "3:2"})
print(wait_for(task_id))

# Image — flux-1.1-pro flat $0.05
task_id = submit("flux-1.1-pro", {"prompt": "studio portrait, 50mm lens", "aspect_ratio": "1:1"})
print(wait_for(task_id))

# Video — wan2.7-video/text-to-video at 720P, $0.10 per second
task_id = submit("wan2.7-video/text-to-video", {"prompt": "a koi pond at dawn, gentle ripples", "resolution": "720P"})
print(wait_for(task_id, timeout_s=600))
このコードが本番対応になる前に、いくつかのことを組み込む必要があります:
submitとwait_forを指数バックオフ付きのリトライでラップします。ネットワークの揺らぎは必ず起こります。- 少なくとも 5 秒の
poll_intervalを使用します。これより頻繁なポーリングは無駄な作業です——画像タスクは 10〜60 秒で完了し、動画タスクは 60〜180 秒で完了します。 - 出力 URL を一時的なリソースとして扱います。CDN URL には
expireAtがあります。リクエスト後にリソースに何らかのライフサイクルがあるなら、バイトをダウンロードして自分のバケットに保存してください。 - モデルアダプターマッピングを固定します。
qwen-image-2.0と一部の動画モデルの入力形状は、デフォルトの画像アスペクト比とは異なります——この知識を一箇所に集中させてください。
hiapi は誰に向いているか
大まかに言って、hiapi は三種類のチームに向いています:
モデルごとに一つの SDK を統合することにうんざりしているチーム。 OpenAI 画像用に一つのアダプター、Black Forest Labs FLUX 用にもう一つ、Alibaba の DashScope 用にもう一つを維持したことがあるなら、N 個の異なる SDK による生産性の税を感じたことがあるでしょう。hiapi はそれをひとつのクライアントに簡素化します。
予測可能な価格設定を必要とするチーム。 呼び出し単位の定額形状により、生成ワーカーを構築し、先月のタスク数を確認し、来月の請求額を予測できます。token 課金のモデルではこれが難しいです。
画像と動画のワンストップサービスを望むチーム。 製品が両方にまたがるようになったら——たとえば、ブリーフからカバー画像と10 秒ループを生成するマーケティングツール——両方を一つのエンドポイントと一つの残高の背後に置く価値は、直接連携で節約できる画像あたりのコストを上回ります。
個人の Discord ボットを動かしている愛好家なら、上流の API を直接使っても問題ありません。実ユーザーを抱える実際の製品をリリースする段階になれば、統合の算術はゲートウェイに傾きます。
よくある質問
無料枠はありますか? 新規アカウントには少額のスターターフレジットがあり、コミットせずにエンドポイントをテストできます。使い切ったら、残高をチャージして完了したタスク単位で支払います。
どのアスペクト比がサポートされていますか?
一般的な比率——1:1、3:2、2:3、4:3、3:4、5:4、4:5、16:9、9:16、21:9——はほとんどの画像モデルで利用可能です。qwen-image-2.0 は代わりに固定のリテラルピクセルサイズのリストを使用します。上記のモデル schema の説明を参照してください。
リソースにウォーターマークはありますか? ありません。出力はクリーンな画像/動画ファイルで、hiapi のブランド表示はありません。
レート制限はどうですか? 非同期タスクモードは、非常に高速に大量の作業を送信できることを意味します。プラットフォームの安定性を保つためのアカウント単位の制限があります。より高い上限が必要なら、リリースのピーク前に申請してください——火曜日に上限を上げる方が、リリース期間中に上げるよりはるかに簡単です。
現在の価格はどこで確認できますか?
https://www.hiapi.ai/api/pricing。最大一時間キャッシュされ、各モデルの pricing_version が固定されているため、変更があれば気づくことができます。
出力は商用利用できますか?
プラットフォーム上のほとんどのモデルは上流で商用利用ライセンスを持っています——Nano-Banana シリーズ、FLUX 1.1 Pro、Qwen-Image は明示的にそうです——ただし、使用するモデルのライセンスタグ(tags フィールド)をリアルタイム価格レスポンスで確認してください。一部の専門モデルは条件がより厳しいためです。
どこから始めるか
ゼロから試すなら:
- hiapi ダッシュボードから API キーを取得します。
/api/pricingを一度呼び出して、現在のモデルカタログと価格を確認します。- 上記の Python スニペットをコピーし、
nano-bananaまたはgpt-image-2/text-to-image@betaに対して実行します——どちらも低コストモデルで、健全性チェックに適しています。数セントで動作するエンドツーエンドのループが得られます。 - そのループを構築中のものに接続します。動画も同じ形状。画像から画像も同じ形状。次にカタログに加わるモデルも同じ形状です。
これがすべてのセールスポイントです:一つのエンドポイント、一つの残高、一つのメンタルモデル。この記事の四枚の画像——カバーイラスト、写真級ポートレート、日中韓書道の看板、タイポグラフィポスター——はすべて上記のスニペットでレンダリングされ、異なるのは model 文字列と各モデルに正しい input 形状だけです。これら四枚の現在の推定予算は $0.172 です。
次に最先端の画像または動画モデルがプラットフォームに上陸したとき、あなたのワーカーは新しいコードを必要としません。変えるのは一つの文字列だけです。


