
Tutoriel
Guide pratique de seedance-2.0-fast : 5 scénarios d'application à forte valeur et points d'intégration clés
De la génération de vidéo à partir de texte ou d'image à la génération à partir de références : comment les développeurs peuvent intégrer ce modèle vidéo dans de vrais projets métier
Pourquoi utiliser seedance-2.0-fast pour valider des scénarios vidéo
L'étape la plus difficile pour déployer des capacités vidéo n'est souvent pas « peut-on générer ? », mais « vaut-il la peine de commencer ? ». seedance-2.0-fast est fourni par ByteDance, produit des vidéos et prend en charge trois modes d'entrée : text-to-video, image-to-video et reference-to-video. Cela signifie qu'une équipe peut couvrir avec un seul modèle trois points de départ très différents : une idée purement textuelle, un visuel principal existant, ou un style ou personnage déjà défini.
Pour une équipe d'ingénierie, sa valeur réside dans le « coût de validation maîtrisé ». Le modèle est facturé à la seconde de sortie et le coût croît linéairement avec la durée : les courts extraits sont bon marché, les films longs coûteux, ce qui fait de « tourner d'abord un petit extrait, puis passer à la production à grande échelle » un rythme naturel de travail d'ingénierie, plutôt qu'une contrainte rigide. Vous pouvez d'abord confirmer avec quelques secondes d'extrait la direction stylistique et la stabilité, puis décider s'il faut passer à la production en série.
Un autre aspect souvent négligé est le périmètre du modèle. Il produit des vidéos et ne prend pas en charge le montage, la musique, l'incrustation de sous-titres ni les autres étapes de post-production ; les trois modes d'entrée ne peuvent pas non plus être combinés en une requête composite « texte + image de référence + ancrage de style ». Mieux vaut inscrire ces limites dans la conception dès le départ : cela coûte bien moins cher que de corriger les erreurs après coup.
Il convient de l'utiliser comme premier modèle d'essai pour vidéoliser une activité : le champ de capacités est suffisamment large, le mode de facturation est clair (à la seconde de sortie) et l'intégration est unifiée. Une fois l'activité bien rodée et les besoins diversifiés, envisagez de combiner horizontalement d'autres modèles.
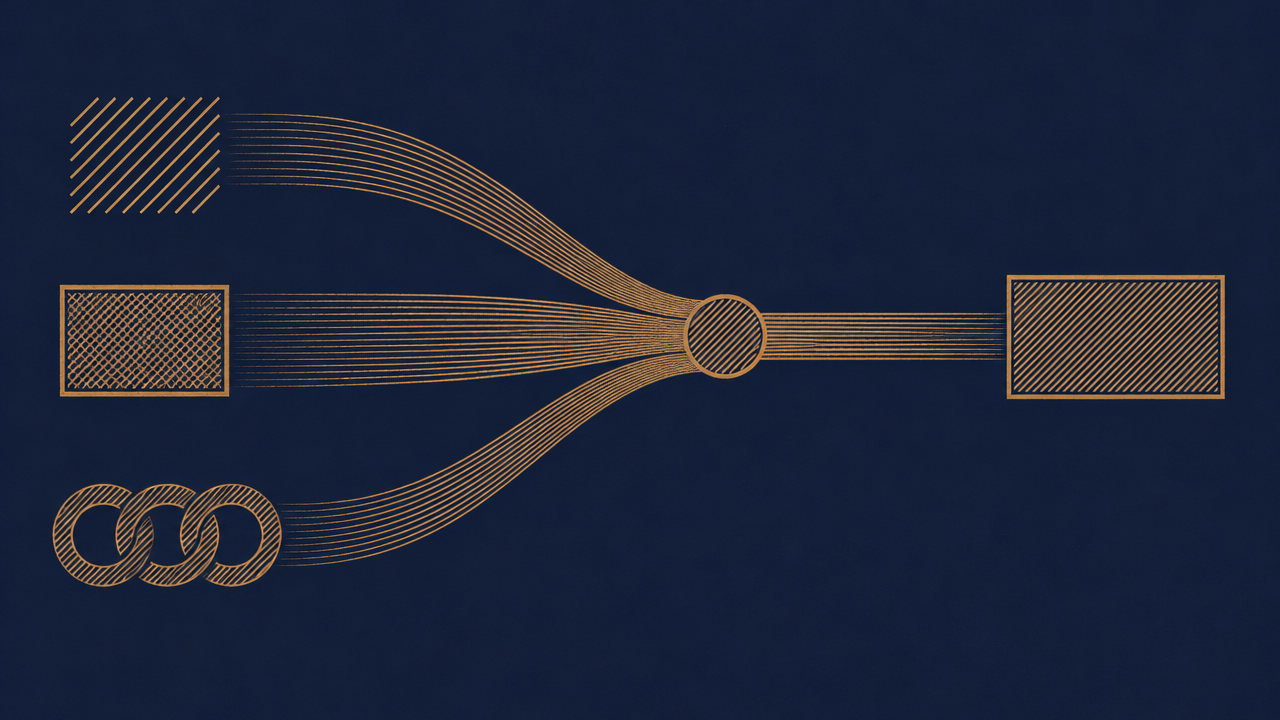
Choisir entre les trois modes d'appel : texte, image et référence
Choisir le mode d'appel revient à répondre à deux questions : disposez-vous de matériel ? Quel niveau d'exigence avez-vous en matière de cohérence ?
Sans matériel, partir de zéro : text-to-video
La génération est pilotée par une description purement textuelle. Adapté à l'exploration créative, aux concepts et à la production en série de plusieurs directions. Le prix à payer est la plus faible contrôlabilité : plusieurs appels avec le même prompt donnent des résultats différents, il ne faut pas espérer reproduire image par image.
Avec un visuel principal à prolonger : image-to-video
Une image existante sert de point de départ et est étendue en contenu animé. Adapté aux éléments déjà dotés d'un visuel défini : KV de marque, visuels produits, affiches. Contrainte essentielle : l'image d'entrée détermine en grande partie la composition et la tonalité ; le rôle du prompt est de décrire « comment ça bouge », non « à quoi ça ressemble ».
Pour conserver un style ou un personnage : reference-to-video
Des éléments de référence servent à ancrer un style ou les traits d'un personnage, puis à générer du nouveau contenu. Adapté à la production sérielle : un même personnage dans différents décors, un même langage visuel sur plusieurs films. Plus l'exigence de cohérence est élevée, plus la qualité et la représentativité des références sont déterminantes.
Ordre de décision
Demandez d'abord « ai-je une image utilisable » : non → text-to-video ; oui et avec exigence de continuité visuelle → image-to-video ; oui et avec exigence d'unité stylistique entre plusieurs contenus → reference-to-video. Demandez ensuite « s'agit-il d'exploration ou de production » : en phase d'exploration, on tolère les écarts ; en phase de production, la cohérence est prioritaire. Les deux situations correspondent souvent à des modes d'appel différents.
Un principe de repli utile : en cas de doute, commencez par text-to-video pour dégager une direction, puis passez à image-to-video ou reference-to-video pour la version finale. Ainsi, le coût d'échec de chaque étape reste au niveau d'un court extrait.
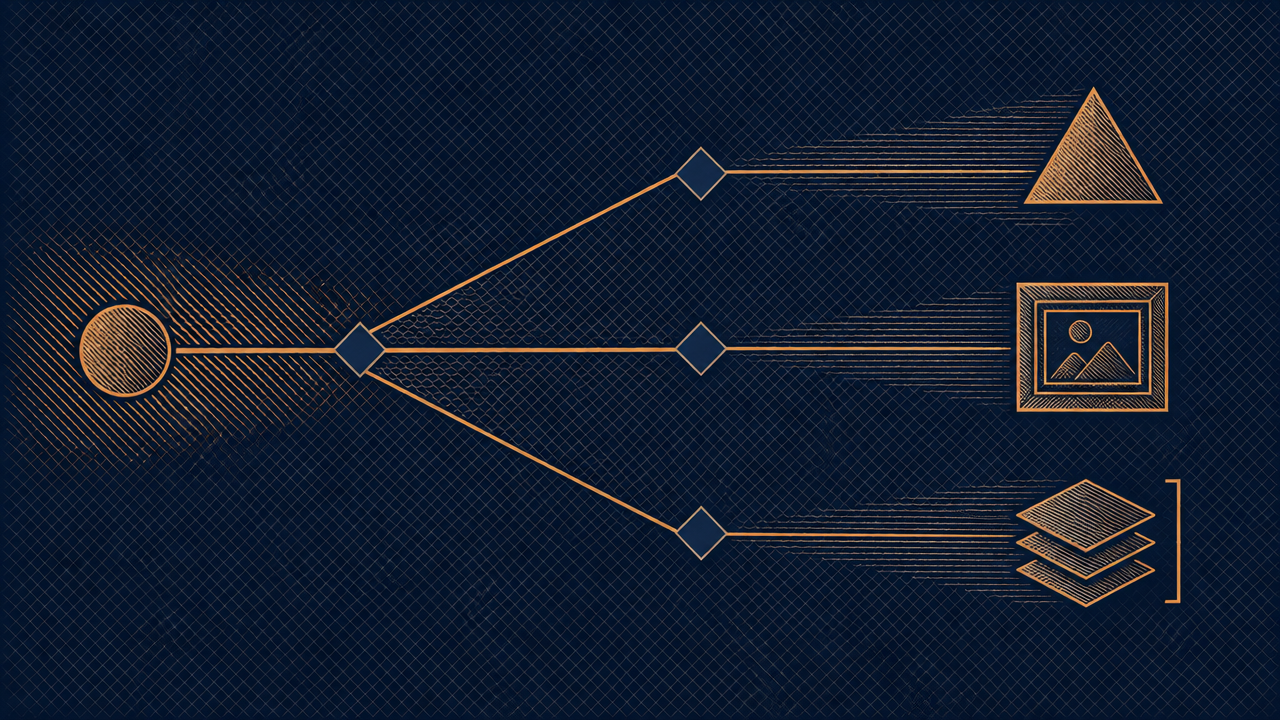
Scénario 1 : génération par lots de vidéos courtes pour le marketing
C'est l'usage le plus direct : produire par lots avec text-to-video plusieurs versions de supports publicitaires, couvrant différents arguments de vente, émotions et accroches.
Conception du processus
Décomposez « une vidéo » en trois niveaux : script d'argumentaire (humain) → modèle de prompt (semi-automatique) → appels par lots (programme). Le modèle de prompt fixe le langage caméra, le rythme et la description du style ; seules les parties variables sont réservées aux arguments et aux scènes. C'est ainsi que les productions générées en série deviennent comparables, et que l'équipe créative peut rapidement sélectionner les versions utilisables.
Trois points d'attention pour passer à l'échelle
Premièrement, avancer par petits lots. Lancez d'abord une série de courts extraits pour voir si le style global tient, puis augmentez le volume. Générer d'un coup un grand nombre de films longs démultiplie le coût d'échec avec la durée.
Deuxièmement, conserver des métadonnées pour chaque production. Version du prompt, mode d'appel, durée et date de génération doivent être consignés ; sinon, avec plusieurs centaines de contenus entassés, la sélection manuelle devient un cauchemar.
Troisièmement, accepter l'aléa et en faire une option. Relancer plusieurs fois le même prompt revient à faire « diverger la machine, converger l'humain » : c'est précisément la valeur de la génération vidéo par lots à partir de texte, ne cherchez pas à l'éliminer.
Scénario 2 : prolonger un visuel principal existant en contenu animé
Lorsque la marque dispose déjà de visuels définis, image-to-video est l'étape au meilleur rapport qualité-prix : transformer des KV statiques, visuels produits et affiches en supports animés diffusables, la base visuelle étant verrouillée par l'image d'entrée, sans réalignement de style.
Points de mise en œuvre
La qualité de l'image d'entrée détermine directement le plafond du résultat. Privilégiez les images bien composées, au sujet net et avec des espaces vides raisonnables ; sur une image trop recadrée ou trop dense en informations, le modèle trouvera difficilement un espace de mouvement cohérent.
Le prompt doit décrire le « mouvement », non le « contenu ». Décrire les travellings et zooms, les variations de lumière et les micro-mouvements d'éléments locaux est plus efficace que répéter ce que contient l'image — l'image est déjà donnée par l'entrée.
Maîtrise de la cohérence
Le risque principal de cette approche est un « mouvement inapproprié » : déformation du sujet, déchirure de l'image, direction de mouvement contraire au bon sens physique. Il est conseillé d'établir une liste de contrôle par type de support, en figeant les problèmes courants en points de vérification plutôt qu'en jugeant à l'œil à chaque fois.
Par ailleurs, une même image d'entrée associée à différentes descriptions de mouvement permet de produire une série de contenus de même origine. C'est très pratique pour les scénarios marketing nécessitant « un même visuel principal, plusieurs versions de diffusion », et le coût ne porte que sur la durée.
Scénario 3 : production de contenus sériels à style homogène
La difficulté des contenus sériels n'a jamais été la qualité d'un épisode isolé, mais que le 10e ressemble au 1er comme s'ils appartenaient au même monde. reference-to-video est prévu pour ce besoin : ancrer le style ou les traits d'un personnage via des références, puis générer de nouvelles scènes.
Organisation des appels
Constituez une « bibliothèque de références » — un petit nombre de références de haute qualité, représentatives et couvrant les angles clés, est plus efficace qu'une grande quantité de références vagues. Si chaque requête de génération pointe vers le même groupe de références, la dérive stylistique se réduit nettement.
Le prompt gère « ce qui doit se passer dans cet épisode », les références gèrent « à quoi cela ressemble ». Il faut bien séparer les rôles, sinon un prompt saturé de descriptions stylistiques entre en conflit avec les références.
Recommandations d'ingénierie
Inscrivez le numéro de version des références dans les métadonnées des productions. Les contenus sériels impliquent souvent de faire évoluer le jeu de références ; sans historique de version, impossible de retracer « avec quelle version de style ce film a été généré ».
Il faut aussi accepter une réalité : la cohérence est un problème probabiliste, pas un interrupteur. En production de masse, prévoyez une proportion de sélection manuelle et éliminez ou relancez les éléments manifestement dérivés ; c'est plus réaliste que de viser la réussite du premier coup.
Scénario 4 : démonstration de fonctionnalités produit et vidéos explicatives animées
Les vidéos de démonstration de fonctionnalités et d'explication de concepts ont une forte demande, un cycle de vie court et des mises à jour fréquentes : c'est précisément le terrain de jeu des modèles génératifs — mais aussi le scénario où le coût de relecture est le plus sous-estimé.
Organisation du prompt
Le cœur d'une vidéo explicative est l'« exactitude de l'information », non l'« esthétique ». Le prompt doit être décomposé par plan : écrivez d'abord le point d'information unique que chaque plan doit transmettre, puis ajoutez les mouvements de caméra et le rythme. Un plan, une information, donne plus facilement un résultat exploitable qu'un long paragraphe contenant trois concepts.
Les contenus impliquant interfaces, textes ou données exigent une prudence particulière : la génération vidéo ne restitue pas fidèlement les UI et les textes ; ces supports se prêtent mieux à des schémas animés abstraits qu'à une reproduction fidèle au niveau de l'interface.
Étape de relecture humaine
C'est une étape indispensable dans ce scénario. La relecture porte non sur l'esthétique, mais sur les faits : l'énoncé du concept est-il correct, l'ordre des étapes est-il bon, des éléments visuels trompeurs ont-ils été générés. Il est conseillé de figer les points de contrôle dans une liste et de la faire parcourir par une personne qui connaît le métier, plutôt que par le seul producteur.
De plus, les contenus explicatifs étant fréquemment mis à jour, il est conseillé de traiter la « régénération » comme une action courante et non exceptionnelle, et de gérer prompts et supports comme des actifs réutilisables.
Scénario 5 : validation créative rapide en phase de prototypage
Au début d'un projet, le plus coûteux n'est pas la production, mais d'avoir terminé quelque chose dans la mauvaise direction. L'usage dans ce scénario est très clair : valider rapidement une direction créative avec de courts extraits et avancer la décision « faut-il le faire » à une phase peu coûteuse.
Méthode
Décomposez l'idée en plusieurs hypothèses vérifiables indépendamment : le style est-il bon, le rythme est-il bon, l'émotion est-elle bonne. Chaque hypothèse se valide par un court extrait, plutôt que de faire un film complet portant toutes les hypothèses. Le coût d'un court extrait décroît linéairement avec la durée : c'est là que la facturation à la seconde est la plus favorable au prototypage.
Les trois modes d'appel sont utilisables ici : sans matériel, text-to-video pour diverger ; avec un visuel existant, image-to-video pour voir l'effet dynamique ; avec des actifs de marque, reference-to-video pour confirmer la continuité stylistique.
Éviter les reprises en post-production
L'essentiel est de capitaliser les conclusions des extraits. Quelle version a été rejetée, pourquoi, qu'est-ce qui a changé : tout doit être consigné. Sinon, en phase de production finale, les mêmes discussions recommencent et la validation aura servi à rien.
Il faut aussi clarifier le statut de l'extrait : c'est un support de décision, pas un livrable. S'accorder là-dessus en amont avec le demandeur évite de nombreuses tensions sur « peut-on utiliser directement l'extrait ».
Coûts et mise en œuvre d'ingénierie : points d'intégration sous facturation à la seconde
seedance-2.0-fast est facturé à la seconde de sortie, le coût croît linéairement avec la durée de la vidéo. Ce n'est pas une simple note de facturation, mais une contrainte qui modifie directement la conception des solutions.
Maîtriser la durée, c'est maîtriser le coût
Intégrez la durée au modèle budgétaire dès la conception : durée unitaire × nombre d'éléments × lots = consommation totale prévisible. En prototypage, utilisez par défaut des durées courtes ; en production finale, allongez selon les besoins des emplacements de diffusion. N'utilisez pas de longs films pour tâtonner en phase de validation : ce serait dépenser les ressources les plus coûteuses sur l'étape la plus incertaine.
Considérer le pipeline asynchrone comme un tout
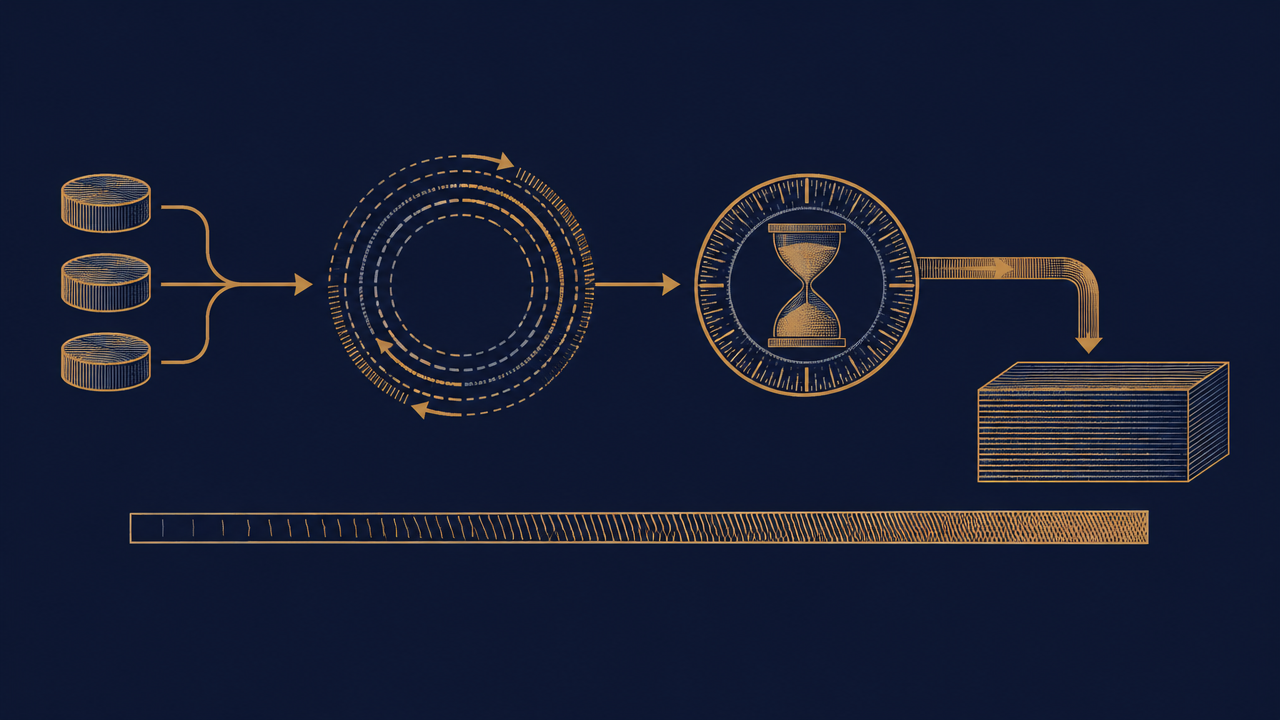
La génération vidéo est une tâche longue ; l'intégration doit être conçue comme une chaîne asynchrone, non comme une requête synchrone. Le pipeline complet comporte au moins quatre segments :
- Soumission de tâche : enregistrer les paramètres de requête et l'identifiant métier, renvoyer un ID de tâche traçable
- Progression de l'état : interrogation périodique ou callback, en choisir un et garantir l'idempotence pour éviter les doubles traitements
- Nouvelle tentative en cas d'échec : distinguer « réessayable » (timeout, erreur temporaire) et « non réessayable » (paramètres invalides, contenu refusé), avec un nombre maximal et un backoff
- Stockage des productions : enregistrer les vidéos sur disque ou les transférer vers un stockage objet ; si le lien généré est temporaire, le déplacer au plus vite pour que l'activité ne dépende pas d'une URL à court terme
Encapsuler dans une couche de service interne unifiée
Enveloppez la capacité vidéo dans un service interne : modèle de tâche unifié, format de callback unifié, adresse de production unifiée. Les couches métier supérieures ne dépendent que de cette interface ; lors d'un remplacement ou d'une combinaison ultérieure avec d'autres modèles vidéo, les modifications restent confinées à cette couche de service. C'est la méthode la plus simple pour réduire le risque de dépendance à un seul modèle.
Il en va de même pour le diagnostic : vérifiez d'abord si le flux d'états de la tâche est normal, puis les paramètres et les matériaux d'entrée, et seulement en dernier la performance du modèle. La grande majorité des « échecs de génération » se bloquent en réalité dans les deux premiers segments.
Menez sérieusement la validation par extraits, puis lancez la production en série : c'est alors que la valeur de ce modèle se révèle vraiment ; pour consulter les capacités et le mode de facturation, fiez-vous directement aux informations en temps réel de la page du modèle sur le site.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat