
Tutorial
Guía práctica de seedance-2.0-fast: 5 escenarios de aplicación de alto valor y puntos clave de integración
Desde texto a vídeo, imagen a vídeo hasta referencia a vídeo: cómo los desarrolladores pueden integrar este modelo de vídeo en negocios reales
Por qué usar seedance-2.0-fast para validar escenarios de vídeo
El paso más difícil para llevar las capacidades de vídeo a producción no suele ser «si se puede generar», sino «si vale la pena empezar por aquí». seedance-2.0-fast lo ofrece ByteDance, su tipo de salida es vídeo y admite tres formas de entrada: text-to-video, image-to-video y reference-to-video. Esto significa que un equipo puede cubrir con un mismo modelo tres puntos de partida de material completamente distintos: una idea puramente textual, un visual principal ya existente o un estilo o personaje ya definido.
Para los equipos de ingeniería, su valor está en que «el coste de validación es controlable». El modelo se factura por segundos de salida y el coste crece linealmente con la duración: los clips cortos son baratos y los largos, caros. Esto convierte «primero hacer una muestra pequeña y luego escalar la producción» en un ritmo de trabajo natural, no en una restricción impuesta. Puedes confirmar primero la dirección estética y la estabilidad con un clip de unos pocos segundos y después decidir si pasar a la producción masiva.
Otro punto que a menudo se pasa por alto es el límite de capacidades. Lo que produce es vídeo, no se encarga de la edición, la música ni la composición de subtítulos, que son fases de postproducción; además, las tres formas de entrada no pueden combinarse en una solicitud compuesta de «texto + imagen de referencia + ancla de estilo». Conviene dejar estos límites escritos en el planteamiento antes de la integración: sale mucho más barato que depurar errores después.
Es adecuado como primer modelo de prueba para llevar el vídeo al negocio: su abanico de capacidades es amplio, su criterio de facturación es claro (por segundos de salida) y su forma de integración es uniforme. Cuando el negocio funcione y las necesidades se diversifiquen, ya se podrá considerar combinar otros modelos de forma transversal.
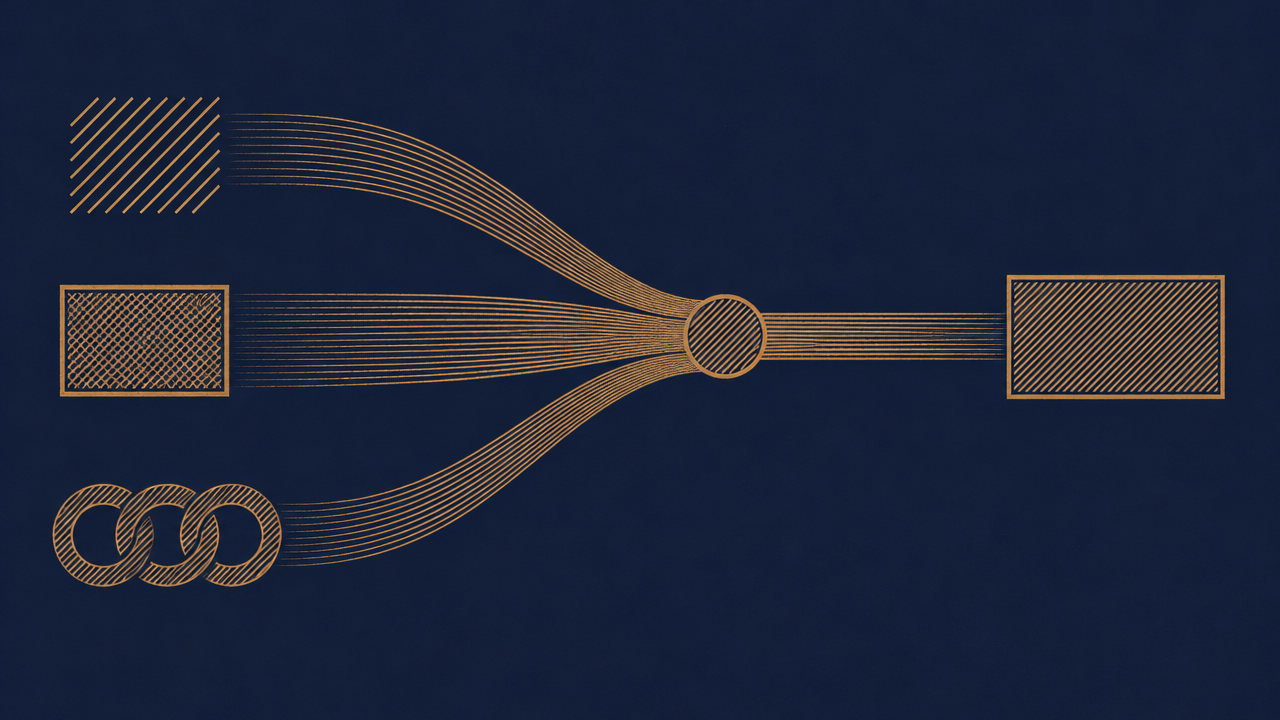
Cómo elegir entre las tres formas de invocación: texto, imagen y referencia
Para elegir la forma de invocación solo hay que responder a dos preguntas: ¿tengo material a mano? ¿Qué nivel de consistencia exijo?
Sin material, desde cero: text-to-video
Generación guiada por una descripción puramente textual. Es adecuada para la divergencia creativa, la exploración de conceptos y la producción masiva de múltiples versiones de una dirección. El precio es el menor control posible: si se invoca varias veces el mismo prompt, los resultados varían; no hay que esperar una reproducción fotograma a fotograma.
Con un visual principal ya existente y necesidad de continuidad de imagen: image-to-video
Toma una imagen existente como punto de partida visual y la extiende a contenido en movimiento. Es adecuada para materiales con un visual ya definido, como el KV de marca, las imágenes de producto o los pósteres. La restricción clave es que la imagen de entrada determina básicamente la composición y la gama cromática; el prompt sirve para describir «cómo se mueve», no «cómo es».
Con necesidad de mantener un estilo o un personaje coherente: reference-to-video
Se usa material de referencia para anclar el estilo o los rasgos del personaje y después generar contenido nuevo. Es adecuada para la producción seriada: un mismo personaje en escenarios distintos, un mismo lenguaje visual en varias piezas. Cuanto mayor sea la exigencia de consistencia, más críticas serán la calidad y la representatividad del material de referencia.
Orden de decisión
Primero pregúntate «¿tengo una imagen utilizable?»: si no la hay, usa text-to-video; si la hay y se exige continuidad de imagen, usa image-to-video; si la hay y se exige uniformidad de estilo entre piezas, usa reference-to-video. Después pregúntate «¿esta pieza es exploración o producción?»: en la fase de exploración se toleran diferencias y en la fase de producción prima la consistencia; las formas de invocación correspondientes suelen ser distintas.
Un principio práctico de reserva: cuando no lo tengas claro, primero obtén la dirección con text-to-video y, una vez definida, cambia a image-to-video o reference-to-video para la versión formal. Así el coste de cada fallo se queda en el nivel de un clip corto de muestra.
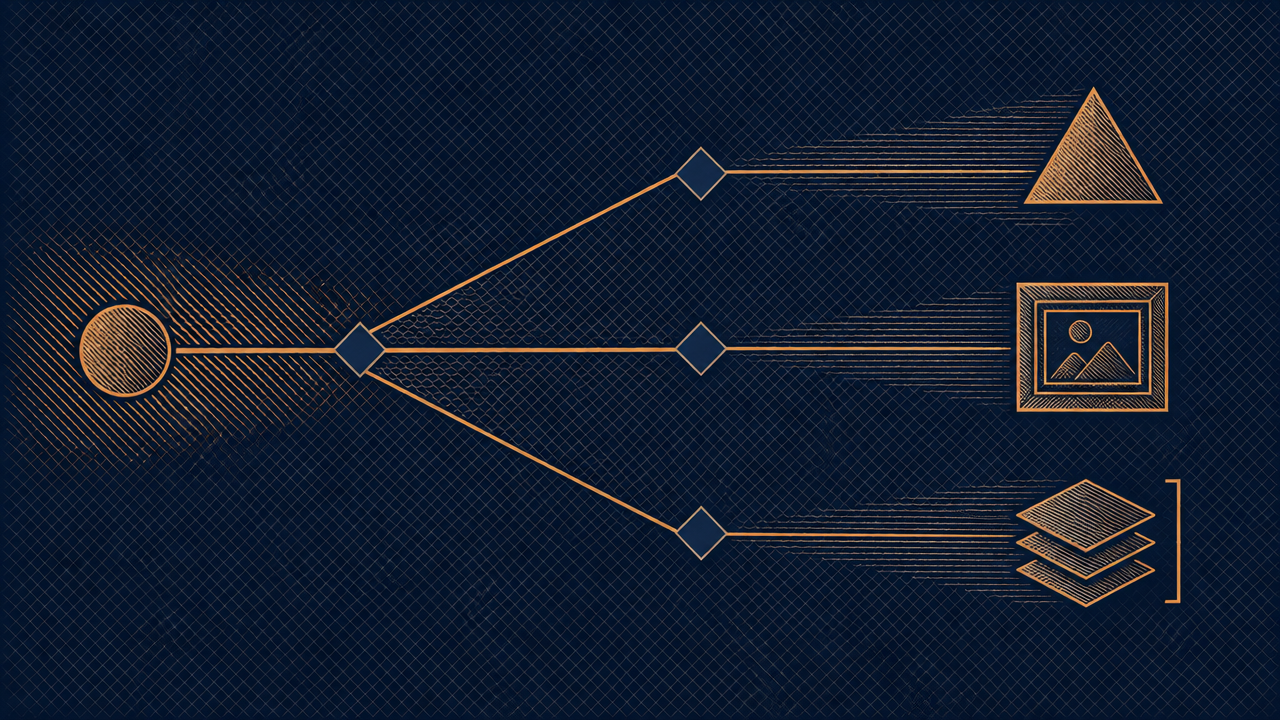
Escenario 1: generación masiva de vídeos cortos para material de marketing
Es el uso más directo: producir por lotes con text-to-video múltiples versiones de material para campañas, cubriendo distintos argumentos de venta, emociones y aperturas.
Diseño del flujo
Divide «un vídeo» en tres capas: guion de argumentos de venta (manual) → plantilla de prompts (semautomática) → invocación masiva (programática). La plantilla de prompts fija el lenguaje de cámara, el ritmo y la descripción del estilo; la parte variable se reserva solo para el argumento de venta y el escenario. Solo así los productos generados en lote son comparables y el equipo de contenido puede seleccionar rápido las versiones utilizables.
Tres advertencias para escalar
Primera: avanza en lotes pequeños. Ejecuta primero un lote de clips cortos para ver si el estilo general se sostiene y después amplía el lote. Si despliegas de golpe muchos vídeos largos, el coste del fallo se multiplica con la duración.
Segunda: guarda metadatos de cada producto. Hay que registrar la versión del prompt, la forma de invocación, la duración y la hora de generación; de lo contrario, con cientos de materiales acumulados, la selección manual se convierte en un desastre.
Tercera: acepta la aleatoriedad y conviértela en una opción. Ejecutar varias veces el mismo prompt es, en esencia, «divergencia de la máquina y convergencia humana»; ese es precisamente el valor del text-to-video masivo, así que no intentes eliminarlo.
Escenario 2: extender contenido en movimiento a partir de un visual principal existente
Cuando la marca ya tiene material gráfico definido, image-to-video es el paso con mejor relación coste-beneficio: convierte el KV estático, las imágenes de producto o los pósteres en material dinámico publicable; la base visual queda fijada por la imagen de entrada y no hay que realinear el estilo.
Puntos de implementación
La calidad de la imagen de entrada determina directamente el techo del resultado. Prioriza imágenes con composición completa, sujeto nítido y espacios en blanco razonables; en imágenes demasiado recortadas o con mucha información, al modelo le cuesta encontrar un espacio de movimiento razonable.
En el prompt hay que escribir «movimiento», no «contenido». Describir el zoom, los cambios de luz y sombra o los movimientos leves de elementos locales es más eficaz que repetir qué hay en la imagen, porque la imagen ya viene dada por la entrada.
Control de la consistencia
El riesgo central de esta vía es que «se mueva mal»: deformación del sujeto, roturas de imagen o direcciones de movimiento que contradicen el sentido físico. Conviene establecer listas de aceptación por tipo de material y fijar los problemas habituales como puntos de comprobación, en lugar de juzgar cada vez a ojo.
Además, una misma imagen de entrada con distintas descripciones de movimiento permite obtener un conjunto de materiales con el mismo origen. Esto es muy favorable para escenarios de marketing que necesitan «un mismo visual principal con varias versiones de campaña», y el coste solo depende de la duración.
Escenario 3: producción de contenido seriado con estilo uniforme
La dificultad del contenido seriado nunca es la calidad de una sola pieza, sino que la décima y la primera parezcan del mismo mundo. reference-to-video está pensado justo para esa necesidad: anclar el estilo o los rasgos del personaje con material de referencia y después generar escenarios nuevos.
Cómo organizar las invocaciones
Crea una «biblioteca de material de referencia»: un conjunto reducido de materiales de alta calidad, muy representativos y que cubran los ángulos clave es más eficaz que muchos materiales genéricos. Si cada solicitud de generación apunta al mismo conjunto de referencias, la deriva de estilo se reduce de forma notable.
El prompt se encarga de «qué ocurre en esta pieza» y el material de referencia, de «cómo es». Hay que separar ambas responsabilidades; de lo contrario, un prompt saturado de descripciones de estilo entrará en conflicto con el material de referencia.
Recomendaciones de ingeniería
Incluye el número de versión del material de referencia en los metadatos del producto. El contenido seriado suele requerir iterar el conjunto de referencias; sin un registro de versiones no se puede rastrear «con qué versión de estilo se generó esta pieza».
Al mismo tiempo, hay que aceptar una realidad: la consistencia es una cuestión de probabilidad, no un interruptor. En la producción masiva conviene reservar una proporción de selección manual y descartar o regenerar las piezas con deriva evidente; es más realista que pretender acertar a la primera.
Escenario 4: demostraciones de funcionalidades de producto y vídeos explicativos dinámicos
Los vídeos de demostración de funcionalidades y de explicación de conceptos tienen mucha demanda, un ciclo de vida corto y actualizaciones frecuentes: es justo el terreno de los modelos generativos, pero también el escenario donde más se subestima el coste de revisión.
Organización del prompt
El núcleo de un vídeo explicativo es que «la información sea correcta», no que «sea bonito». El prompt debe desglosarse por planos: primero escribe el único punto de información que debe transmitir cada plano y después añade el movimiento de cámara y el ritmo. Un plano, una información, da resultados utilizables con más facilidad que un párrafo largo con tres conceptos dentro.
Hay que ser especialmente prudente con contenidos que impliquen interfaces, texto o datos: el vídeo generado no es bueno reproduciendo con precisión UI y texto, así que este tipo de material encaja mejor como esquema dinámico abstraído que como reproducción fiel de la interfaz.
Fase de revisión humana
Es un paso imprescindible en este escenario. El foco de la revisión no es la estética, sino los hechos: si la formulación de los conceptos es correcta, si el orden del flujo es el adecuado y si se han generado elementos visuales engañosos. Conviene fijar los puntos de revisión en una lista y que la revise alguien que entienda el negocio, no solo quien produce el material.
Además, como el contenido explicativo se actualiza con frecuencia, se recomienda tratar la «regeneración» como una acción habitual y no como una excepción, y gestionar tanto los prompts como los materiales como activos reutilizables.
Escenario 5: validación creativa rápida en la fase de prototipo
En las primeras fases de un requisito, lo más caro no es producir, sino terminar algo cuando la dirección ya era equivocada. El uso en este escenario es muy claro: validar rápido la dirección creativa con clips cortos de muestra y adelantar la decisión de «si hacerlo o no» a una fase de bajo coste.
Método
Descompón la idea en varias hipótesis verificables por separado: si el estilo es el correcto, si el ritmo es el correcto, si la emoción es la correcta. Valida cada hipótesis con un clip corto, en lugar de hacer una pieza completa que cargue con todas las hipótesis. El coste de los clips cortos baja linealmente con la duración; ahí es donde la facturación por segundos resulta más favorable para la fase de prototipo.
Las tres formas de invocación sirven aquí: si no hay material, text-to-video para divergir; si hay un visual existente, image-to-video para ver el efecto dinámico; si hay activos de marca, reference-to-video para confirmar la continuidad del estilo.
Evitar retrabajos posteriores
Lo clave es dejar registradas las conclusiones de las muestras. Qué versión se rechazó, por qué y qué se cambió: todo debe quedar registrado. De lo contrario, al entrar en producción formal la misma discusión se repetirá y la validación habrá sido en vano.
También hay que dejar claro el papel de las muestras: son material para decidir, no entregables. Alinear esto con el cliente o el área solicitante por adelantado ahorra muchas discusiones sobre «si la muestra se puede usar directamente».
Coste e implementación de ingeniería: puntos clave de integración con facturación por segundos
seedance-2.0-fast se factura por segundos de salida y el coste crece linealmente con la duración del vídeo. No es una simple nota de facturación, sino una condición restrictiva que cambia directamente el diseño de la solución.
Controlar la duración es controlar el coste
Incorpora la duración al modelo de presupuesto ya en la fase de diseño: duración por pieza × número de piezas × lotes = consumo total estimable. En la fase de prototipo, usa por defecto duraciones cortas; en la producción formal, alarga según las necesidades del soporte de campaña. No pruebes a ciegas con vídeos largos en la fase de validación: sería gastar el recurso más caro en el eslabón más incierto.
La canalización asíncrona debe tratarse como un conjunto
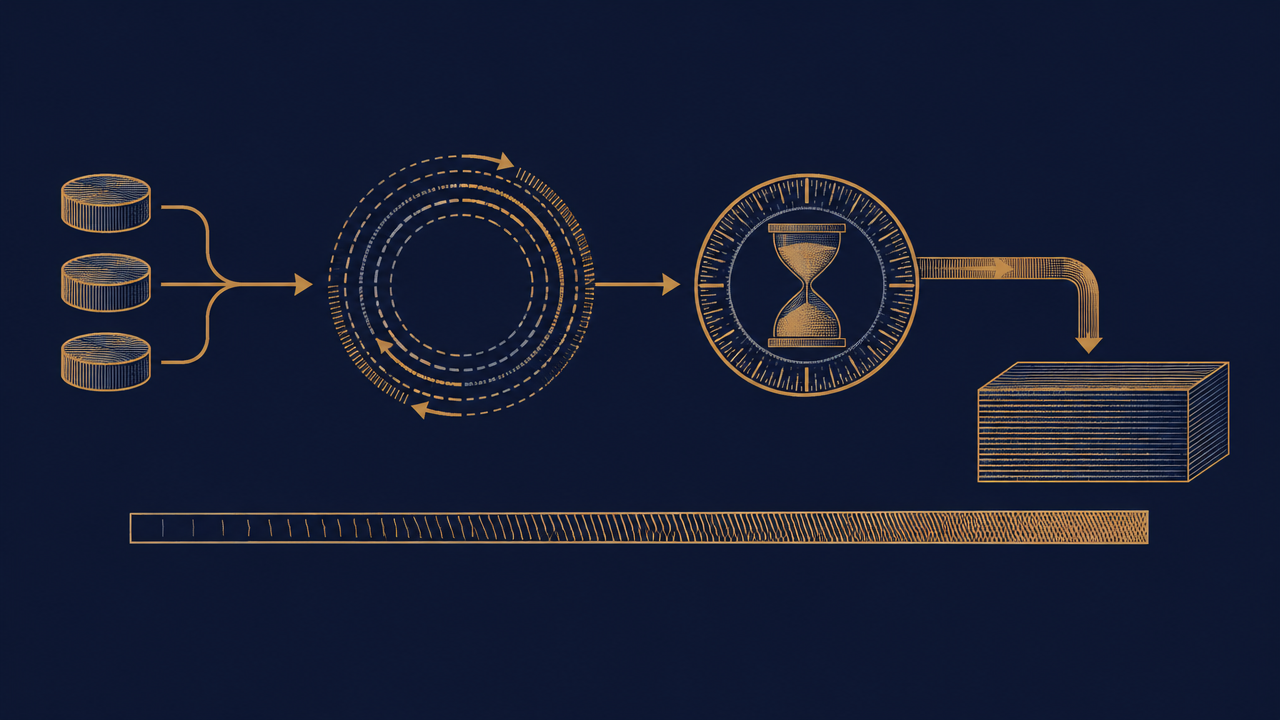
La generación de vídeo es una tarea de larga duración; al integrarla hay que diseñar una cadena asíncrona, no tratarla como una solicitud síncrona. Una canalización completa incluye al menos cuatro tramos:
- Envío de la tarea: registrar los parámetros de la solicitud y el identificador de negocio, y devolver un ID de tarea rastreable
- Avance de estado: sondeo o callback, elegir uno e implementar la idempotencia para evitar consumos duplicados
- Reintento ante fallos: distinguir entre «reintentable» (timeout, error temporal) y «no reintentable» (parámetros inválidos, contenido rechazado); el reintento debe tener límite y retroceso exponencial
- Almacenamiento del producto: guardar el vídeo en disco o transferirlo a almacenamiento de objetos; si se genera un enlace temporal, hay que moverlo cuanto antes para que el negocio no dependa de una URL de corta duración
Encapsular como capa de servicio interna unificada
Envuelve la capacidad de vídeo en un servicio interno: modelo de tareas unificado, formato de callback unificado y dirección de producto unificada. El negocio superior solo depende de esta capa de interfaz; cuando más adelante se sustituyan o combinen otros modelos de vídeo de forma transversal, los cambios quedarán limitados al interior de la capa de servicio. Es la forma más sencilla de reducir el riesgo de dependencia de un único modelo.
Para depurar ocurre lo mismo: primero comprueba si la transición de estados de la tarea es normal, después revisa los parámetros y el material de entrada y solo al final sospecha del comportamiento del modelo. La gran mayoría de los «fallos de generación» se atascan en los dos primeros tramos.
Si la validación con muestras se hace con rigor y luego se pone en marcha la producción masiva, el valor de este modelo se hará realmente visible; para consultar las capacidades y el criterio de facturación, toma como referencia la información en tiempo real de la página del modelo en el sitio.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado