
Tutoriale
Guida pratica a seedance-2.0-fast: 5 scenari applicativi di alto valore e punti chiave per l'integrazione
Dal text-to-video all'image-to-video fino al reference-to-video: come gli sviluppatori possono integrare questo modello video in scenari di business reali
Perché usare seedance-2.0-fast per validare gli scenari video
Il passo più difficile nel portare le capacità video in produzione spesso non è «se si può generare», ma «se vale la pena farlo per primi». seedance-2.0-fast è fornito da ByteDance, il tipo di output è video e supporta tre modalità di input: text-to-video, image-to-video e reference-to-video. Questo significa che un team può coprire con un unico modello tre punti di partenza completamente diversi per i materiali: pura creatività testuale, visual principale già esistente, stile o personaggio già definiti.
Per i team di ingegneria, il valore sta nel «costo di validazione controllabile». Il modello viene fatturato in base ai secondi di output, con un costo che cresce linearmente con la durata: i campioni brevi costano poco, i filmati lunghi costano di più, e questo rende naturale il ritmo ingegneristico di «prima girare un piccolo campione, poi scalare la produzione», anziché un vincolo rigido. Puoi prima confermare l'orientamento dello stile e la stabilità con un campione di pochi secondi, e poi decidere se passare alla produzione in serie.
Un altro punto spesso trascurato sono i confini delle capacità. L'output è video e non si occupa di montaggio, colonna sonora o aggiunta di sottotitoli, fasi di post-produzione; inoltre le tre modalità di input non possono essere combinate in una richiesta composita di «testo + immagine di riferimento + ancora di stile». Scrivere questi confini nel piano prima dell'integrazione costa molto meno che correggere gli errori dopo.
È adatto come primo modello sperimentale per la video-izzazione del business: l'ampiezza delle capacità è sufficiente, il criterio di fatturazione è chiaro (in base ai secondi di output) e la modalità di integrazione è uniforme. Una volta che il business funziona e le esigenze si differenziano, si potrà valutare la combinazione orizzontale con altri modelli.
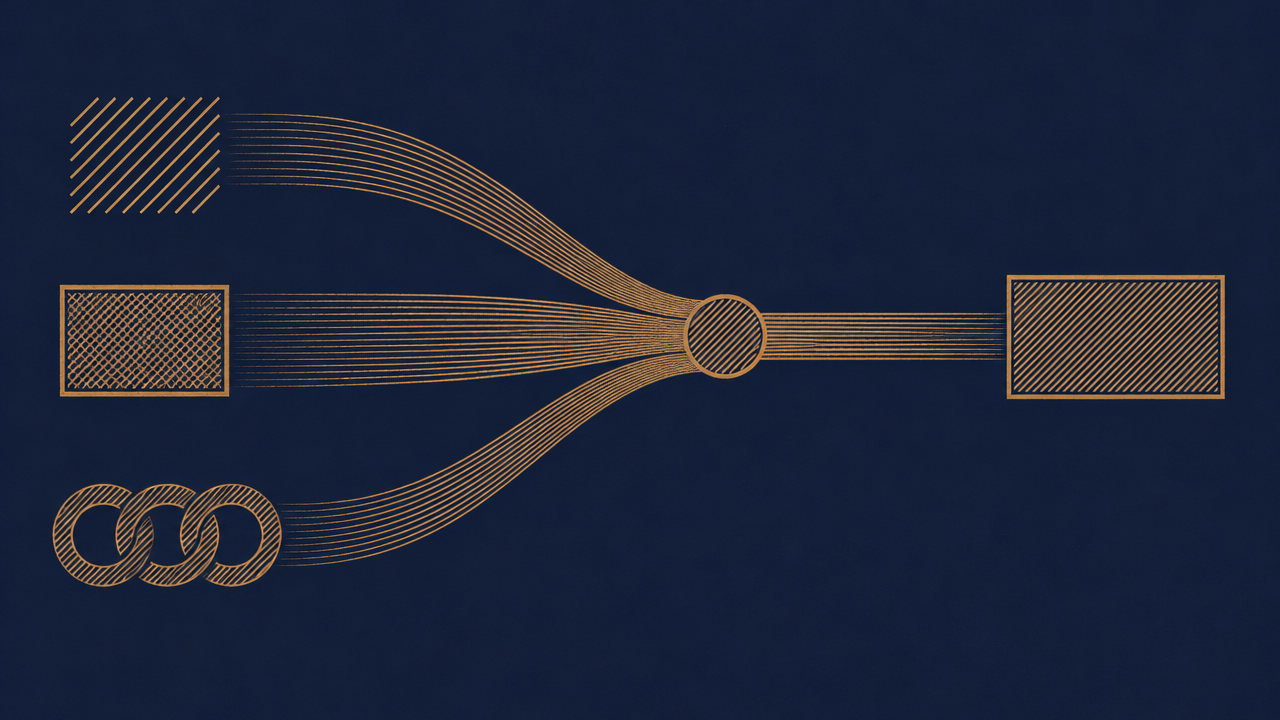
Come scegliere tra le tre modalità di chiamata: text-to-video, image-to-video e reference-to-video
Per scegliere la modalità di chiamata basta rispondere a due domande: hai materiali a disposizione? Quanto è alta la richiesta di coerenza?
Nessun materiale, si parte da zero: text-to-video
Generazione guidata da una descrizione puramente testuale. Adatta alla divergenza creativa, all'esplorazione di concetti e alla produzione in serie di più direzioni. Il prezzo da pagare è la minore controllabilità: più chiamate con lo stesso prompt producono risultati diversi, non aspettarti una riproduzione fedele fotogramma per fotogramma.
Visual principale già esistente, si vuole mantenere la continuità dell'immagine: image-to-video
Si parte da un'immagine esistente come punto iniziale e la si estende in contenuto dinamico. Adatta a materiali con un visual già definito come KV di brand, immagini di prodotto, poster. Il vincolo chiave è che l'immagine di input determina sostanzialmente composizione e tonalità, e il ruolo del prompt è descrivere «come si muove», non «che aspetto ha».
Mantenere la coerenza di stile o personaggio: reference-to-video
Si usano materiali di riferimento per ancorare lo stile o le caratteristiche del personaggio, e poi si genera nuovo contenuto. Adatta alla produzione seriale: lo stesso personaggio in scene diverse, lo stesso linguaggio visivo su più filmati. Più alta è la richiesta di coerenza, più critica diventa la qualità e la rappresentatività dei materiali di riferimento.
Ordine decisionale
Prima domanda: «ci sono immagini utilizzabili?» Se no, si va di text-to-video; se sì e serve continuità dell'immagine, image-to-video; se sì e serve uniformità di stile tra più contenuti, reference-to-video. Poi chiediti: «questo è esplorazione o produzione?» In fase esplorativa si tollerano le differenze, in fase produttiva si privilegia la coerenza, e le due fasi corrispondono spesso a modalità di chiamata diverse.
Un principio pratico di fallback: quando sei incerto, prima produci una direzione con text-to-video, e una volta definita la direzione passa a image-to-video o reference-to-video per la versione ufficiale. Così il costo di fallimento di ogni passo resta a livello di campione breve.
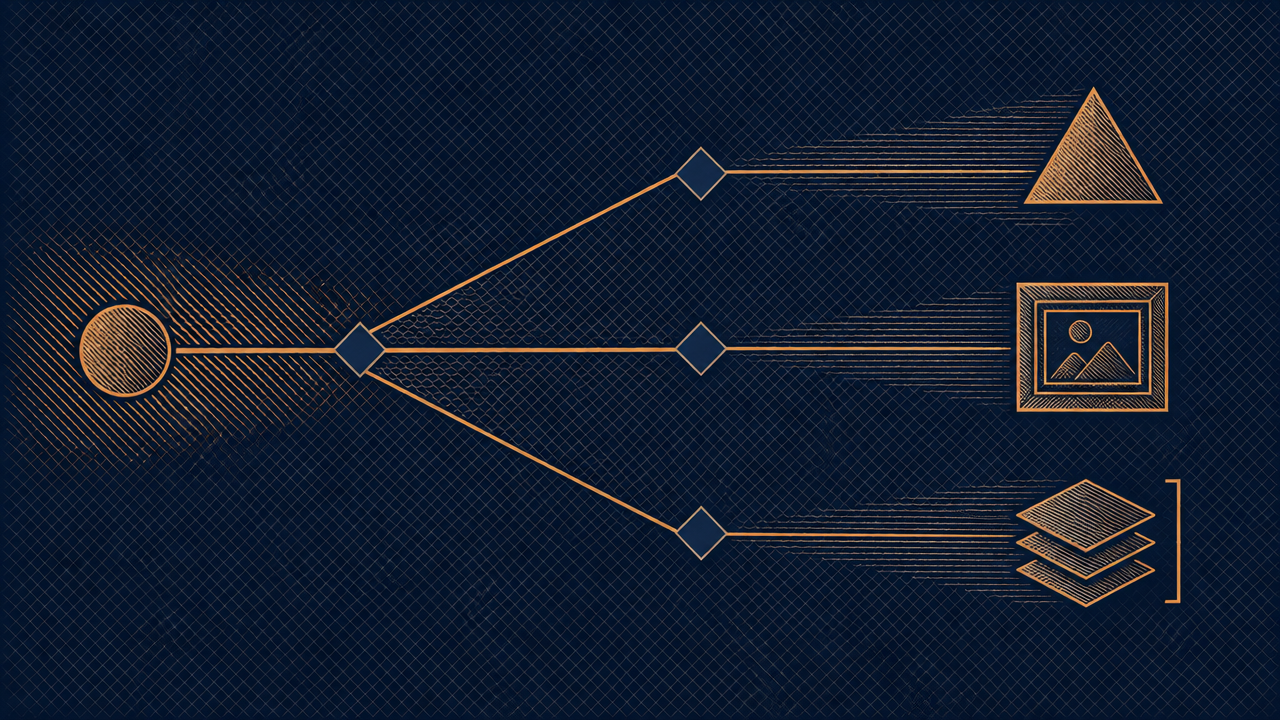
Scenario uno: generazione in serie di video brevi per materiali di marketing
È l'uso più diretto: generare in serie con text-to-video più versioni di materiali per il lancio, coprendo diversi punti di vendita, diverse emozioni e diverse aperture.
Progettazione del flusso
Scomponi «un video» in una struttura a tre livelli: script del punto di vendita (manuale) → template del prompt (semi-automatico) → chiamata in serie (programmatica). Il template del prompt fissa il linguaggio delle inquadrature, il ritmo e la descrizione dello stile, mentre la parte variabile è riservata solo al punto di vendita e alla scena. Solo così i prodotti della generazione in serie sono confrontabili e il team dei materiali può selezionare rapidamente le versioni utilizzabili.
Tre aspetti da curare nella scalabilità
Primo, procedere a piccoli lotti. Prima esegui un lotto di campioni brevi per vedere se lo stile complessivo regge, poi aumenta il volume. Lanciare in una volta sola molti filmati lunghi fa moltiplicare il costo di fallimento con la durata.
Secondo, conservare i metadati per ogni prodotto. Versione del prompt, modalità di chiamata, durata, data di generazione: tutto va registrato, altrimenti con centinaia di materiali accumulati la selezione manuale diventa un disastro.
Terzo, accettare la casualità e trasformarla in opzione. Eseguire più volte lo stesso prompt significa in sostanza «divergenza della macchina, convergenza umana», ed è proprio questo il valore del text-to-video in serie: non cercare di eliminarlo.
Scenario due: estendere in contenuto dinamico un visual principale esistente
Quando il brand ha già materiali immagine definiti, image-to-video è il passo con il miglior rapporto qualità-prezzo: trasforma KV statici, immagini di prodotto e poster in materiali dinamici pronti al lancio, con la base visiva bloccata dall'immagine di input, senza dover riallineare lo stile.
Punti chiave di implementazione
La qualità dell'immagine di input determina direttamente il limite massimo dell'output. Privilegia immagini con composizione completa, soggetto nitido e spazio vuoto ragionevole; per immagini troppo ritagliate o dense di informazioni, il modello fatica a trovare uno spazio di movimento ragionevole.
Il prompt deve descrivere il «movimento», non il «contenuto». Descrivere zoom e carrellate, variazioni di luce e ombra, lievi movimenti di elementi locali è più efficace che ripetere cosa c'è nell'immagine: l'immagine è già data dall'input.
Controllo della coerenza
Il rischio principale di questa linea è «muoversi male»: deformazione del soggetto, lacerazioni dell'immagine, direzione del movimento contraria al buon senso fisico. Si consiglia di creare una checklist di accettazione per tipo di materiale, fissando i problemi comuni come voci di controllo, invece di giudicare ogni volta a occhio.
Inoltre, la stessa immagine di input con descrizioni di movimento diverse produce un set di materiali della stessa origine. È molto utile per scenari di marketing che richiedono «lo stesso visual principale, più versioni di lancio», e il costo grava solo sulla durata.
Scenario tre: produzione di contenuti seriali con stile uniforme
La difficoltà dei contenuti seriali non è mai la qualità del singolo episodio, ma far sembrare il decimo e il primo parte dello stesso mondo. reference-to-video è pensato proprio per questa esigenza: ancorare stile o caratteristiche del personaggio con materiali di riferimento e poi generare nuove scene.
Organizzazione delle chiamate
Crea una «libreria di materiali di riferimento»: pochi materiali di alta qualità, altamente rappresentativi e che coprono gli angoli chiave sono più efficaci di molti materiali generici. Se ogni richiesta di generazione punta allo stesso set di riferimenti, la deriva dello stile si riduce sensibilmente.
Il prompt si occupa di «cosa deve succedere in questo episodio», i materiali di riferimento di «che aspetto ha». Le responsabilità dei due vanno distinte, altrimenti un prompt pieno di descrizioni di stile finisce per tirare in direzioni opposte rispetto ai riferimenti.
Consigli ingegneristici
Inserisci il numero di versione dei materiali di riferimento nei metadati del prodotto. I contenuti seriali spesso richiedono l'iterazione del set di riferimenti, e senza registrazione delle versioni non è possibile risalire a «con quale versione di stile è stato generato questo filmato».
Allo stesso tempo accetta una realtà: la coerenza è un problema probabilistico, non un interruttore. In produzione in serie, prevedi una percentuale di selezione manuale ed elimina o rigenera gli elementi con deriva evidente: è più realistico che puntare a un risultato perfetto al primo colpo.
Scenario quattro: video dimostrativi di funzionalità e spiegazioni dinamiche
I video di dimostrazione funzionale e di spiegazione concettuale hanno domanda elevata, ciclo di vita breve e aggiornamenti frequenti: è proprio il campo d'azione dei modelli generativi, ma anche lo scenario in cui il costo di revisione è più sottovalutato.
Organizzazione del prompt
Il nucleo dei video esplicativi è «l'informazione corretta», non «la bellezza». Il prompt va scomposto per inquadratura: prima scrivi chiaramente l'unico punto informativo che ogni inquadratura deve trasmettere, poi aggiungi movimento di camera e ritmo. Un'inquadratura, un'informazione, dà risultati utilizzabili più facilmente di un lungo paragrafo che infila tre concetti.
Presta particolare attenzione ai contenuti con interfacce, testi e dati: il video generato non è bravo a riprodurre con precisione UI e testi, quindi questi materiali sono più adatti a una rappresentazione dinamica astratta che a una riproduzione fedele a livello di interfaccia.
Fase di revisione manuale
È un passo irrinunciabile in questo scenario. L'attenzione della revisione non è l'estetica, ma i fatti: se l'espressione del concetto è sbagliata, se l'ordine del flusso è corretto, se sono stati generati elementi visivi fuorvianti. Si consiglia di fissare i punti di revisione in una checklist e farla scorrere a chi conosce il business, non solo al produttore.
Inoltre, i contenuti esplicativi si aggiornano spesso: considera la «rigenerazione» come azione ordinaria e non eccezionale, e gestisci prompt e materiali come asset riutilizzabili.
Scenario cinque: validazione rapida delle idee in fase di prototipo
Nella fase iniziale della domanda, la voce più costosa non è la produzione, ma aver completato qualcosa nella direzione sbagliata. L'uso in questo scenario è chiarissimo: validare rapidamente la direzione creativa con campioni di breve durata, anticipando la decisione «se farlo o no» nella fase a basso costo.
Metodo
Scomponi l'idea in alcune ipotesi verificabili in modo indipendente: lo stile è giusto? Il ritmo è giusto? L'emozione è giusta? Ogni ipotesi va verificata con un campione breve, non con un filmato completo che le contenga tutte. Il costo dei campioni brevi diminuisce linearmente con la durata: è proprio questo il punto in cui la fatturazione al secondo è più favorevole nella fase di prototipo.
Qui si possono usare tutte e tre le modalità di chiamata: senza materiali, text-to-video per divergere; con un visual esistente, image-to-video per vedere l'effetto dinamico; con asset di brand, reference-to-video per confermare la continuità dello stile.
Evitare rifacimenti in post-produzione
La chiave è consolidare le conclusioni dei campioni. Quale versione è stata scartata, perché, cosa è stato cambiato: tutto va registrato. Altrimenti, entrando in produzione ufficiale, la stessa discussione si ripresenta e la validazione è stata inutile.
Va anche chiarita la posizione del campione: è materiale decisionale, non un deliverable. Allinearsi in anticipo con il committente su questo punto risparmia molte discussioni del tipo «il campione si può usare direttamente?».
Costi e implementazione ingegneristica: punti chiave di integrazione con fatturazione al secondo
seedance-2.0-fast viene fatturato in base ai secondi di output, con un costo che cresce linearmente con la durata del video. Non è solo una nota di fatturazione, ma un vincolo che cambia direttamente la progettazione della soluzione.
Controllare la durata significa controllare i costi
In fase di progettazione inserisci la durata nel modello di budget: durata singola × numero di elementi × lotti = consumo totale stimabile. In fase di prototipo usa per default durate brevi, poi allunga nella produzione ufficiale in base alle esigenze dei canali di lancio. Non fare tentativi ed errori con filmati lunghi in fase di validazione: sarebbe spendere le risorse più costose nella fase più incerta.
La pipeline asincrona va considerata come un tutto unico
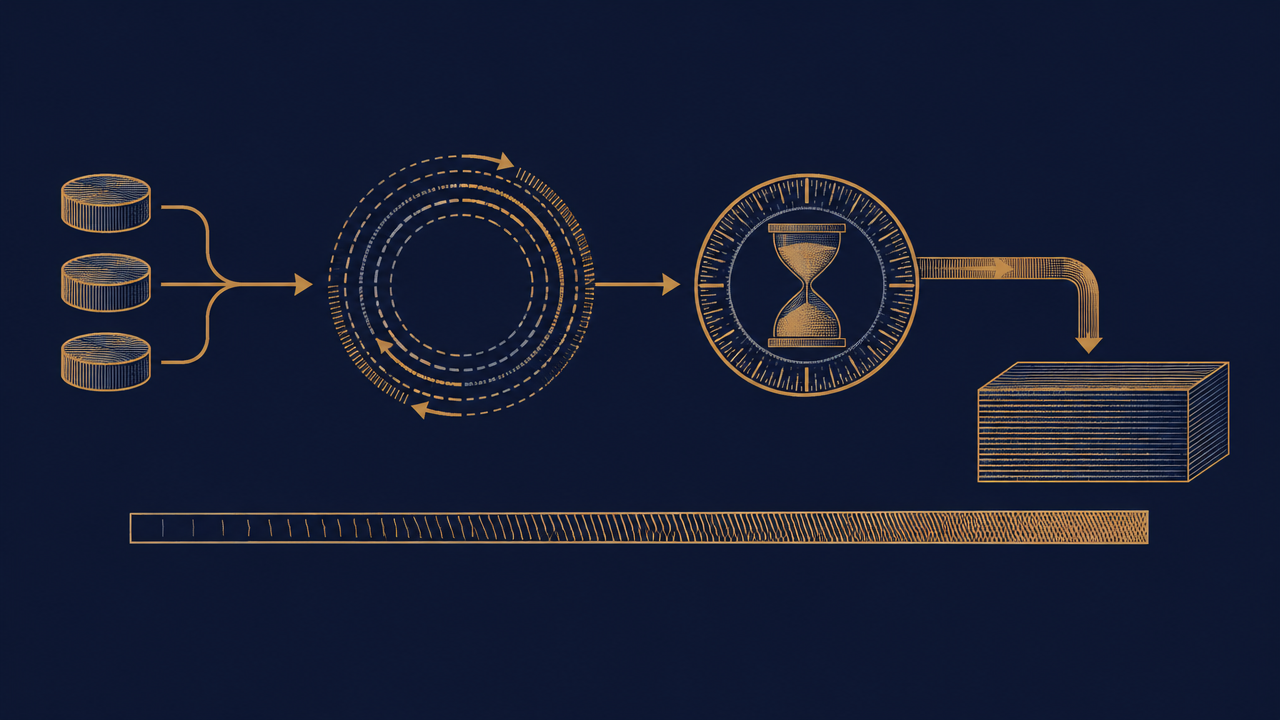
La generazione video è un'attività a lunga esecuzione: in fase di integrazione va progettata come catena asincrona, non come una singola richiesta sincrona. Una pipeline completa comprende almeno quattro segmenti:
- Invio dell'attività: registra i parametri della richiesta e l'identificativo di business, restituisci un ID attività tracciabile
- Avanzamento dello stato: polling o callback, scegline uno e gestisci l'idempotenza, evitando il consumo duplicato
- Retry in caso di errore: distingui «ritentabile» (timeout, errori temporanei) da «non ritentabile» (parametri non validi, contenuto rifiutato); il retry deve avere un limite massimo e un backoff
- Archiviazione del prodotto: salva il video su disco o trasferiscilo su object storage; se viene generato un link temporaneo, spostalo il prima possibile, non far dipendere il business da URL di breve durata
Incapsulare in un livello di servizio interno unificato
Avvolgi le capacità video in un livello di servizio interno: modello di attività unificato, formato di callback unificato, indirizzo del prodotto unificato. Il business di livello superiore dipende solo da questa interfaccia, e quando in futuro si sostituiranno o combineranno orizzontalmente altri modelli video, le modifiche resteranno confinate all'interno del livello di servizio. È il modo più semplice per ridurre il rischio di lock-in su un singolo modello.
Lo stesso vale per la risoluzione dei problemi: prima controlla che il flusso di stato dell'attività sia normale, poi i parametri e i materiali di input, e solo alla fine sospetta delle prestazioni del modello. La stragrande maggioranza dei «fallimenti di generazione» è in realtà bloccata nei primi due segmenti.
Solo facendo una solida validazione con i campioni e poi avviando la produzione in serie il valore di questo modello emergerà davvero; per consultare le capacità e il criterio di fatturazione, fai riferimento alle informazioni in tempo reale della pagina del modello sul sito.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato