
Tutorial
Guia prático do seedance-2.0-fast: 5 cenários de aplicação de alto valor e pontos de integração
Do texto para vídeo e da imagem para vídeo até a referência para vídeo: como os desenvolvedores podem integrar este modelo de vídeo em negócios reais
Por que usar o seedance-2.0-fast para validar cenários de vídeo
A etapa mais difícil de colocar capacidades de vídeo em produção geralmente não é "conseguir gerar", mas "vale a pena começar pelo vídeo". O seedance-2.0-fast é fornecido pela ByteDance, tem saída do tipo vídeo e oferece suporte a três formas de entrada: text-to-video, image-to-video e reference-to-video. Isso significa que as equipes podem usar o mesmo modelo para cobrir três pontos de partida de material completamente diferentes: criação puramente textual, uma identidade visual já existente e um estilo ou personagem já definido.
Para equipes de engenharia, o valor está no "custo de validação controlável". O modelo cobra por segundos de saída, e o custo cresce linearmente com a duração — amostras curtas são baratas, vídeos longos são caros —, o que torna "gerar uma amostra pequena primeiro e depois ampliar a produção" um ritmo de engenharia natural, e não uma restrição rígida. Você pode usar alguns segundos de amostra para confirmar a direção estilística e a estabilidade antes de decidir entrar em produção em lote.
Outro ponto frequentemente ignorado é o limite de capacidade. Ele gera vídeo e não é responsável por edição, trilha sonora, composição de legendas ou outras etapas de pós-produção; as três formas de entrada também não podem ser misturadas em uma solicitação composta de "texto + imagem de referência + âncora de estilo". Definir esses limites no plano antes da integração custa muito menos do que corrigir erros depois.
É adequado como o primeiro modelo experimental para levar vídeo ao negócio: amplitude de capacidade suficiente, critério de cobrança claro (por segundos de saída) e forma de integração unificada. Depois que o negócio estiver funcionando e as necessidades se diversificarem, considere combinar outros modelos horizontalmente.
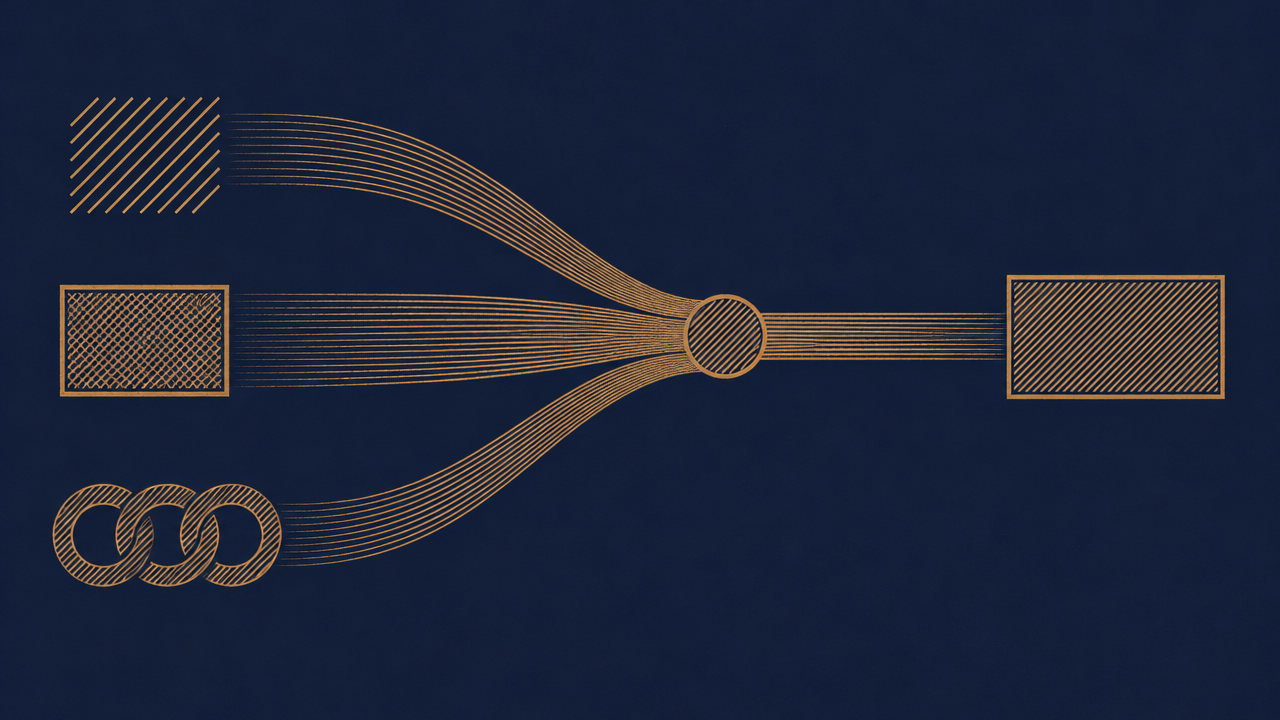
Como escolher entre as três formas de chamada: texto, imagem e referência
Escolher a forma de chamada exige responder apenas a duas perguntas: você tem material em mãos? Quão alta é a exigência de consistência?
Sem material, começando do zero: text-to-video
Geração guiada por descrição puramente textual. Adequada para divergência criativa, exploração de conceitos e produção em lote de múltiplas direções. O custo é a menor controlabilidade — a mesma solicitação chamada várias vezes produz resultados diferentes; não espere reprodução quadro a quadro.
Já existe uma identidade visual e é preciso manter a continuidade da imagem: image-to-video
Usa uma imagem existente como ponto de partida visual e a estende em conteúdo dinâmico. Adequada para materiais que já têm visual definido, como KV de marca, imagens de produto e pôsteres. A restrição principal é: a imagem de entrada basicamente determina a composição e o tom de cor, e o papel da solicitação é descrever "como se move", não "como se parece".
É preciso manter estilo ou personagem consistentes: reference-to-video
Usa materiais de referência para ancorar estilo ou características de personagem e então gerar novo conteúdo. Adequada para produção seriada — o mesmo personagem em cenários diferentes, a mesma linguagem visual cobrindo várias peças. Quanto maior a exigência de consistência, mais críticas são a qualidade e a representatividade dos materiais de referência.
Ordem de decisão
Pergunte primeiro "há uma imagem utilizável?": se não houver, use text-to-video; se houver e for necessária continuidade visual, use image-to-video; se houver e for necessário unificar o estilo entre peças de conteúdo, use reference-to-video. Depois pergunte "esta peça é exploração ou produção?": a fase de exploração tolera diferenças, a fase de produção prioriza consistência, e as formas de chamada correspondentes costumam ser diferentes.
Um princípio prático de segurança: em caso de dúvida, primeiro use text-to-video para definir a direção e, depois de confirmada, mude para image-to-video ou reference-to-video para fazer a versão oficial. Assim, o custo de falha de cada etapa fica no nível de uma amostra curta.
Cenário 1: geração em lote de vídeos curtos para materiais de marketing
Este é o uso mais direto: usar text-to-video para produzir em lote várias versões de materiais para veiculação, cobrindo diferentes argumentos de venda, emoções e aberturas.
Desenho do fluxo
Divida "um vídeo" em três camadas: roteiro de argumento de venda (manual) → modelo de solicitação (semiatomático) → chamada em lote (programático). O modelo de solicitação fixa a linguagem de câmera, o ritmo e a descrição de estilo, deixando as variáveis apenas para o argumento de venda e o cenário. Assim, os produtos gerados em lote se tornam comparáveis e a equipe de materiais consegue selecionar rapidamente as versões utilizáveis.
Três pontos de atenção para escalar
Primeiro, avance em lotes pequenos. Execute primeiro um lote de amostras curtas para ver se o estilo geral se sustenta e depois amplie o lote. Lançar de uma vez muitos vídeos longos multiplica o custo de falha conforme a duração.
Segundo, guarde metadados para cada produto. Versão da solicitação, forma de chamada, duração e horário de geração devem ser registrados; caso contrário, centenas de materiais acumulados transformam a seleção manual em um desastre.
Terceiro, aceite a aleatoriedade e transforme-a em opção. Executar a mesma solicitação várias vezes é, essencialmente, fazer "divergência da máquina, convergência humana"; esse é justamente o valor do text-to-video em lote, então não tente eliminá-lo.
Cenário 2: estender conteúdo dinâmico a partir de uma identidade visual existente
Quando a marca já tem materiais de imagem definidos, o image-to-video é a etapa com melhor custo-benefício: transformar KV estáticos, imagens de produto e pôsteres em materiais dinâmicos veiculáveis, com a base visual travada pela imagem de entrada, sem precisar realinhar o estilo.
Pontos de implementação
A qualidade da imagem de entrada determina diretamente o teto da saída. Priorize imagens com composição completa, sujeito nítido e espaço negativo razoável; em imagens excessivamente recortadas ou densas em informação, o modelo tem dificuldade para encontrar espaço de movimento razoável.
A solicitação deve escrever "movimento", não "conteúdo". Descrever zoom, mudanças de luz e sombra e movimentos leves de elementos locais é mais eficaz do que repetir o que há na imagem — a imagem já foi dada pela entrada.
Controle de consistência
O risco central dessa abordagem é "mover errado": deformação do sujeito, rasgos na imagem, direção de movimento contrária ao senso físico. Recomenda-se criar uma lista de aceitação por tipo de material, transformando problemas comuns em itens de verificação, em vez de depender de julgamento visual improvisado a cada vez.
Além disso, a mesma imagem de entrada com descrições de movimento diferentes gera um conjunto de materiais da mesma origem. Isso é muito amigável para cenários de marketing que precisam de "a mesma identidade visual, várias versões de veiculação", e o custo recai apenas sobre a duração.
Cenário 3: produção seriada de conteúdo com estilo unificado
A dificuldade do conteúdo seriado nunca é a qualidade de uma peça isolada, mas fazer a 10ª peça parecer pertencer ao mesmo mundo que a 1ª. O reference-to-video existe para essa necessidade: ancorar estilo ou características de personagem com materiais de referência e então gerar novos cenários.
Organização das chamadas
Crie um "banco de materiais de referência" — poucos materiais de alta qualidade, representativos e que cubram ângulos-chave são mais eficazes do que muitos materiais genéricos. Se cada solicitação de geração apontar para o mesmo conjunto de referências, a deriva de estilo cai visivelmente.
A solicitação é responsável por "o que acontece nesta peça", e os materiais de referência por "como ela se parece". As responsabilidades precisam ser separadas; caso contrário, a solicitação cheia de descrições de estilo acaba disputando espaço com os materiais de referência.
Recomendações de engenharia
Inclua o número de versão dos materiais de referência nos metadados do produto. Conteúdos seriados costumam iterar o conjunto de referências; sem registro de versão, não é possível rastrear "com qual versão de estilo esta peça foi gerada".
Ao mesmo tempo, aceite uma realidade: consistência é uma questão probabilística, não um interruptor. Na produção em lote, reserve uma proporção para seleção manual, descartando ou regerando itens com deriva evidente; isso é mais realista do que buscar acerto de primeira.
Cenário 4: demonstração de funcionalidades de produto e vídeos explicativos dinâmicos
Vídeos de demonstração de funcionalidades e explicação de conceitos têm grande demanda, ciclo de vida curto e atualizações frequentes — é exatamente aí que os modelos generativos se destacam, mas também é o cenário em que o custo de revisão é mais subestimado.
Organização da solicitação
O núcleo de um vídeo explicativo é "informação correta", não "bonito". A solicitação deve ser decomposta por tomada: primeiro escreva o único ponto de informação que cada tomada deve transmitir, depois acrescente movimento de câmera e ritmo. Uma informação por tomada gera resultados utilizáveis com mais facilidade do que uma longa descrição com três conceitos.
Conteúdos que envolvem interface, texto e dados exigem cuidado especial: o vídeo gerado não é bom em reproduzir com precisão UI e texto; esses materiais são mais adequados para esquemas dinâmicos abstratos do que para buscar reprodução fiel da interface.
Etapa de revisão humana
Esta é uma etapa indispensável neste cenário. O foco da revisão não é estética, mas fatos: a formulação do conceito está errada, a ordem do fluxo está correta, foram gerados elementos visuais enganosos. Recomenda-se transformar os pontos de revisão em uma lista fixa e fazê-la passar por quem entende do negócio, em vez de apenas pela parte produtora.
Além disso, como conteúdos explicativos são atualizados com frequência, trate a "regeração" como ação rotineira e não como exceção; solicitações e materiais devem ser geridos como ativos reutilizáveis.
Cenário 5: validação rápida de ideias na fase de protótipo
No início da demanda, o mais caro não é a produção, mas terminar algo cuja direção estava errada. O uso neste cenário é muito claro: validar rapidamente a direção criativa com amostras curtas e antecipar a decisão de "fazer ou não" para uma fase de baixo custo.
Método
Decomponha a ideia em algumas hipóteses verificáveis de forma independente: o estilo está certo, o ritmo está certo, a emoção está certa. Valide cada hipótese com uma amostra curta, em vez de fazer um vídeo completo carregando todas as hipóteses. O custo de amostras curtas cai linearmente com a duração, e é justamente aí que a cobrança por segundo é mais amigável à fase de protótipo.
As três formas de chamada podem ser usadas aqui: sem material, use text-to-video para divergir; com visual existente, use image-to-video para ver o efeito dinâmico; com ativos de marca, use reference-to-video para confirmar a continuidade do estilo.
Evitar retrabalho posterior
O essencial é registrar as conclusões das amostras. Qual versão foi rejeitada, por que foi rejeitada e o que mudou precisam ser documentados. Caso contrário, ao entrar em produção oficial, a mesma discussão acontecerá de novo e a validação terá sido em vão.
Também é preciso deixar clara a posição da amostra: ela é material de decisão, não entregável. Alinhar isso antecipadamente com o solicitante evita muita discussão sobre "se a amostra pode ser usada diretamente".
Custo e implementação em engenharia: pontos de integração sob cobrança por segundo
O seedance-2.0-fast cobra por segundos de saída, e o custo cresce linearmente com a duração do vídeo. Isso não é apenas uma nota de cobrança, mas uma condição restritiva que altera diretamente o desenho da solução.
Controlar a duração é controlar o custo
Na fase de desenho da solução, inclua a duração no modelo de orçamento: duração por peça × quantidade de peças × lote = consumo total estimável. Na fase de protótipo, use durações curtas por padrão e, na produção oficial, alongue conforme a necessidade do ponto de veiculação. Não use vídeos longos para tentativa e erro na fase de validação; isso é gastar o recurso mais caro na etapa mais incerta.
O pipeline assíncrono deve ser tratado como um todo
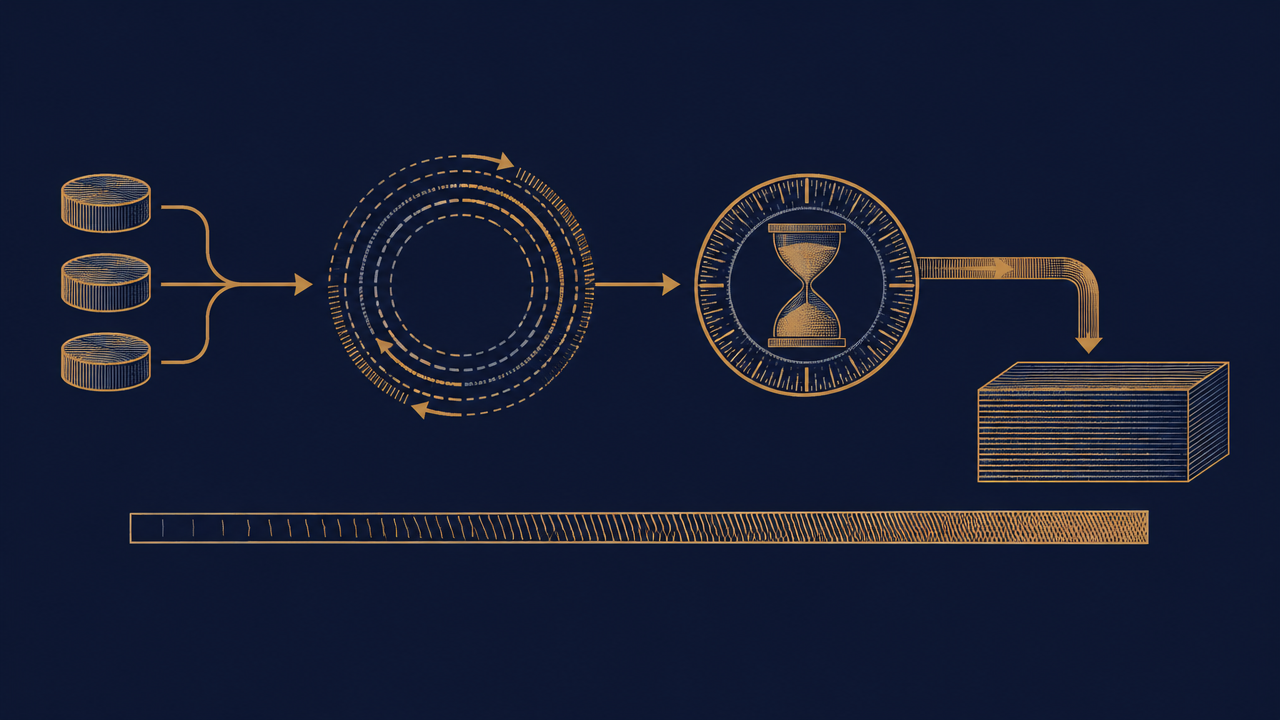
A geração de vídeo é uma tarefa longa; na integração, deve ser desenhada como um fluxo assíncrono, e não como uma requisição síncrona. Um pipeline completo deve conter pelo menos quatro etapas:
- Envio da tarefa: registrar parâmetros da requisição e identificador de negócio, retornando um ID de tarefa rastreável
- Avanço de estado: polling ou callback, escolha um e implemente idempotência para evitar consumo duplicado
- Nova tentativa em caso de falha: distinguir "retentável" (timeout, erro temporário) de "não retentável" (parâmetro inválido, conteúdo rejeitado); a nova tentativa deve ter limite e backoff
- Armazenamento do produto: gravar o vídeo em disco ou transferi-lo para armazenamento de objetos; se o gerado for um link temporário, mova-o o quanto antes, para que o negócio não dependa de URL de curto prazo
Encapsular em uma camada de serviço interna unificada
Envolva a capacidade de vídeo em uma camada de serviço interna: modelo de tarefa unificado, formato de callback unificado e endereço de produto unificado. As camadas de negócio superiores dependem apenas dessa interface; ao substituir ou combinar horizontalmente outros modelos de vídeo no futuro, as mudanças ficam restritas à camada de serviço. Essa é a forma mais simples de reduzir o risco de dependência de um único modelo.
Na solução de problemas, o mesmo vale: primeiro verifique se o fluxo de estados da tarefa está normal, depois os parâmetros e os materiais de entrada, e só então suspeite do comportamento do modelo. A grande maioria das "falhas de geração" está, na verdade, presa nas duas primeiras etapas.
Faça uma validação sólida com amostras e depois coloque a produção em lote para rodar; só assim o valor deste modelo se revelará de fato. Quando precisar consultar capacidades e critérios de cobrança, use as informações em tempo real da página do modelo no site.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado