
Guida all'uso
Prompt PixVerse V6: 4 ricette testo-video con clip reali
- Modello
- pixverse-v6
Ecco quattro prompt per pixverse-v6/text-to-video che puoi copiare, incollare ed eseguire direttamente. Ogni prompt è accompagnato da un body di richiesta completo e dalla clip reale che ha generato sull'API live di hiapi—nessun video di archivio, nessun contenuto simulato. Le clip qui sotto sono riproducibili inline.
Il testo-video e l'immagine-video sono due arti diverse. Con immagine-video dai al modello un primo frame e lui lo anima; con il testo-video non c'è alcun frame di input, quindi il prompt deve stabilire soggetto, scena, illuminazione e movimento tutto insieme. Queste ricette sono calibrate proprio per questo.
I tre campi che fanno il lavoro pesante
Prima delle ricette, costruiamo un modello mentale. pixverse-v6/text-to-video accetta un prompt e un piccolo insieme fisso di campi di input (lo schema è chiuso—i campi sconosciuti vengono rifiutati). Tre campi influenzano l'output più di tutti gli altri:
- Il prompt stesso. Il modello non ha volutamente campi
camera_movement,motion_modeoquality. Ogni movimento di camera e ogni minima azione deve essere scritto nel testo del prompt. Questo è il punto più importante da capire su questo modello. style—un enum con cinque preset:anime,3d_animation,clay,comic,cyberpunk. Impostarlo ridisegna l'intero rendering, non solo la palette.generate_audio—un booleano (predefinitofalse). Quando è attivo, il modello renderizza l'ambiente sonoro descritto nel prompt nella stessa chiamata, mantenendolo sincronizzato.
Gli altri campi sono formato e manopole di controllo: aspect_ratio (otto opzioni, incluse 16:9 e 9:16), duration (un intero, 1–15 secondi), resolution (360p → 1080p), e i facoltativi negative_prompt e seed. L'elenco completo dei campi e la struttura richiesta/risposta sono nella documentazione Create Task e Get Task Detail; la pagina specifica del modello è la documentazione API PixVerse V6 Text to Video.
Ricetta 1—Movimento di camera cinematografico + audio sincronizzato
Un'inquadratura di ambientazione realistica in cui è la telecamera stessa a muoversi, con l'ambiente sonoro generato nella stessa chiamata.
Prompt (copia-incollabile):
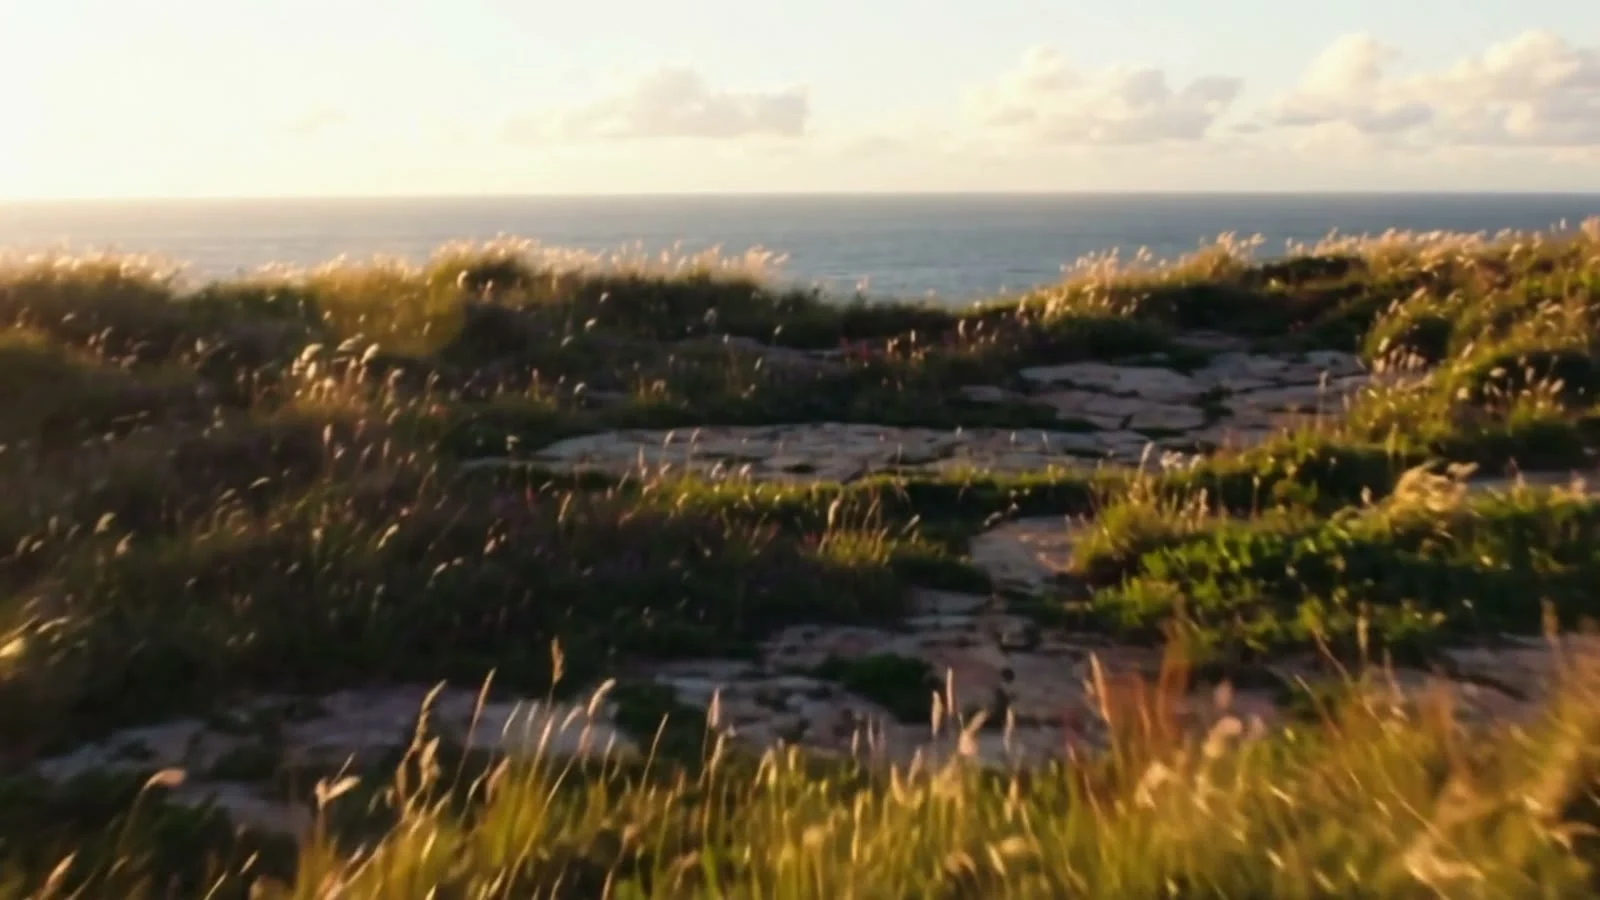
Cinematic slow dolly push-in across a windswept coastal cliff at golden hour. Tall grass ripples in the sea breeze, waves crash against dark rocks far below, warm low sunlight rakes across the scene. The camera glides forward steadily toward the cliff edge, revealing a wide ocean horizon. Shallow depth of field, gentle lens flare, realistic film grain, soft natural ambience of wind and distant surf.
Body della richiesta:
{
  "model": "pixverse-v6/text-to-video",
  "input": {
    "prompt": "<prompt above>",
    "aspect_ratio": "16:9",
    "duration": 5,
    "resolution": "720p",
    "generate_audio": true
  }
}
La vera clip di 5 secondi che ha generato (16:9, 720p, audio attivo):
Perché funziona:
- Su pixverse-v6 non esiste il campo
camera_movement, quindi il movimento sta nel prompt: "slow dolly push-in" e "the camera glides forward steadily" sono ciò che produce l'avanzamento in avanti. generate_audio: trueè l'unica ragione per cui questa clip ha il suono del vento e delle onde—è un vero interruttore booleano, con valore predefinitofalse. Descrivi il suono che vuoi ("soft natural ambience of wind and distant surf") e verrà renderizzato in sincrono.- Verbi sensoriali e concreti ("grass ripples", "waves crash", "sunlight rakes") danno al modello un movimento da animare, invece di una cartolina statica.
Ricetta 2—preset style: anime
Trasforma un normale beat di personaggio in anime disegnato a mano con un solo campo.
Prompt (copia-incollabile):
A teenage courier in a weathered red jacket stands on a rain-slicked rooftop at dusk, distant city lights blooming behind her. A gentle breeze lifts her hair and the hem of her jacket; neon signs flicker and reflect in shallow puddles. The camera slowly orbits from her side around to a three-quarter front view. Hand-drawn anime aesthetic, soft cel shading, warm-to-cool color grade.
Body della richiesta:
{
  "model": "pixverse-v6/text-to-video",
  "input": {
    "prompt": "<prompt above>",
    "aspect_ratio": "16:9",
    "duration": 5,
    "resolution": "720p",
    "style": "anime",
    "negative_prompt": "blurry, distorted hands, extra limbs, watermark, text artifacts"
  }
}
La vera clip di 5 secondi che ha generato (16:9, 720p):
Perché funziona:
style: "anime"ridisegna l'intero rendering—linee, cel shading, color grading—con un effetto che va ben oltre l'aggiunta della parola "anime" nel prompt.- La direzione della camera resta espressa in prosa: "the camera slowly orbits from her side around to a three-quarter front view" produce una rivelazione controllata, non un'inquadratura bloccata su treppiede.
- Un breve
negative_prompt("distorted hands, extra limbs") è un'assicurazione a basso costo sulle inquadrature con personaggi, perché mani e arti sono punti di fallimento comuni.
Ricetta 3—preset style: 3d_animation
Un beat di personaggio 3D caldo, in stile quasi Pixar, adatto a mascotte di prodotto e aperture di explainer.
Prompt (copia-incollabile):
A chubby palm-sized desk robot with big round eyes wakes up on a wooden desk beside a steaming coffee mug. It stretches its little arms, blinks twice, then waves cheerfully at the camera. Morning light streams through a nearby window. Smooth stylized 3D animation, soft global illumination, playful squash-and-stretch motion, shallow depth of field.
Body della richiesta:
{
  "model": "pixverse-v6/text-to-video",
  "input": {
    "prompt": "<prompt above>",
    "aspect_ratio": "16:9",
    "duration": 5,
    "resolution": "720p",
    "style": "3d_animation"
  }
}
La vera clip di 5 secondi che ha generato (16:9, 720p):
Perché funziona:
style: "3d_animation"porta illuminazione globale morbida e superfici levigate, che altrimenti dovresti inseguire per tutto il prompt.- Beat in sequenza rendono leggibili questi 5 secondi: "stretches its little arms, blinks twice, then waves"—ordina le azioni e il modello darà loro un ritmo lungo tutta la clip.
- I suggerimenti di animazione che il modello comprende ("squash-and-stretch motion") vengono interpretati come animazione intenzionale del personaggio, non come un rendering alla deriva.
Ricetta 4—verticale, ritmo ad alta energia (style: cyberpunk, 9:16)
Una clip verticale dinamica che ferma lo scroll, per Reels / Shorts / TikTok.
Prompt (copia-incollabile):
Fast first-person sprint through a narrow neon alley in a rain-soaked future megacity at night. Holographic advertisements smear past, puddles throw back magenta and cyan light, steam vents hiss on both sides. Quick energetic forward motion with a slight handheld camera shake, dynamic reflections, high contrast. Dense, kinetic, cinematic.
Body della richiesta:
{
  "model": "pixverse-v6/text-to-video",
  "input": {
    "prompt": "<prompt above>",
    "aspect_ratio": "9:16",
    "duration": 5,
    "resolution": "720p",
    "style": "cyberpunk",
    "negative_prompt": "static, frozen, slow, dull colors, low detail, watermark, text"
  }
}
La vera clip di 5 secondi che ha generato (9:16, 720p):
Perché funziona:
aspect_ratio: "9:16"compone in verticale fin dall'inizio—ritagliare in verticale in post-produzione perde metà della risoluzione, quindi richiedi direttamente il formato che ti serve.- Il ritmo è una scelta del prompt: "fast first-person sprint", "quick energetic forward motion" e "slight handheld camera shake" spingono il modello verso un movimento dinamico.
- Qui il
negative_promptvale il suo costo—"static, frozen, slow, dull colors" allontana attivamente il modello dagli output spenti che i prompt piatti tendono a produrre.
Punti chiave per la messa a punto
- Il movimento è prosa, non un parametro. Se la clip risulta statica, aggiungi istruzioni esplicite di camera ("slow dolly in", "orbit left", "crane up") e movimento fisico del soggetto. I prompt vaghi ottengono solo inquadrature fisse.
- Scegli
stylecon consapevolezza. La stessa scena appare completamente diversa comeanime,3d_animationocyberpunk. Per uno stile realistico, non impostarestyle. - L'audio è un booleano.
generate_audio: trueaggiunge il suono sincronizzato; il valore predefinito èfalse, esound/audionon sono nomi di campo (verrebbero rifiutati). I prezzi hanno una fascia separata per l'audio attivo, quindi attivalo solo quando serve. - Prima la forma, poi la scala. Per il verticale imposta
aspect_ratio: 9:16invece di ritagliare in post un rendering 16:9.durationè un intero—5funziona,"5"viene rifiutato. negative_prompteseed. Usanegative_promptper allontanare i modi di fallimento comuni ("static, blurry, extra limbs, watermark"); una volta trovato il look che vuoi continuare a iterare, imposta unseed.
FAQ
Come si controlla la camera nel testo-video di pixverse-v6?
Esclusivamente tramite il prompt. Non ci sono parametri di camera—scrivi il movimento a parole ("slow dolly push-in", "the camera orbits to a three-quarter view"), come mostrato nelle ricette 1 e 2 sopra.
Il testo-video di pixverse-v6 può generare audio?
Sì. Imposta generate_audio: true (il valore predefinito è false) e descrivi l'ambiente sonoro nel prompt. La clip costiera della ricetta 1 ha renderizzato vento e onde nella stessa richiesta.
Quali durate e risoluzioni sono supportate?duration è un intero da 1 a 15 secondi, resolution può essere 360p, 540p, 720p, 1080p. La fatturazione è al secondo, con fasce diverse per audio attivo/disattivo—per le tariffe al secondo attuali per ogni risoluzione consulta la pagina dei prezzi (dati validi a ottobre 2026).
In cosa differisce dall'immagine-video?
Il testo-video non ha frame di input, quindi il prompt porta l'intera scena. Se hai già un primo frame da animare, usa invece pixverse-v6/image-to-video.
Questi prompt funzionano su altri modelli video?
La struttura è trasferibile, ma i preset di stile e l'interruttore audio sono specifici di pixverse-v6. Per altri modelli consulta le nostre altre raccolte di ricette, come i prompt testo-video di Kling e i prompt di Grok Imagine 1.5.
Esegui tu stesso queste ricette
Ogni clip sopra proviene da una chiamata POST /v1/tasks più un polling—copia un prompt, inseriscilo nel body della richiesta e otterrai output dello stesso tipo. Ottieni lo schema live e la tua chiave API dalla pagina del modello PixVerse V6 Text to Video, apri la documentazione Create Task per il formato della richiesta e controlla i prezzi prima di eseguire in batch.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori