
OpenAI
GPT Image 2
gpt-image-2/image-to-image
Modello di generazione e modifica di immagini di OpenAI, incentrato sul fotorealismo, sul rendering testuale ad alta precisione e sull'output nativo in 4K, adatto a materiali commerciali e immagini di prodotto che contengono testo
Prova gpt-image-2/image-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image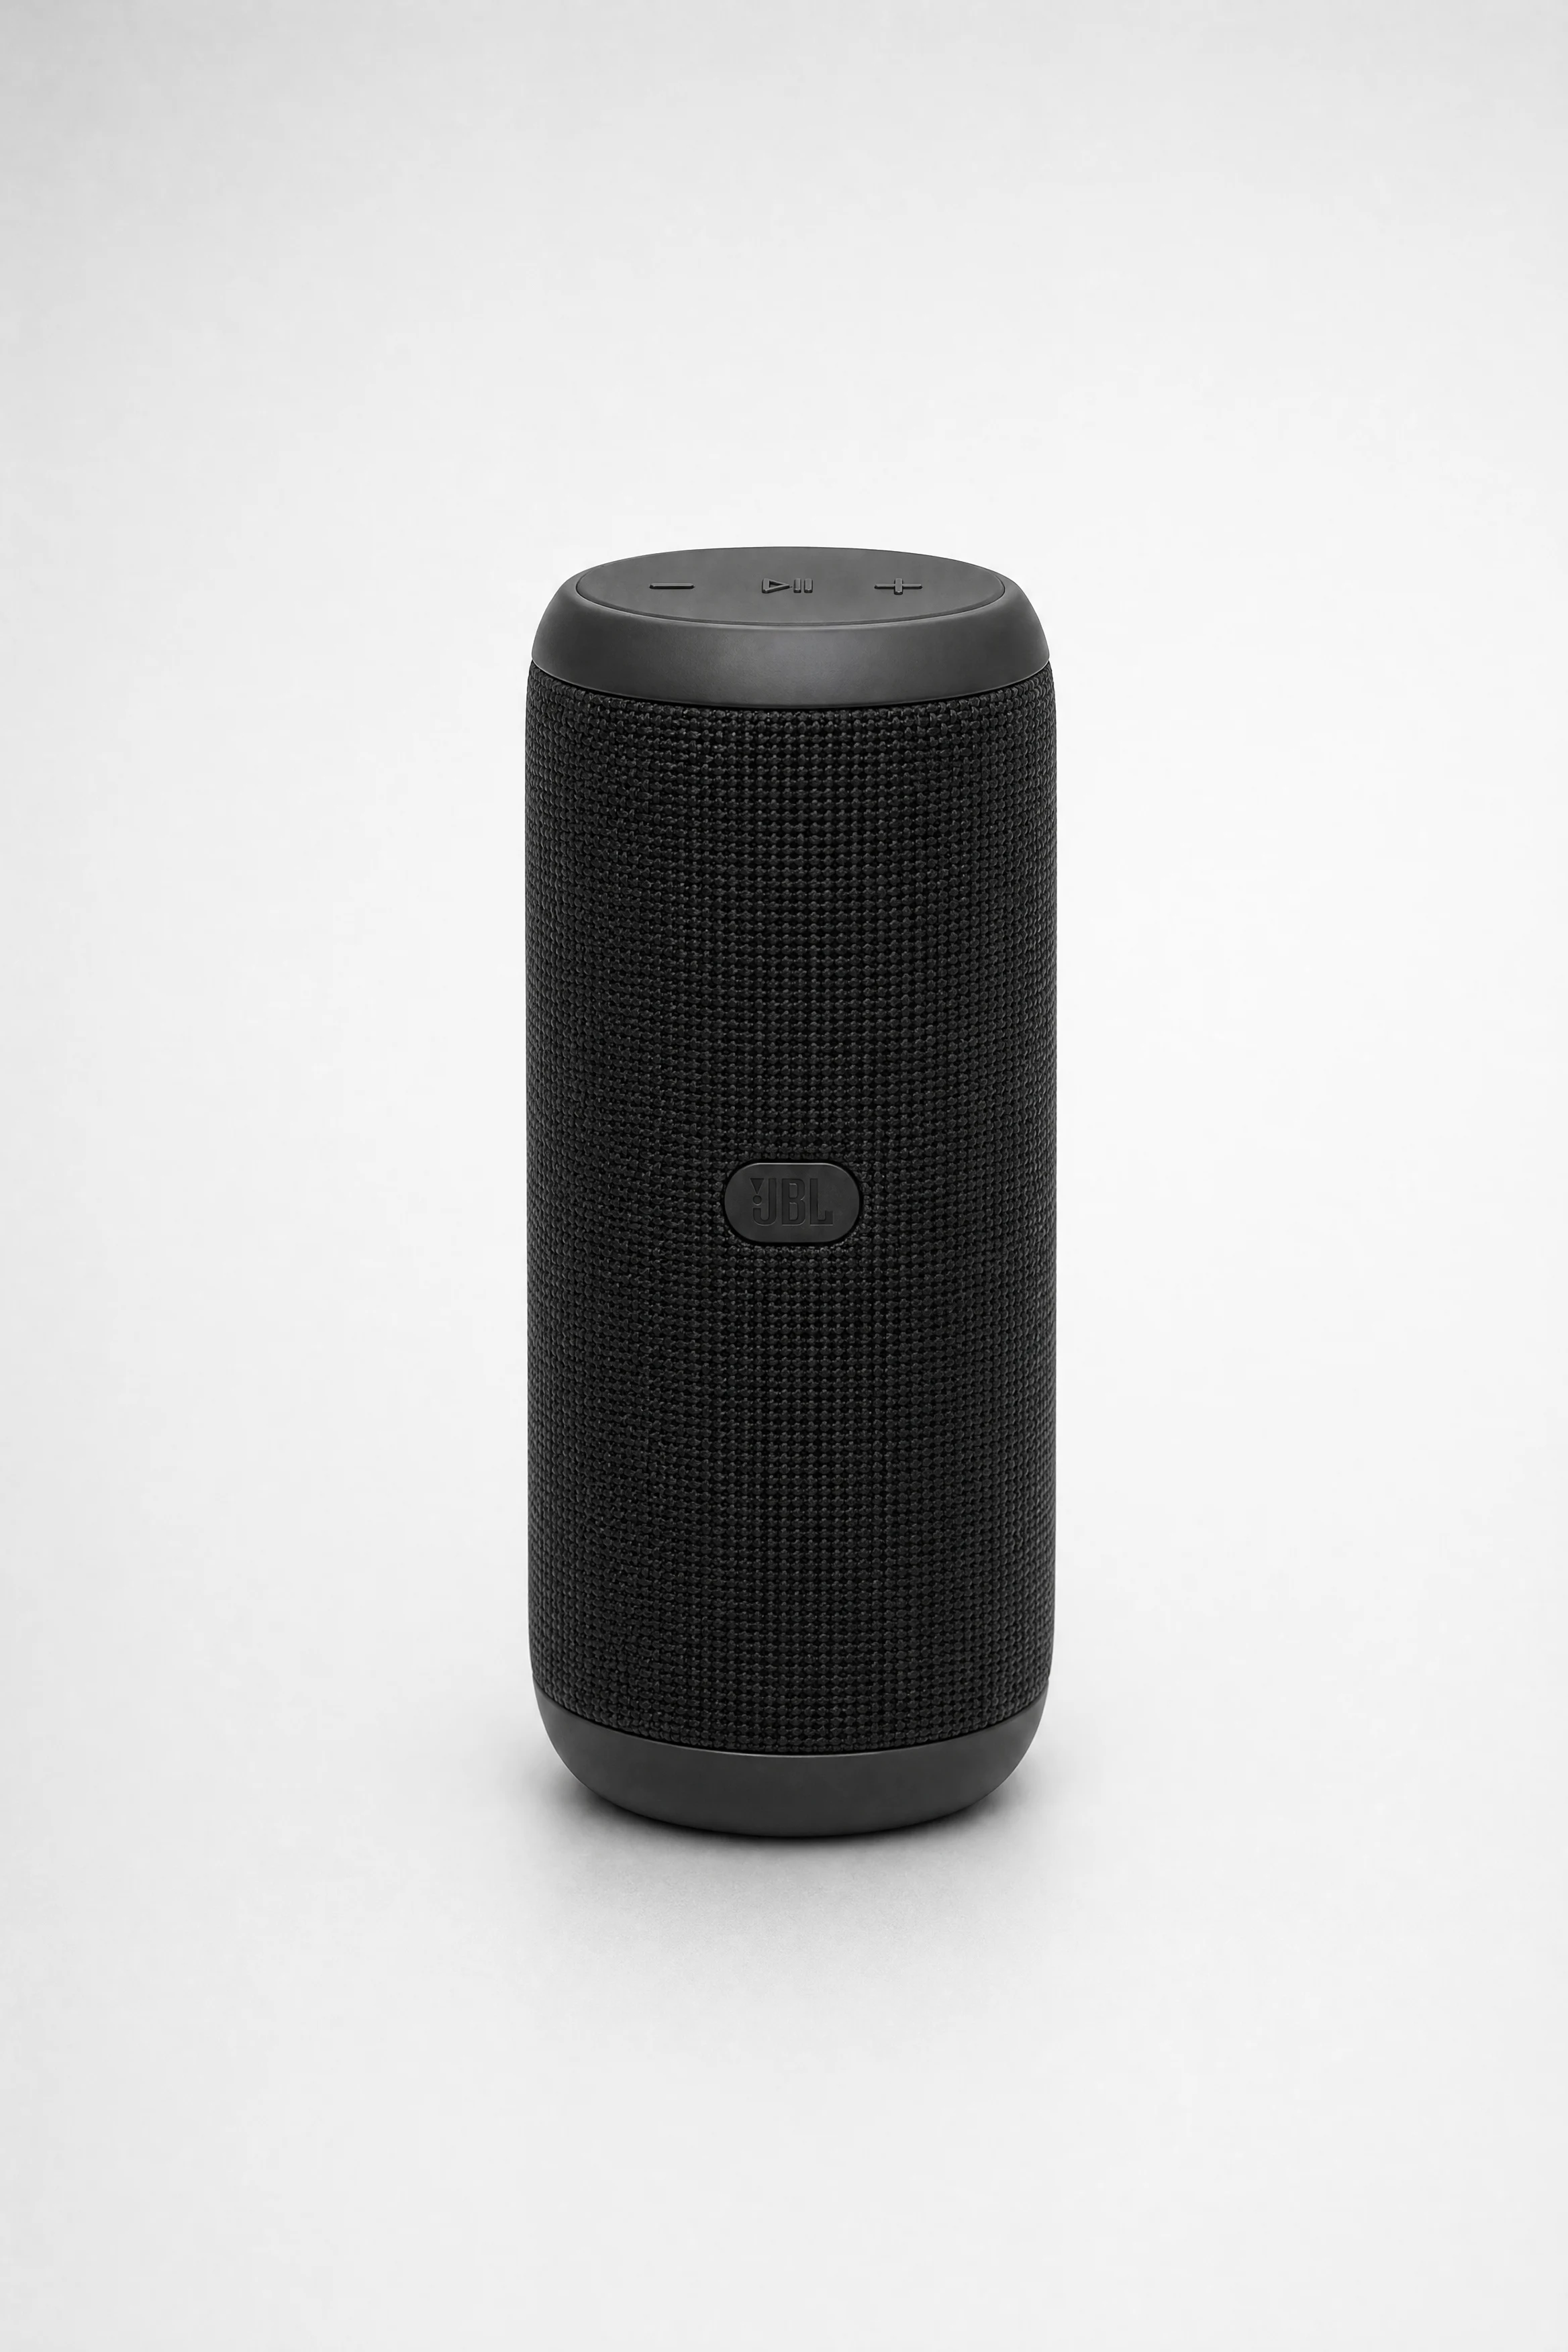
Qualità della fotografia di prodotto e-commerce: generazione commerciale da immagine a immagine
Stile Immagine del prodotto · ecommerce · Fotorealistico
Input di riferimento
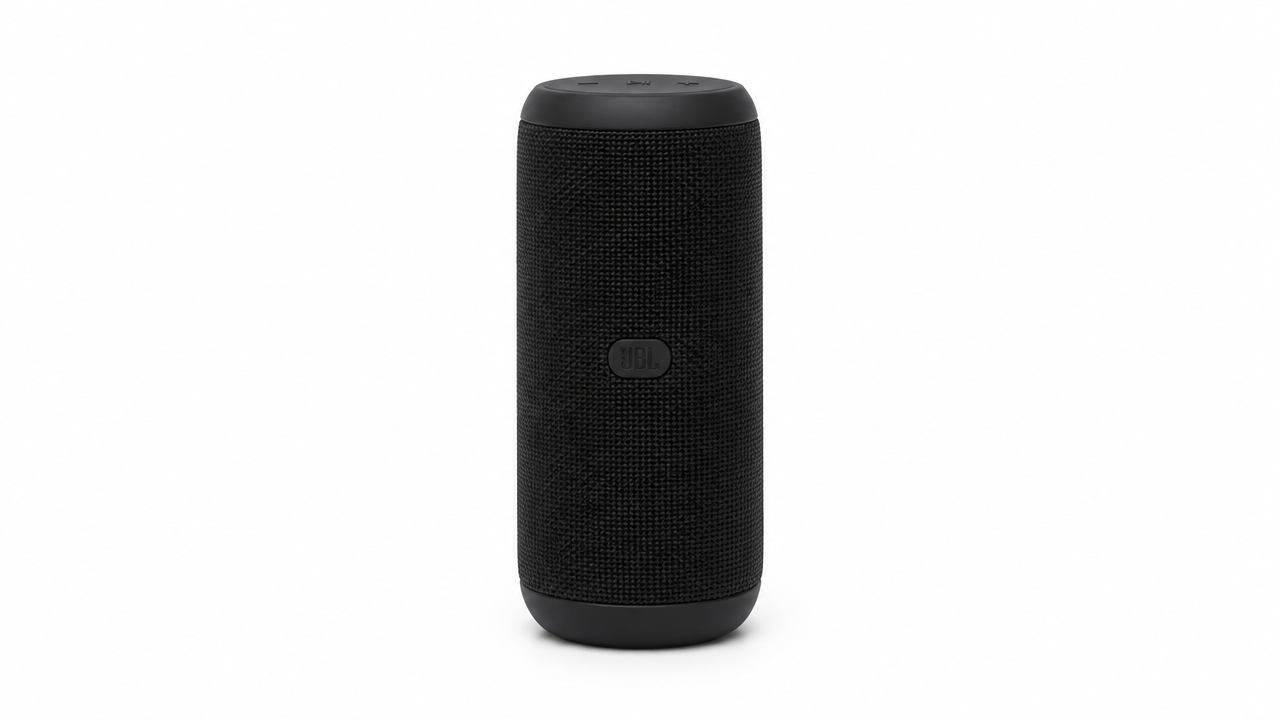
Immagine di riferimento
Prompt
Ricomponi la foto di prodotto di riferimento per creare un'immagine principale di alto livello per l'e-commerce. Mantieni invariati forma, colore, posizione del logo e proporzioni del prodotto; non aggiungere né rimuovere alcuna caratteristica del prodotto. Sostituisci lo sfondo originale con uno sfondo continuo in gradiente grigio chiaro da studio. Utilizza un'illuminazione a tre punti con softbox: un grande softbox principale a 45 gradi in avanti a sinistra, una luce di riempimento debole a destra e una luce di contorno stretta sul bordo superiore, in modo da separare il prodotto dallo sfondo. Preserva la risposta realistica dei materiali: le superfici lucide mostrano alte luci con gradiente morbido, tessuti e gomma presentano microtexture opache, i metalli mostrano una caduta pulita delle alte luci speculari. Aggiungi un'ombra di contatto morbida sotto il prodotto, senza proiezioni nette. Scatta da un'angolazione di tre quarti leggermente rialzata, con un obiettivo equivalente a 85mm, profondità di campo piuttosto ampia, prodotto che occupa circa il 70% dell'inquadratura e abbondante spazio negativo nella parte superiore per il testo di marketing. Qualità di ritocco di livello commerciale, colori accurati, nessun oggetto di scena, nessun riflesso dello studio sul prodotto, nessuna sovrapposizione di testo.
Copia il prompt completo e adattalo alla tua generazione.
Tag
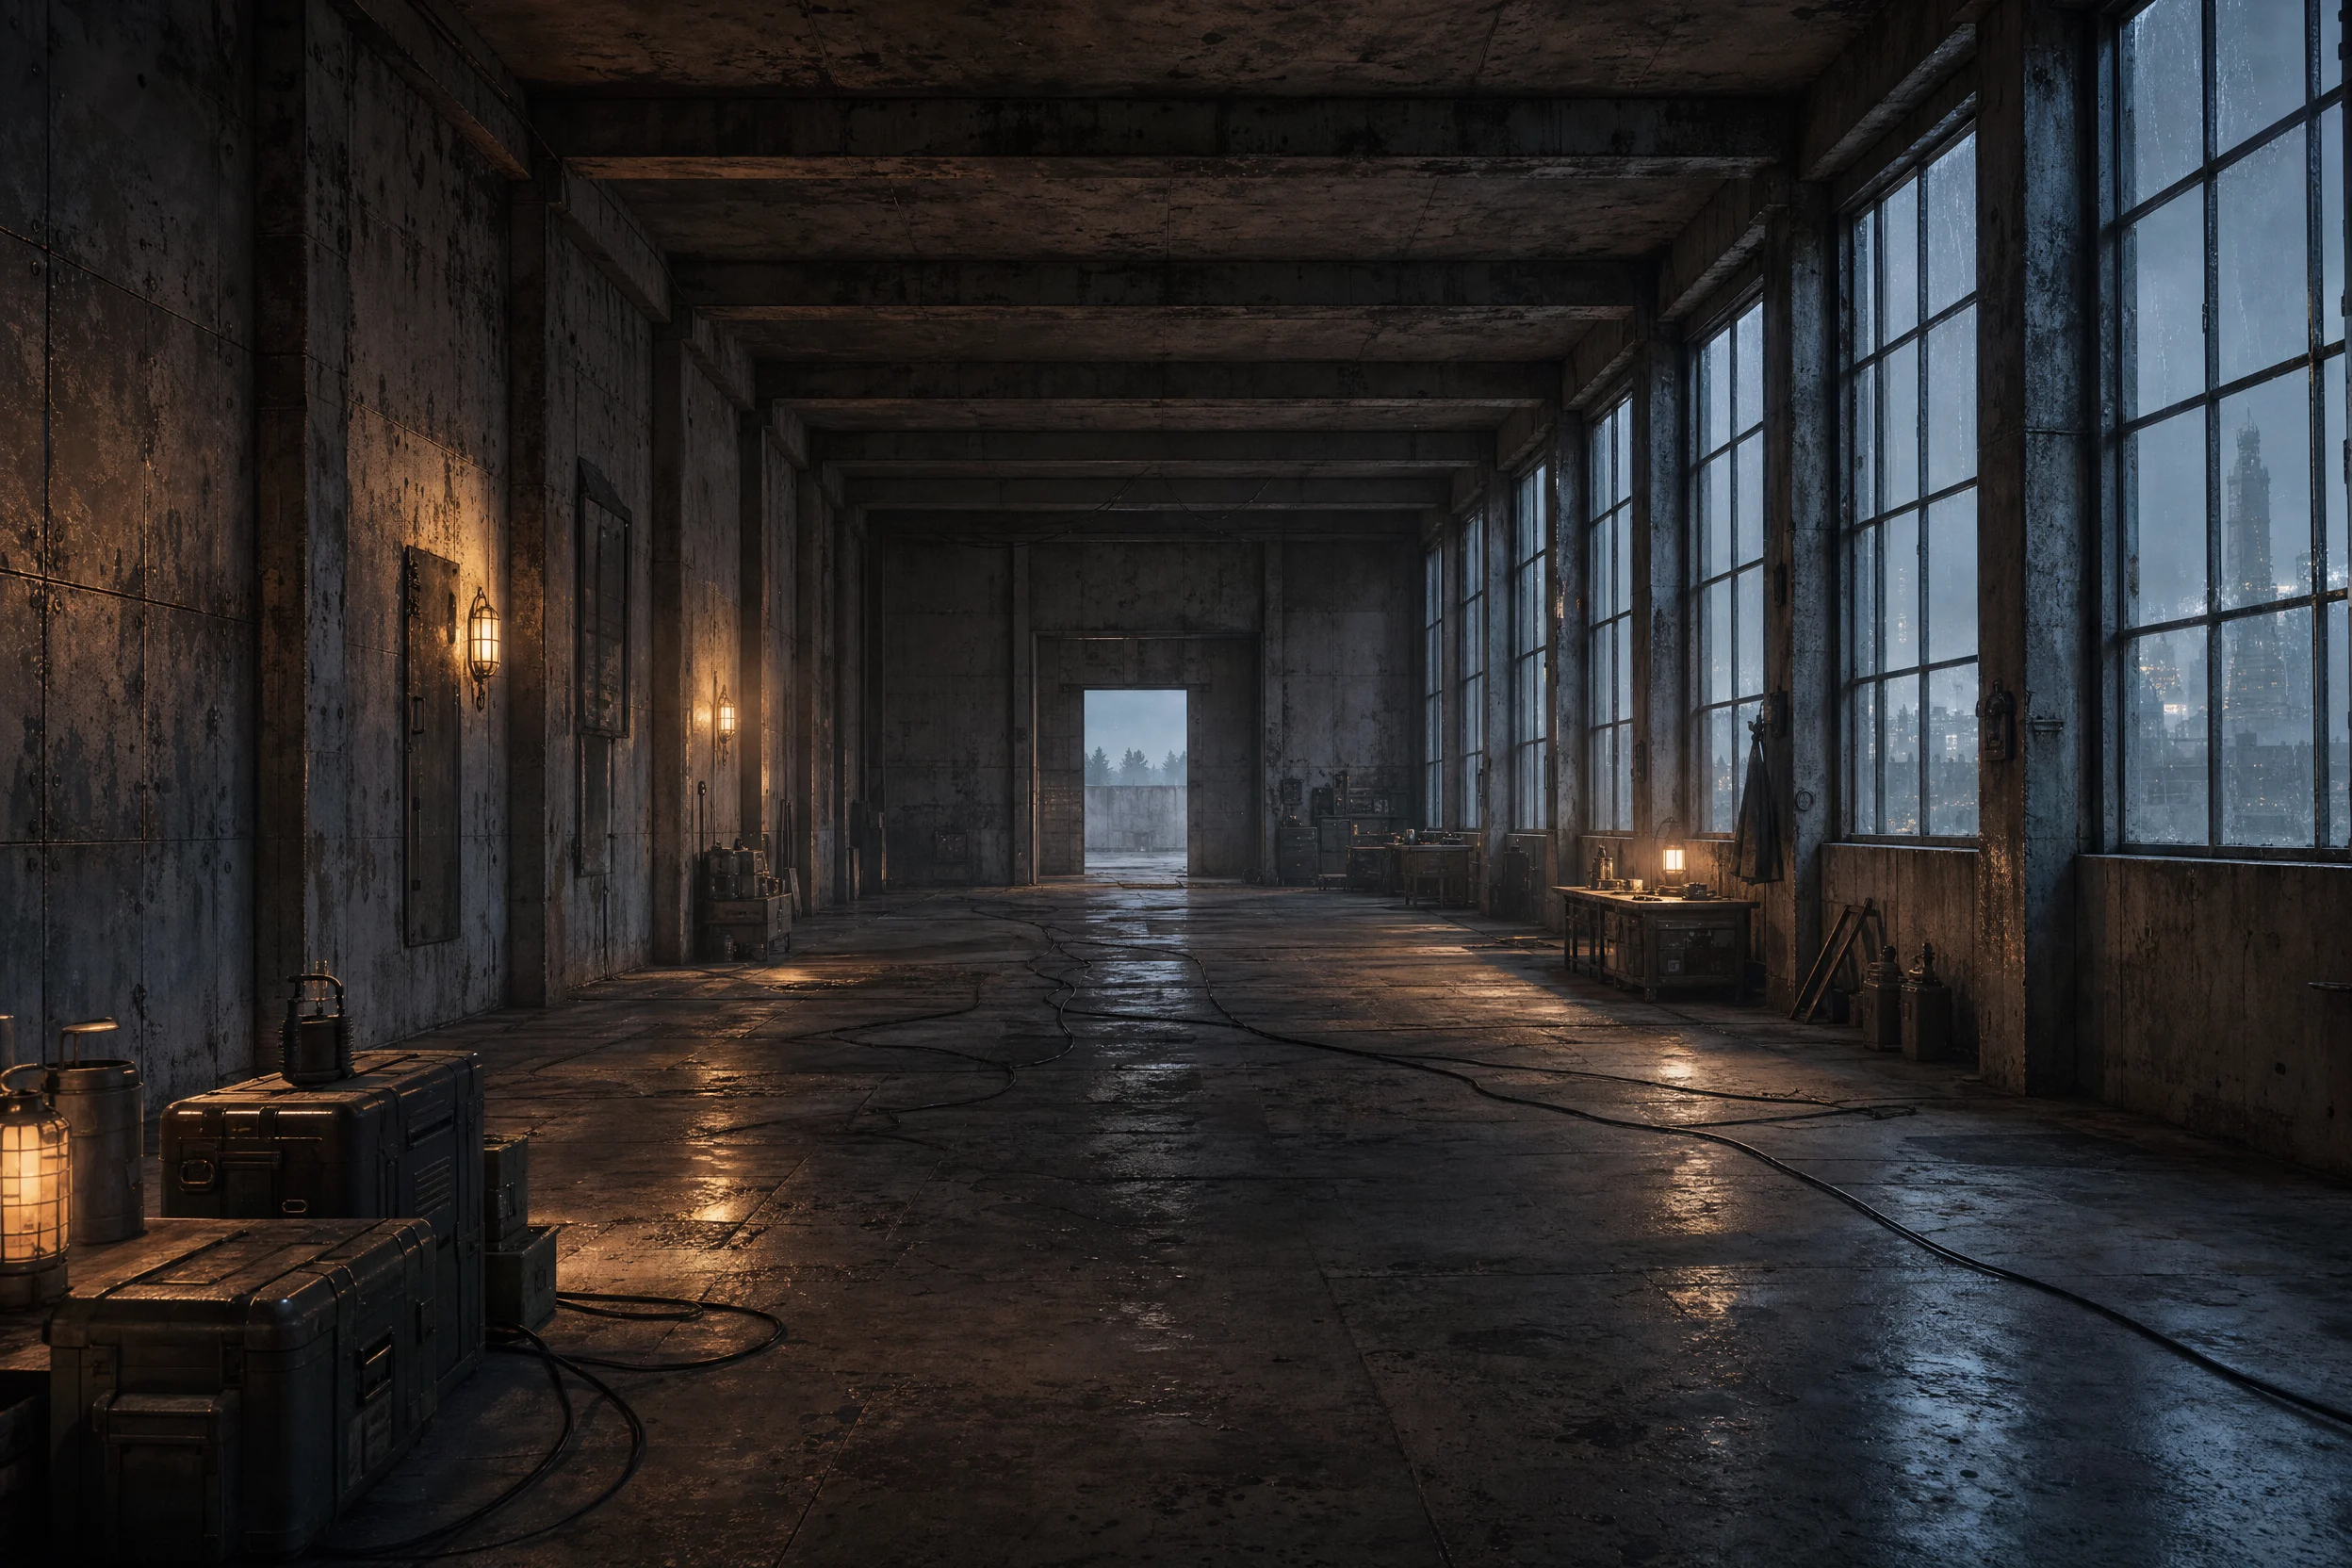
Concetto di scenario di ambientazione: riscrittura atmosferica guidata da un'immagine di riferimento
Stile Concept art · Costruzione del mondo · modifica-immagine
Input di riferimento
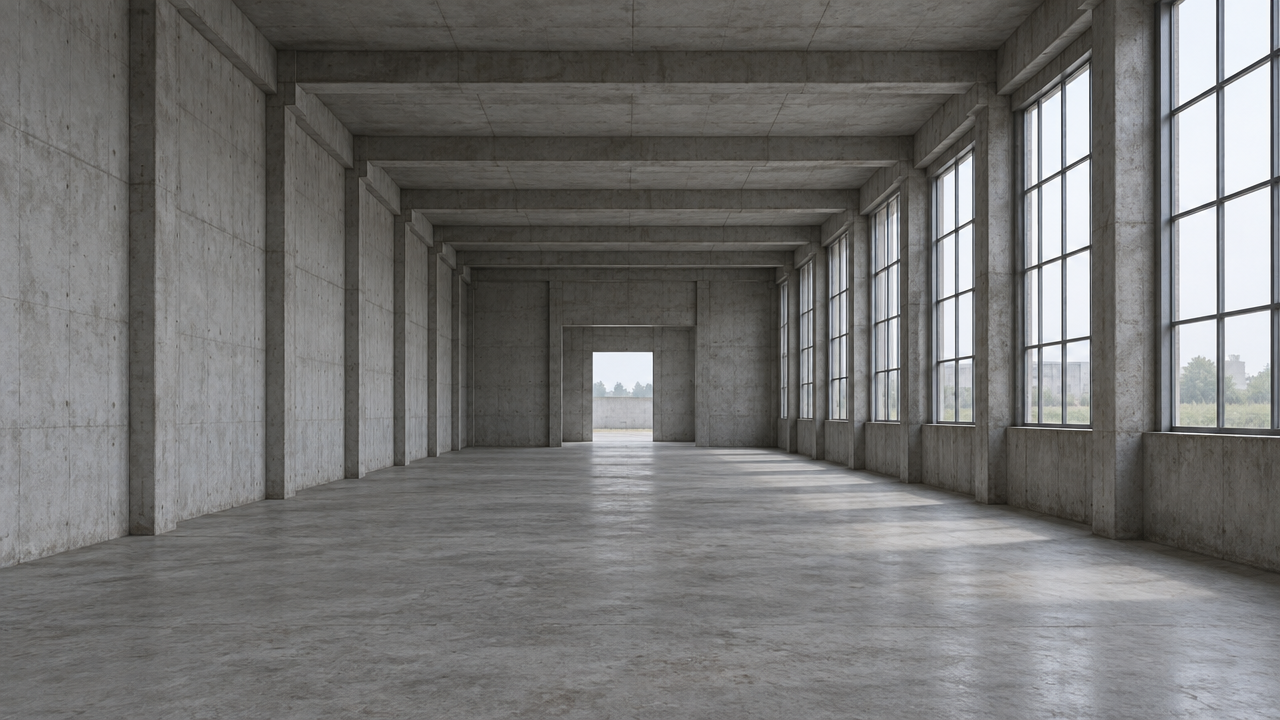
Immagine di riferimento
Prompt
Concept art di ambientazione da immagine a immagine. Mantieni invariati la posizione della camera, la prospettiva e la disposizione di pareti e aperture dell'immagine di riferimento; ricrea completamente atmosfera, materiali e illuminazione. Trasforma la scena in un avamposto di ricerca di frontiera logorato dal tempo al crepuscolo: pannelli metallici rattoppati, rivetti ossidati, cemento macchiato di sporco, cavi stesi lungo il pavimento, finestre alte e strette che lasciano filtrare una luce esterna blu freddo, calde lampade utilitarie ambrate all'interno, polvere volumetrica nell'aria, vago condensamento sul vetro, la sagoma di una torre in rovina in lontananza oltre la finestra. Composizione cinematografica in 16:9, con chiari livelli di primo piano, piano medio e sfondo, forte separazione tra luci e ombre, palette sobria e desaturata con un unico accento caldo, sottile grana cinematografica, texture pittorica da concept art, senza testo, senza filigrana.
Copia il prompt completo e adattalo alla tua generazione.
Tag
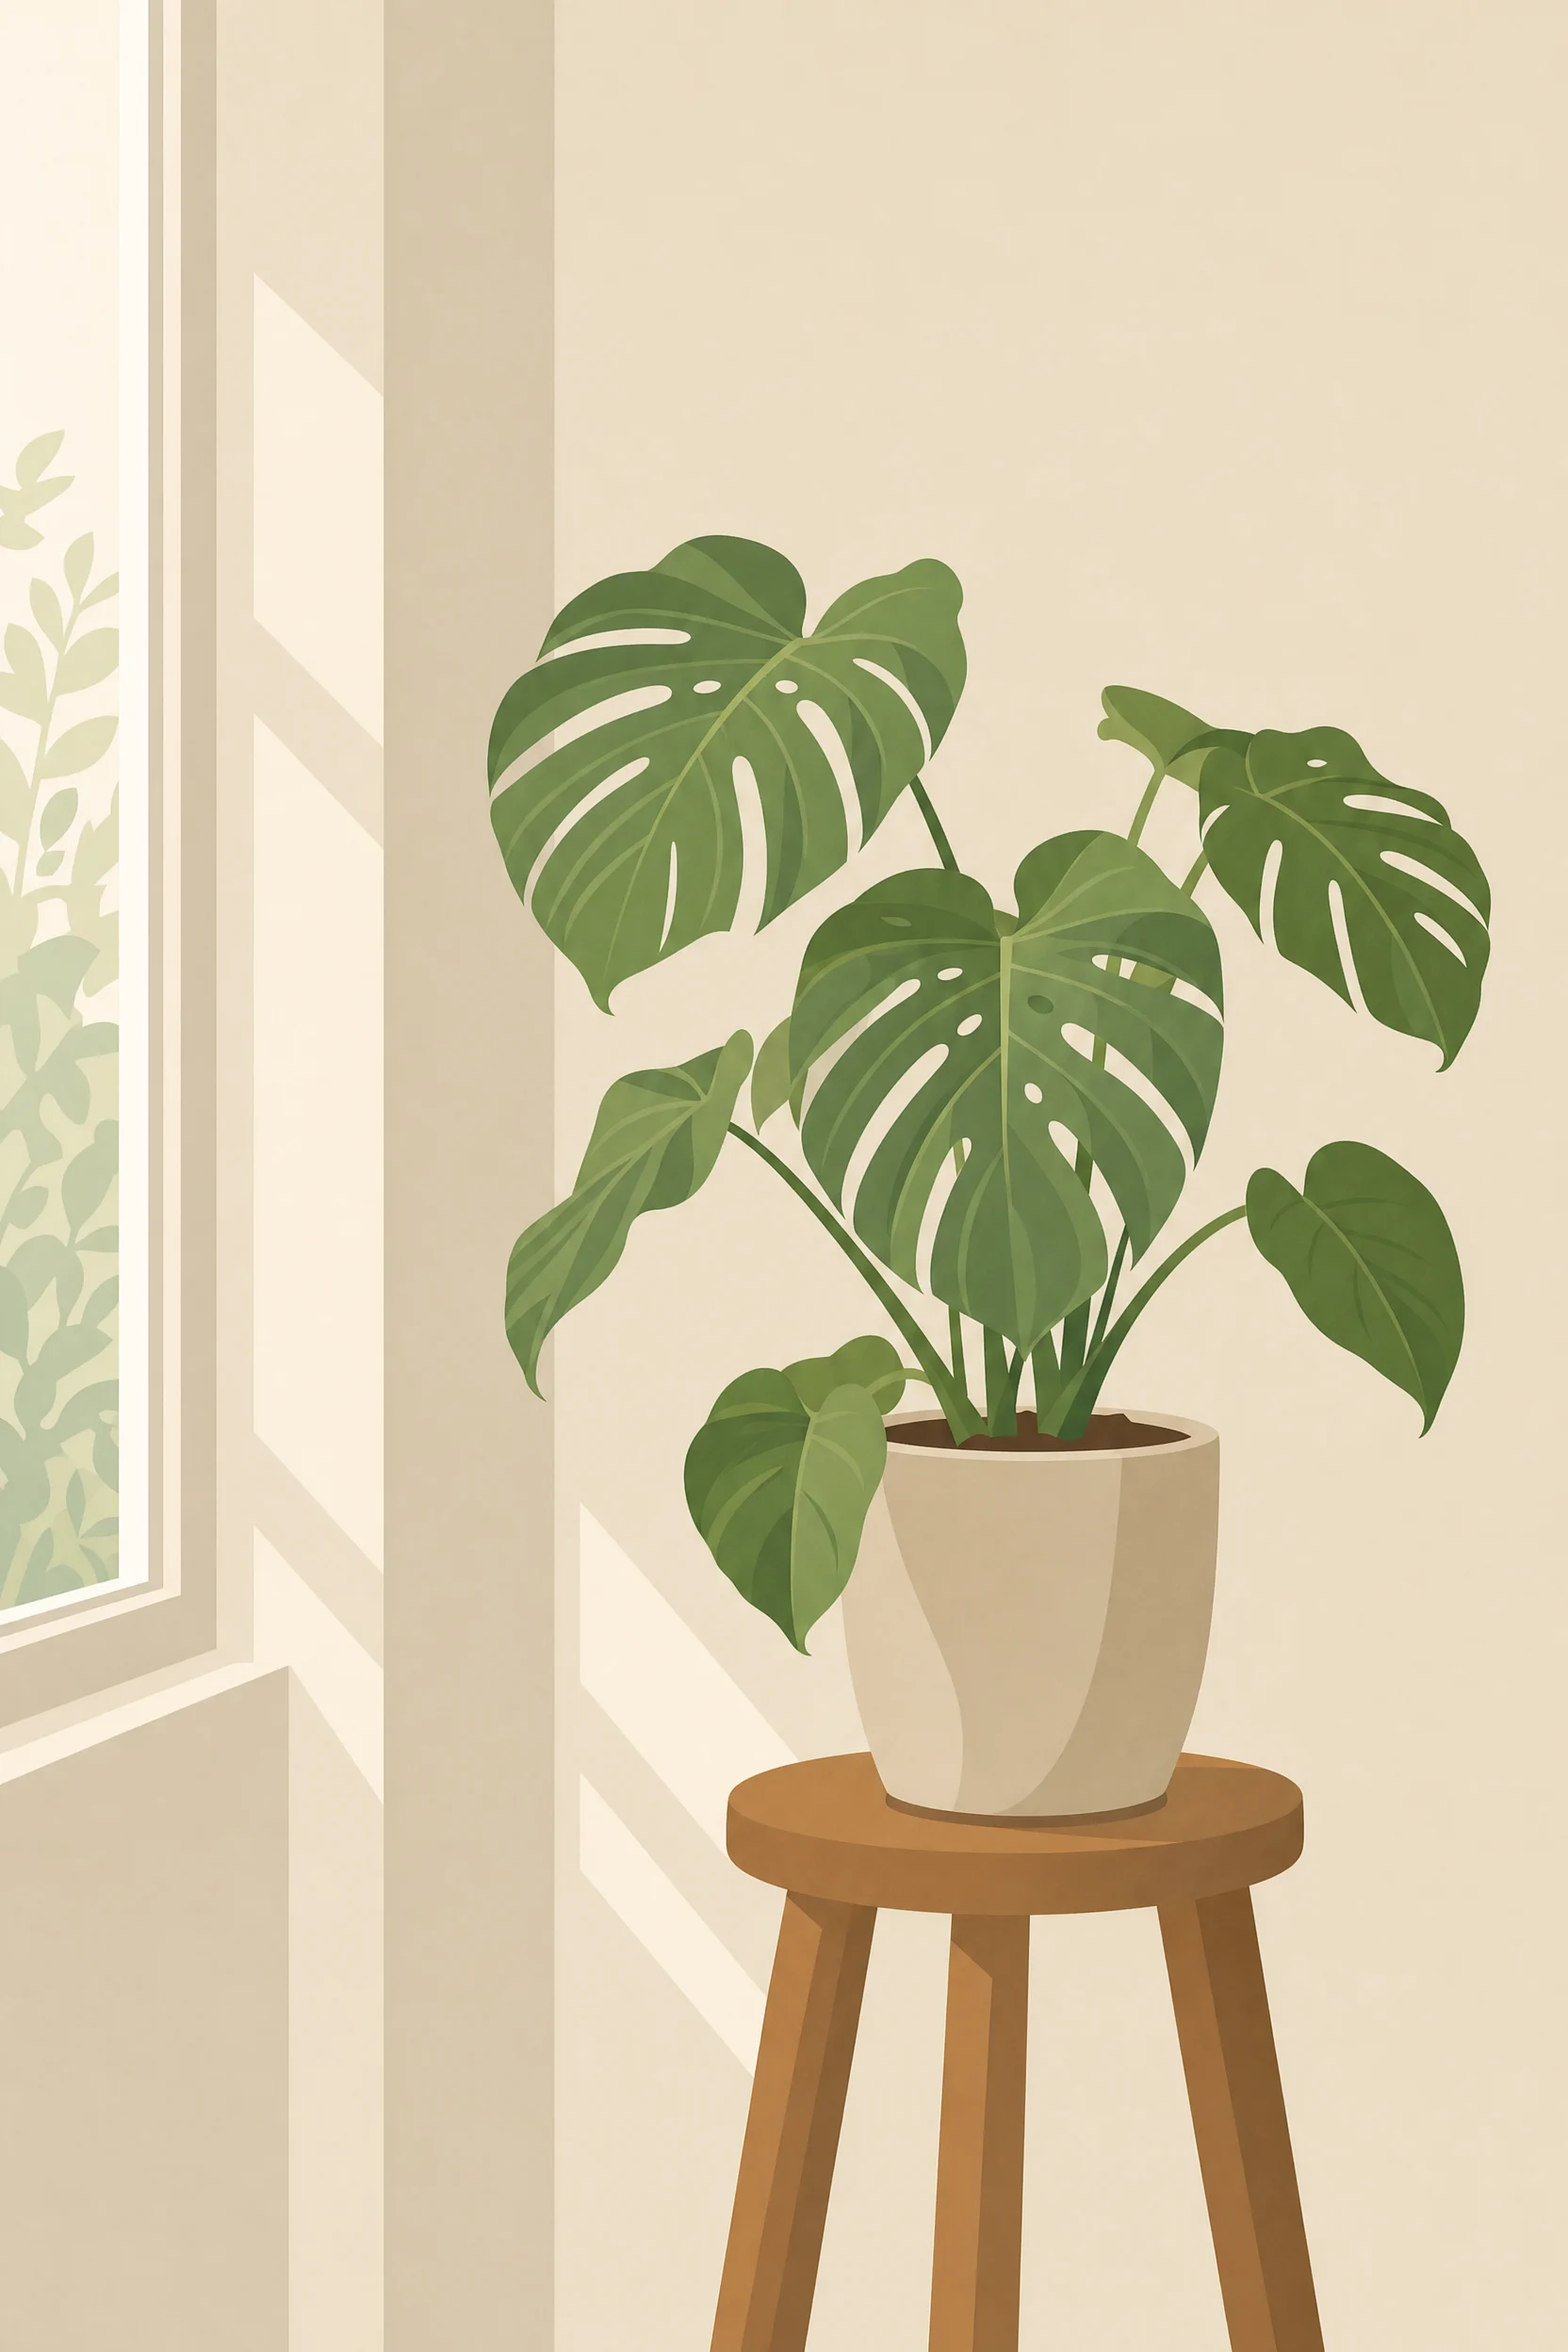
Dal realismo al flat: illustrazioni dello spettro stilistico con img2img di gpt-image-2
Stile trasferimento-di-stile · editorial-illustration · Design piatto
Input di riferimento
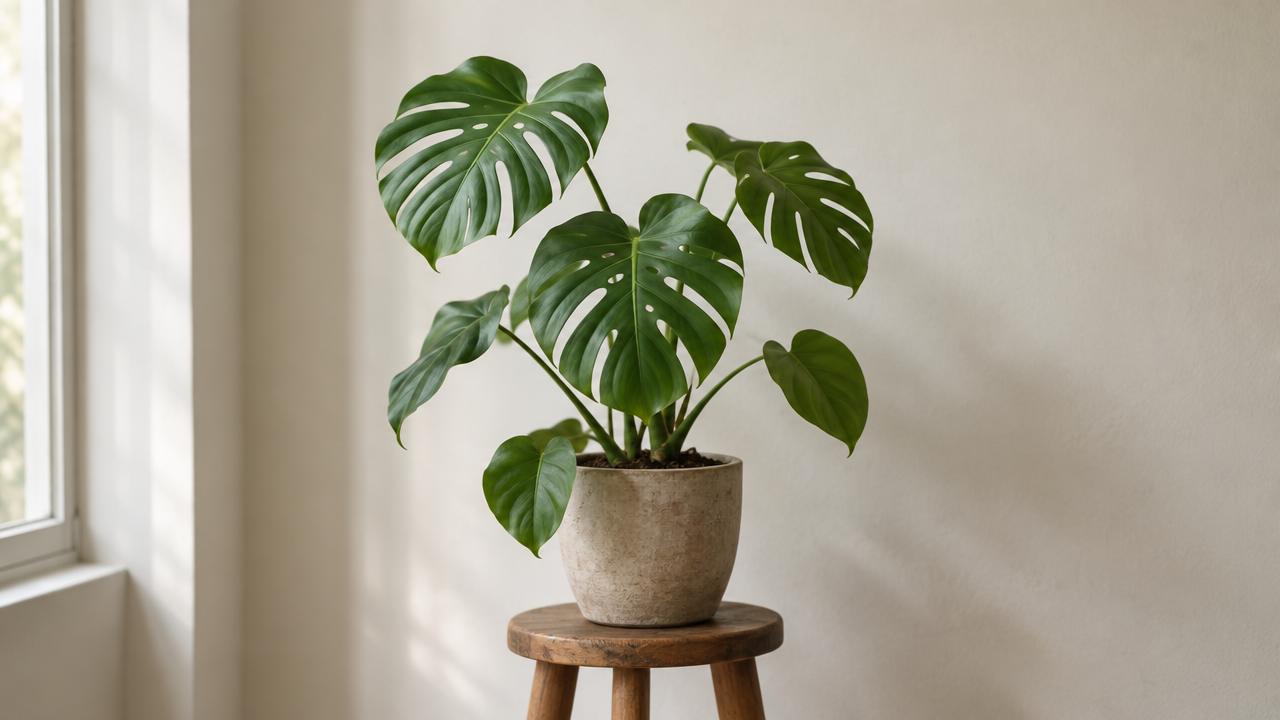
Immagine di riferimento
Prompt
Esegui una migrazione stilistica img2img su una singola foto di riferimento, trasformandola in un'illustrazione editoriale flat. Mantieni la silhouette del soggetto, la posizione degli oggetti e la composizione complessiva dell'immagine di origine; semplifica progressivamente i dettagli fotografici in forme geometriche semplificate, bordi puliti di tipo vettoriale e una palette limitata composta da 5–6 colori desaturati con un unico accento caldo. Rimuovi texture, rumore, gradienti e riflessi speculari; sostituisci le ombre con forme dai toni in tinta unita. Composizione verticale 4:5, soggetto centrato con ampio spazio negativo, illuminazione morbida e uniforme suggerita da riempimenti piatti anziché da luci renderizzate. Bordi nitidi, nessun contorno più spesso di un capello, nessuna grana fotografica, nessun elemento aggiuntivo oltre alla scena di origine.
Copia il prompt completo e adattalo alla tua generazione.
Tag
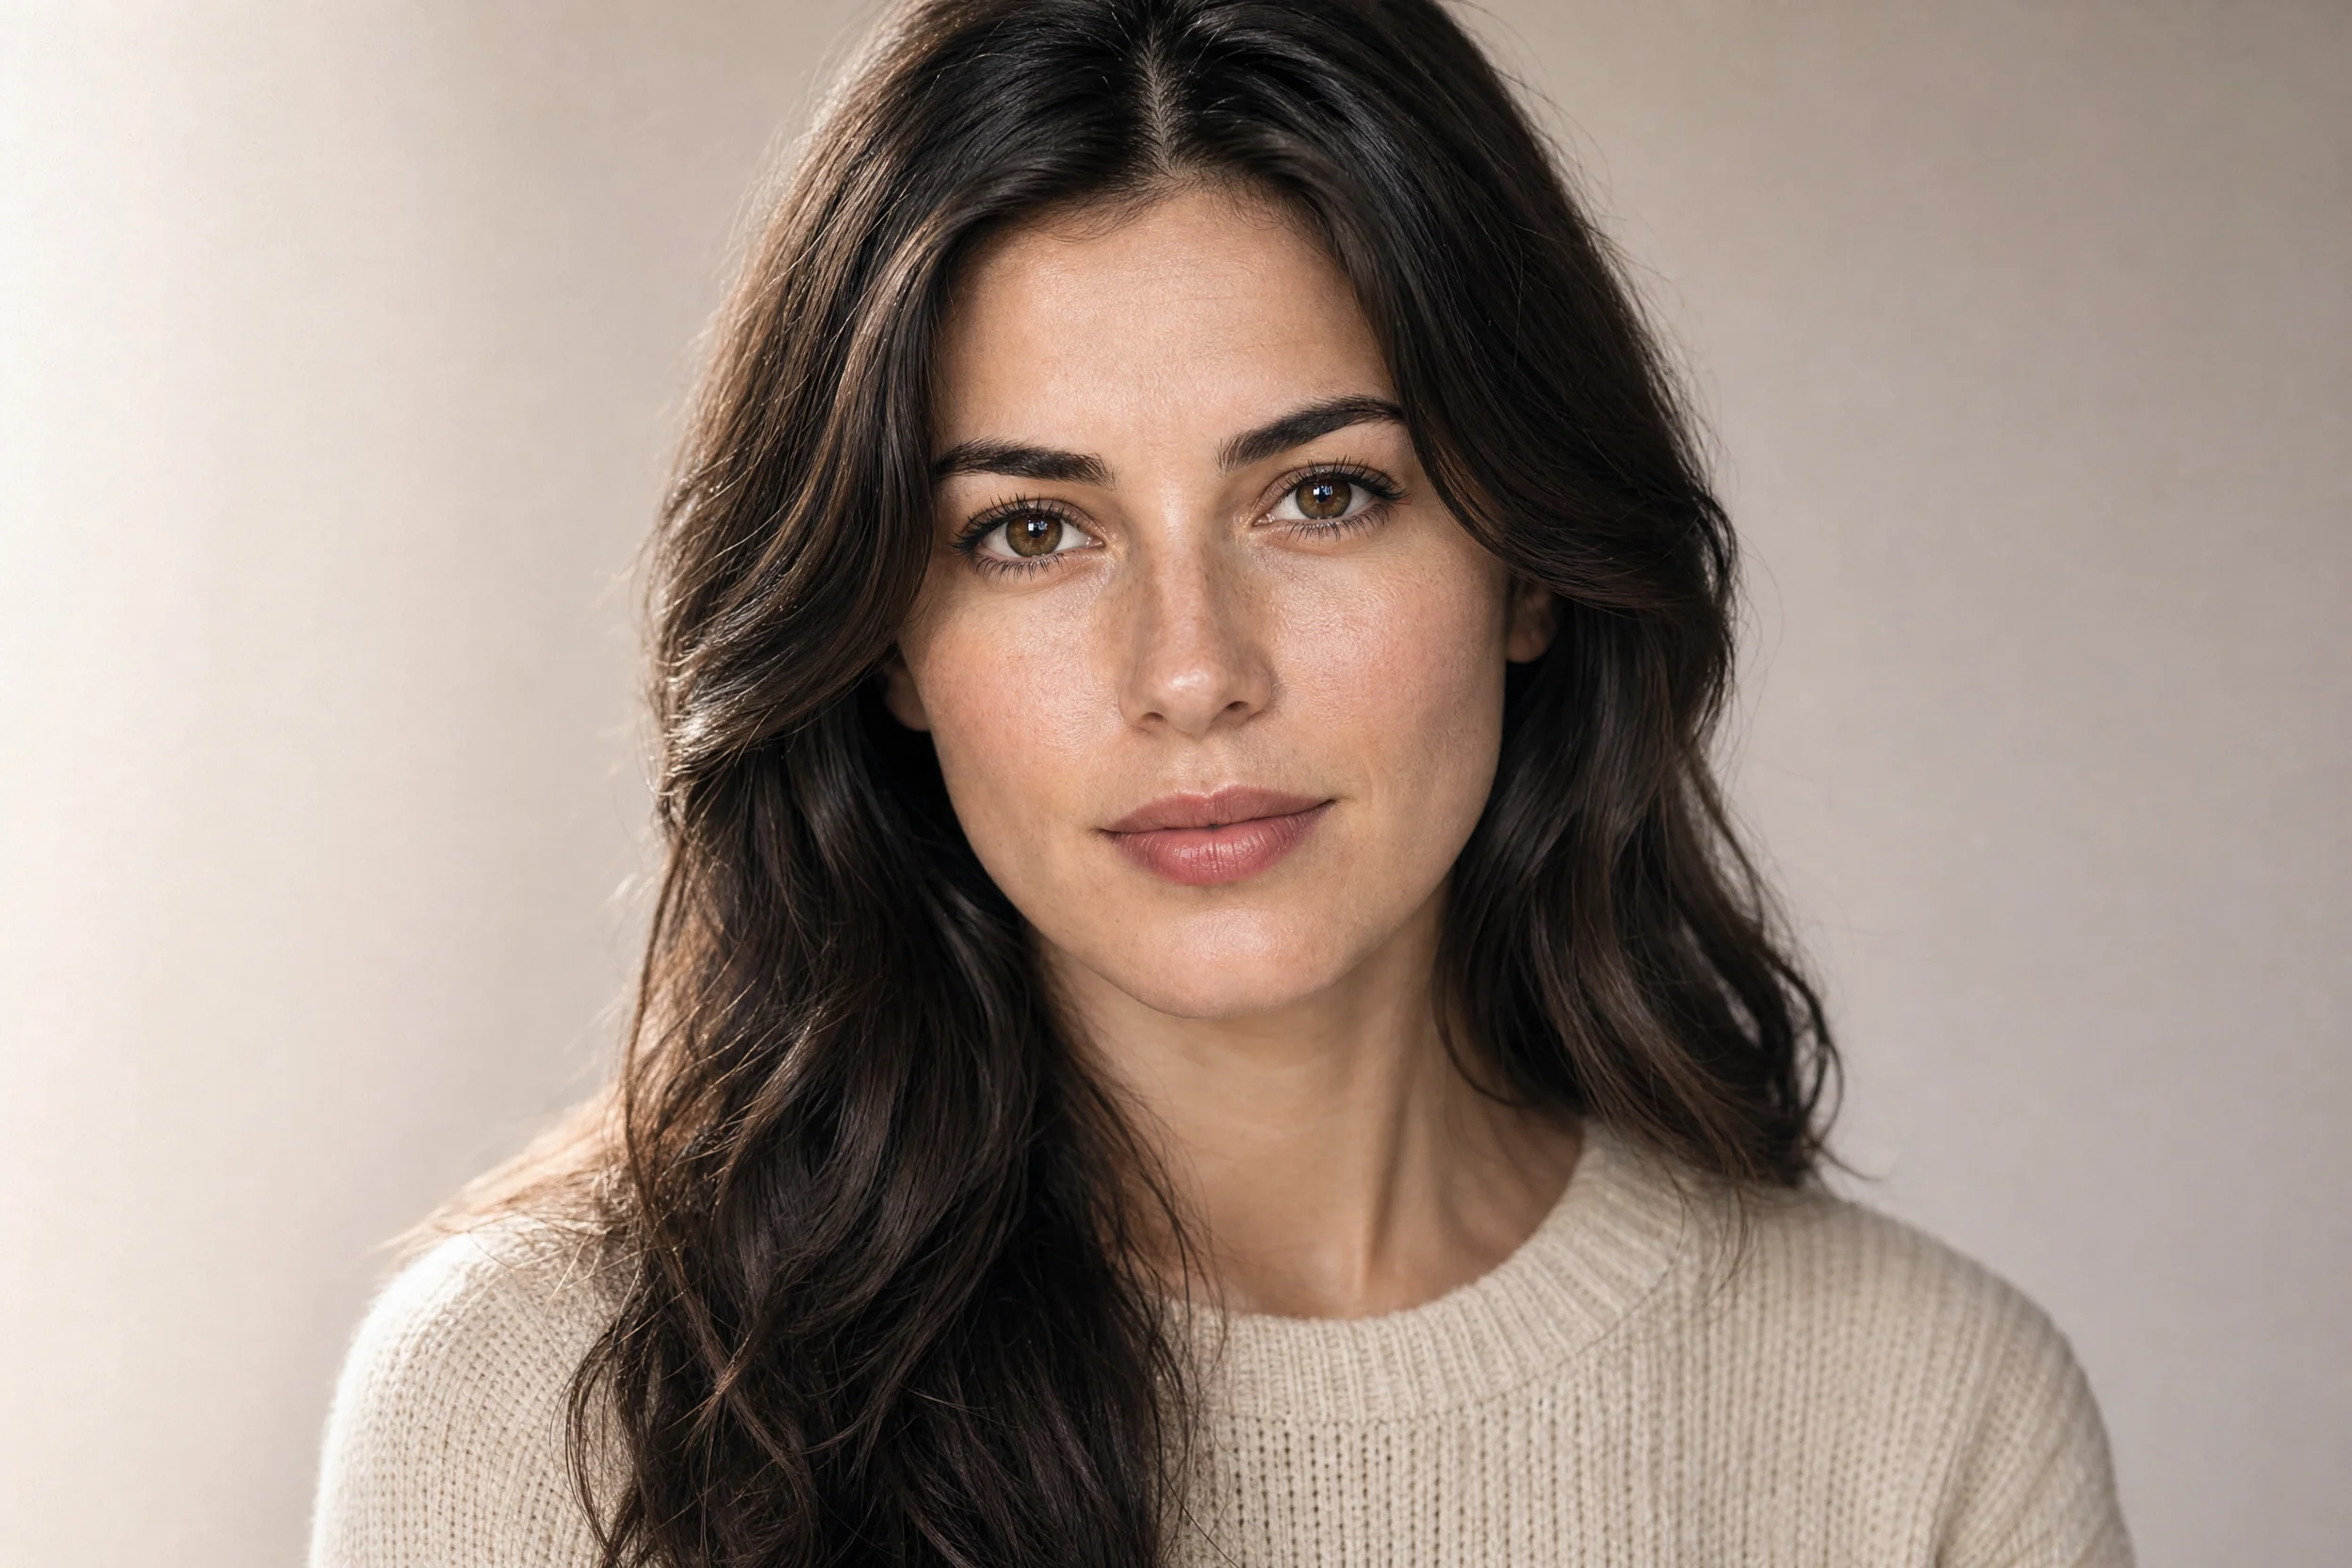
gpt-image-2 demo di stile ritratto image-to-image: doppio percorso realistico e artistico
Stile Ritratto e fotografia · trasferimento-di-stile · Fotografia commerciale
Input di riferimento
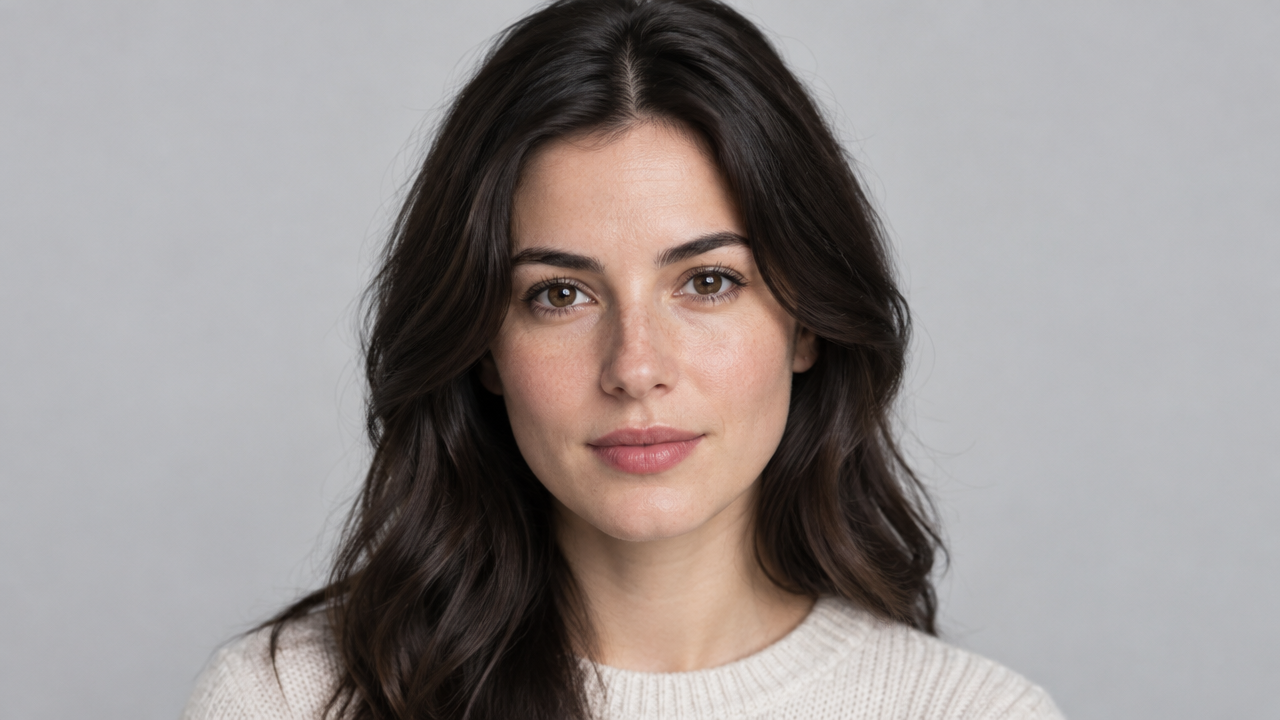
Immagine di riferimento
Prompt
Ridisegno di stile ritratto image-to-image. Mantieni l'identità facciale, la posa e la composizione della persona nell'immagine di riferimento; modifica solo l'illuminazione, la correzione colore e il rendering della superficie. Percorso realistico: texture cutanea naturale, pori visibili e peluria sottile, luce finestra direzionale morbida proveniente da sinistra della fotocamera, transizione morbida verso le ombre, bilanciamento neutro caldo-bianco, angolo di campo equivalente a 85mm, profondità di campo ridotta, leggera grana filmica, resa da ritratto commerciale in medio formato, sfondo neutro pulito e ordinato. Composizione verticale 4:5, taglio testa-spalle, occhi sulla linea del terzo superiore, senza testo, senza filigrana.
Copia il prompt completo e adattalo alla tua generazione.
Tag
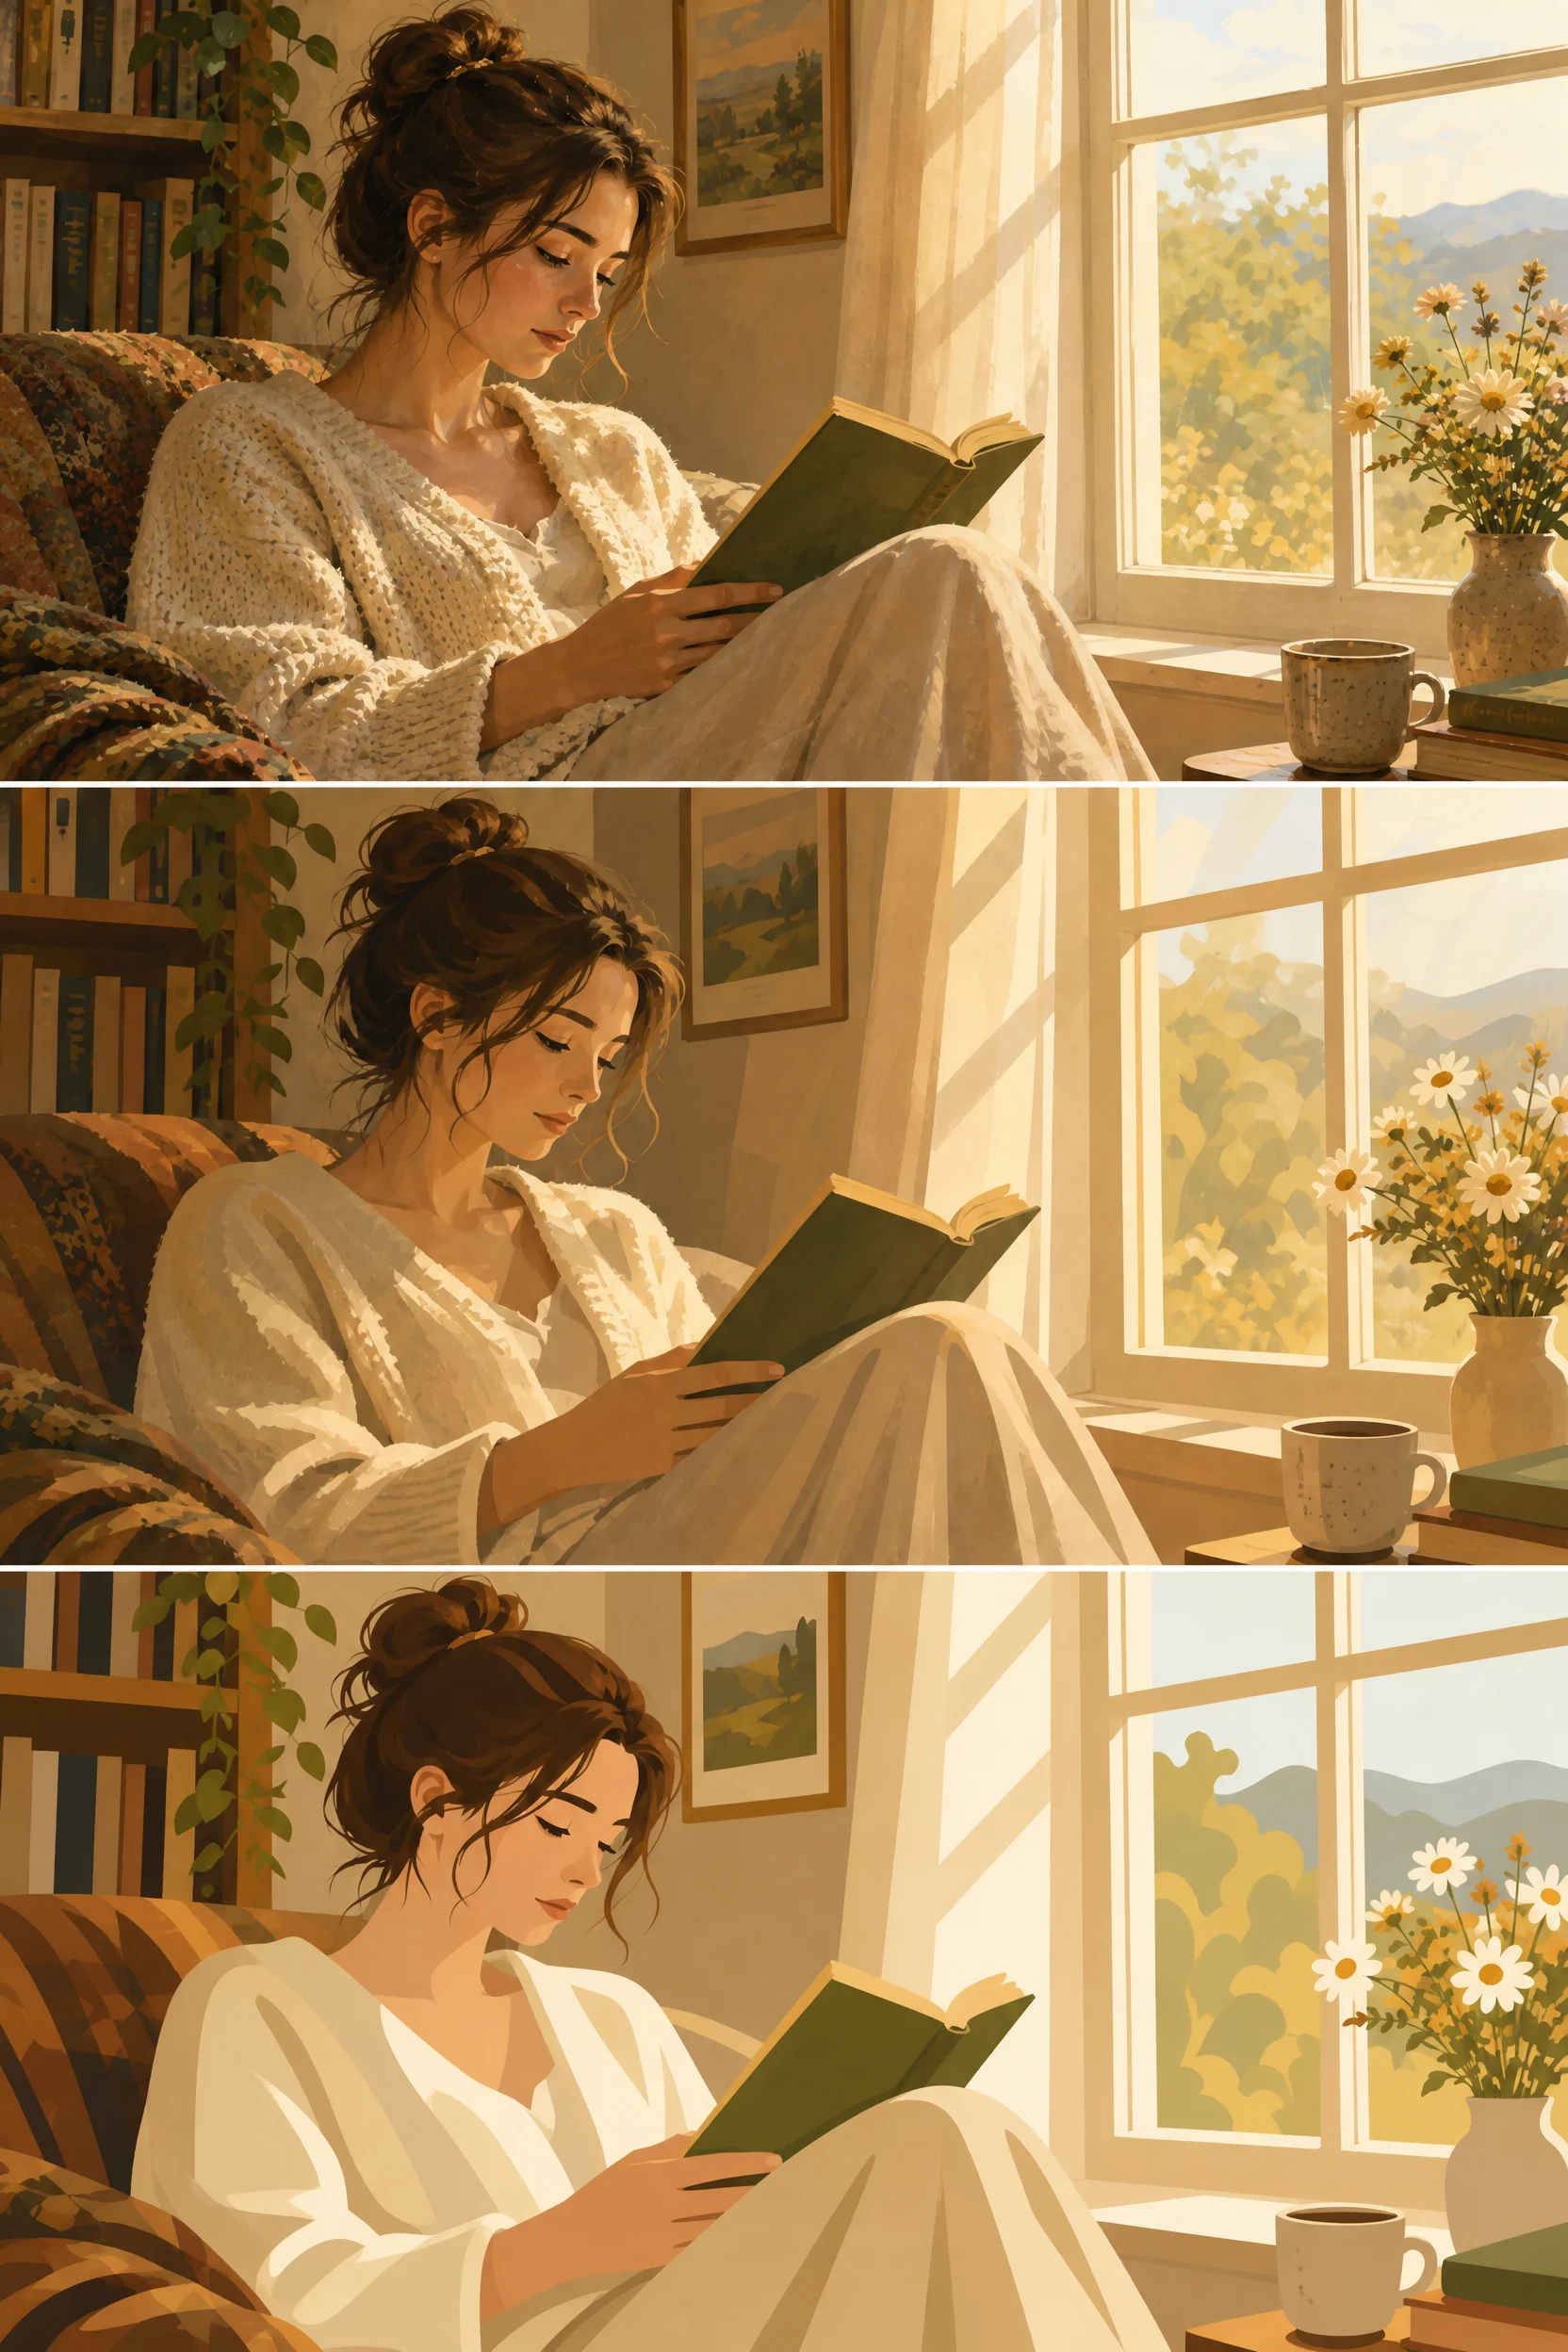
Spettro stilistico: dalla stessa illustrazione realistica al flat con gradiente
Stile Illustrazione · trasferimento-di-stile · Design piatto
Input di riferimento
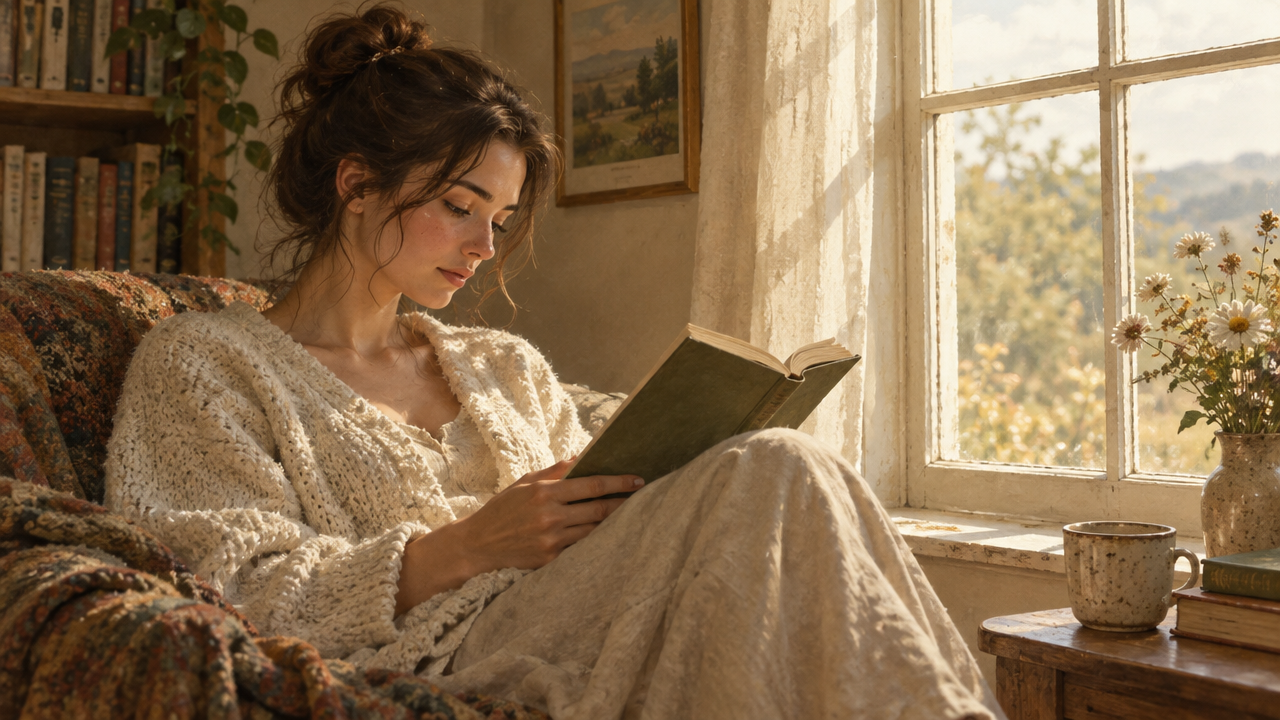
Immagini di riferimento
Prompt
Una serie di illustrazioni che mostra lo spettro stilistico dal realistico al flat. Partendo da una scena d'interni realistica, calda e dalla luce soffusa, in cui una donna legge accanto alla finestra, la si reinterpreta poi in tre livelli di stilizzazione: (1) semi-realistico, con morbidi gradienti pittorici e dettagli preservati; (2) semi-flat, con ombre semplificate, silhouette marcate e texture ridotte; (3) stile vettoriale completamente flat, con campiture di colore puro, forme geometriche pulite e linee minimali. Mantieni coerenti soggetto, composizione e gamma cromatica in tutti i livelli. Composizione 16:9, bordi puliti, senza testo.
Copia il prompt completo e adattalo alla tua generazione.
Tag
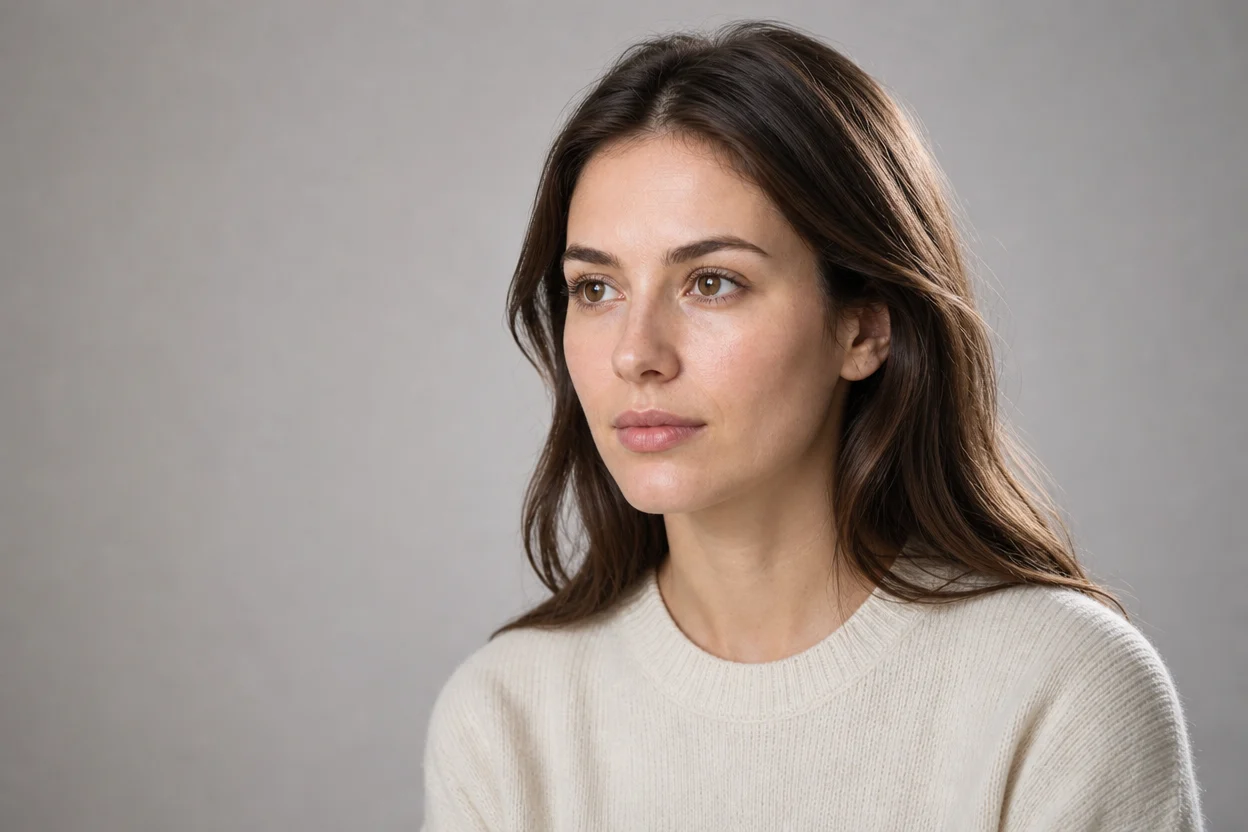
Ridisegno dello stile del ritratto: due percorsi, realismo e artisticità
Stile Ritratto e fotografia · immagine-in-immagine · trasferimento-di-stile
Input di riferimento
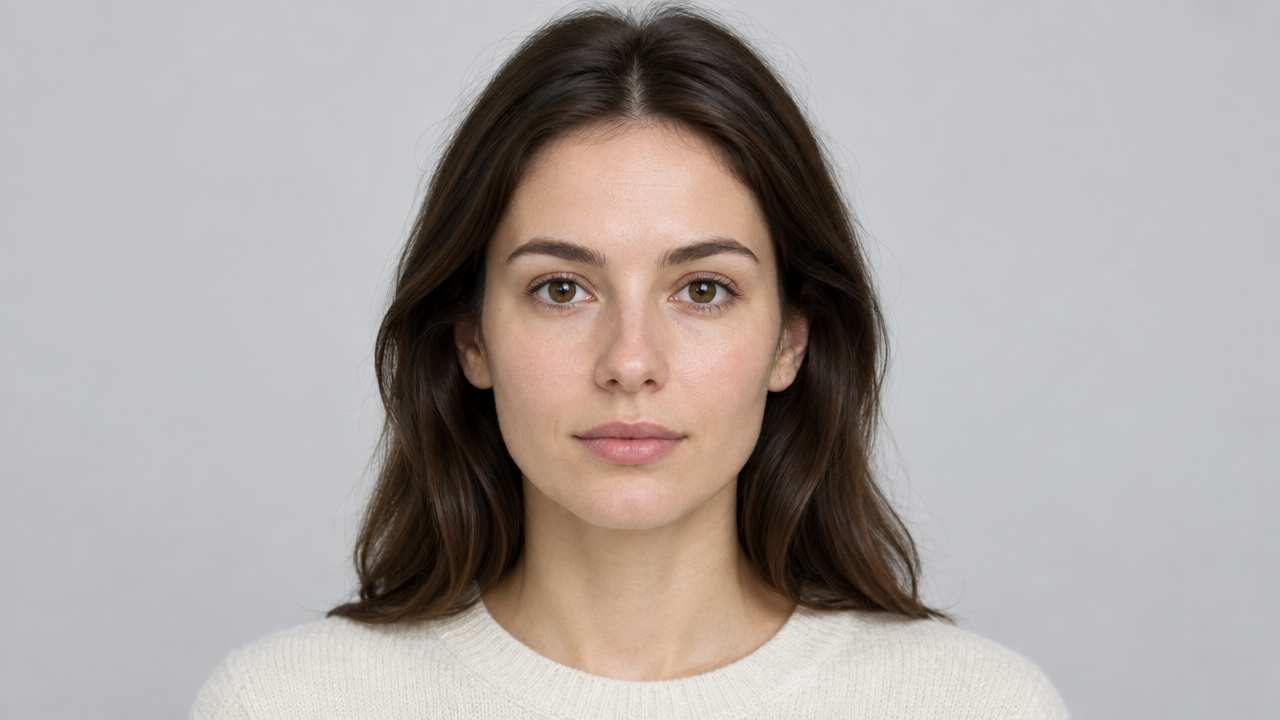
Immagini di riferimento
Prompt
Ritratto da studio fotorealistico, vista di tre quarti laterale in stile editoriale di rivista, singolo soggetto adulto leggermente rivolto verso sinistra, luce principale morbida da un grande softbox posto a destra della fotocamera, integrata da una leggera luce di riempimento e da una delicata luce di contorno sui capelli, profondità di campo ridotta, sfondo grigio neutro con dissolvenza uniforme, texture naturale della pelle preservata, pori visibili e capelli sottili, espressione calma e sicura, color grading da rivista di moda contemporanea, composizione orizzontale 16:9, ampio spazio negativo a sinistra, ricco di dettagli, senza testo, senza logo
Copia il prompt completo e adattalo alla tua generazione.
Tag
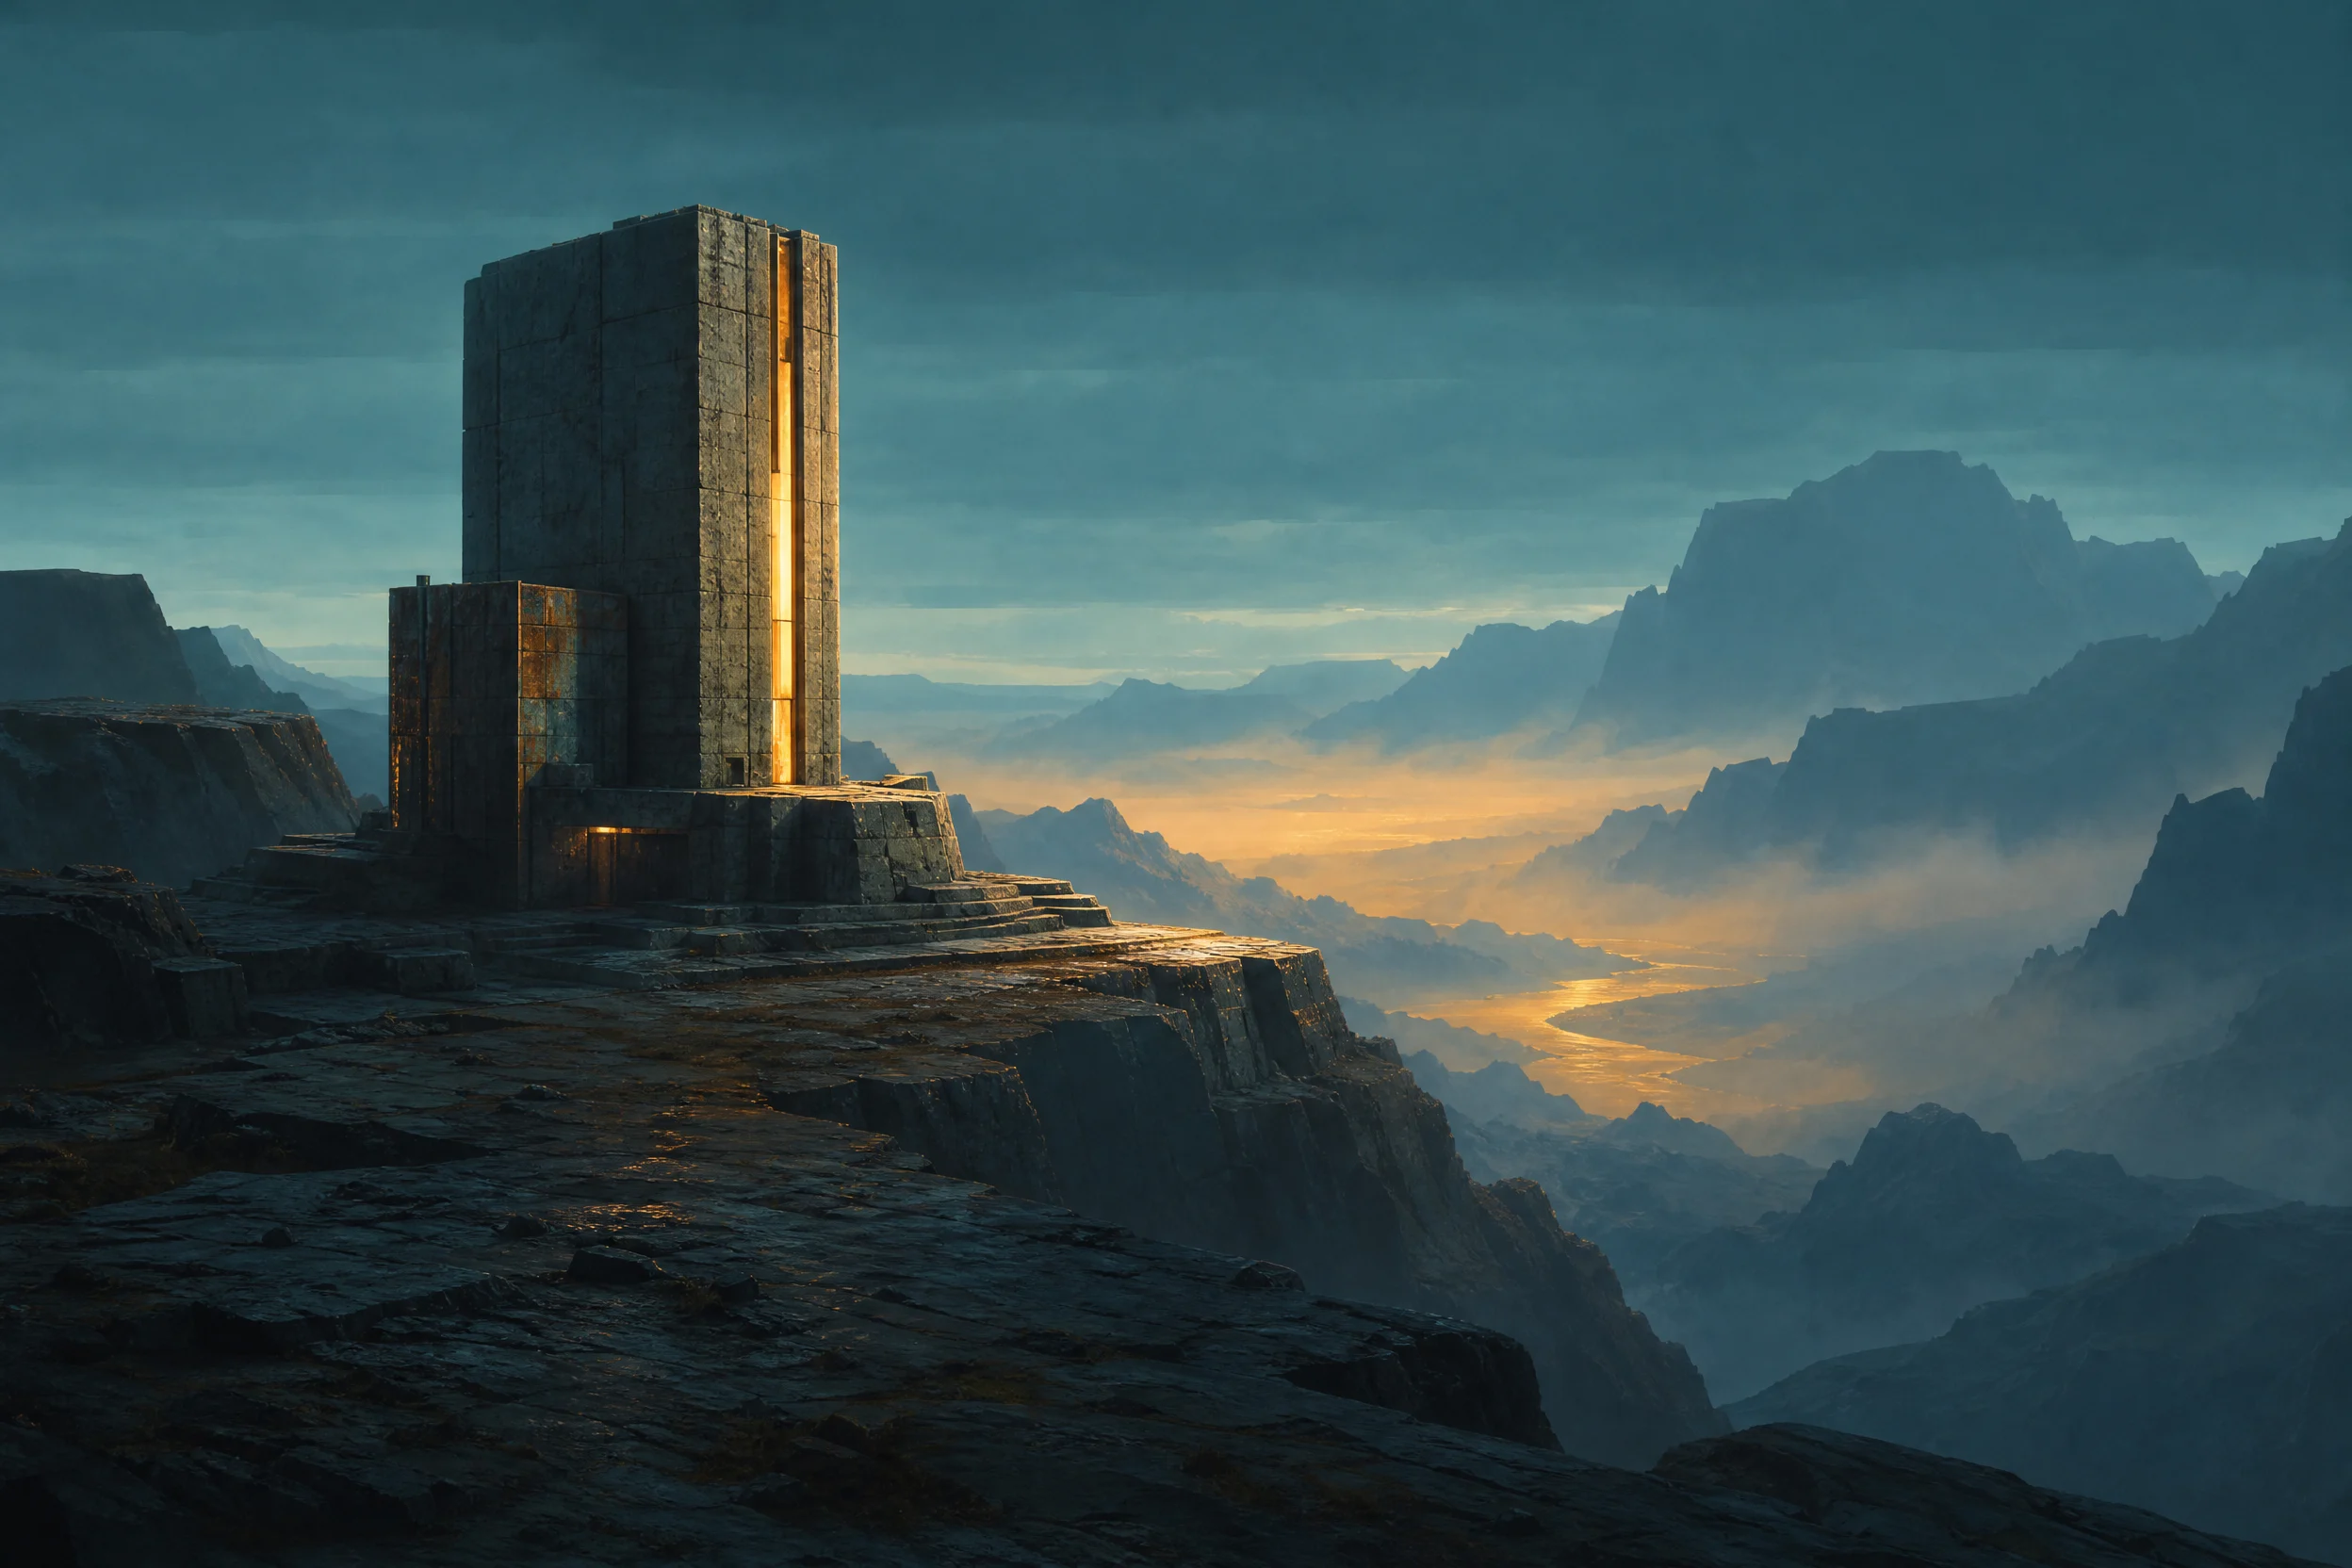
Concetto di scenario del worldbuilding: esplorazione visiva d'atmosfera
Stile Concept art · Costruzione del mondo · Cinematografico
Input di riferimento
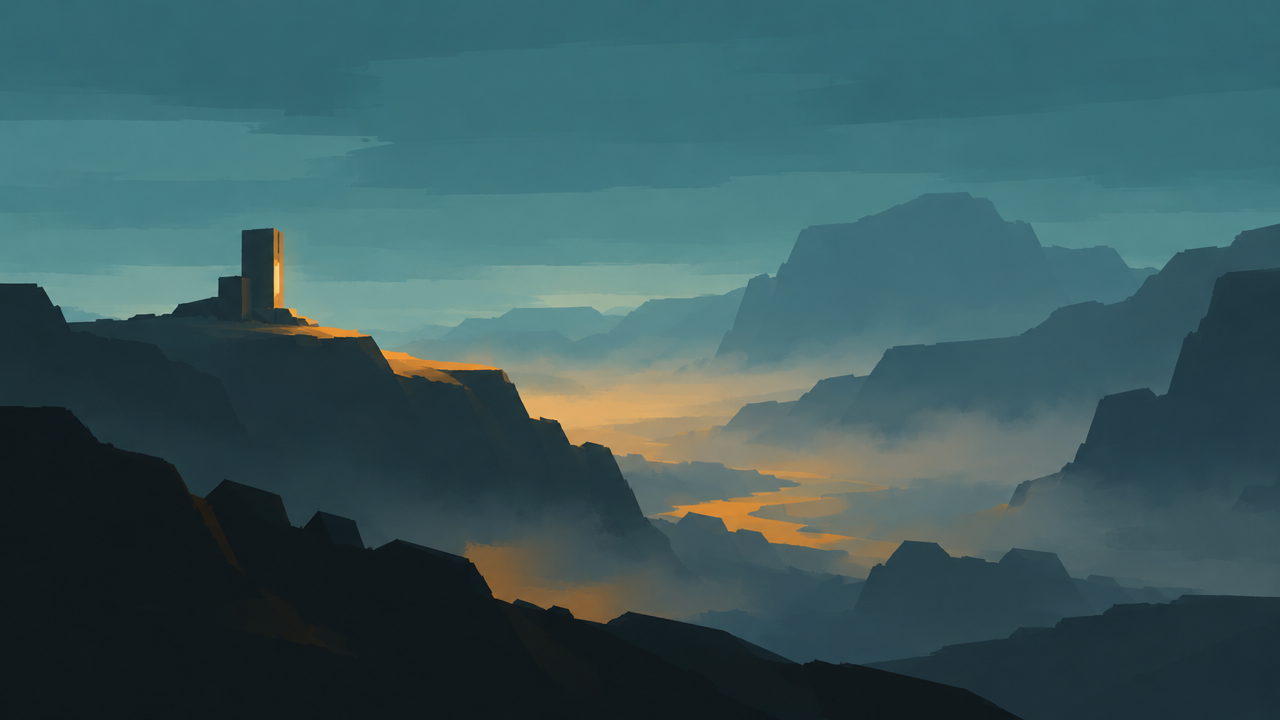
Immagini di riferimento
Prompt
Concept art ambientale di livello cinematografico rielaborata a partire dal mood board di riferimento: un gigantesco osservatorio isolato, incastonato in una scogliera di basalto, che domina una valle avvolta da una nebbia leggera al crepuscolo dell'ora blu. Mantieni le tonalità fredde verde acqua e ambra, il linguaggio delle silhouette e la posizione dell'orizzonte dell'immagine di riferimento; aggiungi dettagli materici solidi — pietra erosa dagli agenti atmosferici, nervature metalliche ossidate, una calda luce interna che filtra dalle fessure strette. Composizione in formato panoramico 16:9, con un pianoro roccioso in primo piano che offre un riferimento di scala, le strutture architettoniche a metà campo e una nebbia atmosferica stratificata che si estende fino alle montagne in lontananza. Luce volumetrica morbida, sottile luce di contorno sulle architetture, rendering pittorico ma credibile, alta gamma dinamica, senza testo, senza filigrana.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
gpt-image-2/image-to-image per image
| Specifiche | Prezzo unitario |
|---|---|
| 1K | $0.030 |
| 2K | $0.040 |
| 4K | $0.060 |
gpt-image-2/image-to-image @ext per image
Panoramica e posizionamento
gpt-image-2/image-to-image è la linea della famiglia di modelli di immagini OpenAI dedicata alla rigenerazione e alla modifica delle immagini: riceve da 1 a 16 immagini di riferimento e un prompt testuale, restituendo un'immagine ricostruita. È adatta agli scenari di sviluppo in cui occorre riscrivere, estendere, uniformare lo stile o sostituire il layout partendo da materiali già esistenti, e consente di scegliere il formato in base alle specifiche di pubblicazione e una risoluzione massima fino a 4K. Rispetto alla pura generazione da testo, il valore di questa linea sta nell'ancorare il risultato alle immagini di riferimento fornite dallo sviluppatore.
Punti salienti
- Input con più immagini di riferimento — in una singola chiamata si possono inviare da 1 a 16 immagini di riferimento, usando l'insieme dei materiali come base della generazione anziché affidarsi solo alla descrizione testuale.
- Formato scelto in base alle specifiche di pubblicazione — sono inclusi oltre dieci rapporti, da 1:1 e 16:9 fino a 21:9 e 9:21, allineabili direttamente a landing page, feed e materiali verticali.
- Risoluzione massima fino a 4K — sono supportate tre fasce di output, 1K, 2K e 4K; il formato 1:1 non supporta il 4K, mentre l'alta risoluzione è utilizzabile per materiali di livello tipografico o per grandi schermi.
- Supporto all'output con sfondo trasparente — a 1K è possibile scegliere la modalità di sfondo trasparente, opaca o automatica, per sovrapporre direttamente il risultato ad altri livelli di progettazione.
Descrizione delle capacità
Riscrittura dell'immagine guidata da riferimenti: genera una nuova immagine a partire da quella di input, adatta a sostituire lo stile, modificare la composizione o creare varianti basate su materiali esistenti; il risultato eredita gli indizi visivi delle immagini di riferimento.
Controllo combinato di formato e risoluzione: le specifiche di output sono determinate dai due parametri aspect_ratio e resolution; scegliendo auto o rapporti d'aspetto particolari il formato è limitato a 1K, quindi è necessario vincolare i parametri in anticipo.
Controllo della modalità di sfondo: il parametro background offre i valori auto, opaque e transparent, attivo solo alla risoluzione 1K, adatto a flussi successivi che richiedono rimozione dello sfondo o compositing a livelli.
Vincoli sui prompt lunghi: prompt ha un limite di 20000 caratteri, consentendo di inserire in un'unica soluzione più vincoli, indicazioni di layout e contenuti testuali, riducendo le descrizioni supplementari su più turni.
Unione di più materiali: input_urls consente di passare più immagini in una sola volta, fornendo separatamente soggetto, riferimenti di stile ed esempi di layout, che il modello combina in un'unica immagine di output.
Scenari d'uso
- Estensione multi-formato del key visual da parte dei team di design — caricando il key visual e i requisiti dei diversi formati, si producono in batch versioni adatte a feed, schermate di avvio e verticali, che entrano direttamente nella libreria dei materiali pubblicitari.
- Rigenerazione contestuale delle immagini prodotto per l'e-commerce — inviando foto reali dei prodotti, si generano immagini finite con sfondi e illuminazioni diverse, da usare per sostituire quelle nelle pagine di dettaglio e negli spazi pubblicitari.
- Iterazione del layout testo-immagine nel design visivo — prendendo come riferimento un layout esistente, si sostituiscono tramite prompt i testi e gli elementi grafici, producendo una nuova versione del progetto da sottoporre a revisione.
- Flussi di compositing che richiedono materiali con sfondo trasparente — abilitando l'output con sfondo trasparente a 1K, il risultato viene sovrapposto direttamente ad altri livelli o scene, eliminando la fase di scontorno manuale.
Limiti e consigli per la scelta
Questa linea produce solo immagini e non riguarda altre modalità come video o testo. Risoluzione e formato sono vincolati tra loro: i rapporti automatici o particolari supportano solo 1K, il formato 1:1 non supporta il 4K e lo sfondo trasparente è disponibile solo a 1K, per cui tra specifiche elevate e controllo dello sfondo occorre operare scelte sui parametri. L'alta risoluzione e i riferimenti multipli aumentano i tempi di generazione e i costi di chiamata, rendendola inadatta a scenari interattivi in tempo reale con requisiti di latenza molto bassi; se serve solo generare da testo senza materiali di riferimento, conviene scegliere la linea di text-to-image della stessa famiglia.
Novità
Vedi il changelog →- Modifica dei parametri gpt-image-2 aggiunge le risoluzioni 1K / 2K / 4K
Domande frequenti
Vedi tutte le domande →-
Che cos'è GPT Image 2?
GPT Image 2 è il modello text-to-image di OpenAI, adatto per poster, card informative, visual di prodotto e per la generazione di immagini con requisiti espliciti di testo e impaginazione.
-
GPT Image 2 e GPT Image 2.0 sono lo stesso modello?
GPT Image 2.0 è un'abbreviazione comunemente usata nelle ricerche; utilizza l'ID esatto del modello elencato nella pagina di GPT Image 2 e nella documentazione API.
-
Quale endpoint e ID modello utilizza l'API GPT Image 2?
Invia una richiesta a POST /v1/tasks, imposta model su gpt-image-2/text-to-image per la generazione di immagini da testo e passa prompt, aspect_ratio e resolution in input. L'API restituisce prima un taskId, poi recupera l'immagine finale tramite la query del task o il callback.
-
Come si usa GPT Image 2?
Nel Playground, specifica il soggetto, la scena, il layout e il testo che deve apparire, quindi seleziona il formato, la risoluzione e lo sfondo, fai clic su Esegui e visualizza il risultato.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: gpt-image-2/image-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per gpt-image-2/image-to-image e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 1maxLength 20000Prompt di testo, obbligatorio, lunghezza massima 20000 caratteri, utilizzato per descrivere il contenuto dell'immagine che si desidera generare.
backgroundstringOpzionaleModalità sfondo, controlla il modo in cui viene gestito lo sfondo dell'immagine generata; questo parametro è supportato solo con risoluzione 1K.
autoopaquetransparentinput_urlsarrayObbligatoriominItems 1maxItems 16Array di URL di immagini di riferimento, fornisce una o più immagini come riferimento per la generazione img2img; supporta da 1 a 16 immagini.
Array [ string ]
resolutionstringOpzionalePredefinito: "1K"Risoluzione dell'immagine generata, predefinita 1K. Quando aspect_ratio è auto è necessario utilizzare 1K; 1:1 non supporta 4K; quando aspect_ratio è 3:1/1:3/9:21 è supportato solo 1K; quando background è auto/opaque/transparent è supportato solo 1K.
1K2K4Kaspect_ratiostringOpzionalePredefinito: "auto"Rapporto larghezza-altezza dell'immagine generata, predefinito auto. Quando il valore è auto o omesso, è supportata solo la risoluzione 1K.
auto1:13:22:34:33:45:44:5Mostra tutto (8)
16:99:162:11:23:11:321:99:21callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentmodelstringObbligatorioValore fisso attuale: gpt-image-2/image-to-image
routestringOpzionaleValore fisso attuale: ext
inputobjectObbligatorio
Oggetto di parametri di business per gpt-image-2/image-to-image e la route ext — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 1maxLength 20000图像编辑提示词 Max 20000 characters.
qualitystringObbligatorioPredefinito: "low"lowmediumhighimage_urlsarrayObbligatoriominItems 1maxItems 6参考图 URL 或 data URI,最多 6 张
Array [ string ]
resolutionstringObbligatorioPredefinito: "1K"1K2K4Kaspect_ratiostringOpzionalePredefinito: "auto"输出画幅比例
auto1:13:22:34:33:45:44:5Mostra tutto (8)
16:99:162:11:23:11:321:99:21callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gpt-image-2/image-to-image",
  "input": {
    "prompt": "…",
    "input_urls": "…",
    "resolution": "1K",
    "aspect_ratio": "auto"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/image-to-image",
input: {
"prompt": "…",
"input_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/image-to-image",
"input": {
"prompt": "…",
"input_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer $HIAPI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2/image-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"image_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}'const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/image-to-image@ext",
input: {
"prompt": "…",
"quality": "low",
"image_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/image-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"image_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Grok Imagine Image 2.0 xAI $0.052 /immagine
-
 FLUX.1 Schnell Black Forest Labs $0.005 /immagine
-
 Qwen Image 3.0 Alibaba $0.036 /immagine
-
 Grok Imagine xAI $0.011 /secondo
-
 Qwen Image 2.0 Alibaba $0.042 /immagine
-
 FLUX 3 Image Black Forest Labs $0.041 /immagine
-
 FASHN Tryon v1.6 FASHN $0.107 /immagine
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /immagine
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Nano Banana Google $0.021 /immagine
-
 Google Virtual Try-On Google $0.107 /immagine
-
 Ideogram V4 Ideogram $0.050 /immagine


