
Alibaba
Qwen Image 3.0
qwen-image-3.0-pro/text-to-image
Modello di terza generazione di Alibaba per la generazione e modifica di immagini, specializzato nella composizione tipografica densa e nel rendering multilingue con prompt lunghi, supporta la modifica tramite immagini di riferimento
Prova qwen-image-3.0-pro/text-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image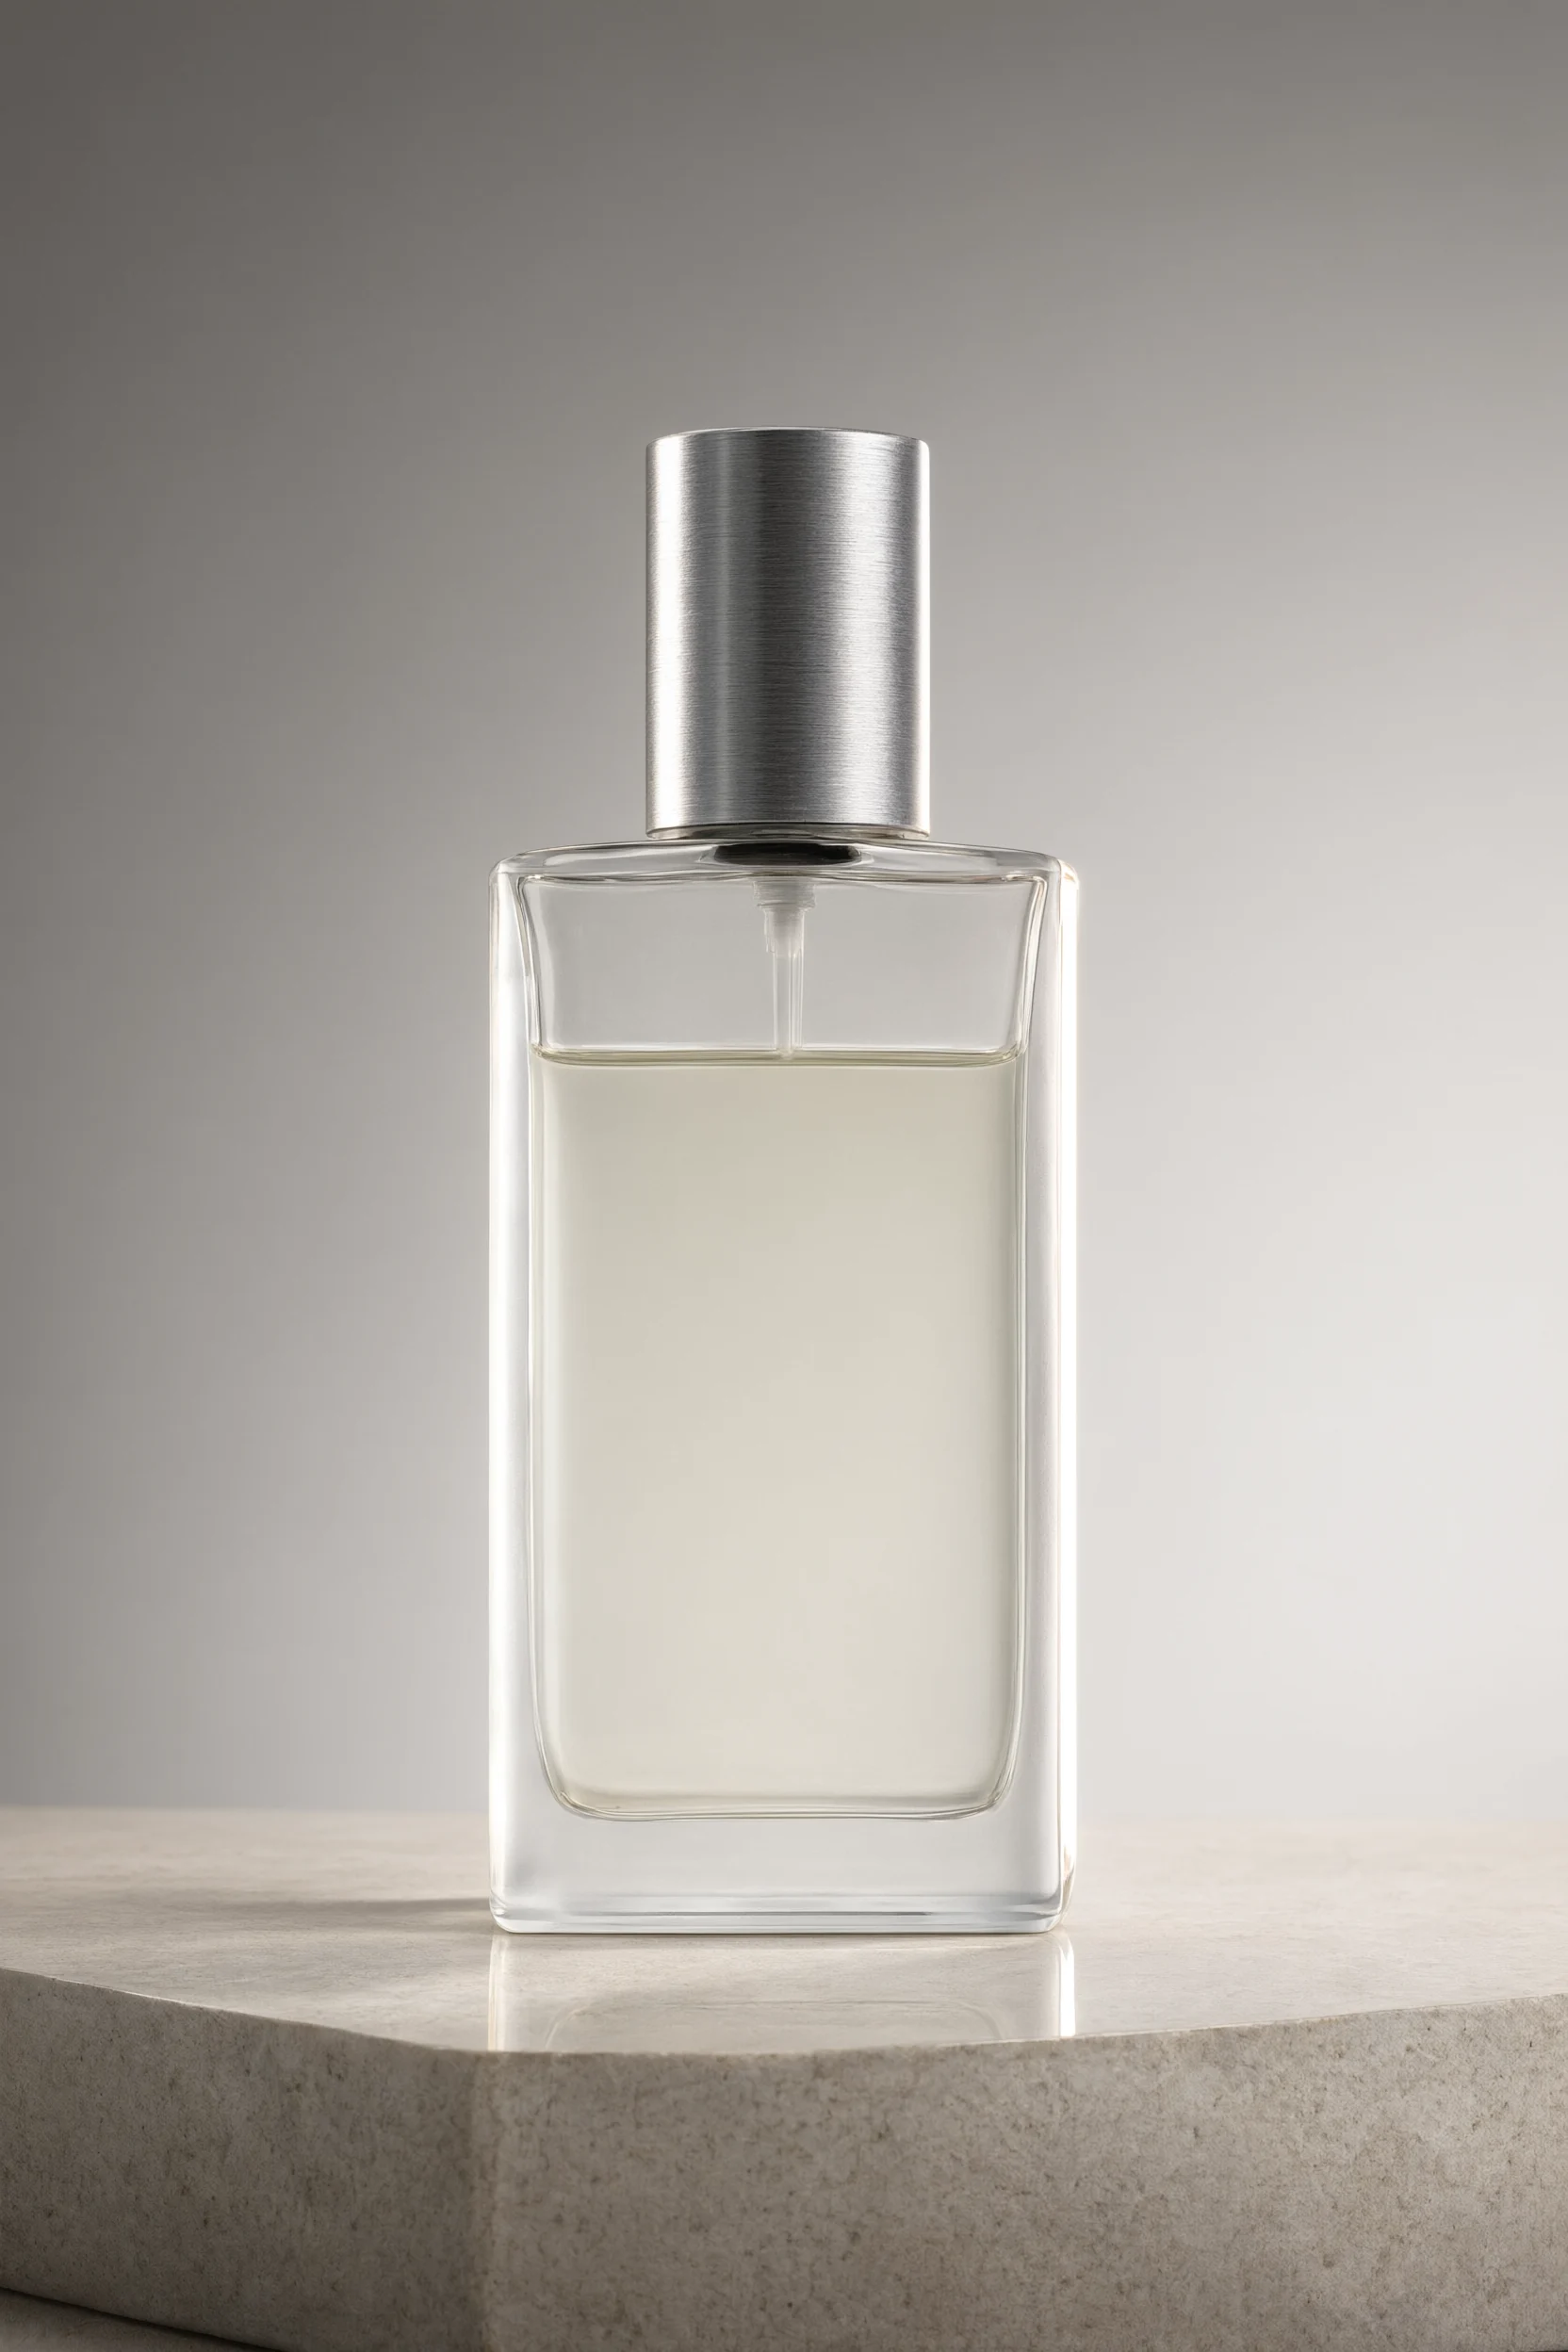
Fotografia di prodotto di livello e-commerce: struttura del prompt e qualità dell'immagine
Stile Immagine del prodotto · ecommerce · Illuminazione da studio
Prompt
Fotografia di prodotto e-commerce: una boccetta di profumo in vetro opaco con tappo in alluminio spazzolato, centrata su un basamento in pietra grigio caldo chiaro. Schema di illuminazione da studio: una grande softbox in alto a sinistra come luce principale crea un morbido riflesso verticale lungo il bordo sinistro della boccetta, una stretta luce di contorno sul lato destro separa la silhouette della boccetta dallo sfondo a gradiente continuo, una debole luce di riempimento frontale garantisce che l'area dell'etichetta sia chiara e leggibile. Sulla superficie in pietra lucidata sono visibili l'ombra di contatto e un leggero riflesso controllato. Scattata con obiettivo macro 85mm a f/8, prodotto completamente a fuoco, distorsione minima, linea di vista leggermente sopra la base della boccetta. Palette neutra a bassa saturazione, con un solo accento di colore a bassa saturazione, spazio bianco pulito in alto per l'impaginazione del testo. Rendering fotorealistico dei materiali: il liquido trasparente presenta una rifrazione corretta, lo spessore del vetro è fine, la superficie metallica mostra una microtrama spazzolata, superficie priva di polvere. Composizione orizzontale 16:9, estetica da catalogo commerciale, alta gamma dinamica, senza testo, senza logo.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
qwen-image-3.0-pro/text-to-image per image
| Specifiche | Prezzo unitario |
|---|---|
| 1K | $0.0497 |
| 2K | $0.0993 |
Panoramica di posizionamento
Qwen Image 3.0 Pro è il modello text-to-image della serie Qwen di Alibaba, incentrato sulla produzione di immagini che veicolano informazioni reali: una singola immagine può ospitare contenuti densi come infografiche, impaginazioni di giornale, concept di interfacce, griglie di prodotti, e rendere testo multilingue con layout corretto. È pensato per gli sviluppatori che devono trasformare in modo affidabile prompt lunghi in asset visivi utilizzabili, ed è adatto alla generazione di immagini in batch per applicazioni di design, contenuti, e-commerce e istruzione.
Punti di forza principali
- I prompt lunghi gestiscono layout complessi — limite del prompt di 18000 caratteri, sufficiente a descrivere impaginazioni multi-blocco, gerarchie e i testi di ciascun blocco.
- Il rendering di testo e impaginazione è il focus — orientato alla generazione di immagini dense di elementi e contenenti testo, riducendo il rifacimento per aggiungere testi e impaginare dopo la generazione.
- Parametri controllabili che coprono le esigenze comuni — supporta proporzioni, risoluzione 1K/2K, formato png/jpeg, prompt negativo e riproducibilità tramite seed.
Descrizione delle capacità
Generazione da prompt testuali lunghi: tramite il campo prompt si passa la descrizione completa dell'immagine, con supporto a spiegazioni estese di layout ed elementi; una singola chiamata produce direttamente l'immagine finita, riducendo l'assemblaggio a più passaggi.
Risoluzione e proporzioni controllate: resolution può essere 1K o 2K, aspect_ratio copre 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16, 21:9, per generare direttamente la dimensione corrispondente al canale di pubblicazione.
Ottimizzazione automatica del prompt e vincoli negativi: prompt_extend è attivo per impostazione predefinita e può completare e ottimizzare automaticamente il prompt; negative_prompt serve a escludere contenuti indesiderati, migliorando la stabilità dell'immagine.
Riproducibilità con seed casuale: è fornito il parametro seed; inserendo un seed da 0 a 2147483647 si può riprodurre lo stesso risultato, utile per confronti nella messa a punto dei parametri e per la stabilità dei processi in batch.
Output diretto nel formato desiderato: output_format supporta png e jpeg, consentendo di scegliere direttamente il formato file in base all'uso a valle, evitando passaggi di transcodifica aggiuntivi.
Scenari di utilizzo
- Team di contenuti: poster e impaginazioni da testi lunghi — inserendo titoli, testi e requisiti di impaginazione nel prompt, si producono poster o impaginazioni in stile giornale con testo, utilizzabili direttamente per pubblicazioni e materiali operativi.
- Sviluppatori di design: generazione di concept di interfaccia — generazione di concept UI e mockup ad alta fedeltà in formato 16:9 o 9:16, come riferimento visivo per la revisione di prodotto e la riproduzione front-end.
- Operatori e-commerce: creazione di immagini di presentazione prodotto — generazione di griglie di prodotti e immagini espositive in 1:1 o 4:3, con seed fisso per produrre in batch materiali marketing dallo stile coerente.
- Ambito educativo: materiali esplicativi con testo e immagini — descrivendo la struttura dei contenuti con prompt lunghi, si generano immagini esplicative con testo e immagini affiancati, per illustrare slide e materiali di formazione.
Limiti e consigli per la scelta
Il modello è posizionato sulla produzione visiva informativa, con immagini dense di elementi e contenenti testo; non è la prima scelta per illustrazioni o creazioni artistiche puramente estetiche. I prompt devono specificare chiaramente impaginazione e testi, richiedendo buone capacità descrittive; la sintesi complessa con più immagini di riferimento non rientra in questa linea (questa linea è solo text-to-image). I risultati dipendono dalla densità dell'impaginazione e dalla lingua; prima della generazione in batch ufficiale occorre validare con un campione e controllare la stabilità tramite seed fisso e prompt negativo.
Novità
Vedi il changelog →- Nuovo modello Nuovo modello disponibile: qwen-image-3.0-pro/text-to-image
- Nuovo modello Lancio del modello image-to-image qwen-image-3.0-pro
- Nuovo modello Aggiunti qwen-image-3.0/text-to-image…
Domande frequenti
Vedi tutte le domande →-
Quante immagini di riferimento supporta l'editor di immagini Qwen Image 3.0?
Supporta da 1 a 3 immagini di riferimento. Ne serve almeno una, il campo API è input.image_urls.
-
Qual è la differenza tra l'editing di immagini Standard e Pro?
La versione Standard privilegia costi contenuti e iterazioni rapide; Pro è più adatta alla sostituzione accurata del testo, ai materiali complessi e al layout finale.
-
Come vengono fatturati 1K, 2K e le immagini di riferimento?
1K e 2K utilizzano lo stesso livello di output; per ogni immagine di riferimento è previsto un costo aggiuntivo. Gli importi esatti sono quelli del prezzo in tempo reale indicato in questa pagina.
-
Come ridurre la deriva del soggetto, del layout o del testo?
Nel Prompt, elenca separatamente i contenuti da modificare e quelli che devono essere preservati: soggetto, testo, posizione, materiale, inquadratura e illuminazione; quando serve un testo accurato, scrivi il testo desiderato tra virgolette.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: qwen-image-3.0-pro/text-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per qwen-image-3.0-pro/text-to-image e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionalemin 0max 2147483647Seme casuale utilizzato per controllare la casualità della generazione; il valore è un numero intero, e lo stesso seme permette di riprodurre risultati di generazione simili.
promptstringObbligatoriominLength 1maxLength 18000Prompt positivo, descrive tramite una stringa il contenuto, lo stile e la composizione dell'immagine desiderata, ed è la base principale per la generazione dell'immagine.
resolutionstringOpzionalePredefinito: "1K"Livello di risoluzione dell'output, specifica tramite una stringa il livello di risoluzione dell'immagine generata, predefinito 1K.
1K2Kaspect_ratiostringOpzionalePredefinito: "1:1"Proporzioni di larghezza e altezza dell'immagine di output, specificate come stringa, predefinito 1:1.
1:13:22:34:33:416:99:1621:9output_formatstringOpzionalePredefinito: "png"Formato del file dell'immagine generata, specificato come stringa, predefinito png.
pngjpegprompt_extendbooleanOpzionalePredefinito: trueIndica se ottimizzare automaticamente il prompt, valore booleano, predefinito true; se attivato, il prompt inserito viene automaticamente ampliato e ottimizzato.
negative_promptstringOpzionalePredefinito: ""maxLength 500Prompt negativo, descrive il contenuto che non si desidera compaia nell'immagine, stringa, predefinito stringa vuota.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-3.0-pro/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "1:1",
    "output_format": "png",
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "qwen-image-3.0-pro/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "qwen-image-3.0-pro/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Muse Image 1.0 Meta $0.015 per task
-
 Qwen Image 3.0 Alibaba $0.036 /immagine
-
 Ideogram V3 Character Ideogram $0.090 /immagine
-
 Grok Imagine Image 2.0 xAI $0.052 /immagine
-
 Recraft Creative Upscale Recraft $0.357 /immagine
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /immagine
-
 FIBO 1.5 Bria $0.058 /immagine
-
 FLUX 3 Image Black Forest Labs $0.041 /immagine
-
 Recraft V4.1 Recraft $0.010 /immagine
-
 FLUX.1 Schnell Black Forest Labs $0.005 /immagine
-
 BRIA Eraser Bria $0.058 /immagine
-
 BRIA Product Shot Bria $0.058 /immagine
Stesso fornitore
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Wan 3.0 Video Alibaba $0.040 /secondo
-
 Z-Image Alibaba $0.008 /immagine
-
 Qwen Image 2.0 Alibaba $0.042 /immagine
-
 HappyHorse 1.0 Alibaba $0.168 /secondo
-
 Wan 2.6 Flash Alibaba $0.043 /secondo
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caratteri
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Wan 2.7 Video Alibaba $0.100 /secondo
- Qwen Image 3.0 Alibaba $0.036 /immagine