
Runway
Runway Gen 4.5
runway-gen-4.5/image-to-video
Al momento della pubblicazione è in cima alla classifica di generazione video da testo di Artificial Analysis con 1247 Elo, con prestazioni eccellenti nel rispetto dei prompt, nella fisica e nel movimento del corpo umano, ideale per la creazione di storyboard cinematografici e brevi video di brand
Prova runway-gen-4.5/image-to-video
Input
Creazioni
Vedi tutte le creazioniOutput
videoRunway Gen-4.5 capacità di image-to-video illustrate: dal primo frame alla ripresa controllabile
Stile Immagine in video · Cinematografico · demo-capacità
Input di riferimento
image_urls
Prompt
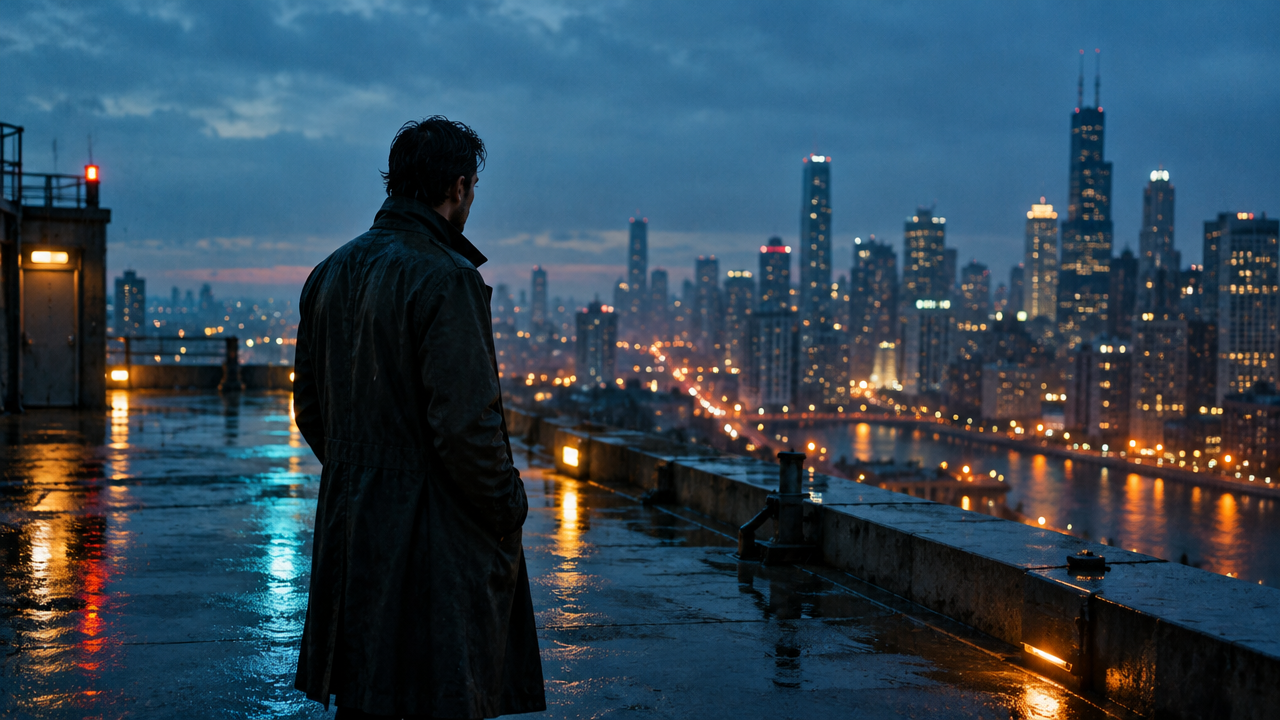
Nell'ora blu, la macchina da presa avanza lentamente verso una figura sola in piedi sul bordo di un tetto bagnato dalla pioggia, la cinepresa si trova all'altezza del petto e avanza con una leggera angolazione verso l'alto, profondità di campo ridotta, le luci della città in lontananza si sfocano in bokeh, una pioggia sottile attraversa l'inquadratura, il tessuto del cappotto si solleva in un vento costante, movimento fluido e continuo, ritmo stabile, qualità cinematografica fotorealistica, ombre fredde color verde acqua in contrasto con le calde luci al sodio.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Dal testo all'immagine: video concettuale di storyboard con primo fotogramma Gen-4.5
Stile Storyboard · Cinematografico · Immagine in video
Input di riferimento
image_urls
Prompt
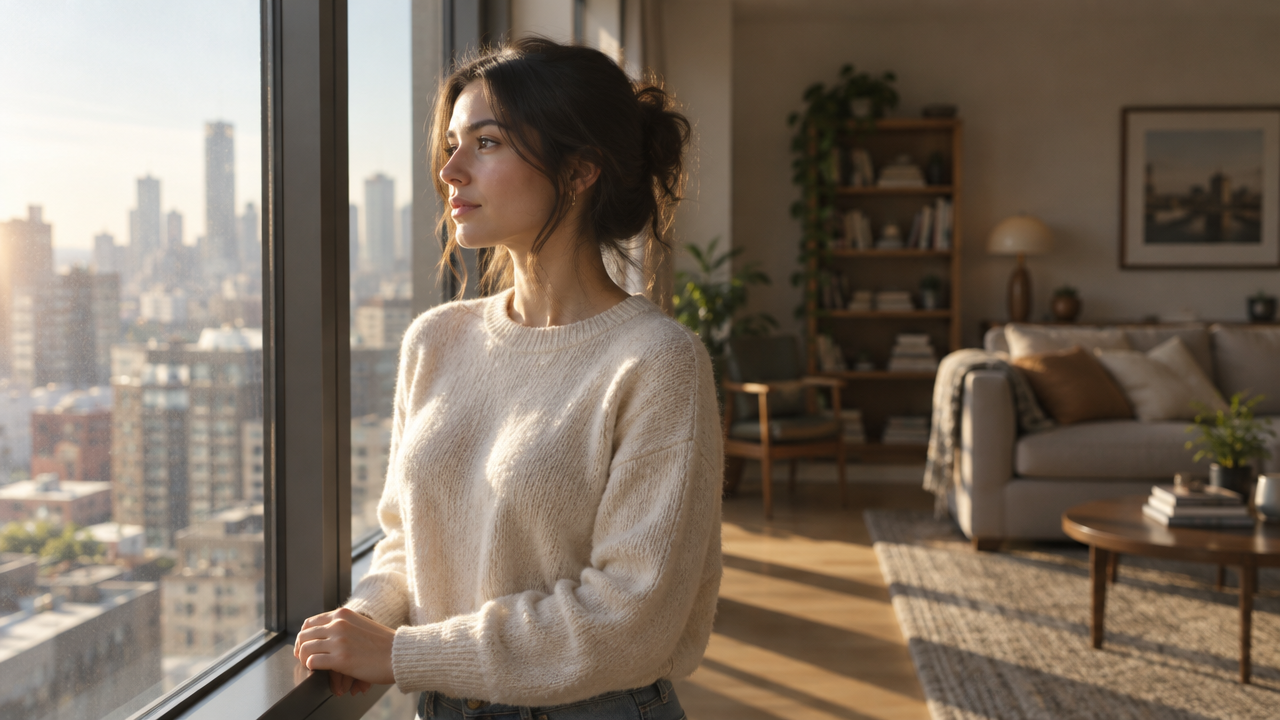
Interno di un appartamento silenzioso, ripresa cinematografica a piano medio, una giovane donna con un maglione in maglia chiaro sta in piedi davanti a un'alta finestra, la luce del mattino le sfiora obliquamente il viso. La camera avanza lentamente da un'inquadratura alla vita verso un primo piano sopra il petto, con profondità di campo ridotta e i mobili sullo sfondo dolcemente sfocati. Lei gira la testa verso la finestra e solleva una mano per sistemare la tenda; il tessuto ondeggia leggermente con un peso naturale. Leggero tremolio da camera a mano, color grading caldo e neutro, luce principale morbida dalla finestra con una delicata caduta di luce, grana fine della pellicola, formato 16:9.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Scheda formula dei prompt per video da immagine Runway Gen-4.5
Stile Motion design · Spiegazione · Cinematografico
Input di riferimento
image_urls
Prompt
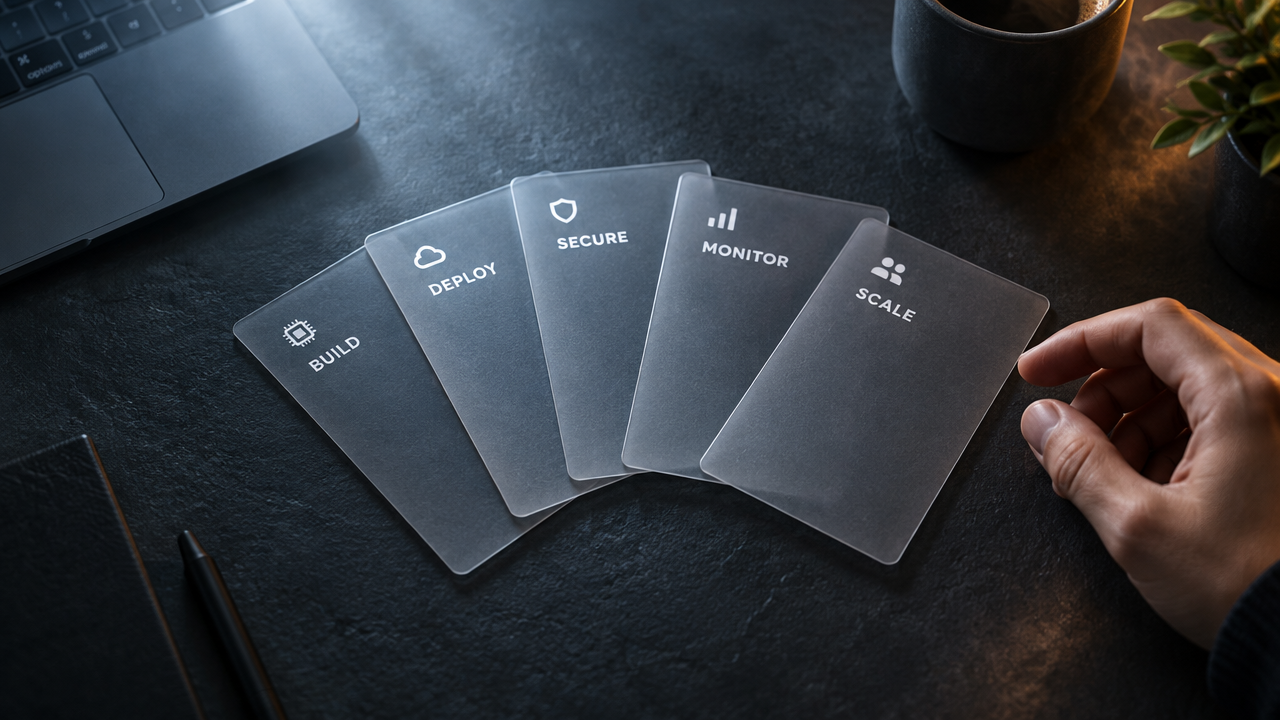
Movimento di camera lento e controllato: su un tavolo in ardesia scura, un'inquadratura fissa dall'alto che avanza leggermente, con un mazzo di schede traslucide disposte a ventaglio, ciascuna con un'etichetta ben visibile. Una mano entra da destra e spinge in avanti sulla superficie la scheda in cima; la scheda si ferma, accompagnata da un morbido spostamento parallattico, mentre un sottile riflesso luminoso ne sfiora il bordo. Profondità di campo ridotta, schede nitide, sfondo che si dissolve nell'ombra. Luce fredda, luce principale direzionale dall'alto a sinistra con un tocco di luce di contorno calda e una leggera nebbia volumetrica. Movimento fermo e meccanico, senza tremolii di camera, senza tagli, un'unica ripresa continua, 5 secondi, atmosfera tecnica misurata, ritmo da film di prodotto in stile magazine.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
runway-gen-4.5/image-to-video per second
| Prezzo unitario | $0.1715 |
|---|
Panoramica della posizione
Linea image-to-video di Runway Gen-4.5: partendo da un'immagine del primo frame, insieme a una descrizione di azioni e movimenti di camera, genera video da 5, 8 o 10 secondi. Prosegue i punti di forza della serie in termini di aderenza ai prompt e qualità del movimento, ed è adatta a scenari di previsualizzazione cinematografica, pubblicità ed esplorazione progettuale in cui occorre estendere immagini di riferimento, concept o immagini di prodotto in riprese dinamiche; si richiama tramite l'interfaccia unificata di HiAPI.ai e la fatturazione avviene in base ai secondi di output.
Punti di forza principali
- Il primo frame ancora il punto di partenza dell'immagine——una singola immagine come input del primo frame; l'output si sviluppa da quell'immagine, riducendo la deriva compositiva tipica della generazione da solo testo.
- Durata e formato regolabili in base alle esigenze di consegna——supporta tre durate (5, 8, 10 secondi) e cinque rapporti d'aspetto; l'immagine del primo frame viene ritagliata al centro secondo il rapporto scelto.
- Il prompt descrive il movimento, non ridisegna l'immagine——il prompt si concentra sulla descrizione di azioni e posizione della camera; il soggetto dell'immagine è determinato dal primo frame, con una chiara divisione dei compiti tra istruzioni e immagine.
Descrizione delle capacità
Generazione video guidata dal primo frame: carica un'immagine jpeg, png o webp come primo frame (massimo 10MB); il modello genera da essa un video dinamico, adatto a fasi produttive in cui la composizione è già definita e occorre completare il movimento.
Controllo delle istruzioni di movimento e camera: il prompt serve a descrivere azioni e movimenti di camera, con una lunghezza massima di 1000 caratteri, così da poter inserire direttamente nei parametri di generazione le posizioni di camera e le intenzioni di regia dello storyboard.
Durata e formato parametrizzati: è possibile scegliere durate di 5, 8 o 10 secondi e formati 16:9, 9:16, 4:3, 3:4, 1:1, coprendo esigenze di distribuzione orizzontale, verticale e quadrata.
Scenari di utilizzo
- Storyboarder per cinema e pubblicità: generare riprese di previsualizzazione da immagini chiave——usare il frame chiave dello storyboard come primo frame per generare clip di previsualizzazione di più secondi con movimento di camera, utili per approvazioni interne e conferma del ritmo delle riprese.
- Design di brand ed e-commerce: trasformare immagini di prodotto in presentazioni dinamiche——generare brevi video usando l'immagine di riferimento del prodotto come primo frame, per pagine di dettaglio, inserzioni nei feed e altri spazi verticali o quadrati.
- Team di concept design: esplorare l'espressione dinamica di bozze statiche——estendere i concept in brevi clip dinamiche per confrontare rapidamente diverse soluzioni di movimento prima di decidere la direzione da avviare alla produzione ufficiale.
Limiti e consigli di selezione
In quanto linea image-to-video, il soggetto dell'immagine è determinato dal primo frame e il prompt controlla solo movimento e camera, senza poter modificare composizione e contenuto del primo frame; il primo frame supporta solo una singola immagine e non include SVG. L'ordine causale e la coerenza degli oggetti tra i frame possono ancora presentare deviazioni in riprese complesse; per riprese che richiedono grandi cambiamenti di composizione o narrazioni su lunghe sequenze temporali si consiglia di suddividerle e prevedere costi di rigenerazione, oppure di passare a un metodo di generazione più adatto.
Domande frequenti
Vedi tutte le domande →-
Quali sono i requisiti per l'immagine del primo frame?
Una per volta, in formato jpeg, png o webp, con una dimensione massima di 10MB per immagine; SVG non è supportato. È preferibile che le proporzioni dell'immagine corrispondano a quelle del formato di output; se le proporzioni sono diverse, il primo frame viene ritagliato centralmente, quindi è più sicuro posizionare il soggetto al centro.
-
È possibile aggiungere un frame finale?
No, questo modello utilizza solo un frame iniziale; l'immagine finale è determinata dal prompt e dal modello. Se hai bisogno di specificare l'immagine finale, puoi usare Kling 2.5 Turbo Image-to-Video, che supporta un frame finale opzionale.
-
Quali formati e durate posso scegliere? Qual è la risoluzione?
Formati 16:9, 9:16, 4:3, 3:4, 1:1, predefinito 16:9; durate 5, 8, 10 secondi, disponibili per ogni formato, predefinito 5 secondi; risoluzione uniforme 720p.
-
I video generati hanno l'audio?
Non c'è traccia audio, il video finale contiene solo le immagini; la musica e la voce fuori campo vengono aggiunte in fase di montaggio.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: runway-gen-4.5/image-to-video
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per runway-gen-4.5/image-to-video e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 1maxLength 1000Prompt testuale che descrive il movimento dell'immagine e il movimento della telecamera, fornito come stringa, massimo 1000 caratteri.
durationintegerOpzionalePredefinito: 5min 5max 10Durata del video generato, espressa come numero intero, in secondi, valore predefinito 5.
5810image_urlsarrayObbligatoriominItems 1maxItems 1Array di immagini del primo fotogramma, l'array contiene un solo elemento, che è l'URL dell'immagine; supporta i formati jpeg/png/webp, dimensione massima 10MB per immagine, SVG non supportato.
Array [ string ]
aspect_ratiostringOpzionalePredefinito: "16:9"Proporzioni del video in uscita, fornite come stringa, valore predefinito 16:9; l'immagine del primo fotogramma viene ritagliata al centro secondo queste proporzioni.
16:99:164:33:41:1callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "runway-gen-4.5/image-to-video",
  "input": {
    "prompt": "…",
    "duration": 5,
    "image_urls": "…",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "runway-gen-4.5/image-to-video",
input: {
"prompt": "…",
"duration": 5,
"image_urls": "…",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "runway-gen-4.5/image-to-video",
"input": {
"prompt": "…",
"duration": 5,
"image_urls": "…",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Vidu Q4 Preview Vidu $0.051 /secondo
-
 PixVerse V6 PixVerse $0.036 /secondo
-
 Wan 3.0 Video Alibaba $0.040 /secondo
-
 Wan 2.6 Flash Alibaba $0.043 /secondo
-
 Kling 3.0 Kuaishou $0.100 /secondo
-
 Veo 3.1 Google $0.290 /secondo
-
 Hailuo 2.3 MiniMax $0.270 /video
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 Kandinsky 6.0 Pro $1.93 /video
-
 Seedance 2.5 ByteDance $0.121 /secondo
-
 Kling AI Avatar Kuaishou --
-
 HappyHorse 1.0 Alibaba $0.168 /secondo