
Tutorial
Automação de pedidos no n8n: tutorial de integração com a Claude API
Monte um pipeline de processamento automático de novos pedidos com o n8n: a IA identifica a intenção e gera respostas, pedidos comuns são respondidos automaticamente e reclamações são escaladas para atendimento humano
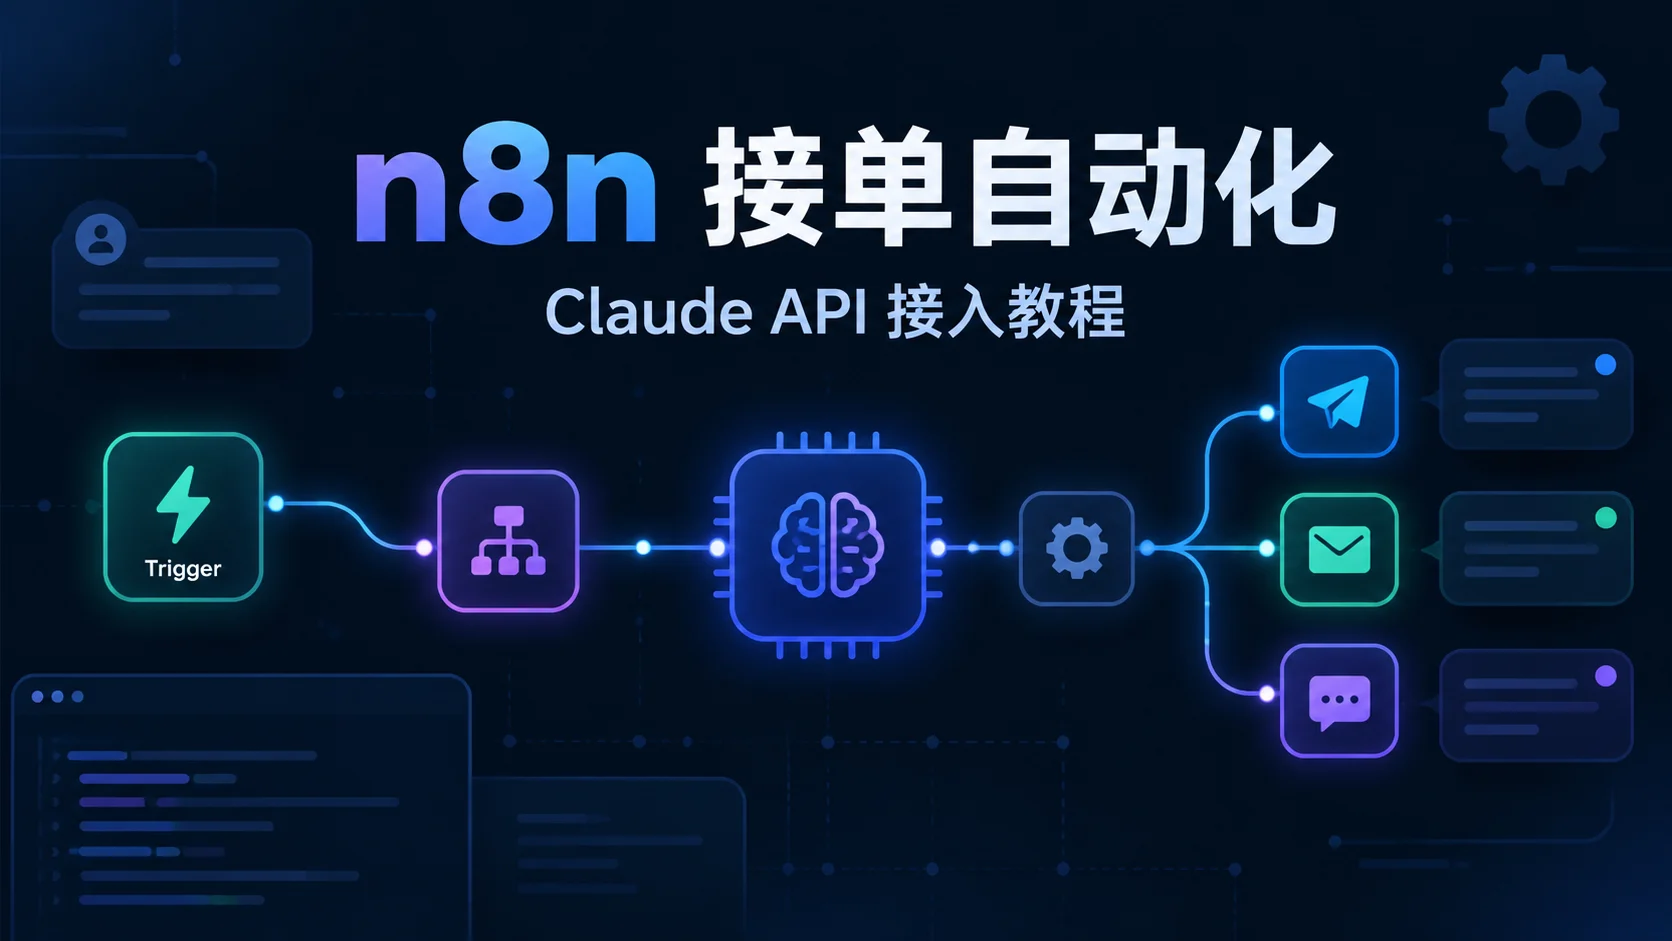
Cenário: responder mensagens de pedidos manualmente todos os dias, sem dar conta
Em negócios locais como restaurantes, varejo e compras coletivas de bairro, as mensagens de pedidos chegam quase sempre pelo WeChat, por formulários ou pelo painel da loja. O padrão é fixo: chega um novo pedido, dá-se uma olhada no conteúdo, verifica-se se é um pedido normal ou uma reclamação, e então se envia uma mensagem de confirmação. Com pouco volume, tudo bem; quando o volume aumenta, a maior parte do tempo é gasta em respostas repetitivas.
O objetivo deste tutorial é bem específico: montar um pipeline de automação com o n8n em que, ao chegar um novo pedido, a IA identifica automaticamente a intenção e gera a resposta, pedidos comuns são respondidos de imediato e pedidos de reclamação são encaminhados para uma pessoa, junto com uma notificação. Em todo o processo não se escreve código; para conectar o modelo basta uma API key da HiAPI.
Desde 2026, o n8n vem sendo recomendado repetidamente a pequenos e médios comerciantes em várias análises de ferramentas de automação (como as listas anuais de 2026 da Atlassian e da techaigoz), por motivos diretos: auto-hospedagem, código aberto e um ecossistema maduro de nós para LLM. Em outubro de 2026, um post no X sobre o uso do n8n para automatizar o recebimento de pedidos de pequenos comerciantes locais alcançou cerca de 51 mil visualizações em uma única publicação, o que mostra que essa necessidade já é muito comum.
Preparação: uma key da HiAPI + um n8n
Antes de começar, você só precisa de duas coisas.
Primeiro, a API key da HiAPI. Crie e copie no console da HiAPI; o formato começa com sk-. Essa key é compatível com OpenAI, e todos os modelos usados no n8n passarão por ela.
Segundo, o n8n. Pode ser a versão em nuvem ou auto-hospedada; este artigo não exige um tipo de implantação específico. O único requisito é não usar uma versão muito antiga, pelo motivo explicado abaixo.
O passo central: conectar o nó OpenAI Chat Model à HiAPI
O ponto-chave de todo o pipeline é fazer o n8n se conectar ao modelo. O procedimento é mais simples do que parece: no sistema de nós de IA do n8n existe um subnó OpenAI Chat Model, cuja Credential tem um campo Base URL; basta preencher o endpoint compatível com OpenAI e a API Key para usar (esse recurso já era discutido na comunidade do n8n, veja o post da comunidade Override baseURL for OpenAI Node).
Preencha três coisas:
- Base URL:
https://api.hiapi.ai - API Key: sua key da HiAPI (começa com
sk-) - Model: preencha manualmente
deepseek-v4.1-flash
Atenção a dois pontos. Primeiro, use o subnó OpenAI Chat Model do sistema de nós de IA, não o nó OpenAI antigo. Segundo, o campo Base URL só existe em versões mais recentes do n8n; algumas versões antigas não têm esse campo, então atualize o n8n para uma versão mais recente antes de configurar.
Depois de preencher, todos os nós de IA do workflow compartilham essa mesma Credential. Para trocar de modelo depois, basta alterar o campo Model; por exemplo, para o cenário de reclamações, troque para claude-opus-4-8, sem mexer na key.
Com isso, o modelo está conectado. A seguir vem o próprio workflow.
As quatro etapas do workflow
Todo o pipeline é composto por quatro nós em sequência: gatilho Webhook, classificação e elaboração de resposta pela IA, ramificação IF e notificação.
1. Gatilho Webhook
Use o nó Webhook como entrada; quando o sistema de pedidos (formulário, painel da loja, bot intermediário) tiver um novo pedido, ele faz POST do conteúdo da mensagem para esse endereço. O texto do pedido recebido pelo gatilho é passado para o nó de IA seguinte.
Se ainda não houver integração com sistema, você pode primeiro usar o nó de gatilho por formulário do n8n para simular manualmente novos pedidos, validar o fluxo e depois trocar pela fonte de dados real.
2. Nó de IA: classificação + elaboração de resposta
Conecte um nó AI Agent (ou um nó Chain simplificado), anexe a Credential OpenAI Chat Model configurada anteriormente e preencha o modelo com deepseek-v4.1-flash. O prompt de sistema é responsável por duas coisas: determinar se a mensagem é um pedido normal ou uma reclamação e, em seguida, elaborar uma resposta no tom do comerciante para cada caso.
Abaixo há um prompt de sistema pronto para usar; basta substituir pelo nome da sua loja e seu segmento para rodar:
Você é um assistente de recebimento de pedidos de um comerciante local de alimentos e bebidas. Processe cada mensagem do usuário conforme as regras abaixo:

1. Primeiro, determine o tipo da mensagem:
   - Pedido normal: o usuário faz um pedido explícito, incluindo produto, quantidade, endereço ou forma de retirada
   - Reclamação: o usuário expressa insatisfação com o produto ou serviço, pede reembolso ou faz uma reclamação
   - Outros: perguntas sobre horário de funcionamento, cardápio etc. que não exigem resposta imediata

2. Em seguida, gere a resposta conforme o tipo:
   - Pedido normal: confirme o conteúdo do pedido no tom do comerciante, repita os produtos e quantidades, informe o tempo estimado de preparo ou entrega, com tom acolhedor e natural
   - Reclamação: primeiro expresse desculpas e atenção, informe que o caso será tratado por uma pessoa o quanto antes, não prometa um plano de compensação específico
   - Outros: responda normalmente à pergunta do usuário

3. O formato de saída deve ser estritamente JSON, com dois campos:
   - category: order / complaint / other
   - reply: o texto da resposta elaborada

Emita apenas o JSON, sem nenhuma explicação.
Exigir que a IA produza JSON estruturado é o ponto principal, para que a ramificação IF seguinte possa decidir de forma estável. Se ocasionalmente a saída não estiver no padrão, adicione após o nó de IA uma etapa simples de limpeza de dados como segurança.
3. Ramificação IF: pedidos comuns respondidos automaticamente, reclamações escaladas para humano
Use um nó IF para ler o campo category:
orderouother: segue para resposta automática, enviando o texto dereplyde volta ao cliente pelo seu canal de notificação (bot de WeChat, e-mail ou SMS, dependendo do que você conectou)complaint: não responde automaticamente; empacota o texto original do pedido e o resultado da classificação e envia uma notificação ao dono da loja ou à pessoa de plantão, com uma sugestão de abordagem, aguardando alguém assumir
Essa divisão é o valor de todo o pipeline. A IA resolve a maior parte das mensagens repetitivas de confirmação, e as pessoas cuidam apenas das reclamações, que exigem discernimento e empatia.
4. Nó de notificação
Por fim, conecte um nó de notificação para enviar o resultado do processamento à sua ferramenta de colaboração (Feishu, WeChat ou e-mail, tanto faz). Para pedidos comuns, notifique que a resposta foi enviada automaticamente; para reclamações, notifique com as informações completas do pedido e marque como pendente de atendimento humano. Assim, mesmo sem acompanhar o histórico de execução do pipeline, você sabe em tempo real o que está acontecendo na loja.
Controle de custos: flash no fluxo comum, opus nos casos complexos
Escolher o modelo por tarefa é a chave para controlar custos nesse fluxo; não é necessário usar o mais caro em todas as requisições.
- Classificação e resposta comuns usam deepseek-v4.1-flash, entrada US$ 0,44 / milhão de tokens e saída US$ 1,32 / milhão de tokens (preço da plataforma HiAPI, até 2026-10). Mensagens de pedido geralmente têm algumas centenas de tokens, então o custo de modelo por pedido é muito baixo, estimado em menos de 1 centavo de dólar
- Análise de reclamações, resumos de contexto longo e outros cenários complexos passam a usar claude-opus-4-8, entrada US$ 2,29 / milhão de tokens e saída US$ 11,47 / milhão de tokens (até 2026-10). Como as reclamações são uma parcela pequena, o impacto no custo total é limitado
Sobre preços, paramos por aqui; para detalhes, veja a página do modelo. Se quiser entender melhor por que escolher o modelo por tarefa economiza custos, veja o que escrevemos antes em Práticas de roteamento automático do Notion AI, que traz a ideia completa de distribuir requisições para modelos diferentes conforme a tarefa, a mesma lógica do cenário de pedidos deste artigo.
FAQ
É seguro colocar a API key no n8n?
A key deve ser preenchida na Credential do n8n, não gravada diretamente nos parâmetros do nó nem no código. A Credential é armazenada criptografada pelo n8n, e a key não é exportada ao compartilhar o workflow. Além disso, recomenda-se definir no console da HiAPI um limite de uso para essa key; mesmo em caso de vazamento, a perda fica controlada.
O que fazer ao receber 429 (requisições excessivas)?
O 429 indica que o limite de taxa foi atingido. Primeiro verifique se houve uma grande quantidade de pedidos enviada em lote em pouco tempo; você pode aumentar o intervalo do gatilho ou adicionar fila ao nó de IA. Se persistir, consulte no console da HiAPI as configurações de concorrência e cota da key atual e, se necessário, ajuste o plano. No workflow, também é possível configurar uma política de retry no nó de IA para, ao receber 429, aguardar e tentar novamente.
É possível trocar por outro modelo?
Sim. Basta trocar o campo Model pelo nome de qualquer modelo da HiAPI; por exemplo, pedidos comuns com deepseek-v4.1-flash e reclamações com claude-opus-4-8, sem alterar a key nem a Base URL. Uma key serve para todos os modelos, e é justamente essa a praticidade de usar a HiAPI em vez de solicitar uma key oficial de cada fornecedor.
Qual é a diferença em relação a solicitar diretamente as API keys oficiais?
Principalmente dois pontos. Primeiro, uma key da HiAPI cobre vários modelos, sem precisar registrar-se, recarregar e gerenciar cotas separadamente em cada plataforma oficial. Segundo, a cobrança por uso é unificada, o que é mais vantajoso para cenários em que o volume de chamadas se distribui entre vários modelos. Para pequenos e médios comerciantes, o custo de gestão importa mais do que a diferença de preço unitário.
Não haver suporte a streaming é um problema?
Não. Este pipeline processa pedidos de forma assíncrona; a IA gera a resposta e retorna de uma vez, sem a necessidade de exibição caractere por caractere como em uma interface de chat. Com ou sem streaming, o resultado não muda.
E se não houver o campo Base URL no n8n?
Isso indica que a versão do n8n usada é muito antiga. Base URL é um parâmetro do subnó OpenAI Chat Model do sistema de nós de IA, disponível apenas em versões mais recentes. Atualize o n8n para uma versão mais recente e depois siga os passos de configuração da Credential acima.
Conclusões principais
- A integração consiste em alterar um único ponto da Credential: preencher Base URL com
https://api.hiapi.ai, API Key com a key da HiAPI e o nome do modelo manualmente comdeepseek-v4.1-flash, sem escrever código. - A classificação e a elaboração da resposta são feitas na mesma chamada de IA, com formato de saída JSON estrito, para que a ramificação IF seguinte decida de forma estável.
- Pedidos comuns são respondidos automaticamente; reclamações são sempre escaladas para atendimento humano, e essa fronteira é imposta pela ramificação IF.
- Gaste conforme a dificuldade: pedidos comuns usam flash, mensagens difíceis passam para
claude-opus-4-8, com a mesma key e apenas trocando o nome do modelo. - A key fica na Credential do n8n para gestão unificada; ao receber 429, faça retry com atraso; trocar de modelo é uma alteração em um único ponto.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado