
Tutoriale
Automazione degli ordini con n8n: guida all'integrazione dell'API Claude
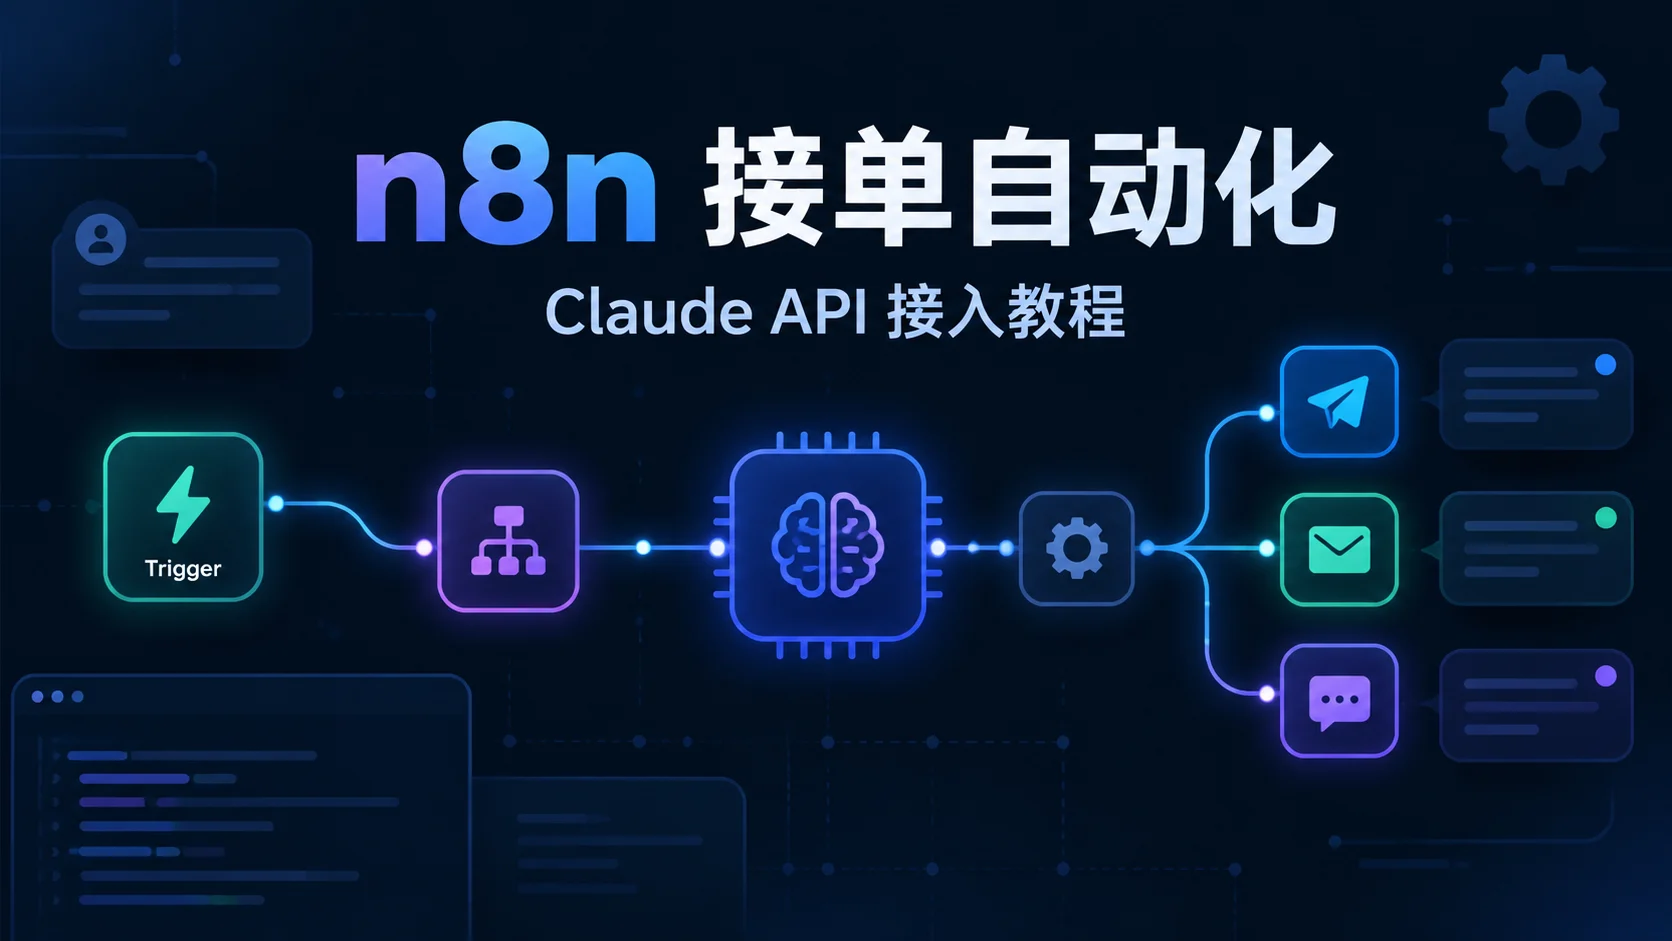
Crea una pipeline automatizzata per i nuovi ordini con n8n: l'AI individua l'intento e genera la risposta, gli ordini normali ricevono risposta automatica, i reclami vengono inoltrati a un operatore
Scenario: rispondere ogni giorno a mano ai messaggi degli ordini, impossibile starci dietro
In attività locali come ristorazione, retail e gruppi d'acquisto di quartiere, i messaggi degli ordini arrivano quasi tutti su WeChat, nei moduli o nel back office del negozio. Lo schema è sempre lo stesso: arriva un nuovo ordine, si dà un'occhiata al contenuto, si stabilisce se è un ordine normale o un reclamo, poi si risponde con un messaggio di conferma. Con pochi ordini non è un problema, ma appena il volume cresce la maggior parte del tempo si consuma in risposte ripetitive.
L'obiettivo di questa guida è concreto: costruire con n8n una pipeline automatizzata in cui, all'arrivo di un nuovo ordine, l'AI individua automaticamente l'intento e genera la risposta; gli ordini normali ricevono risposta automatica, i reclami vengono inoltrati a una persona con una notifica. Tutto senza scrivere codice: per collegare il modello basta una API key di HiAPI.
Dal 2026, n8n è stato più volte consigliato alle piccole e medie imprese in diverse rassegne di strumenti di automazione (come le rassegne annuali 2026 di Atlassian e techaigoz), per motivi semplici: self-hosting, open source e un ecosistema maturo di nodi LLM. Nell'ottobre 2026, un post su X che mostrava l'uso di n8n per l'automazione degli ordini per piccoli esercenti locali ha totalizzato circa 51.000 visualizzazioni in un solo post, segno che questa esigenza è ormai molto diffusa.
Preparazione: una key di HiAPI + un'istanza n8n
Prima di iniziare servono solo due cose.
Primo, la API key di HiAPI. Creala e copiala dalla console HiAPI: inizia con sk-. Questa key è compatibile con OpenAI e tutti i modelli in n8n la useranno.
Secondo, n8n. Va bene sia la versione cloud sia quella self-hosted: questa guida non impone un metodo di deploy. L'unico requisito è non usare una versione troppo vecchia, e il motivo lo spieghiamo più avanti.
Il passaggio chiave: collegare il nodo OpenAI Chat Model a HiAPI
Il punto cruciale dell'intera pipeline è far connettere n8n al modello. È più semplice di quanto sembri: nell'ecosistema di nodi AI di n8n esiste un sotto-nodo OpenAI Chat Model, la cui Credential include un campo Base URL: basta inserire l'endpoint compatibile con OpenAI e la API Key (questa possibilità è discussa da tempo nella community di n8n, vedi il post della community Override baseURL for OpenAI Node).
Nello specifico vanno compilati tre campi:
- Base URL:
https://api.hiapi.ai - API Key: la tua key di HiAPI (inizia con
sk-) - Model: inserisci manualmente
deepseek-v4.1-flash
Attenzione a due cose. Primo, va usato il sotto-nodo OpenAI Chat Model dell'ecosistema di nodi AI, non il vecchio nodo OpenAI. Secondo, il campo Base URL esiste solo nelle versioni più recenti di n8n: alcune versioni vecchie non lo hanno, quindi aggiorna n8n a una versione più recente prima di configurare.
Fatto questo, tutti i nodi AI del workflow condividono questa unica Credential. Per cambiare modello in seguito basta modificare il campo Model, ad esempio passando a claude-opus-4-8 per i reclami, senza toccare la key.
A questo punto il modello è collegato. Passiamo al workflow vero e proprio.
Il workflow in quattro passaggi
La pipeline è composta da quattro nodi in sequenza: trigger Webhook, classificazione e bozza di risposta con l'AI, diramazione IF, notifica.
1. Trigger Webhook
Usa il nodo Webhook come ingresso: quando il sistema ordini (modulo, back office del negozio, bot intermedio) riceve un nuovo ordine, invia il contenuto del messaggio in POST a questo indirizzo. Il testo dell'ordine ricevuto dal trigger viene passato al successivo nodo AI.
Se al momento non hai un sistema da collegare, puoi simulare manualmente i nuovi ordini con il nodo di trigger da modulo di n8n, verificare il flusso e poi passare ai dati reali.
2. Nodo AI: classificazione + bozza di risposta
Aggiungi un nodo AI Agent (o un nodo Chain semplificato), collegagli la Credential OpenAI Chat Model configurata poco fa e inserisci deepseek-v4.1-flash come modello. Il prompt di sistema si occupa di due cose: stabilire se il messaggio è un ordine normale o un reclamo, e poi redigere una risposta nel tono del negoziante per ciascun caso.
Qui sotto c'è un prompt di sistema pronto all'uso: basta sostituire il nome del tuo negozio e la categoria merceologica per iniziare:
Sei l'assistente per gli ordini di un ristorante locale. Elabora ogni messaggio dell'utente secondo queste regole:

1. Prima determina il tipo di messaggio:
   - Ordine normale: l'utente ordina chiaramente, indicando prodotti, quantità, indirizzo o modalità di ritiro
   - Reclamo: l'utente esprime insoddisfazione per prodotti o servizi, chiede un rimborso o presenta un reclamo
   - Altro: domande su orari di apertura, menù e altri contenuti che non richiedono risposta immediata

2. Poi genera la risposta in base al tipo:
   - Ordine normale: nel tono del negoziante, conferma il contenuto dell'ordine, ripeti prodotti e quantità, indica i tempi previsti di preparazione o consegna, con tono cordiale e naturale
   - Reclamo: esprimi prima scuse e attenzione, spiega che una persona interverrà al più presto, senza promettere soluzioni di risarcimento specifiche
   - Altro: rispondi normalmente alla domanda dell'utente

3. Il formato di output deve essere rigorosamente JSON, con due campi:
   - category: order / complaint / other
   - reply: il testo della risposta redatta

Restituisci solo il JSON, senza alcuna spiegazione.
Chiedere all'AI un output JSON strutturato è il punto essenziale: solo così la diramazione IF successiva può valutare in modo stabile. Se ogni tanto l'output non è conforme, aggiungi dopo il nodo AI un semplice passaggio di pulizia dati come rete di sicurezza.
3. Diramazione IF: risposta automatica per gli ordini normali, escalation umana per i reclami
Usa un nodo IF per leggere il campo category:
orderoother: risposta automatica, invia il testo direplyal cliente tramite il tuo canale di notifica (bot WeChat, email o SMS, a seconda di cosa hai collegato)complaint: nessuna risposta automatica, invia al titolare o al personale di turno il testo originale dell'ordine e il risultato della classificazione, con una proposta di risposta suggerita, in attesa che qualcuno prenda in carico
Questa suddivisione è il valore dell'intera pipeline. L'AI gestisce la maggior parte dei messaggi di conferma ripetitivi; le persone si occupano solo dei reclami, che richiedono capacità di giudizio ed empatia.
4. Nodo di notifica
Infine aggiungi un nodo di notifica che invii l'esito all'interno del tuo strumento di collaborazione (Feishu, WeChat o email, vanno tutti bene). Per gli ordini normali notifica che è stata inviata una risposta automatica; per i reclami notifica le informazioni complete dell'ordine contrassegnandolo come in attesa di intervento umano. Così, anche senza tenere d'occhio il registro di esecuzione della pipeline, sai in tempo reale cosa succede nel negozio.
Controllo dei costi: flash per la routine, opus per i casi complessi
Scegliere il modello in base al compito è la chiave per contenere i costi di questo flusso: non ha senso usare il modello più costoso per tutte le richieste.
- Classificazione e risposte ordinarie con deepseek-v4.1-flash, input $0,44 / milione di token, output $1,32 / milione di token (prezzo della piattaforma HiAPI, aggiornato a 2026-10). I messaggi degli ordini sono in genere di poche centinaia di token: il costo del modello per un ordine è bassissimo, stimato sotto 1 centesimo di dollaro
- Analisi dei reclami, riassunti con contesti lunghi e altri scenari complessi passano a claude-opus-4-8, input $2,29 / milione di token, output $11,47 / milione di token (aggiornato a 2026-10). I reclami sono una quota ridotta, quindi l'impatto sul costo totale è limitato
Sui prezzi ci fermiamo qui: per il dettaglio consulta la pagina del modello. Per capire meglio perché scegliere il modello in base al compito riduce i costi, puoi leggere il nostro articolo Notion AI: pratica di routing automatico, che contiene l'approccio completo per distribuire le richieste ai diversi modelli in base al compito, la stessa logica di questa guida per gli ordini.
FAQ
È sicuro mettere la API key in n8n?
La key va inserita nella Credential di n8n, non scritta direttamente nei parametri o nel codice del nodo. Le Credential sono archiviate cifrate da n8n e non vengono incluse quando esporti e condividi il workflow. Inoltre ti consigliamo di impostare nella console HiAPI un limite di utilizzo per questa key, così anche in caso di fuga i danni restano sotto controllo.
Cosa fare se ricevo 429 (troppe richieste)?
Il 429 indica che è stato attivato il rate limit. Controlla prima se hai inviato in blocco molti ordini in poco tempo: puoi allungare l'intervallo di trigger o aggiungere una coda al nodo AI. Se il problema persiste, controlla nella console HiAPI le impostazioni di concorrenza e quota della key corrente e, se necessario, modifica il piano. Nel workflow puoi anche impostare una strategia di retry sul nodo AI, così in caso di 429 riprova automaticamente dopo un ritardo.
Posso usare un altro modello?
Sì. Basta sostituire il campo Model con il nome di qualsiasi modello disponibile su HiAPI, ad esempio deepseek-v4.1-flash per gli ordini normali e claude-opus-4-8 per i reclami: key e Base URL restano invariati. Una sola key vale per tutti i modelli: è proprio questo il vantaggio di usare HiAPI invece di richiedere separatamente le key ufficiali di ogni fornitore.
Qual è la differenza rispetto a richiedere direttamente le API key ufficiali?
Due punti essenziali. Primo, una key HiAPI copre più modelli: non serve registrarsi, ricaricare e gestire le quote separatamente su ogni piattaforma ufficiale. Secondo, la fatturazione a consumo è unificata, il che conviene di più quando le chiamate sono distribuite su più modelli. Per le piccole e medie imprese, il costo di gestione conta più della differenza di prezzo unitario.
Non supportare lo streaming è un problema?
No. Questa pipeline elabora gli ordini in modo asincrono: l'AI genera la risposta e la restituisce in un'unica soluzione, senza bisogno di mostrarla carattere per carattere come in un'interfaccia di chat. Lo streaming non influisce sul risultato.
Cosa fare se in n8n non c'è il campo Base URL?
Significa che stai usando una versione di n8n troppo vecchia. Base URL è un parametro del sotto-nodo OpenAI Chat Model dell'ecosistema di nodi AI, disponibile solo nelle versioni più recenti. Aggiorna prima n8n a una versione più recente, poi segui i passaggi di configurazione della Credential indicati sopra.
Conclusioni chiave
- L'integrazione consiste nel modificare una sola Credential: Base URL
https://api.hiapi.ai, API Key con la key HiAPI, nome del modello inserito manualmentedeepseek-v4.1-flash, senza scrivere codice. - Classificazione e bozza di risposta avvengono nella stessa chiamata AI, con un rigoroso formato di output JSON: solo così la diramazione IF successiva può valutare in modo stabile.
- Gli ordini normali ricevono risposta automatica, i reclami vengono sempre inoltrati a una persona: questo confine è imposto dalla diramazione IF.
- Il denaro va speso in base alla difficoltà: flash per gli ordini ordinari,
claude-opus-4-8per i messaggi difficili, con la stessa key e cambiando solo il nome del modello. - La key va gestita in modo centralizzato nella Credential di n8n, con retry ritardati in caso di 429; cambiare modello è una modifica in un solo punto.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato