
チュートリアル
n8n 受注自動化:Claude API 連携チュートリアル
n8n で新規注文の自動処理パイプラインを構築:AI が意図を判定し返信を生成、通常注文は自動返信、クレームは人へエスカレーション
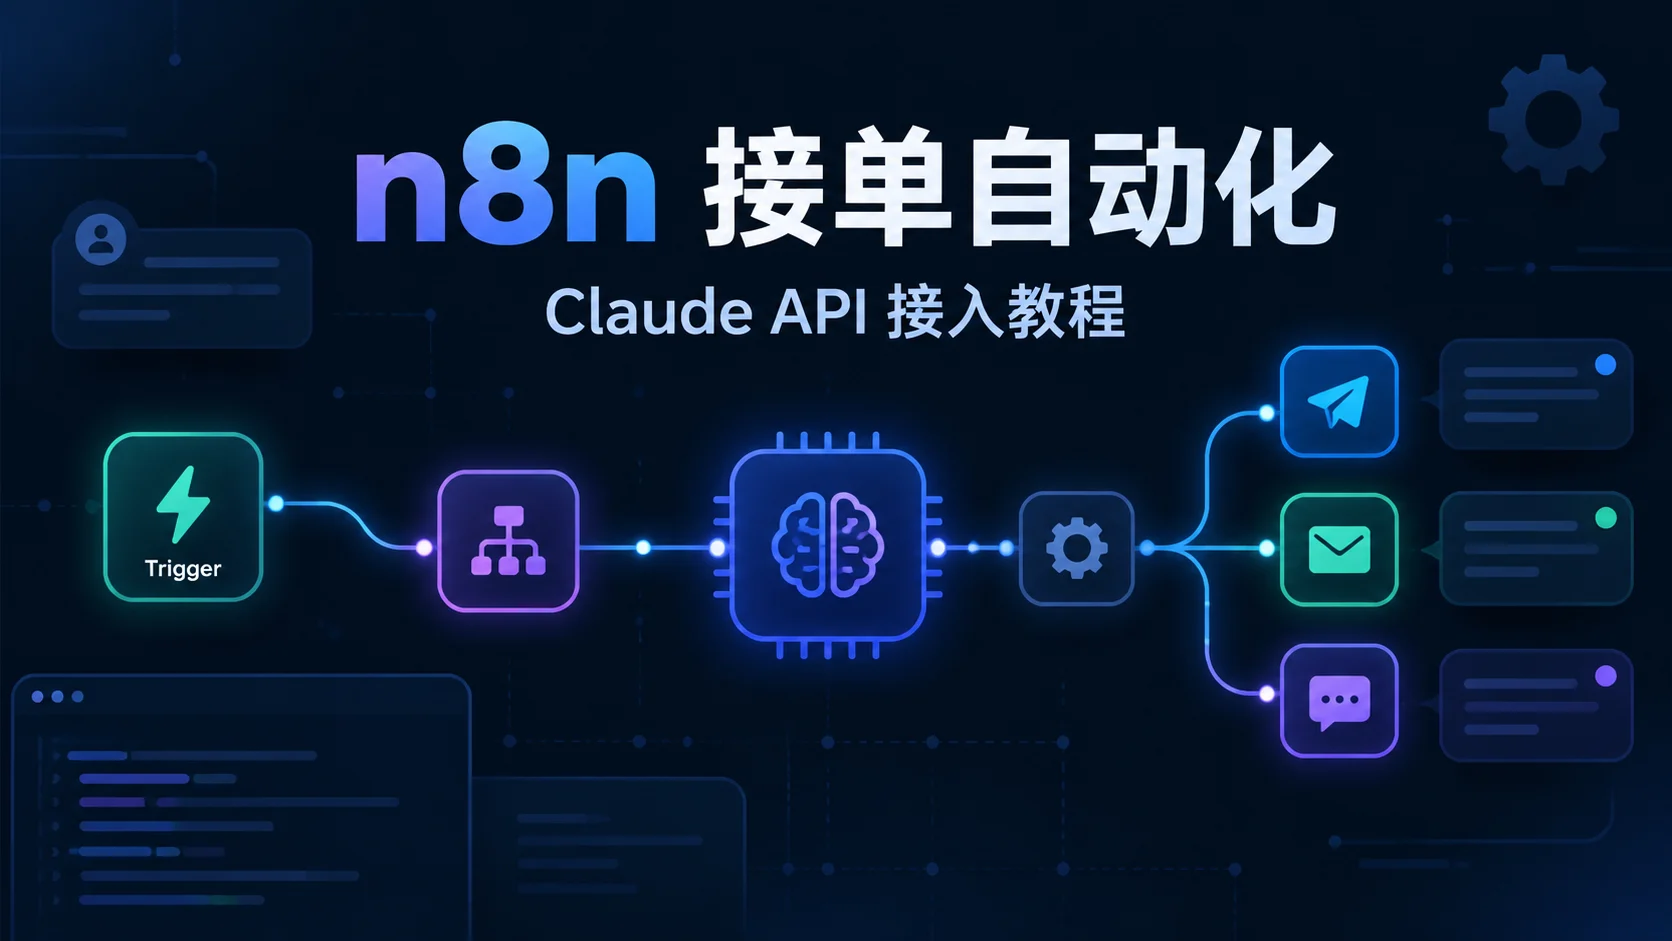
シナリオ:毎日手動で注文メッセージに返信、対応しきれない
飲食、小売、コミュニティグループ購入といったローカルビジネスでは、注文メッセージはほぼ WeChat、フォーム、店舗バックエンドに届きます。パターンはほぼ固定です。新規注文が入ったら内容を確認し、通常の注文かクレームかを判断して、確認メッセージを返す。注文量が少ないうちは問題ありませんが、注文量が増えると、ほとんどの時間が繰り返しの返信に費やされます。
このチュートリアルの目標は具体的です。n8n で自動化パイプラインを構築し、新規注文が入ったら AI が自動で意図を判定して返信を生成、通常注文はそのまま自動返信し、クレーム系の注文は人に転送して処理し、同時に通知を送る。コードは一切書かず、モデルの接続には HiAPI の API key が 1 つあれば十分です。
2026 年以来、n8n は複数の自動化ツール特集で中小事業者に繰り返し推薦されています(Atlassian、techaigoz の 2026 年度特集など)。理由は明快です。セルフホスト可能、オープンソース、LLM ノード体系が成熟していること。2026 年 10 月、X で n8n を使ってローカルの小規模事業者の受注自動化を行う投稿が 1 件で約 5.1 万閲覧を集めており、このニーズがすでに一般的であることを示しています。
準備:HiAPI key 1 つ + n8n 1 つ
始める前に必要なものは 2 つだけです。
第一に、HiAPI の API key。HiAPI コンソールで作成してコピーします。形式は sk- で始まります。この key は OpenAI 互換で、以降 n8n 内のすべてのモデルはこれを使います。
第二に、n8n。クラウド版でもセルフホストでも構いません。この記事ではデプロイ方式を問いません。唯一の条件はバージョンが古すぎないことです。理由は後述します。
核心となるステップ:OpenAI Chat Model ノードで HiAPI に接続
パイプライン全体の鍵は、n8n をモデルに接続することです。やり方は想像以上に簡単です。n8n の AI ノード体系には OpenAI Chat Model サブノードがあり、その Credential に Base URL 入力欄があります。OpenAI 互換エンドポイントと API Key を入力すれば使えます(この機能は n8n コミュニティでも早くから議論されており、コミュニティ投稿 Override baseURL for OpenAI Node を参照)。
具体的には 3 つを入力します:
- Base URL:
https://api.hiapi.ai - API Key:あなたの HiAPI key(
sk-で始まる) - Model:手入力で
deepseek-v4.1-flash
2 点注意してください。第一に、使うのは AI ノード体系の OpenAI Chat Model サブノードであり、旧来の OpenAI ノードではありません。第二に、Base URL フィールドは比較的新しいバージョンの n8n にしかありません。一部の古いバージョンではこのフィールドが欠けているため、まず n8n を新しいバージョンにアップグレードしてから設定してください。
入力が完了すれば、ワークフロー全体のすべての AI ノードがこの 1 つの Credential を共有します。その後モデルを変えたい場合は Model 欄を変更するだけです。たとえばクレーム対応のシナリオで claude-opus-4-8 に変えても、key はそのままです。
これでモデルの接続は完了です。次はワークフロー本体です。
ワークフローの 4 ステップ
パイプライン全体は 4 つのノードをつなげます:Webhook トリガー、AI による分類と返信案の作成、IF 分岐、通知。
1. Webhook トリガー
Webhook ノードを入口にします。注文システム(フォーム、店舗バックエンド、中継ボット)で新規注文があると、メッセージ内容をこのアドレスに POST します。トリガーが受け取った注文テキストは後続の AI ノードに渡されます。
まだシステム連携がない場合は、まず n8n のフォームトリガーノードで新規注文を手動で模擬し、フローを通してから実際のデータソースに切り替えても構いません。
2. AI ノード:分類 + 返信案の作成
AI Agent ノード(または簡略化した Chain ノード)を接続し、先ほど設定した OpenAI Chat Model Credential を紐づけ、モデルに deepseek-v4.1-flash を入力します。システム prompt は 2 つの役割を担います。このメッセージが通常注文かクレームかを判定し、それぞれ商家の口調で返信案を 1 つ作成します。
以下はそのまま使えるシステム prompt です。自分の店名と業態に置き換えれば動作します:
あなたはローカル飲食店の受注アシスタントです。以下のルールに従って各ユーザーメッセージを処理してください:

1. まずメッセージの種類を判定する:
   - 通常注文:ユーザーが明確に注文し、商品、数量、住所または受け取り方法を含む
   - クレーム:ユーザーが商品やサービスに不満を表明し、返金を要求、または苦情を述べる
   - その他:営業時間やメニューなどの問い合わせで、すぐに返信する必要がない内容

2. 次に種類に応じて返信を生成する:
   - 通常注文:商家の口調で注文内容を確認し、商品と数量を復唱し、提供予定時刻または配達予定時刻を伝える。親しみやすく自然な语气で
   - クレーム:まずお詫びと重視する姿勢を表し、できるだけ早く人による対応を行うことを伝える。具体的な補償案は約束しない
   - その他:ユーザーの質問に通常どおり回答する

3. 出力形式は厳密に JSON、2 つのフィールド:
   - category:order / complaint / other
   - reply:作成した返信テキスト

JSON のみを出力し、説明は一切出力しない。
AI に構造化 JSON を出力させるのが要点です。これにより後続の IF 分岐が安定して判定できます。たまに標準外の出力がある場合は、AI ノードの後に簡単なデータクリーニングステップを追加してフォールバックしてください。
3. IF 分岐:通常注文は自動返信、クレームは人へエスカレーション
IF ノードで category フィールドを読み取ります:
orderまたはother:自動返信へ進み、replyテキストをあなたの通知チャネル経由で顧客に返信する(WeChat ボット、メール、SMS など、接続しているものによる)complaint:自動返信せず、注文原文と分類結果をパッケージして店主または当番担当者に通知し、推奨対応トーク例を添えて、人が引き継ぐのを待つ
この振り分けこそがパイプライン全体の価値です。AI が大部分の繰り返し確認メッセージを処理し、人は判断力と共感が必要なクレームだけを処理します。
4. 通知ノード
最後に通知ノードを接続し、処理結果をあなたのコラボレーションツール(Feishu、WeChat、メールいずれでも可)に送ります。通常注文は自動返信済みと通知し、クレーム注文は完全な注文情報と人による対応待ちのフラグを通知します。これにより、パイプラインの実行履歴を監視していなくても、店で何が起きているかをリアルタイムに把握できます。
コスト管理:通常は flash、複雑なものは opus
タスクに応じてモデルを選ぶことが、このフローでコストを抑える鍵です。すべてのリクエストに最も高いモデルを使う必要はありません。
- 通常の分類と返信は deepseek-v4.1-flash を使用。入力 $0.44 / 百万 token、出力 $1.32 / 百万 token(HiAPI プラットフォーム価格、2026-10 時点)。受注メッセージは通常数百 token で、1 注文あたりのモデルコストは非常に低く、見積もりでは 1 セント未満
- クレーム分析、長文コンテキストの要約などの複雑なシナリオでは claude-opus-4-8 に切り替え。入力 $2.29 / 百万 token、出力 $11.47 / 百万 token(2026-10 時点)。クレームの割合は小さく、総コストへの影響は限定的
価格はここまでにしておきます。詳細な料金はモデル詳細ページをご覧ください。タスクに応じたモデル選択でコストを抑えられる理由をより深く知りたい方は、以前書いた Notion AI 自動ルーティング実践 をご覧ください。タスクに応じてリクエストを異なるモデルに振り分ける完全な考え方が載っており、この記事の受注シナリオと同じロジックです。
FAQ
API key を n8n に置くのは安全ですか?
key は n8n の Credential(資格情報)に入力し、ノードのパラメータやコードに直接書かないでください。Credential は n8n によって暗号化して保存され、ワークフローをエクスポートして共有する際に key は含まれません。また、HiAPI コンソールでこの key に使用量上限を設定することをおすすめします。万一漏洩しても被害を抑えられます。
429(リクエストが多すぎる)に遭遇したらどうすればよいですか?
429 はレート制限に達したことを示します。まず短時間に大量の注文を一括投入していないか確認し、トリガー間隔を延ばすか AI ノードにキューを追加してください。継続的に発生する場合は、HiAPI コンソールで現在の key の並列数とクォータ設定を確認し、必要に応じてプランを調整してください。ワークフロー内で AI ノードにリトライ戦略を設定し、429 発生時に自動で遅延してリトライすることもできます。
他のモデルに変更できますか?
できます。Model 欄を HiAPI 上の任意のモデル名に変更するだけです。たとえば通常注文は deepseek-v4.1-flash、クレームは claude-opus-4-8 に変えても、key と Base URL は変更不要です。1 つの key で全モデル共通、これこそが各社公式 key を個別に申請するのではなく HiAPI を使う手軽さです。
公式 API key を直接申請するのと何が違いますか?
核心は 2 点です。第一に、1 つの HiAPI key で複数モデルをカバーでき、各社公式プラットフォームに個別登録、個別チャージ、個別クォータ管理をする必要がありません。第二に、従量課金で統一精算され、呼び出し量が複数モデルに分散するシナリオではより割安です。中小事業者にとっては、管理コストの差が単価差よりも重要です。
ストリーミング出力(streaming)が非対応でも問題ありませんか?
問題ありません。このパイプラインは注文を非同期で処理し、AI が返信を生成し終えたら一括で返せばよく、チャット画面のように 1 文字ずつ表示する必要はありません。ストリーミングの有無は効果に影響しません。
n8n に Base URL フィールドがない場合はどうすればよいですか?
使用している n8n のバージョンが古すぎることを示します。Base URL は AI ノード体系の OpenAI Chat Model サブノードのパラメータで、比較的新しいバージョンにのみあります。まず n8n を新しいバージョンにアップグレードし、上記の Credential 設定手順に従って操作してください。
重要な結論
- 接続は Credential の 1 箇所を変えるだけ:Base URL に
https://api.hiapi.ai、API Key に HiAPI key、モデル名を手入力でdeepseek-v4.1-flash、コードは書かない。 - 分類と返信案の作成は同じ AI 呼び出しで完了し、厳密な JSON 出力形式を使うことで、後続の IF 分岐が安定して判定できる。
- 通常注文は自動返信、クレームは毎回人へエスカレーション、この境界は IF 分岐によって強制される。
- コストは難易度に応じて配分:通常注文は flash、処理が難しいメッセージは
claude-opus-4-8に切り替え、同じ key でモデル名だけ変更。 - key は n8n Credential で一元管理し、429 発生時は遅延リトライ、モデル変更は 1 箇所の変更で済む。
関連記事
すべての記事を見る →-

チュートリアル
Recraft Creative Upscale 事例:風景と水彩のアップスケール
山小屋、湖、水彩の町のテクスチャ変化を確認し、完全な結果とプレビューを区別して、描き直された細部をチェックします。
-

チュートリアル
OpenAI API キーが無効:401、環境変数とプロジェクト設定の調査
OpenAI の 401、403、429 を区別し、環境変数、組織とプロジェクトの設定を確認し、読み取り専用リクエストで認証情報を検証します。
-

チュートリアル
Kling 4.0 プロンプト大全:6つのシーンをそのままコピーして動画を生成
EC商品、グルメ、旅行風景、日常のワンシーン、音声付きの空撮カット、イメージ・トゥ・ビデオ。各シーンに実写動画、完全なプロンプト、ワンクリックで自動入力されるリンクをご用意。