
Tutorial
Automatización de pedidos con n8n: tutorial de integración de la API de Claude
Crea con n8n una canalización de procesamiento automático de nuevos pedidos: la IA determina la intención y genera respuestas; los pedidos normales se responden automáticamente y las reclamaciones se escalan a una persona
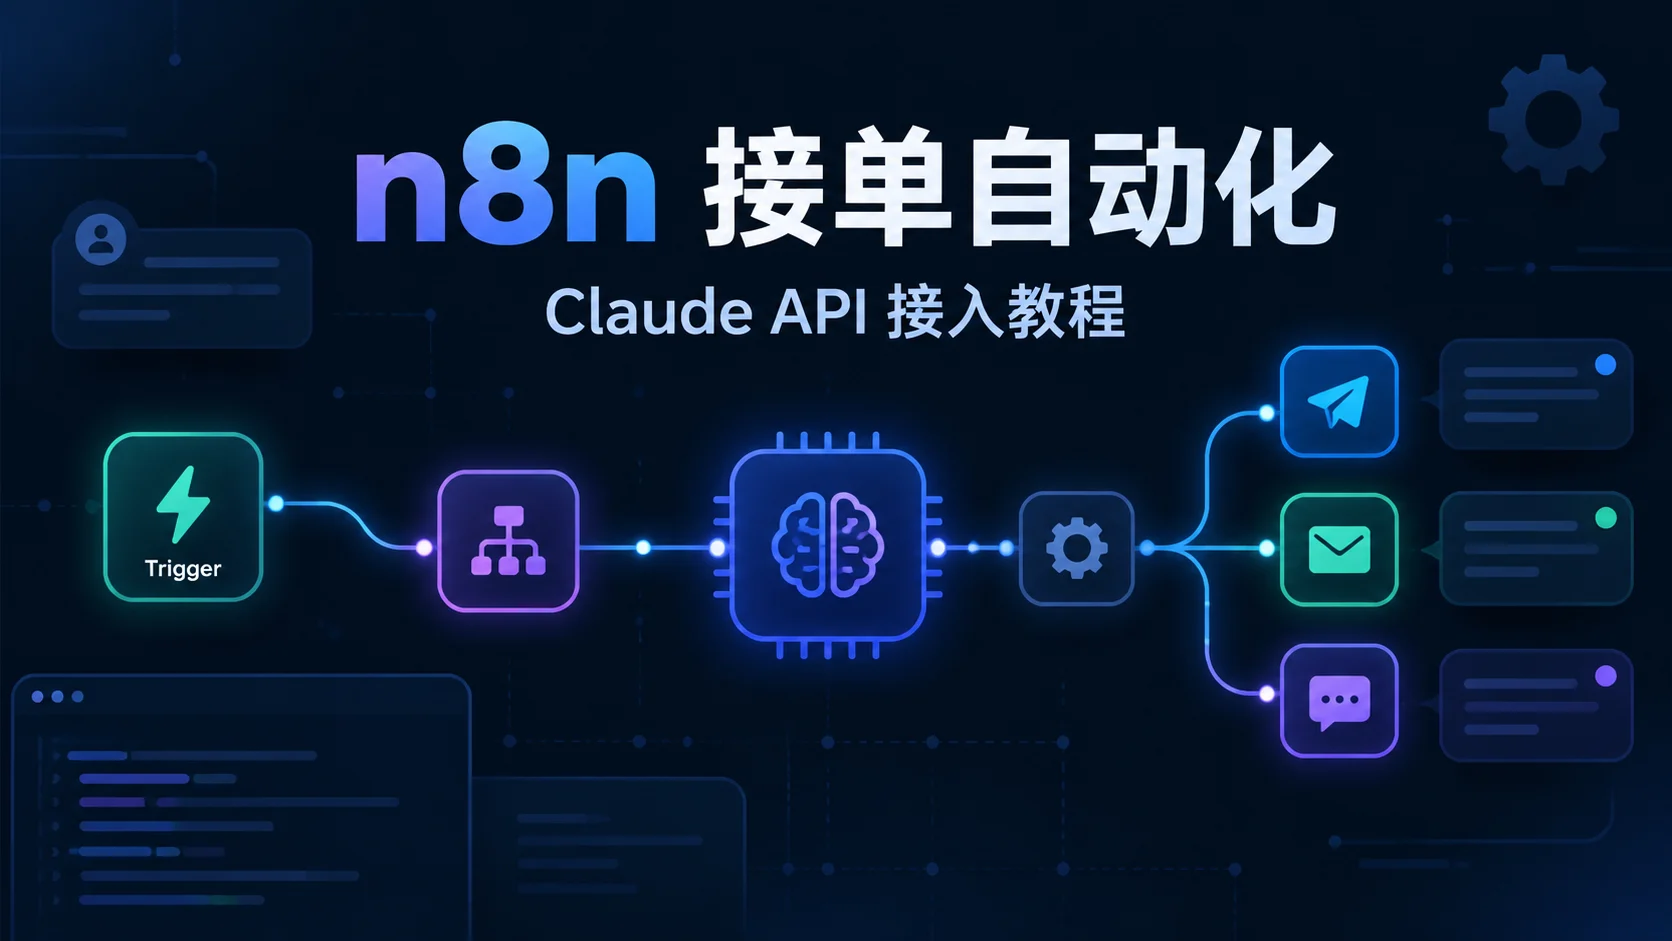
Escenario: responder manualmente los mensajes de pedidos todos los días, sin dar abasto
En negocios locales como restaurantes, comercio minorista o compras grupales de barrio, los mensajes de pedidos llegan casi siempre por WeChat, formularios o el panel de la tienda. El patrón es muy fijo: entra un nuevo pedido, se revisa el contenido, se decide si es un pedido normal o una reclamación y se envía un mensaje de confirmación. Con poco volumen no importa, pero en cuanto el volumen sube, la mayor parte del tiempo se consume en respuestas repetitivas.
El objetivo de este tutorial es muy concreto: crear con n8n una canalización automatizada en la que, cuando entra un nuevo pedido, la IA determine automáticamente la intención y genere una respuesta; los pedidos normales se responden de forma automática y los pedidos de reclamación se reenvían a una persona para su gestión, enviando además una notificación. No se escribe código en ningún momento; para conectar el modelo solo se necesita una API key de HiAPI.
Desde 2026, n8n ha sido recomendado repetidamente en varios análisis de herramientas de automatización para pequeños y medianos comercios (por ejemplo, en los análisis anuales de 2026 de Atlassian y techaigoz), por motivos muy directos: autoalojamiento, código abierto y un ecosistema de nodos LLM maduro. En octubre de 2026, una publicación en X sobre el uso de n8n para la gestión automatizada de pedidos de pequeños comercios locales alcanzó unas 51 000 visualizaciones en una sola publicación, lo que indica que esta necesidad ya es muy común.
Preparación: una key de HiAPI + un n8n
Antes de empezar solo se necesitan dos cosas.
Primero, la API key de HiAPI. Créala y cópiala en la consola de HiAPI; el formato empieza por sk-. Esta key es compatible con OpenAI y todos los modelos que se usen después en n8n pasarán por ella.
Segundo, n8n. Sirve tanto la versión en la nube como el autoalojamiento; este tutorial no depende del tipo de despliegue. El único requisito es que la versión no sea demasiado antigua; el motivo se explica más abajo.
Paso clave: conectar el nodo OpenAI Chat Model a HiAPI
La clave de toda la canalización es conseguir que n8n se conecte al modelo. Es más sencillo de lo que parece: en el sistema de nodos de IA de n8n existe un subnodo OpenAI Chat Model, cuyo Credential incluye un campo Base URL; basta con introducir el endpoint compatible con OpenAI y la API Key para usarlo (esta capacidad se ha debatido desde hace tiempo en la comunidad de n8n; véase la publicación de la comunidad Override baseURL for OpenAI Node).
En concreto, hay que rellenar tres cosas:
- Base URL:
https://api.hiapi.ai - API Key: tu key de HiAPI (empieza por
sk-) - Model: introduce manualmente
deepseek-v4.1-flash
Ten en cuenta dos cosas. Primero, hay que usar el subnodo OpenAI Chat Model del sistema de nodos de IA, no el nodo OpenAI antiguo. Segundo, el campo Base URL solo existe en versiones relativamente recientes de n8n; algunas versiones antiguas no lo tienen, así que actualiza n8n a una versión más reciente antes de configurarlo.
Una vez rellenado, todos los nodos de IA del flujo de trabajo comparten este único Credential. Si después quieres cambiar de modelo, basta con modificar la columna Model; por ejemplo, para el escenario de reclamaciones puedes cambiar a claude-opus-4-8 sin tocar la key.
Con esto el modelo ya está conectado. A continuación, el flujo de trabajo en sí.
Los cuatro pasos del flujo de trabajo
Toda la canalización encadena cuatro nodos: activación por Webhook, clasificación y redacción de respuesta por IA, rama IF y notificación.
1. Activación por Webhook
Usa un nodo Webhook como entrada; cuando el sistema de pedidos (formulario, panel de la tienda, bot intermediario) tenga un nuevo pedido, envía el contenido del mensaje por POST a esta dirección. El texto del pedido que recibe el activador se pasa al nodo de IA posterior.
Si de momento no hay un sistema integrado, también puedes simular manualmente nuevos pedidos con el nodo de activación por formulario de n8n, validar el flujo y después cambiar a la fuente de datos real.
2. Nodo de IA: clasificación + redacción de respuesta
Conecta un nodo AI Agent (o un nodo Chain simplificado), asígnale el Credential OpenAI Chat Model configurado antes y pon deepseek-v4.1-flash como modelo. El prompt del sistema se encarga de dos cosas: determinar si el mensaje es un pedido normal o una reclamación y, en cada caso, redactar una respuesta con el tono del comercio.
A continuación tienes un prompt del sistema listo para usar; sustitúyelo por el nombre de tu tienda y tu categoría y ya funciona:
Eres el asistente de pedidos de un comercio local de restauración. Procesa cada mensaje de usuario según estas reglas:

1. Primero determina el tipo de mensaje:
   - Pedido normal: el usuario realiza un pedido de forma explícita e incluye producto, cantidad, dirección o forma de recogida
   - Reclamación: el usuario expresa insatisfacción con el producto o el servicio, solicita un reembolso o presenta una queja
   - Otro: consultas sobre horario de apertura, menú u otros contenidos que no requieren respuesta inmediata

2. Después genera una respuesta según el tipo:
   - Pedido normal: confirma el contenido del pedido con el tono del comercio, repite el producto y la cantidad, indica el tiempo estimado de preparación o entrega, con un tono cercano y natural
   - Reclamación: expresa primero disculpas e interés, indica que se gestionará por una persona lo antes posible y no prometas una solución de compensación concreta
   - Otro: responde normalmente a la pregunta del usuario

3. El formato de salida debe ser estrictamente JSON, con dos campos:
   - category: order / complaint / other
   - reply: el texto de respuesta redactado

Salida solo en JSON, sin ninguna explicación.
Exigir que la IA genere un JSON estructurado es lo importante, ya que así la rama IF posterior puede decidir de forma estable. Si en alguna ocasión la salida no es estándar, añade tras el nodo de IA un paso sencillo de limpieza de datos como red de seguridad.
3. Rama IF: los pedidos normales se responden solos, las reclamaciones se escalan a una persona
Usa un nodo IF para leer el campo category:
orderuother: sigue la respuesta automática y envía el texto dereplyal cliente por tu canal de notificación (bot de WeChat, correo o SMS, según lo que tengas conectado)complaint: no se responde automáticamente; se empaqueta el pedido original con el resultado de la clasificación y se envía una notificación al dueño de la tienda o a la persona de guardia, junto con un guion de respuesta sugerido, y se espera a que alguien lo atienda
Este enrutamiento es el valor de toda la canalización. La IA se encarga de la mayor parte de los mensajes de confirmación repetitivos y las personas solo gestionan las reclamaciones, que requieren criterio y empatía.
4. Nodo de notificación
Por último, conecta un nodo de notificación que envíe el resultado del procesamiento a tu herramienta de colaboración (Feishu, WeChat o correo). Para los pedidos normales se notifica que se ha respondido automáticamente; para las reclamaciones se notifica la información completa del pedido y se marca como pendiente de gestión humana. Así, aunque no estés pendiente del historial de ejecución de la canalización, puedes saber en tiempo real qué ocurre en la tienda.
Control de costes: lo habitual con flash, lo complejo con opus
Elegir el modelo según la tarea es la clave para controlar el coste de este flujo; no tiene sentido usar el más caro para todas las solicitudes.
- Clasificación y respuesta habituales con deepseek-v4.1-flash, entrada $0.44 / millón de tokens, salida $1.32 / millón de tokens (precio de la plataforma HiAPI, a fecha de 2026-10). Los mensajes de pedido suelen tener unos cientos de tokens, por lo que el coste de modelo de un pedido es muy bajo, menos de 1 céntimo de dólar según la estimación
- Análisis de reclamaciones, resúmenes de contexto largo y otros escenarios complejos, cambia a claude-opus-4-8, entrada $2.29 / millón de tokens, salida $11.47 / millón de tokens (a fecha de 2026-10). Las reclamaciones son una proporción pequeña, así que el impacto en el coste total es limitado
Los precios son solo orientativos; consulta la página de detalle de cada modelo para el precio detallado. Si quieres entender mejor por qué elegir el modelo según la tarea permite ahorrar costes, puedes leer nuestro artículo anterior Práctica de enrutamiento automático de Notion AI, donde se explica la idea completa de distribuir solicitudes entre distintos modelos según la tarea, la misma lógica que el escenario de pedidos de este artículo.
FAQ
¿Es seguro guardar la API key en n8n?
La key debe introducirse en el Credential de n8n, no escribirse directamente en los parámetros del nodo ni en el código. n8n almacena el Credential cifrado y, al exportar y compartir el flujo de trabajo, no se incluye la key. Además, se recomienda establecer en la consola de HiAPI un límite de uso para esta key, de modo que incluso en caso de filtración las pérdidas sean controlables.
¿Qué hacer si aparece un 429 (demasiadas solicitudes)?
Un 429 indica que se ha activado el límite de frecuencia. Comprueba primero si se ha volcado un gran volumen de pedidos en poco tiempo; puedes ampliar el intervalo de activación o añadir una cola al nodo de IA. Si persiste, revisa en la consola de HiAPI la configuración de concurrencia y cuota de la key actual y ajusta el plan si es necesario. En el flujo de trabajo también puedes configurar una estrategia de reintentos para el nodo de IA, de modo que al recibir un 429 se reintente automáticamente tras un retraso.
¿Se puede cambiar a otro modelo?
Sí. Basta con cambiar la columna Model por el nombre de cualquier modelo de HiAPI; por ejemplo, para pedidos normales cambia a deepseek-v4.1-flash y para reclamaciones a claude-opus-4-8, sin modificar la key ni la Base URL. Una sola key sirve para todos los modelos, y esa es precisamente la comodidad de usar HiAPI en lugar de solicitar una key oficial a cada proveedor.
¿Qué diferencia hay con solicitar directamente las API keys oficiales?
Hay dos diferencias principales. Primero, una sola key de HiAPI cubre varios modelos, sin necesidad de registrarse, recargar y gestionar cuotas por separado en cada plataforma oficial. Segundo, la facturación por uso es unificada, lo que resulta más rentable en escenarios en los que el volumen de llamadas se reparte entre varios modelos. Para pequeños y medianos comercios, el coste de gestión es más importante que la diferencia de precio unitario.
¿Importa que no se admita la salida en streaming?
No importa. Esta canalización procesa pedidos de forma asíncrona y basta con que la IA devuelva la respuesta generada de una vez; no necesita mostrar el texto carácter a carácter como una interfaz de chat. El streaming no afecta al resultado.
¿Qué hago si no aparece el campo Base URL en n8n?
Significa que la versión de n8n que usas es demasiado antigua. Base URL es un parámetro del subnodo OpenAI Chat Model del sistema de nodos de IA y solo existe en versiones relativamente recientes. Actualiza primero n8n a una versión más reciente y después sigue los pasos de configuración del Credential indicados arriba.
Conclusiones clave
- La integración consiste en cambiar un único Credential: en Base URL pon
https://api.hiapi.ai, en API Key pon la key de HiAPI y escribe manualmentedeepseek-v4.1-flashcomo nombre del modelo, sin escribir código. - La clasificación y la redacción de la respuesta se realizan en la misma llamada a la IA, con un formato de salida JSON estricto, para que la rama IF posterior pueda decidir de forma estable.
- Los pedidos normales se responden automáticamente y las reclamaciones se escalan siempre a una persona; la rama IF impone este límite.
- El dinero se gasta según la dificultad: los pedidos habituales con flash y los mensajes difíciles con
claude-opus-4-8, cambiando solo el nombre del modelo con la misma key. - La key se gestiona de forma centralizada en el Credential de n8n; ante un 429, reintenta con retraso; cambiar de modelo es un solo cambio.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado