
Guia de uso
Receitas de prompts de texto para vídeo do Wan 2.7: 3 prompts prontos para copiar e suas saídas reais
Três receitas de prompts one-shot para wan2.7-video/text-to-video — uma cena fotorrealista, um estilo visual travado e um movimento de câmera com recompensa narrativa — cada uma acompanhada do seu prompt exato, do clipe que ele realmente gerou e do motivo de ter funcionado.
Texto para vídeo é a zona mais profunda da criação de prompts. No imagem para vídeo, você entrega um quadro ao modelo e só descreve o movimento — já cobrimos essa abordagem aqui. Já no texto para vídeo não existe imagem: um único texto precisa carregar a cena, a atuação do protagonista, a câmera, o estilo visual e — como o wan2.7 gera áudio nativamente — também a trilha sonora.
Este guia traz três receitas de prompts prontas para copiar, destinadas ao wan2.7-video/text-to-video, o modelo de texto para vídeo Tongyi Wanxiang 2.7 da Alibaba, cada uma cobrindo uma das tarefas que um prompt de texto para vídeo precisa cumprir: uma cena fotorrealista, um estilo visual travado e um movimento de câmera com recompensa narrativa. Cada clipe abaixo é a saída real e de uma única tentativa do prompt impresso ao seu lado, gerada pela API de tarefas da hiapi — sem seleção entre seeds, sem novas tentativas. Os três clipes juntos custaram US$ 1,84.
Estrutura da requisição (leia primeiro)
O wan2.7 texto para vídeo roda no endpoint de tarefas assíncronas da hiapi, e a entrada é surpreendentemente enxuta — apenas três campos:
prompt— o filme inteiro: cena, ação, câmera, estilo, som.resolution— valor de enumeração:720Pou1080P, sem outras opções.duration— em segundos, com limite máximo de 15.
Não há array de mídia, nem botão de proporção de tela, nem campo de prompt negativo. Diferente do modelo irmão i2v, aqui não há nada para enviar — e é exatamente por isso que o prompt precisa trabalhar mais.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/text-to-video",
    "input": {
      "prompt": "Night street food market in a narrow alley. A cook in a white apron tosses noodles in a flaming wok...",
      "resolution": "720P",
      "duration": 5
    }
  }'
A resposta retorna imediatamente um taskId; faça polling em GET /v1/tasks/{taskId} até que status seja success e então baixe output[0].url. Sobre o retorno, duas coisas vale saber:
- O arquivo contém uma faixa de áudio real.Cada clipe deste artigo é entregue em H.264, a 30 fps, com áudio AAC gerado a partir das pistas sonoras do prompt — verificamos os níveis e não se trata de uma faixa muda de preenchimento.
- As URLs de saída expiram.Baixe o arquivo imediatamente após o sucesso da tarefa e armazene-o no seu próprio bucket — veja aqui o que acontece se você não fizer isso.
Receita 1: cena fotorrealista
A habilidade básica: produzir cinco segundos que pareçam filmagem real e não "vídeo de IA". A receita é uma pilha ordenada — cena, ação do protagonista, vida de fundo, câmera, som, estilo de lente — com uma oração para cada item:
Night street food market in a narrow alley. A cook in a white apron tosses
noodles in a flaming wok; sparks and steam burst upward, glowing under a
string of red lanterns. Customers drift past as soft bokeh in the background.
The camera slowly dollies in toward the wok. Sizzling oil crackles over the
low murmur of the crowd and distant rain. Cinematic handheld feel, 35mm lens,
shallow depth of field, warm tungsten highlights against cool blue shadows.
Parâmetros:resolution: 720P, duration: 5 — custo de US$ 0,50.
Saída de uma única tentativa:
Observe o que o modelo fez com cada camada: a chama e o vapor da wok animam continuamente, os transeuntes cruzam o quadro como formas desfocadas, exatamente onde o prompt os posicionou ("soft bokeh in the background"), e o dolly-in é real — aos quatro segundos a wok já preenche o quadro. Ative o som: o chiado se sobressai ao murmúrio da multidão, vindo diretamente da oração de áudio. O truque estrutural é dar exatamente uma oração para cada elemento e exatamente uma instrução para a câmera. Prompts fotorrealistas costumam falhar por aglomeração — três ideias de plano e um sistema meteorológico enfiados num único texto — e não por falta de detalhe.
Receita 2: estilo travado
O segundo uso do texto para vídeo: conteúdo estilizado em que o meio é a própria mensagem. A receita abre com a declaração de estilo e depois mantém cada objeto dentro desse mundo material — e faz o áudio combinar com o estilo:
Handcrafted paper-cutout stop-motion style. A tiny paper sailboat rides
rolling waves made of layered blue cardboard; a paper whale surfaces beside
it, spouting a burst of white paper confetti, then dives back under. The sun
is a crinkled gold-foil disc in a construction-paper sky. Slightly jittery
stop-motion cadence, soft studio light, visible paper grain and hand-cut
edges throughout. Gentle ukulele plucks over a soft ocean whoosh.
Parâmetros:resolution: 720P, duration: 5 — custo de US$ 0,50.
Saída de uma única tentativa:
O estilo se mantém em todos os quadros: as ondas são claramente papelão em camadas deslizando umas sobre as outras, a baleia expele confete de papel branco em vez de água, e o sol de folha dourada conserva a textura amassada quando a luz o percorre. A cadeia de ações executa na ordem escrita — a baleia emerge, sopra e volta a mergulhar — e é isso que dá o controle de linha do tempo em um clipe de cinco segundos. Duas regras sustentam esta receita: declare o estilo na primeira frase (palavras de estilo enterradas no meio do prompt vazam para o realismo), e converta cada efeito físico no meio — pedir "confete de papel" em vez de "respingos" é a diferença entre estilo e filtro.
Receita 3: movimento de câmera com recompensa narrativa
Autoria de câmera pura: a cena é só o cenário, e a câmera é o conteúdo. Nomeie o movimento, dê a ele uma trajetória e — a parte que a maioria dos prompts pula — dê a ele um desfecho:
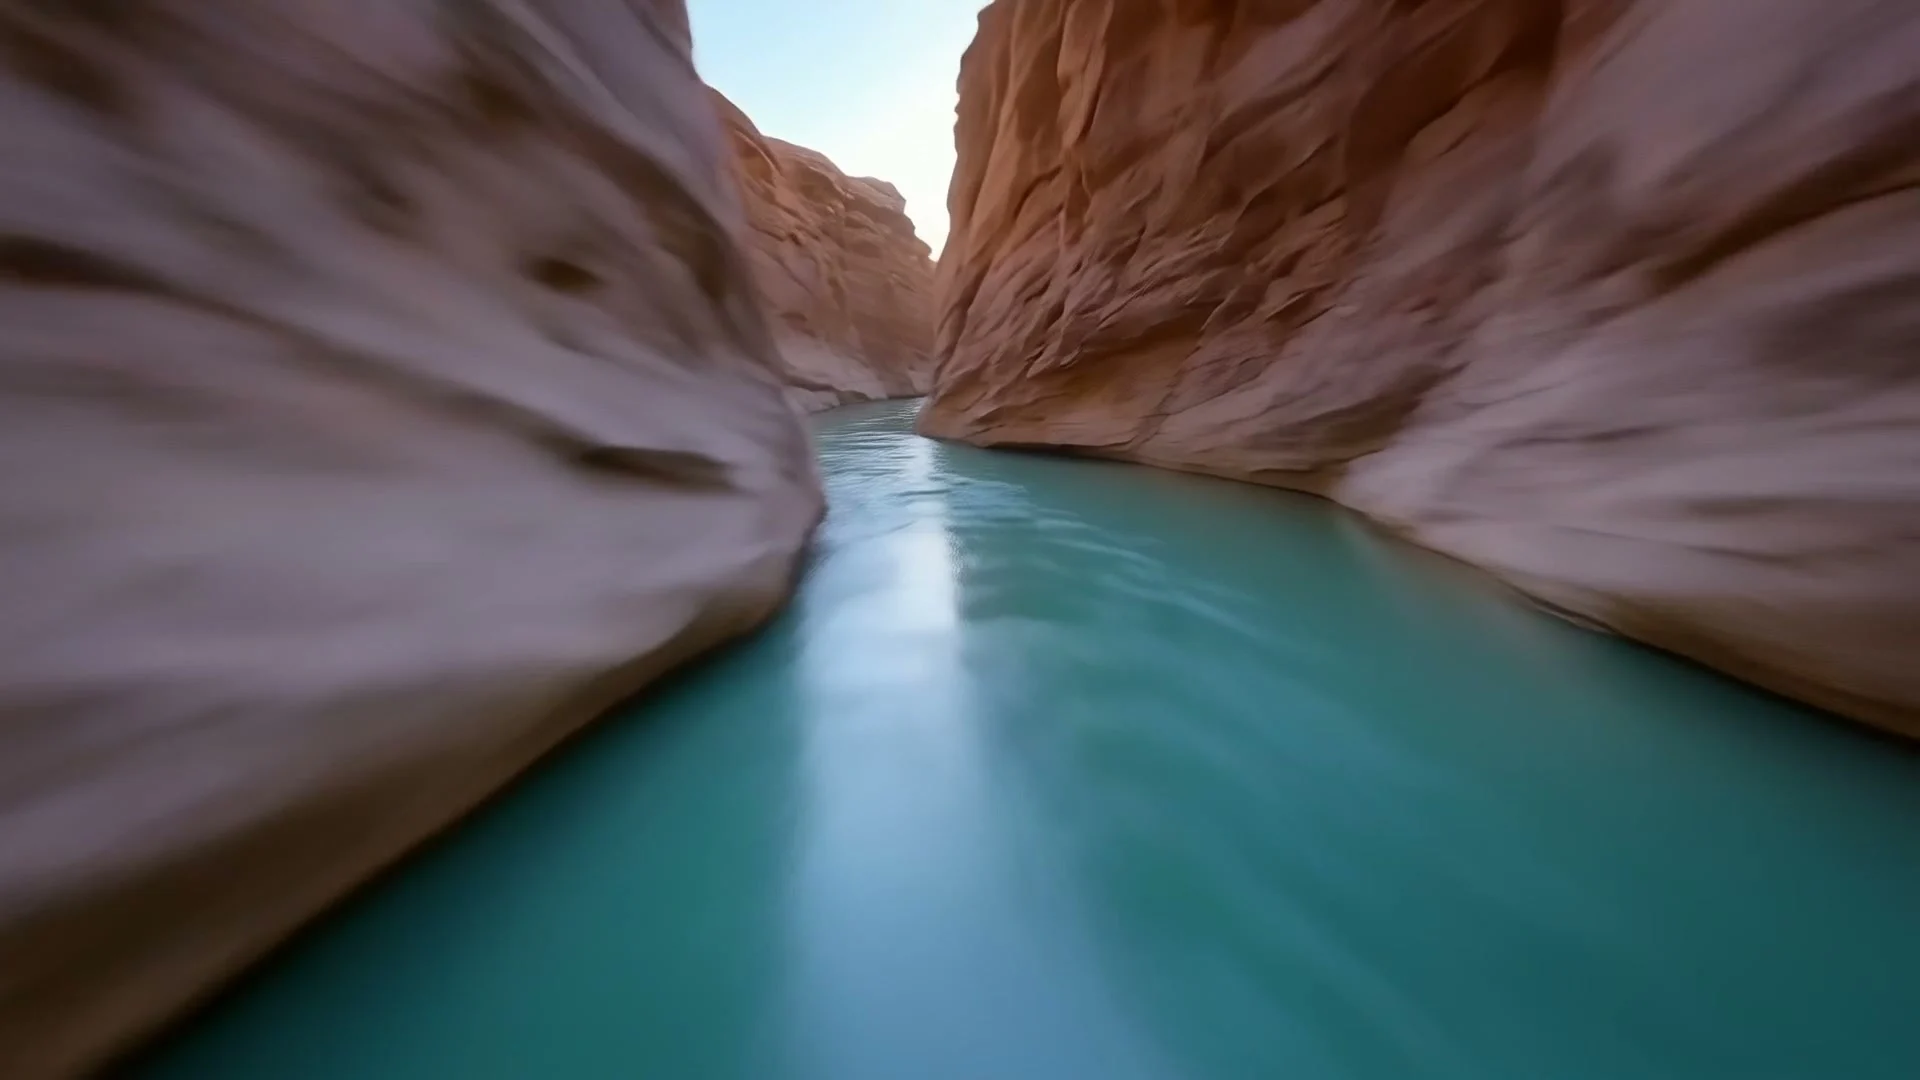
FPV drone shot racing low over a turquoise river through a narrow slot canyon
at sunrise, banking left and right with the curves of the canyon walls, then
pulling up sharply over the rim to reveal a vast desert plain glowing gold in
the morning haze. Motion blur on the near canyon walls, lens flare as the sun
crests the rim, smooth confident racing-drone motion, no cuts. Rushing wind
and a deep ambient synth swell that opens up on the reveal.
Parâmetros:resolution: 1080P, duration: 5 — custo de US$ 0,835.
Saída de uma única tentativa:
O clipe tem um arco real: quatro segundos inclinando-se pelo cânion, com motion blur nas paredes próximas, e então a subida que completa a revelação — um deserto banhado de sol até o horizonte. Esse arco vem da forma do prompt: corrida baixa → inclinar com as curvas do cânion → subida → com revelação. Uma trajetória com destino vence uma pilha de adjetivos de câmera todas as vezes. Repare na orientação de áudio — "um swell de sintetizador que se abre na revelação" amarra o design de som ao compasso narrativo do plano, algo que só um modelo com áudio nativo consegue executar a partir de um único prompt.
Guia rápido
Cinco regras, destiladas destas execuções e das tentativas que não entraram no artigo:
- A ordem das frases é a sua linha do tempo.O wan2.7 reproduz as ações na ordem escrita — organize o prompt como indicações de cena, não como descrição.
- Comece pelo estilo.A primeira frase define o modo de renderização; o realismo é o padrão, e as palavras de estilo precisam vencê-lo desde cedo.
- Uma instrução de câmera por clipe.Dolly-in, ou voo FPV, ou câmera fixa. Movimentos empilhados se anulam e viram borrão.
- Escreva a trilha sonora.Uma oração de áudio — o que soa e o que está por baixo — já entrega um clipe com trilha de graça. Silêncio no prompt não significa silêncio na saída; significa que o modelo está adivinhando.
- Dê um destino ao movimento."Subir sobre a borda para revelar a planície" produz um arco; "filmagem aérea dinâmica de drone" produz vadiagem.
Quanto custa
O wan2.7-video/text-to-video é cobrado por segundo de vídeo gerado, com tarifa definida pela resolução:
| Resolução | Preço | Clipe de 5 segundos | Clipe de 15 segundos (máximo) |
|---|---|---|---|
| 720P | US$ 0,10 / segundo | US$ 0,50 | US$ 1,50 |
| 1080P | US$ 0,167 / segundo | US$ 0,835 | US$ 2,505 |
Os três clipes deste artigo — dez segundos em 720P mais cinco segundos em 1080P, todos com áudio nativo — custaram US$ 1,84 no total, e como as tarefas rodam em paralelo no servidor, todos os arquivos ficaram prontos cerca de seis minutos após o primeiro envio. As tarifas atuais estão sempre na página de preços.
Experimente
Se você já tem uma imagem de que gosta, o wan2.7-video/image-to-video a anima pelo mesmo preço por segundo — o artigo de receitas i2v é o complemento deste. Para tudo o que você consegue descrever mas ainda não filmou, pegue qualquer prompt acima, troque os substantivos e envie para a API de tarefas — a página do modelo wan2.7-video/text-to-video tem a referência de parâmetros ao vivo. Um primeiro rascunho em 720P custa US$ 0,50 e volta em poucos minutos; deixe o 1080P para prompts que resistem à iteração.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores