
Guida all'uso
Ricette di prompt text-to-video per Wan 2.7: 3 prompt pronti da copiare e i relativi output reali
Tre ricette di prompt one-shot per wan2.7-video/text-to-video — una scena fotorealistica, uno stile visivo bloccato e un movimento di camera con una ricompensa narrativa — ciascuna con il suo prompt esatto, la clip che ha effettivamente generato e il motivo per cui funziona.
Il text-to-video è il terreno insidioso della creazione di prompt. Con l'image-to-video dai al modello un fotogramma e devi solo descrivere il movimento — abbiamo già trattato quel metodo qui. Il text-to-video, invece, non ha un'immagine: un testo deve trasportare la scena, la recitazione del soggetto, la camera, lo stile visivo e — poiché wan2.7 genera l'audio in modo nativo — anche la colonna sonora.
Questa guida ti offre tre ricette di prompt pronte da copiare per wan2.7-video/text-to-video, il modello text-to-video Tongyi Wanxiang 2.7 di Alibaba; ogni ricetta affronta un compito che un prompt text-to-video deve assolvere: una scena fotorealistica, uno stile visivo bloccato e un movimento di camera con una ricompensa narrativa. Ogni clip qui sotto è l'output reale e one-shot del prompt stampato accanto, generato tramite l'API task di hiapi — nessuna selezione tra più seed, nessun nuovo tentativo. Le tre clip sono costate in totale $1.84.
Struttura della richiesta (leggi prima)
wan2.7 text-to-video gira sull'endpoint asincrono dei task di hiapi, e l'input è sorprendentemente scarno — solo tre campi:
prompt— l'intero film: scena, azione, camera, stile, suono.resolution— valori ammessi:720Po1080P, nessun'altra opzione.duration— in secondi, massimo 15.
Nessun array di media, nessuna manopola per l'aspect ratio, nessun campo per i prompt negativi. A differenza del modello gemello i2v, qui non c'è nulla da caricare — ed è proprio per questo che il prompt deve lavorare di più.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/text-to-video",
    "input": {
      "prompt": "Night street food market in a narrow alley. A cook in a white apron tosses noodles in a flaming wok...",
      "resolution": "720P",
      "duration": 5
    }
  }'
La risposta restituisce subito un taskId; esegui il polling di GET /v1/tasks/{taskId} finché status non diventa success, poi scarica output[0].url. Due cose vale la pena sapere su ciò che viene restituito:
- Il file contiene una vera traccia audio. Ogni clip di questo articolo viene consegnata in H.264, 30 fps, con audio AAC generato dagli indizi sonori presenti nel prompt — abbiamo controllato i livelli, non è una traccia placeholder muta.
- Gli URL di output scadono. Scarica il file subito dopo il successo del task e salvalo nel tuo bucket — qui trovi cosa succede se non lo fai.
Ricetta 1: una scena fotorealistica
L'abilità di base: produrre cinque secondi che sembrano girati dal vero e non "video AI". La ricetta è uno stack ordinato — scena, azione del soggetto, vita di sfondo, camera, suono, stile di ripresa — una clausola per elemento:
Night street food market in a narrow alley. A cook in a white apron tosses
noodles in a flaming wok; sparks and steam burst upward, glowing under a
string of red lanterns. Customers drift past as soft bokeh in the background.
The camera slowly dollies in toward the wok. Sizzling oil crackles over the
low murmur of the crowd and distant rain. Cinematic handheld feel, 35mm lens,
shallow depth of field, warm tungsten highlights against cool blue shadows.
Parametri: resolution: 720P, duration: 5 — costo $0.50.
Output one-shot:
Osserva cosa ha fatto il modello con ogni livello: le fiamme e il vapore nel wok si animano di continuo, i passanti attraversano l'inquadratura come sagome sfocate, esattamente dove il prompt li ha collocati ("soft bokeh in the background"), e il dolly è reale — entro il quarto secondo il wok riempie l'inquadratura. Attiva l'audio: il crepitio emerge sopra il brusio della folla, direttamente dalla clausola audio. Il trucco strutturale è una sola clausola per ogni elemento e una sola istruzione per la camera. I prompt fotorealistici falliscono più spesso per affollamento — tre idee di ripresa e un sistema meteorologico stipati in un unico testo — che per mancanza di dettagli.
Ricetta 2: uno stile bloccato
Secondo utilizzo del text-to-video: contenuti stilizzati in cui il medium stesso è il messaggio. La ricetta apre con una dichiarazione di stile, poi mantiene ogni oggetto in quel mondo materiale — e fa in modo che l'audio si adegui allo stile:
Handcrafted paper-cutout stop-motion style. A tiny paper sailboat rides
rolling waves made of layered blue cardboard; a paper whale surfaces beside
it, spouting a burst of white paper confetti, then dives back under. The sun
is a crinkled gold-foil disc in a construction-paper sky. Slightly jittery
stop-motion cadence, soft studio light, visible paper grain and hand-cut
edges throughout. Gentle ukulele plucks over a soft ocean whoosh.
Parametri: resolution: 720P, duration: 5 — costo $0.50.
Output one-shot:
Lo stile viene mantenuto in ogni fotogramma: le onde sono chiaramente cartone stratificato che scivola su se stesso, la balena spruzza coriandoli di carta bianca invece che acqua, e il sole di foglia d'oro conserva la sua texture increspata mentre la luce lo attraversa. La catena di azioni si svolge nell'ordine scritto — la balena emerge, soffia, si rituffa — ed è così che controlli la timeline in una clip di cinque secondi. Due regole sostengono questa ricetta: dichiara lo stile nella prima frase (una parola di stile sepolta a metà prompt tende a scivolare verso il realismo) e traduci ogni effetto fisico nel medium — chiedere "coriandoli di carta" invece di "spruzzi" è la differenza tra stile e filtro.
Ricetta 3: movimento di camera con una ricompensa narrativa
Pura autorialità della camera: la scena è solo lo sfondo, la camera è il contenuto. Nomina il movimento, dagli una traiettoria e — la parte che quasi tutti i prompt saltano — dagli un finale:
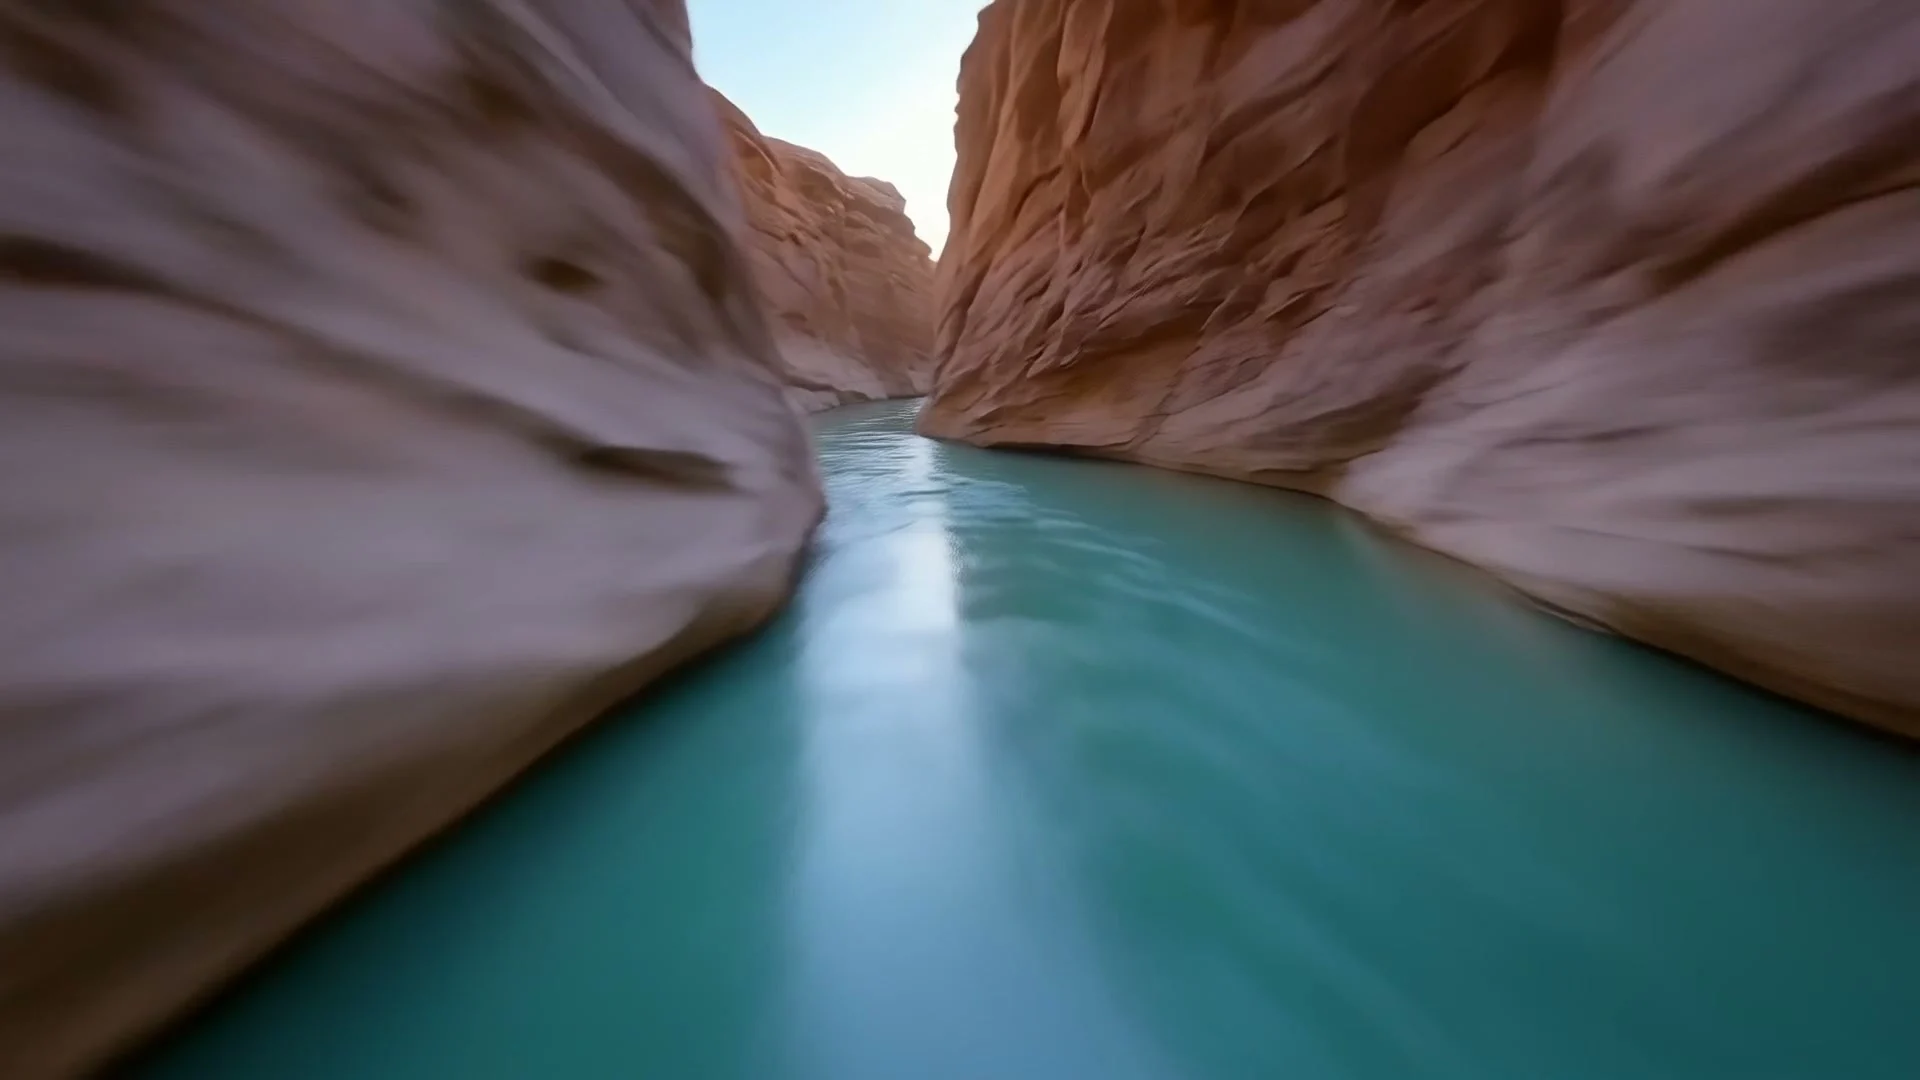
FPV drone shot racing low over a turquoise river through a narrow slot canyon
at sunrise, banking left and right with the curves of the canyon walls, then
pulling up sharply over the rim to reveal a vast desert plain glowing gold in
the morning haze. Motion blur on the near canyon walls, lens flare as the sun
crests the rim, smooth confident racing-drone motion, no cuts. Rushing wind
and a deep ambient synth swell that opens up on the reveal.
Parametri: resolution: 1080P, duration: 5 — costo $0.835.
Output one-shot:
La clip ha un arco reale: quattro secondi di virate nel canyon, con motion blur sulle pareti vicine, poi la salita che completa la rivelazione — il deserto illuminato dal sole che si estende fino all'orizzonte. Quell'arco deriva dalla forma del prompt: volo radente → virate lungo le curve del canyon → salita → rivelazione. Una traiettoria con una destinazione batte ogni volta una pila di aggettivi sulla camera. Nota la guida audio — "un crescendo di synth che si apre sulla rivelazione" lega il sound design al battito narrativo dell'inquadratura, cosa che solo un modello con audio nativo può eseguire da un unico prompt.
Promemoria rapido
Cinque regole, distillate da queste esecuzioni e dai tentativi che non sono entrati nell'articolo:
- L'ordine delle frasi è la tua timeline. wan2.7 esegue le azioni nell'ordine in cui sono scritte — disponi il prompt come indicazioni di scena, non come una descrizione.
- Inizia con lo stile. La prima frase imposta la modalità di rendering; il realismo è il valore predefinito e le parole di stile devono superarlo subito.
- Un'istruzione di camera per clip. Dolly, oppure volo FPV, oppure camera fissa. Movimenti sovrapposti si annullano a vicenda in una poltiglia.
- Scrivi la colonna sonora. Una clausola audio — cosa risuona, cosa sta sotto — ti regala una clip con colonna sonora. Il silenzio nel prompt non significa silenzio nell'output; significa che il modello sta indovinando.
- Dai al movimento una destinazione. "Salire oltre il bordo per rivelare la pianura" produce un arco; "riprendere con drone dinamico" produce un vagare.
Quanto costa
wan2.7-video/text-to-video si fattura al secondo di video prodotto, con tariffa determinata dalla risoluzione:
| Risoluzione | Prezzo | Clip da 5 secondi | Clip da 15 secondi (massimo) |
|---|---|---|---|
| 720P | $0.10 / secondo | $0.50 | $1.50 |
| 1080P | $0.167 / secondo | $0.835 | $2.505 |
Le tre clip di questo articolo — dieci secondi in 720P più cinque secondi in 1080P, tutte con audio nativo — sono costate in totale $1.84, e poiché i task girano in parallelo lato server l'intero lotto di file era su disco circa sei minuti dopo il primo invio. Le tariffe attuali sono sempre sulla pagina dei prezzi.
Provalo
Se hai già un'immagine che ti piace, wan2.7-video/image-to-video la anima allo stesso prezzo al secondo — l'articolo sulle ricette i2v è il gemello di questo. Per tutto ciò che sai descrivere ma non hai ancora girato, prendi uno qualsiasi dei prompt qui sopra, cambia i sostantivi e invialo all'API task — la pagina del modello wan2.7-video/text-to-video ha il riferimento live dei parametri. Una bozza in 720P costa $0.50 e torna in pochi minuti; riserva il 1080P ai prompt che hanno superato la prova.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori