
Guía de uso
Recetas de prompts de texto a vídeo de Wan 2.7: 3 prompts listos para copiar y sus resultados reales
Tres recetas de prompts de un solo intento para wan2.7-video/text-to-video: una escena fotorrealista, un estilo visual fijado y un movimiento de cámara con recompensa narrativa; cada una incluye su prompt exacto, el clip que realmente generó y por qué funciona.
El texto a vídeo es la zona profunda de la creación de prompts. Con imagen a vídeo le das al modelo un fotograma y solo describes el movimiento: ya cubrimos ese método aquí. El texto a vídeo no tiene imagen: un texto debe soportar la escena, la actuación del sujeto, la cámara, el estilo visual y, como wan2.7 genera audio de forma nativa, también la banda sonora.
Esta guía te ofrece tres recetas de prompts listas para copiar para wan2.7-video/text-to-video, el modelo de texto a vídeo Tongyi Wanxiang 2.7 de Alibaba; cada receta corresponde a una de las tareas que todo prompt de texto a vídeo debe cumplir: una escena fotorrealista, un estilo visual fijado y un movimiento de cámara con recompensa narrativa. Cada clip a continuación es la salida real y de un solo intento del prompt impreso junto a él, generada mediante la API de tareas de hiapi: sin selección entre semillas, sin reintentos. Los tres clips costaron $1.84 en total.
Estructura de la solicitud (léelo primero)
wan2.7 texto a vídeo se ejecuta en el endpoint de tareas asíncronas de hiapi, y la entrada es sorprendentemente pequeña: solo tres campos:
prompt: la película entera: escena, acción, cámara, estilo, sonido.resolution: valor de enumeración:720Po1080P, sin otras opciones.duration: en segundos, con un máximo de 15.
No hay arreglos de medios, ni control de relación de aspecto, ni campo de prompt negativo. A diferencia del modelo hermano i2v, aquí no hay nada que subir; esa es precisamente la razón por la que el prompt debe trabajar más.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/text-to-video",
    "input": {
      "prompt": "Night street food market in a narrow alley. A cook in a white apron tosses noodles in a flaming wok...",
      "resolution": "720P",
      "duration": 5
    }
  }'
La respuesta devuelve inmediatamente un taskId; consulta GET /v1/tasks/{taskId} hasta que status sea success y luego descarga output[0].url. Hay dos cosas que conviene saber sobre lo que devuelve:
- El archivo incluye una pista de audio real. Cada clip de este artículo se entrega en H.264 a 30 fps con audio AAC generado a partir de las indicaciones de sonido del prompt; verificamos los niveles y no es una pista de relleno silenciosa.
- Las URL de salida caducan. Descarga el archivo y guárdalo en tu propio bucket en cuanto la tarea tenga éxito; aquí puedes ver qué pasa si no lo haces.
Receta 1: escena fotorrealista
La habilidad básica: lograr que cinco segundos parezcan metraje real y no «vídeo de IA». La receta es una pila ordenada: escena, acción del sujeto, vida de fondo, cámara, sonido, estilo de imagen; una cláusula para cada elemento:
Night street food market in a narrow alley. A cook in a white apron tosses
noodles in a flaming wok; sparks and steam burst upward, glowing under a
string of red lanterns. Customers drift past as soft bokeh in the background.
The camera slowly dollies in toward the wok. Sizzling oil crackles over the
low murmur of the crowd and distant rain. Cinematic handheld feel, 35mm lens,
shallow depth of field, warm tungsten highlights against cool blue shadows.
Parámetros: resolution: 720P, duration: 5: coste de $0.50.
Salida de un solo intento:
Observa lo que hizo el modelo con cada capa: la llama y el vapor del wok se animan de forma continua, los transeúntes cruzan el encuadre como formas desenfocadas, exactamente donde el prompt los colocó («soft bokeh in the background»), y el travelling de avance es real: al cuarto segundo el wok ya llena el encuadre. Activa el sonido: el chisporroteo flota sobre el murmullo de la multitud, directamente desde la cláusula de audio. El truco estructural es exactamente una cláusula por elemento y exactamente una instrucción de cámara. Los prompts fotorrealistas suelen fallar por saturación —tres ideas de cámara y un sistema meteorológico en un párrafo— no por falta de detalle.
Receta 2: estilo fijado
El segundo uso del texto a vídeo: contenido estilizado donde el medio mismo es el mensaje. La receta abre con una declaración de estilo y luego mantiene cada objeto dentro de ese mundo material, y hace que el audio coincida con el estilo:
Handcrafted paper-cutout stop-motion style. A tiny paper sailboat rides
rolling waves made of layered blue cardboard; a paper whale surfaces beside
it, spouting a burst of white paper confetti, then dives back under. The sun
is a crinkled gold-foil disc in a construction-paper sky. Slightly jittery
stop-motion cadence, soft studio light, visible paper grain and hand-cut
edges throughout. Gentle ukulele plucks over a soft ocean whoosh.
Parámetros: resolution: 720P, duration: 5: coste de $0.50.
Salida de un solo intento:
El estilo se mantiene en cada fotograma: las olas son claramente cartón laminado deslizándose unas sobre otras, la ballena expulsa confeti de papel blanco en lugar de agua y el sol de pan de oro conserva su textura arrugada cuando la luz lo roza. La cadena de acciones se ejecuta en el orden escrito —la ballena emerge, expulsa el chorro, vuelve a sumergirse— y ese es tu control de la línea temporal en un clip de cinco segundos. Dos reglas sostienen esta receta: declara el estilo en la primera frase (las palabras de estilo enterradas en medio del prompt se filtran hacia el realismo) y convierte cada efecto físico en el medio: pedir «confeti de papel» en lugar de «salpicadura» es la diferencia entre estilo y filtro.
Receta 3: movimiento de cámara con recompensa narrativa
Autoría pura de cámara: la escena es solo el decorado y la cámara es el contenido. Nombra el movimiento, dale una trayectoria y —la parte que casi todos los prompts omiten— dale un desenlace:
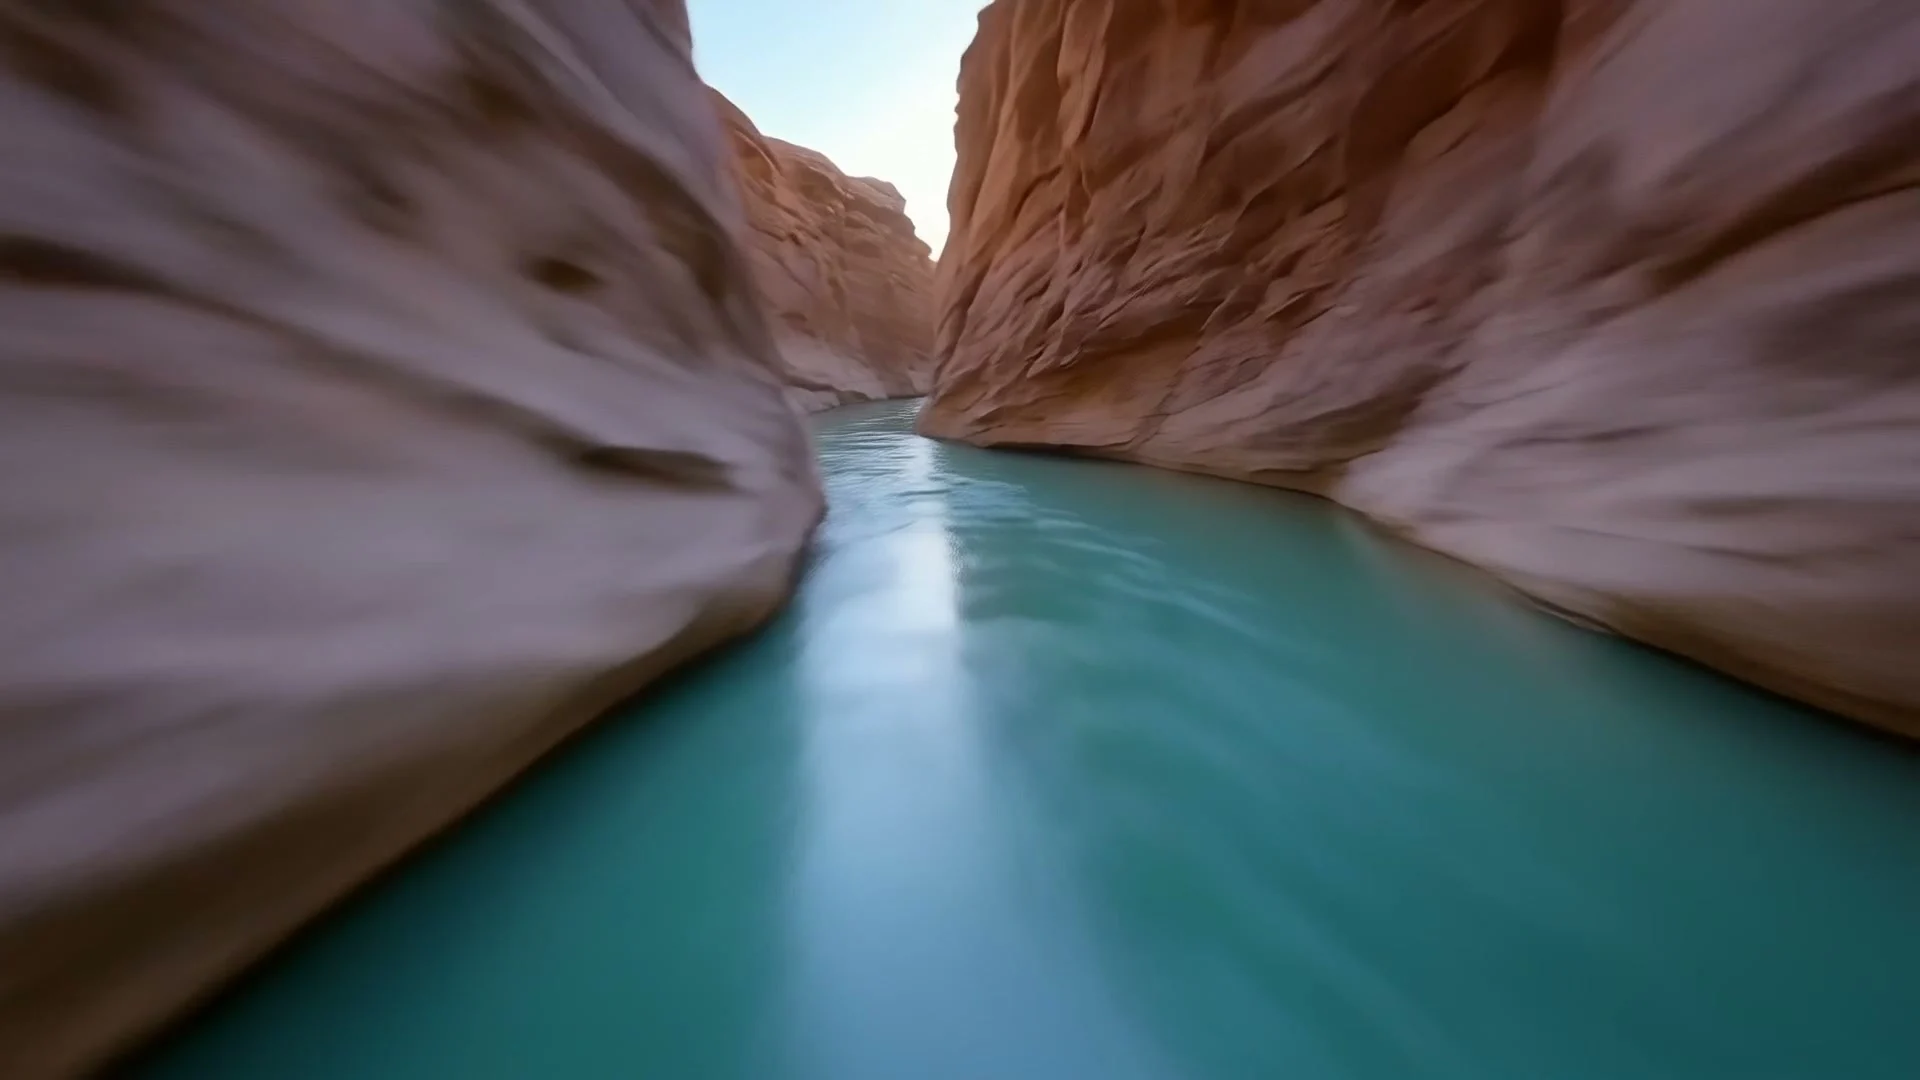
FPV drone shot racing low over a turquoise river through a narrow slot canyon
at sunrise, banking left and right with the curves of the canyon walls, then
pulling up sharply over the rim to reveal a vast desert plain glowing gold in
the morning haze. Motion blur on the near canyon walls, lens flare as the sun
crests the rim, smooth confident racing-drone motion, no cuts. Rushing wind
and a deep ambient synth swell that opens up on the reveal.
Parámetros: resolution: 1080P, duration: 5: coste de $0.835.
Salida de un solo intento:
El clip tiene un arco real: cuatro segundos inclinándose por el cañón con desenfoque de movimiento en las paredes cercanas y luego el ascenso para completar la revelación: un desierto bañado por el sol que se extiende hasta el horizonte. Ese arco proviene de la forma del prompt: carrera a baja altura → inclinarse con las curvas del cañón → ascenso → revelación. Una trayectoria con destino supera cada vez a un montón de adjetivos de cámara. Fíjate en la indicación de audio: «synthetic swell opens up on the reveal» ata el diseño sonoro al pulso narrativo del plano, algo que solo un modelo con audio nativo puede ejecutar desde un único prompt.
Chuleta
Cinco reglas destiladas de estas ejecuciones y de los intentos que no llegaron a este artículo:
- El orden de las frases es tu línea temporal. wan2.7 reproduce las acciones en el orden escrito: ordena el prompt como indicaciones escénicas, no como una descripción.
- Empieza por el estilo. La primera frase fija el modo de renderizado; el realismo es el valor por defecto y las palabras de estilo deben imponerse pronto.
- Una instrucción de cámara por clip. Travelling de avance, o vuelo FPV, o cámara fija. Los movimientos apilados se anulan entre sí y producen una masa confusa.
- Escribe la banda sonora. Una cláusula de audio —qué suena, qué hay debajo— te da un clip con banda sonora gratis. El silencio en el prompt no significa silencio en la salida; significa que el modelo está adivinando.
- Dale un destino al movimiento. «Ascender sobre el borde para revelar la llanura» produce un arco; «toma aérea dinámica con dron» produce un vagabundeo.
Cuánto cuesta
wan2.7-video/text-to-video se factura por segundo de vídeo de salida, con una tarifa que depende de la resolución:
| Resolución | Precio | Clip de 5 segundos | Clip de 15 segundos (máximo) |
|---|---|---|---|
| 720P | $0.10 / segundo | $0.50 | $1.50 |
| 1080P | $0.167 / segundo | $0.835 | $2.505 |
Los tres clips de este artículo —diez segundos en 720P más cinco segundos en 1080P, todos con audio nativo— costaron en total $1.84, y como las tareas se ejecutan en paralelo en el servidor, todos los archivos estuvieron listos unos seis minutos después del primer envío. Las tarifas vigentes están siempre en la página de precios.
Pruébalo
Si ya tienes una imagen que te gusta, wan2.7-video/image-to-video la anima al mismo precio por segundo; el artículo de recetas i2v es el complemento de este. Para todo lo que puedes describir pero aún no has rodado, toma cualquiera de los prompts anteriores, cambia los sustantivos y envíalo a la API de tareas; la página del modelo wan2.7-video/text-to-video tiene la referencia de parámetros en vivo. Un primer borrador en 720P cuesta $0.50 y vuelve en pocos minutos; reserva el 1080P para prompts que resisten las pruebas.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores