
Benutzerhandbuch
Wan 2.7 Text-zu-Video-Prompt-Rezepte: 3 direkt kopierbare Prompts und echte Ausgaben
Drei Einmal-Prompt-Rezepte für wan2.7-video/text-to-video – eine fotorealistische Szene, ein festgelegter visueller Stil und eine Kamerabewegung mit erzählerischer Auflösung – jeweils mit dem exakten Prompt, dem tatsächlich erzeugten Clip und der Begründung, warum er funktioniert.
Text-zu-Video ist das tiefe Wasser der Prompt-Gestaltung. Bei Bild-zu-Video gibst du dem Modell ein Bild und beschreibst nur die Bewegung – diesen Ansatz haben wir hier bereits vorgestellt. Bei Text-zu-Video gibt es kein Bild: Ein Text muss die Szene, die Performance des Motivs, die Kamera, den visuellen Stil und – da wan2.7 native Audio generiert – auch die Tonspur tragen.
Dieser Leitfaden liefert dir drei direkt kopierbare Prompt-Rezepte für wan2.7-video/text-to-video, das Text-zu-Video-Modell von Alibabas Tongyi Wanxiang 2.7. Jedes Rezept deckt eine Aufgabe ab, die ein Text-zu-Video-Prompt erfüllen muss: eine fotorealistische Szene, einen festgelegten visuellen Stil und eine Kamerabewegung mit erzählerischer Auflösung. Jeder Clip unten ist eine echte Einmal-Ausgabe des daneben abgedruckten Prompts, erzeugt über die hiapi Task-API – keine Auswahl über mehrere Seeds, keine Wiederholungen. Die drei Clips kosteten zusammen 1,84 $.
Anfragestruktur (bitte zuerst lesen)
wan2.7 Text-zu-Video läuft auf hiapis asynchronem Task-Endpunkt, und die Eingabe ist erstaunlich klein – nur drei Felder:
prompt– der ganze Film: Szene, Aktion, Kamera, Stil, Ton.resolution– Enum-Wert:720Poder1080P, keine weiteren Optionen.duration– in Sekunden, maximal 15.
Keine Media-Arrays, kein Seitenverhältnis-Regler, kein Feld für negative Prompts. Anders als das i2v-Schwestermodell muss hier nichts hochgeladen werden – genau deshalb müssen die Prompts härter arbeiten.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/text-to-video",
    "input": {
      "prompt": "Night street food market in a narrow alley. A cook in a white apron tosses noodles in a flaming wok...",
      "resolution": "720P",
      "duration": 5
    }
  }'
Die Antwort liefert sofort eine taskId; frage GET /v1/tasks/{taskId} ab, bis status gleich success ist, und lade dann output[0].url herunter. Zwei Dinge zur zurückgegebenen Datei sollte man wissen:
- Die Datei enthält eine echte Tonspur. Jeder Clip in diesem Artikel wird als H.264 mit 30 fps ausgeliefert, mit AAC-Audio, das anhand der Tonhinweise im Prompt generiert wurde – wir haben die Pegel geprüft, es ist keine stille Platzhalterspur.
- Ausgabe-URLs laufen ab. Lade die Datei sofort nach erfolgreichem Task herunter und speichere sie in deinem eigenen Bucket – was passiert, wenn du das nicht tust, liest du hier.
Rezept 1: Eine fotorealistische Szene
Die Grundfertigkeit: fünf Sekunden erzeugen, die wie echtes Filmmaterial aussehen und nicht wie „KI-Video“. Das Rezept ist ein geordneter Stapel – Szene, Aktion des Motivs, Hintergrundleben, Kamera, Ton, Bildstil – jeweils ein Nebensatz pro Punkt:
Night street food market in a narrow alley. A cook in a white apron tosses
noodles in a flaming wok; sparks and steam burst upward, glowing under a
string of red lanterns. Customers drift past as soft bokeh in the background.
The camera slowly dollies in toward the wok. Sizzling oil crackles over the
low murmur of the crowd and distant rain. Cinematic handheld feel, 35mm lens,
shallow depth of field, warm tungsten highlights against cool blue shadows.
Parameter: resolution: 720P, duration: 5 – Kosten: 0,50 $.
Einmal-Ausgabe:
Beobachte, was das Modell mit jeder Ebene gemacht hat: Die Flammen und der Dampf im Wok animieren durchgehend, Passanten ziehen als unscharfe Formen durchs Bild, genau dort platziert, wo der Prompt sie verortet („soft bokeh im Hintergrund“), und der Dolly-in ist echt – in der vierten Sekunde füllt der Wok das Bild. Schalte den Ton ein: Das Zischen liegt über dem Murmeln der Menge, direkt aus dem Audio-Nebensatz. Der strukturelle Trick ist, dass jedes Element genau einen Nebensatz bekommt und die Kamera genau eine Anweisung. Fotorealistische Prompts scheitern am häufigsten an Überladung – drei Kamerideen und ein Wettersystem in einem Textabsatz – und nicht an fehlenden Details.
Rezept 2: Ein festgelegter Stil
Die zweite Verwendung von Text-zu-Video: stilisierte Inhalte, bei denen das Medium selbst die Botschaft ist. Das Rezept beginnt mit einer Stil-Erklärung, hält dann jedes Objekt in dieser Materialwelt – und lässt das Audio zum Stil passen:
Handcrafted paper-cutout stop-motion style. A tiny paper sailboat rides
rolling waves made of layered blue cardboard; a paper whale surfaces beside
it, spouting a burst of white paper confetti, then dives back under. The sun
is a crinkled gold-foil disc in a construction-paper sky. Slightly jittery
stop-motion cadence, soft studio light, visible paper grain and hand-cut
edges throughout. Gentle ukulele plucks over a soft ocean whoosh.
Parameter: resolution: 720P, duration: 5 – Kosten: 0,50 $.
Einmal-Ausgabe:
Der Stil bleibt in jedem Frame erhalten: Die Wellen sind eindeutig geschichtete Pappe, die übereinander gleitet, der Wal stößt weißes Papierkonfetti statt Wasser aus, und die Goldfolien-Sonne behält ihre knitterige Textur, während das Licht über sie streicht. Die Aktionskette läuft in der geschriebenen Reihenfolge ab – der Wal taucht auf, stößt aus, taucht wieder unter – das ist deine Timeline-Kontrolle in einem Fünf-Sekunden-Clip. Zwei Regeln tragen dieses Rezept: Stil im ersten Satz erklären (Stilwörter, die mitten im Prompt vergraben sind, bluten in den Realismus durch), und jede Physik in das Medium übersetzen – nach „Papierkonfetti“ statt „Spritzer“ zu fragen, ist der Unterschied zwischen Stil und Filter.
Rezept 3: Kamerabewegung mit erzählerischer Auflösung
Reine Kamera-Autorschaft: Die Szene ist nur die Kulisse, die Kamera ist der Inhalt. Benenne die Bewegung, gib ihr eine Bahn und – der Teil, den die meisten Prompts auslassen – gib ihr ein Ende:
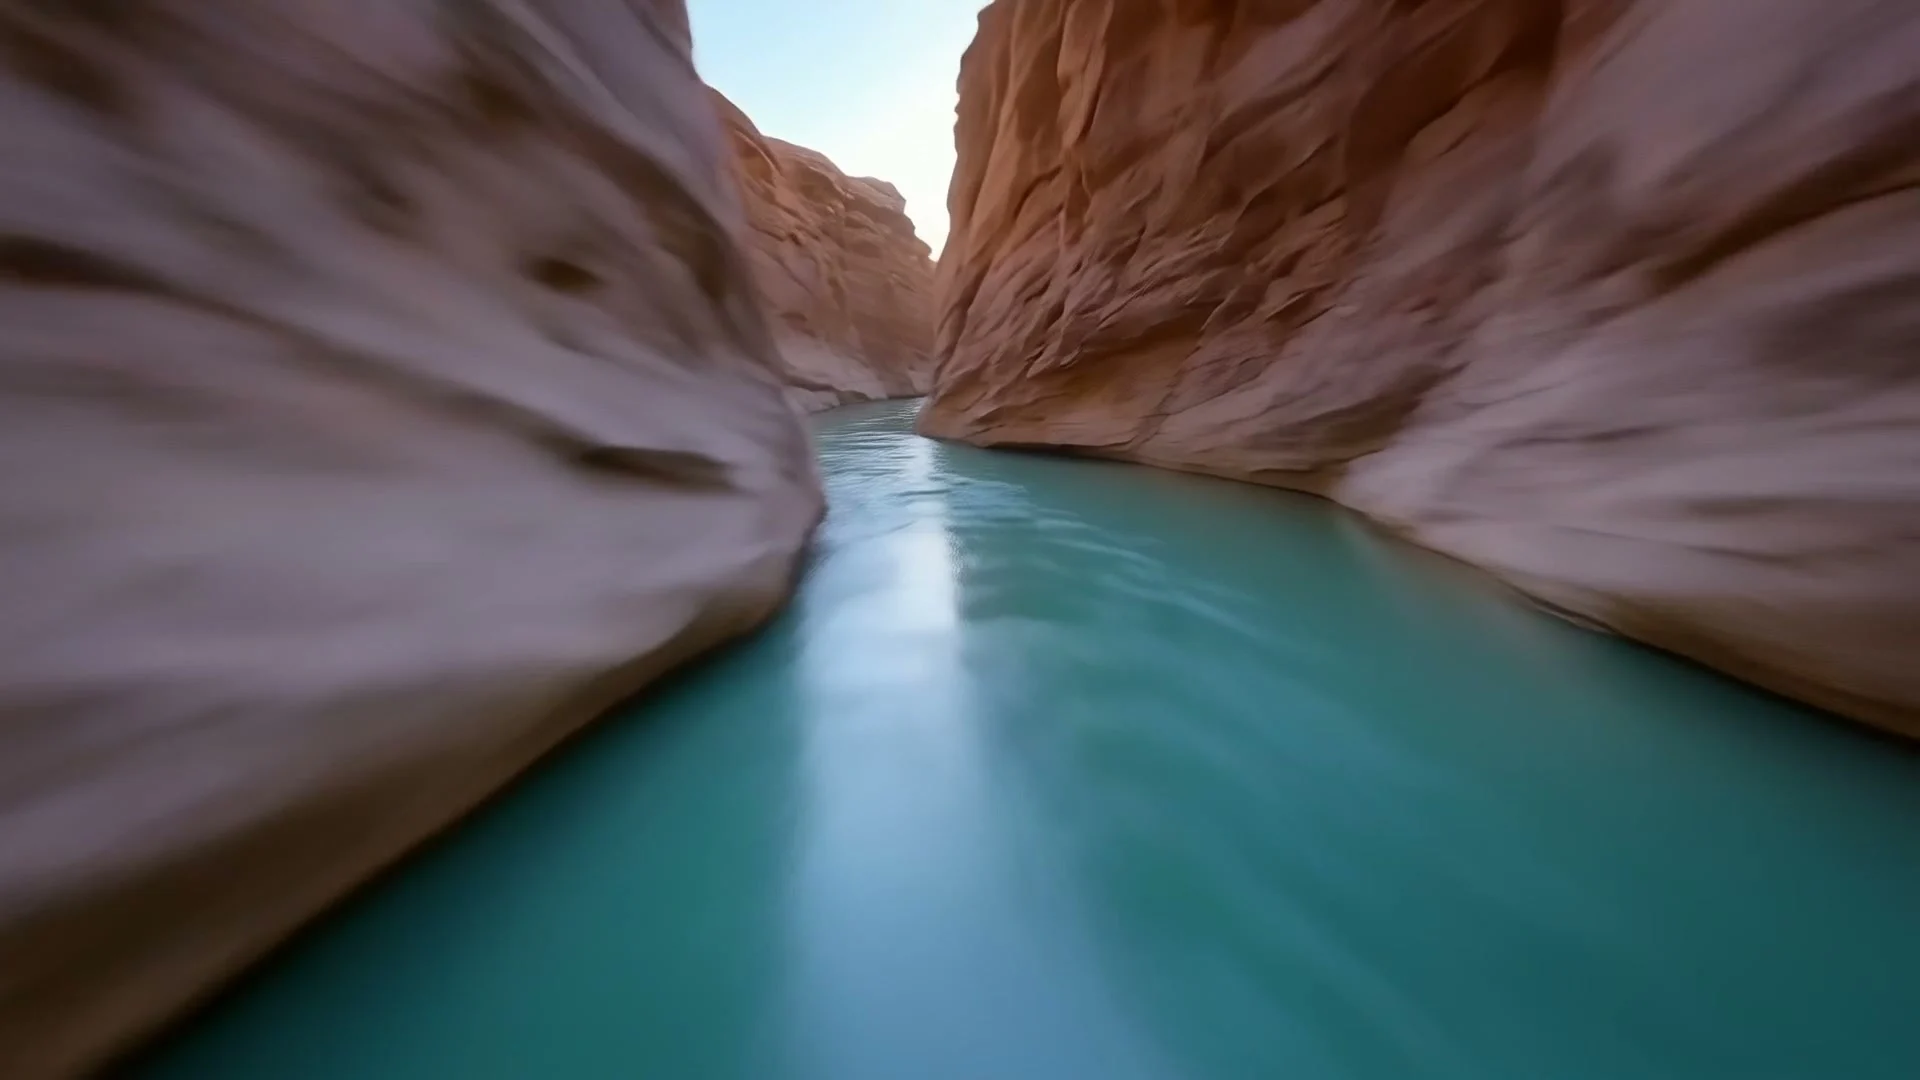
FPV drone shot racing low over a turquoise river through a narrow slot canyon
at sunrise, banking left and right with the curves of the canyon walls, then
pulling up sharply over the rim to reveal a vast desert plain glowing gold in
the morning haze. Motion blur on the near canyon walls, lens flare as the sun
crests the rim, smooth confident racing-drone motion, no cuts. Rushing wind
and a deep ambient synth swell that opens up on the reveal.
Parameter: resolution: 1080P, duration: 5 – Kosten: 0,835 $.
Einmal-Ausgabe:
Der Clip hat einen echten Bogen: vier Sekunden lang schlängelt er sich mit Bewegungsunschärfe an den nahen Wänden durch den Canyon, dann zieht er nach oben und vollendet die Enthüllung – eine sonnenbeschienene Wüste bis zum Horizont. Dieser Bogen kommt aus der Form des Prompts: tiefer Rennflug → Neigung mit den Kurven der Canyonwände → Steigflug → zur Enthüllung. Eine Bahn mit Ziel schlägt jedes Mal eine Ansammlung von Kamera-Adjektiven. Beachte die Audio-Anweisung – „Synth-Anschwellung, die sich bei der Enthüllung öffnet“ bindet das Sounddesign an den narrativen Takt der Kamera, etwas, das nur ein Modell mit nativem Audio aus einem einzigen Prompt heraus umsetzen kann.
Schnellreferenz
Fünf Regeln, destilliert aus diesen Läufen und den Versuchen, die es nicht in diesen Artikel geschafft haben:
- Satzreihenfolge ist deine Timeline. wan2.7 spielt Aktionen in der geschriebenen Reihenfolge ab – ordne den Prompt wie Bühnenanweisungen an, nicht wie eine Beschreibung.
- Beginne mit dem Stil. Der erste Satz legt den Rendering-Modus fest; Realismus ist der Standard, Stilwörter müssen ihn früh übertrumpfen.
- Eine Kameranweisung pro Clip. Dolly-in oder FPV-Flug oder feste Kamera. Gestapelte Bewegungen heben sich gegenseitig zu Matsch auf.
- Schreibe die Tonspur. Ein Audio-Nebensatz – was klingt, was darunter liegt – liefert dir kostenlos einen Clip mit Ton. Stille im Prompt bedeutet nicht Stille in der Ausgabe; sie bedeutet, dass das Modell rät.
- Gib der Bewegung ein Ziel. „Steigflug über den Rand zur Enthüllung der Ebene“ erzeugt einen Bogen; „dynamische Drohnenaufnahme“ erzeugt ein Umherwandern.
Was es kostet
wan2.7-video/text-to-video wird pro Sekunde Ausgabevideo abgerechnet, der Tarif richtet sich nach der Auflösung:
| Auflösung | Preis | 5-Sekunden-Clip | 15-Sekunden-Clip (Maximum) |
|---|---|---|---|
| 720P | 0,10 $ / Sek. | 0,50 $ | 1,50 $ |
| 1080P | 0,167 $ / Sek. | 0,835 $ | 2,505 $ |
Die drei Clips in diesem Artikel – zehn Sekunden 720P plus fünf Sekunden 1080P, alle mit nativem Audio – kosteten zusammen 1,84 $, und da die Tasks serverseitig parallel laufen, lagen alle Dateien des Batches etwa sechs Minuten nach der ersten Einreichung vor. Die aktuellen Tarife findest du immer auf der Preisseite.
Probier es aus
Wenn du bereits ein Bild hast, das dir gefällt, animiert wan2.7-video/image-to-video es zum selben Sekundenpreis – der i2v-Rezeptartikel ist das Schwesterstück zu diesem Text. Für alles, was du beschreiben, aber noch nicht filmen kannst: nimm einen der obigen Prompts, tausche die Nomen und reiche ihn bei der Task-API ein – die Modellseite von wan2.7-video/text-to-video enthält eine Live-Parameterreferenz. Ein 720P-Entwurf kostet 0,50 $ und kommt in wenigen Minuten zurück; spare dir 1080P für Prompts auf, die die Probe bestehen.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte