
Руководство
gpt-5.6-terra 实战指南:5 个高价值 текстовых сценариев и ключевые моменты внедрения
От выбора сценариев до ключевых моментов интеграции — решение реальных бизнес-задач с помощью текстовой модели
Почему текстовую модель стоит выбирать отдельно
В обсуждениях выбора модели многие по умолчанию считают «умение видеть изображения» и «умение генерировать изображения» мерилом возможностей модели, но для подавляющего большинства бизнес-систем в production-цепочке по-прежнему работают вызовы с текстовым входом и текстовым выходом. gpt-5.6-terra — новая текстовая модель от OpenAI: тип вывода — текст, тарификация по токенам. Если оценивать её отдельно, а не сравнивать в общем ряду с мультимодальными моделями, можно получить более чёткие выводы.
Цепочка ввода-вывода проще
Контракт вызова чисто текстовой модели очень чистый: вы передаёте текст (или набор сообщений) — она возвращает текст. Нет дополнительных переменных вроде кодирования изображений, согласования разрешения, обрезки длительности аудио и видео. Это значит, что при отладке нужно следить только за двумя вещами — промптом и контекстом. Цепочка короткая — проблемы локализуются быстро, и стоимость разбора инцидентов в проде ниже.
Структура затрат легче прогнозируется
Преимущество тарификации по токенам — её можно посчитать. Длина входа, длина выхода, число повторов — этого в основном достаточно, чтобы оценить стоимость одного вызова. Мультимодальные вызовы часто дополнительно накладывают тарификацию, связанную с обработкой медиа, и при оценке приходится учитывать больше ветвлений. Если 90% задач в вашем бизнесе — это текстовая работа вроде классификации, извлечения, переписывания и объяснения, текстовая модель — более прямой выбор.
Когда стоит использовать чисто текстовую модель
Критерий может быть очень простым: если критерий успеха задачи можно описать одним фрагментом текста или одним JSON — в первую очередь рассматривайте текстовую модель. Типичные сигналы: в требованиях встречаются «извлечь поля», «определить намерение», «переписать в другом тоне», «объяснить эти данные»; на приёмке вы можете написать явный эталонный ответ; ошибки исправляются правкой промпта или дополнением контекста, а не сменой модальности.
И наоборот: если задача сама по себе зависит от визуальной вёрстки (например, определить принадлежность таблицы по макету сканированного документа) или от аудиопросодии, текстовая модель — не основной выбор. Смешанные сценарии тоже можно разделить: сначала другими средствами преобразовать нетекстовое содержимое в текст, а затем передать его gpt-5.6-terra — так и затраты, и качество контролируются лучше.
Второй принцип выбора — не ставить всё на одну модель сразу. Оберните вызов модели в заменяемый слой, и тогда и постепенное внедрение новой модели, и откат к старой будут лишь изменением конфигурации.
Сценарий первый: структурированное извлечение из длинных документов
Договоры, финансовые отчёты, тендерная документация, медицинские заключения — бизнес-ценность таких длинных документов высока, но ручной ввод полей крайне трудоёмок. Преобразование неструктурированного длинного текста в структурированный JSON — один из самых зрелых сценариев применения текстовых моделей.
Подход к реализации
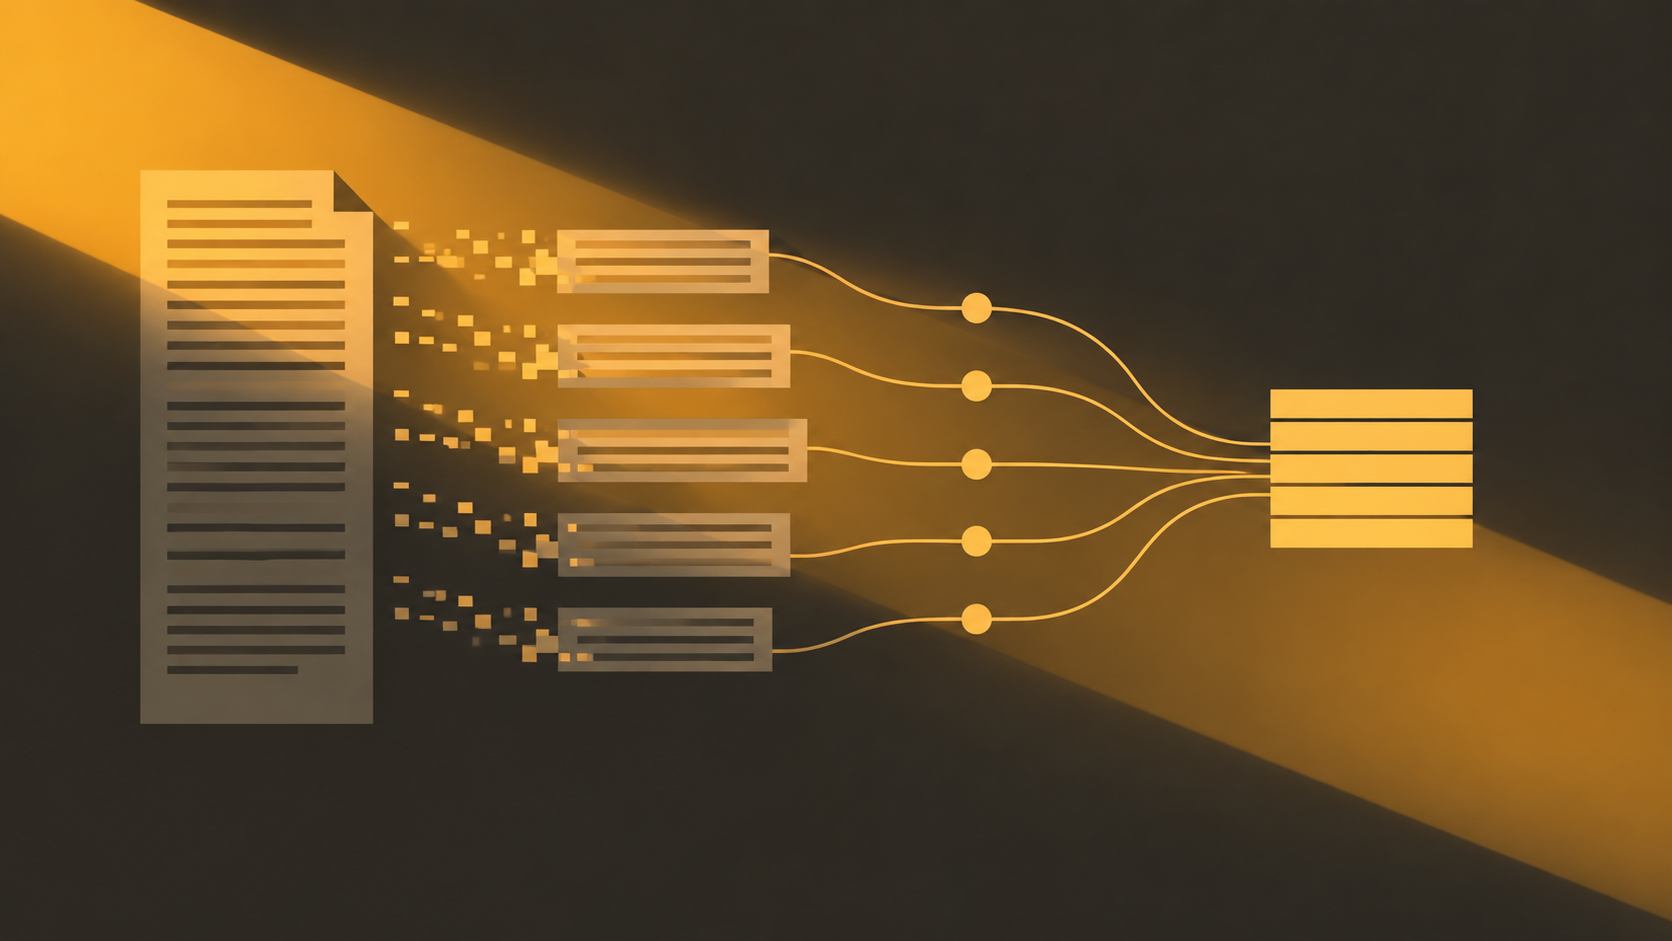
В целом это трёхступенчатая схема «нарезка — извлечение — слияние». Сначала длинный документ режется на блоки по уровням заголовков или фиксированной длине, каждый блок снабжается информацией о позиции (номер страницы, путь по разделам); затем модель по заранее заданной схеме выводит поля; наконец, на уровне приложения выполняется слияние и разрешение конфликтов.
Схему обязательно нужно зафиксировать заранее и указать в промпте типы полей, диапазоны значений и способ обозначения отсутствия. Заставить модель выводить «неизвестно», а не выдумывать значение, гораздо проще, чем потом вылавливать ошибки из грязных данных.
{
  "party_a": "string | null",
  "effective_date": "YYYY-MM-DD | null",
  "payment_terms": "string | null",
  "termination_clause": "string | null"
}
Ключевые моменты оценки и отказоустойчивости
Не судите о качестве извлечения по принципу «выглядит правильно или нет». Подготовьте размеченный набор, покрывающий различные макеты и граничные случаи, посчитайте точность по каждому полю, отдельно соберите статистику по ключевым полям (суммы, даты, названия сторон). Для числовых полей рекомендуется на уровне приложения дополнительно проверять формат и диапазон: если извлечённое моделью значение не проходит проверку — возвращайте на ручную обработку.
У длинных документов есть две частые ловушки: первая — поля, разнесённые по блокам (например, общая сумма указана в итоговой сводке в конце, а условия разбросаны по нескольким блокам); вторая — шум от таблиц, колонтитулов и нижних колонтитулов. Первую можно решить повторным слиянием на этапе объединения, вторую выгоднее очищать до нарезки.
Ключ к контролю затрат — не вставлять весь документ в контекст целиком. Обрабатывайте по блокам и вызывайте модель только для совпавших блоков — это заметно сокращает расход входных токенов.
Сценарий второй: интеллектуальная маршрутизация обращений и заявок
В основе маршрутизации заявок лежат два суждения: что это за проблема (намерение) и насколько это срочно (приоритет). Обе задачи относятся к классификации текста и отлично подходят для текстовой модели.
От свободной классификации к управляемой
Худшее — позволить модели свободно придумывать названия категорий: это быстро раздувает систему тегов и делает её непригодной для статистики. Правильный подход — задать замкнутый набор намерений, позволить модели выбрать из него и потребовать одновременно указать уверенность и обоснование решения.
Отнесите следующую заявку к одному из намерений:
[спор по счёту / сбой функции / консультация по использованию / безопасность аккаунта / другое]
и укажите приоритет [P0 / P1 / P2] и причину не длиннее 30 символов.
Содержание заявки: {{ticket_text}}
Требовать от модели обоснование нужно не для демонстрации, а для разбора. Когда ошибки классификации в какой-то категории начинают концентрироваться, по обоснованиям можно быстро понять, размыто ли определение тега или в промпте не хватает информации.
Стратегия подстраховки по уверенности
Когда модель выдаёт низкую уверенность, не стоит жёстко назначать маршрут. Надёжнее использовать запасную цепочку: при низкой уверенности направлять в ручную очередь или выполнять маршрутизацию только по «крупной категории», а не по «подкатегории», оставляя тонкое суждение человеку. Так даже при нестабильном решении модели заявка не попадёт не в ту команду и не задержит реакцию.
Поддержка в проде
Система намерений развивается вместе с бизнесом, и границы категорий тоже смещаются. Рекомендуется записывать результаты каждой ручной перенаправки и регулярно возвращать их в оценочный набор, чтобы проверять, остаются ли валидными промпт и определения тегов. С приоритетами нужно быть особенно осторожными: когда речь идёт о заявках по безопасности, лучше установить правило «модель делает только первичную фильтрацию, человек обязательно проверяет».
Сценарий третий: массовое переписывание и локализация контента
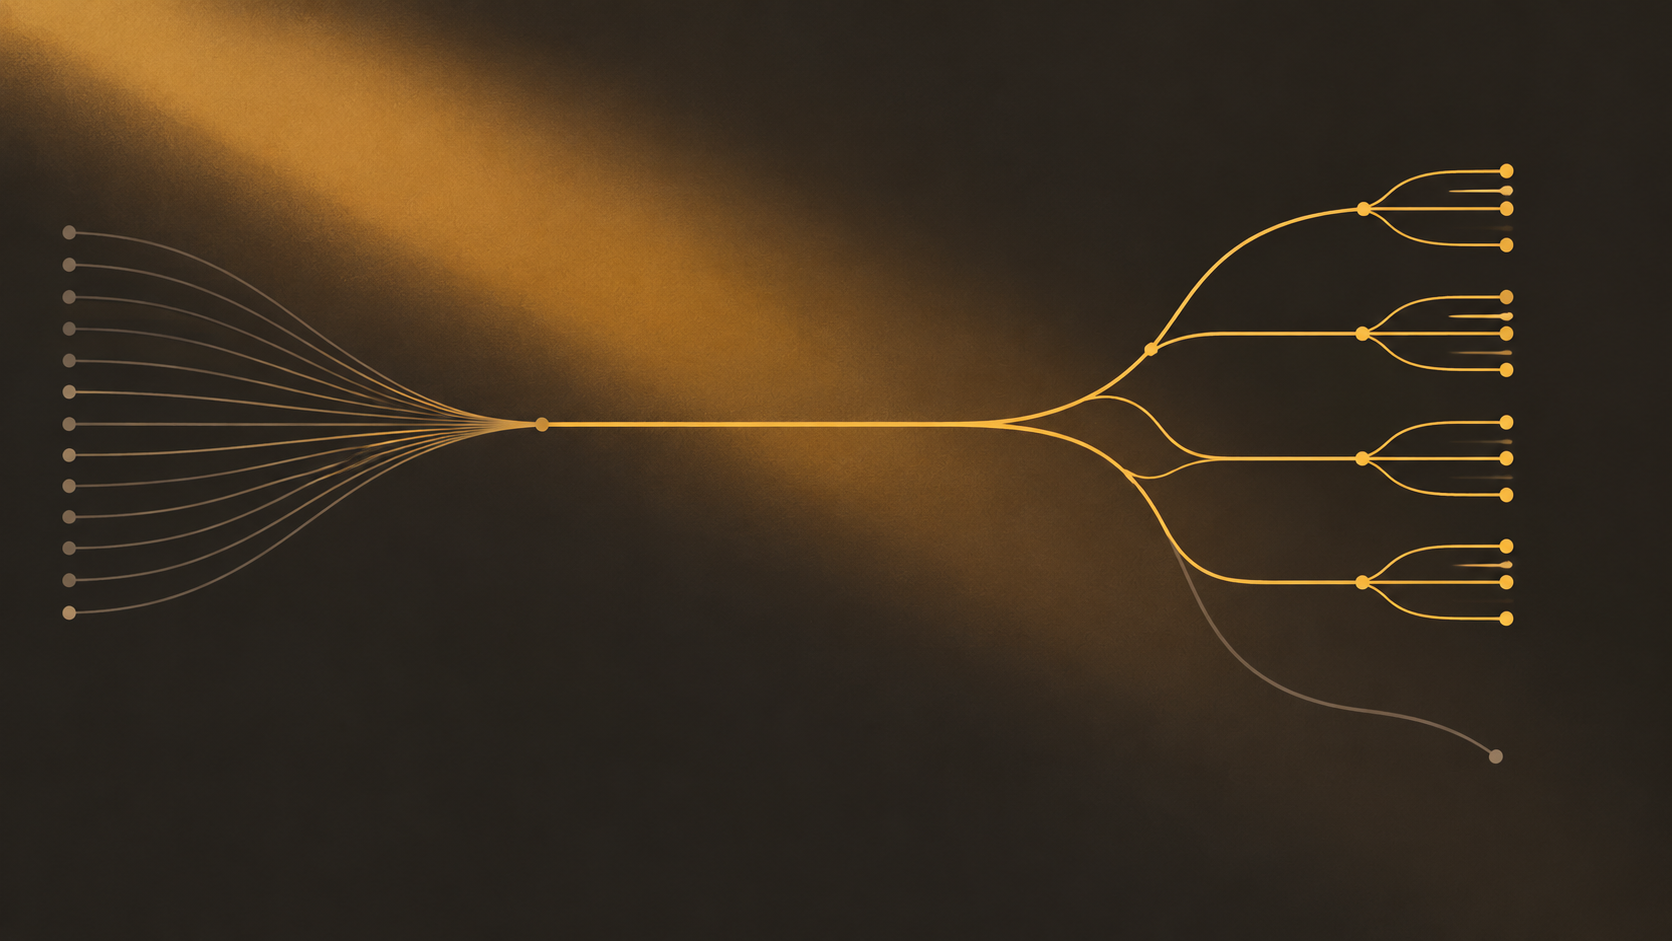
Маркетинговые тексты, описания товаров, объявления и уведомления — такого контента много, он однороден и при этом должен сохранять единый стиль, поэтому массовое переписывание — естественный сценарий. Текстовая модель здесь выполняет роль «один вход — много выходов».
Один вход, несколько выходов
Передавайте исходный текст и стилевые ограничения отдельно. Исходный текст — это содержание, стилевые ограничения — параметры: тон (официальный/неформальный), длина (уложиться в N символов), аудитория (новые пользователи/постоянные клиенты), региональные особенности речи. Так из одного набора исходных текстов можно параллельно получить несколько версий, и различия между версиями будут определяться параметрами, а не случайностью.
Перепишите следующий исходный текст в одну версию:
- Тон: {{tone}}
- Целевая аудитория: {{audience}}
- Ограничение по символам: {{max_chars}}
- Информация, которую обязательно сохранить: {{must_keep}}
Исходный текст: {{source_text}}
Поле «информация, которую обязательно сохранить» — ключевое. Самая частая ошибка массового переписывания — потеря ключевой информации (ценовой диапазон, сроки акции, условия применения); явное перечисление даёт модели чёткое обязательство сохранить её.
Механизм выборочной проверки качества
Не рассчитывайте на полную ручную проверку. Реалистичнее многоуровневая выборочная проверка: высокорисковый контент (акции, заявления о соответствии, публичные объявления) проходит полную ручную проверку; низкорисковый — проверяется по выборке. Поверх выборочной проверки добавьте автоматическую: сохранена ли ключевая информация, не превышена ли длина, нет ли запрещённых слов — всё это делается правилами почти без затрат.
Детали, которые нужно учесть при локализации
Адаптация под разные регионы — это не только замена формулировок. Единицы измерения, формат даты, привычные обращения, недопустимые сравнения — всё это нужно явно прописать в ограничениях. Рекомендуется поддерживать для каждого целевого региона отдельное руководство по стилю и фиксировать его как часть промпта, чтобы не описывать всё заново при каждом вызове.
В массовых задачах также нужно учитывать идемпотентность повторов при ошибках: дайте каждой задаче переписывания стабильный идентификатор, чтобы при перезапуске результат перезаписывался, а не дублировался.
Сценарий четвёртый: помощь в разборе кода и логов
При ошибках в проде инженеры тратят много времени на чтение логов и догадки о первопричине. Ценность текстовой модели в таких задачах — не заменить человека, а сжать гору шума в несколько упорядоченных гипотез.
Практичный способ организации входа
Отправлять модели десятки мегабайт логов — расточительство. Сначала отфильтруйте правила, вырежьте фрагмент контекста вокруг ошибки, добавьте необходимую информацию об окружении (имя сервиса, версия, цепочка вызовов), а затем попросите модель вывести ранжированные гипотезы первопричины.
Ниже фрагмент лога ошибки и информация об окружении сервиса:
{{log_snippet}}
Окружение: {{env_info}}
Приведите 3 гипотезы первопричины в порядке вероятности, к каждой добавьте способ проверки и информацию, которую нужно дополнить.
Требовать от модели способ проверки гораздо полезнее, чем просто вывод. Это подталкивает вывод к выполнимым действиям по диагностике и помогает оценить надёжность рекомендаций.
Границы безопасности
В логах часто содержатся пользовательские данные, внутренние пути, фрагменты ключей. Перед отправкой обязательно обезличьте данные: замените номера телефонов, паспортные данные, токены, внутренние адреса. Этот слой должен выполняться до вызова, нельзя полагаться на то, что модель сама их проигнорирует.
Кроме того, нужно чётко определить статус вывода модели: это рекомендации по диагностике, а не заключение. Любые операции, связанные с изменениями в проде, должны выполняться только после подтверждения инженером. Разделение «рекомендации» и «выполнения» на уровне системы позволяет избежать многих рисков.
Как измерять эффект
Выгоду в таких сценариях сложно измерить точностью, но можно использовать процессные метрики: среднее время локализации, сколько раз требовались уточняющие вопросы, доля принятых рекомендаций. Сравнение этих метрик через некоторое время после запуска убедительнее субъективных ощущений.
Сценарий пятый: вопросы и ответы на естественном языке по структурированным данным
Отчёты и результаты запросов к базе данных часто плохо читаются бизнес-пользователями; преобразование результата запроса в естественно-языковое объяснение заметно снижает порог использования. Текстовая модель здесь занимается «переводом», а не «вычислением».
Ключевой принцип: сначала запрос данных, потом объяснение
Позволять модели самой вычислять числа — зона высокого риска галлюцинаций. Правильное разделение: запросы, агрегация, статистика полностью выполняются в базе данных или на уровне приложения, модель получает уже посчитанный результат и отвечает за формулировку и дополнение контекстным объяснением.
Ниже уже посчитанные статистические данные (JSON):
{{query_result}}
Объясните бизнес-пользователю смысл этих данных в 3 предложениях и явно укажите временной диапазон и методику подсчёта.
Три способа контроля галлюцинаций
Первый — ограничить вход. Модель может отвечать только на основе заданного результата; в промпте явно требуется «не вводить числа, которых нет во входных данных».
Второй — требовать указания источника. Пусть в ответе будут временной диапазон, размер выборки, измерение статистики — увидев эту информацию, бизнес-пользователь сам сможет оценить достоверность.
Третий — обнаружение аномалий. На уровне приложения выполните обратную проверку чисел в выводе модели: любое число, которое есть в ответе, но отсутствует во входных данных, сразу блокируется или понижается до чисто шаблонного вывода.
Дизайн объяснимости
В одном и том же наборе данных разные роли заинтересованы в разном. Руководству — тренды, операционным командам — аномалии, финансам — различия в методиках подсчёта. Если зафиксировать эти ракурсы в нескольких шаблонах ответов, это будет стабильнее свободного творчества модели и проще для тестирования согласованности.
Интеграция и контроль затрат: тратить токены с умом
Тарификация gpt-5.6-terra по токенам означает, что стоимость напрямую связана с длиной входа и выхода. Инженерные решения на этапе интеграции во многом определяют, насколько будет отличаться счёт при одинаковом объёме бизнеса.
Управление контекстом — самый большой рычаг
Входные токены обычно составляют основную часть затрат. Несколько действий с немедленным эффектом:
- Передавайте только необходимые поля, не вставляйте всю запись из базы данных — сначала спроецируйте столбцы, которые реально используются в промпте.
- Сжимайте длинные диалоги в резюме, сохраняя выводы и ограничения, отбрасывая приветствия и повторы.
- Размещайте неизменные инструкции и примеры в стабильной позиции, чтобы в дальнейшем можно было использовать кэширование префикса.
- На стороне вывода ограничивайте длину структурными ограничениями и лимитом символов, чтобы модель не разворачивалась чрезмерно.
Кэширование и повторное использование
Многие бизнес-запросы сильно повторяются (однотипные заявки, один и тот же шаблонный текст). Кэширование результатов на уровне приложения для запросов с «полностью идентичным входом» напрямую снижает затраты. Учтите, что ключ кэша должен включать версию промпта и идентификатор модели, иначе после изменения промпта кэш превратится в неверные ответы.
Мониторинг использования нужно разбивать по сценариям
Не смотрите только на общий расход. Записывайте число вызовов, входные токены, выходные токены, число повторов при ошибках по сценариям и эндпоинтам. Только с этими четырьмя числами вы сможете понять, где выросли затраты: вырос трафик или промпт в каком-то сценарии незаметно удлинился.
Повторы — тоже скрытая стоимость. Настройте разумные таймауты и лимит повторов, не повторяйте запросы при явных ошибках ввода — это позволит избежать массы бесполезного расхода.
Единый слой интеграции
Оберните вызов модели во внутренний интерфейс: параметры — шаблон промпта, переменные, ограничения вывода; возвращает структурированный результат и информацию об использовании. Верхнеуровневый бизнес зависит только от этого интерфейса и не зависит напрямую ни от какого имени модели. Тогда переключение модели, постепенное внедрение новой версии, маршрутизация по сценариям — всё это меняется в одном месте конфигурации.
Валидация и итерации: решение о масштабировании на основе оценочного набора
Определять, годится ли модель, «на ощущение» — самый ошибочный путь. Небольшой, но тщательно подобранный оценочный набор перед запуском — единственный способ перевести решение из субъективной плоскости в данные.
Как собрать оценочный набор
Тысячи примеров не нужны. Для старта достаточно 100–300 примеров на каждый сценарий, покрывающих типичные случаи; главное — правильное распределение: типичные ситуации, граничные случаи и исторически проблемные места — все три категории должны присутствовать. Каждый пример должен иметь явный ожидаемый вывод или проверяемый критерий приёмки.
Метрики оценки зависят от сценария. Для извлечения — точность и полнота по полям; для маршрутизации — точность классификации и доля низкой уверенности; для переписывания — сохранность ключевой информации и оценка человека; для вопросов-ответов — согласованность чисел и оценка читаемости человеком. Метрики разные, но принцип один: воспроизводимость и сравнимость.
Постепенное внедрение и A/B-тестирование
Пройти оценку — не значит, что в проде всё в порядке. Сначала запустите на малом трафике, проведите A/B-сравнение новой модели с текущим решением, наблюдайте за двумя линиями метрик: бизнес- и стоимостными. При сравнении сохраняйте прочие переменные неизменными: тот же поток трафика, та же структура промпта, отличие только в модели.
Период наблюдения должен быть достаточно длинным, охватывать рабочие дни и пиковые часы. Если ключевые метрики не имеют значимого преимущества, не спешите с полным внедрением; если преимущество только в стоимости, но качество на том же уровне — это тоже разумное основание для переключения, но его нужно чётко зафиксировать.
Замкнутый цикл непрерывных итераций
После запуска постоянно возвращайте в оценочный набор ручные исправления, отзывы пользователей и случаи сбоев в проде. Каждый раз при изменении промпта, смене версии модели, корректировке стратегии контекста — сначала прогоняйте оценочный набор, затем решайте, выпускать ли изменения.
Модели развиваются, бизнес тоже дрейфует. Смысл этого замкнутого цикла в том, что в любой момент вы можете ответить на вопрос «каков же сейчас эффект в этом сценарии», а не искать причины задним числом после возникновения проблем. Настоящая ценность новых моделей вроде gpt-5.6-terra тоже может быть подтверждена только в измеримой системе. Сделайте слой интеграции тонким, а оценку — основательной, и стоимость переключения естественно снизится.
Похожие статьи
Все статьи →-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата