
Tutoriale
Guida pratica a gpt-5.6-terra: 5 scenari applicativi testuali ad alto valore e punti chiave per l'implementazione
Dalla scelta degli scenari ai punti chiave di integrazione: risolvere problemi aziendali reali con un modello testuale
Perché vale la pena valutare separatamente un modello testuale
Nelle discussioni sulla selezione dei modelli, molti considerano «sa vedere le immagini» e «sa generare immagini» come metri di riferimento predefiniti delle capacità di un modello; tuttavia, per la stragrande maggioranza dei sistemi aziendali, ciò che gira davvero nella catena di produzione sono ancora le chiamate con input testuale e output testuale. gpt-5.6-terra è un modello testuale appena lanciato da OpenAI: il tipo di output è testuale e il prezzo è calcolato per token. Valutarlo separatamente, invece di confrontarlo in modo generico con i modelli multimodali, permette di arrivare a conclusioni più chiare.
La catena input-output è più semplice
Il contratto di chiamata di un modello puramente testuale è molto pulito: gli si fornisce un testo (o un insieme di messaggi) e restituisce testo. Non ci sono variabili aggiuntive come la codifica delle immagini, la negoziazione della risoluzione o il troncamento della durata di audio e video. Questo significa che in fase di debug devi preoccuparti solo di due cose: il prompt e il contesto. Catena corta, individuazione rapida dei problemi e costi di troubleshooting in produzione più bassi.
La struttura dei costi è più facile da prevedere
Il vantaggio del prezzo per token è la calcolabilità. Lunghezza dell'input, lunghezza dell'output e numero di retry bastano in pratica a inquadrare il costo di una chiamata. Le chiamate multimodali spesso aggiungono anche criteri di fatturazione legati all'elaborazione dei media, e i rami da considerare nella stima sono di più. Se nel tuo business il 90% delle attività è costituito da lavori testuali come classificazione, estrazione, riscrittura e spiegazione, usare un modello testuale è la scelta più diretta.
Quando conviene usare un modello puramente testuale
Il criterio di giudizio può essere molto semplice: se il criterio di successo di un'attività si può esprimere chiaramente con un testo o un JSON, allora conviene privilegiare un modello testuale. I segnali tipici includono: nella richiesta compaiono espressioni come «estrarre campi», «determinare l'intento», «riscrivere il tono», «spiegare questi dati»; in fase di accettazione riesci a scrivere una risposta di riferimento inequivocabile; gli errori si possono correggere modificando il prompt o aggiungendo contesto, anziché cambiando modalità.
Al contrario, se l'attività dipende intrinsecamente dal layout visivo (ad esempio determinare l'appartenenza di una tabella dal layout di una scansione) o dalla prosodia audio, allora il modello testuale non è la scelta principale. Anche gli scenari misti si possono scomporre: prima convertire i contenuti non testuali in testo con altri mezzi, poi affidarli a gpt-5.6-terra; così costi e qualità sono più facili da controllare.
Il secondo principio della selezione è non puntare tutto in una sola volta. Incapsula la chiamata al modello in uno strato sostituibile: in seguito, sia che si tratti di un rilascio graduale di un nuovo modello sia di un ritorno a quello vecchio, sarà solo questione di cambiare configurazione.
Scenario uno: estrazione strutturata da documenti lunghi
Contratti, report finanziari, documenti di gara, referti medici: questi documenti lunghi hanno un alto valore aziendale, ma l'inserimento manuale dei campi richiede moltissimo tempo. Convertire testi lunghi non strutturati in JSON strutturati è uno degli scenari di applicazione più maturi per i modelli testuali.
Approccio di implementazione
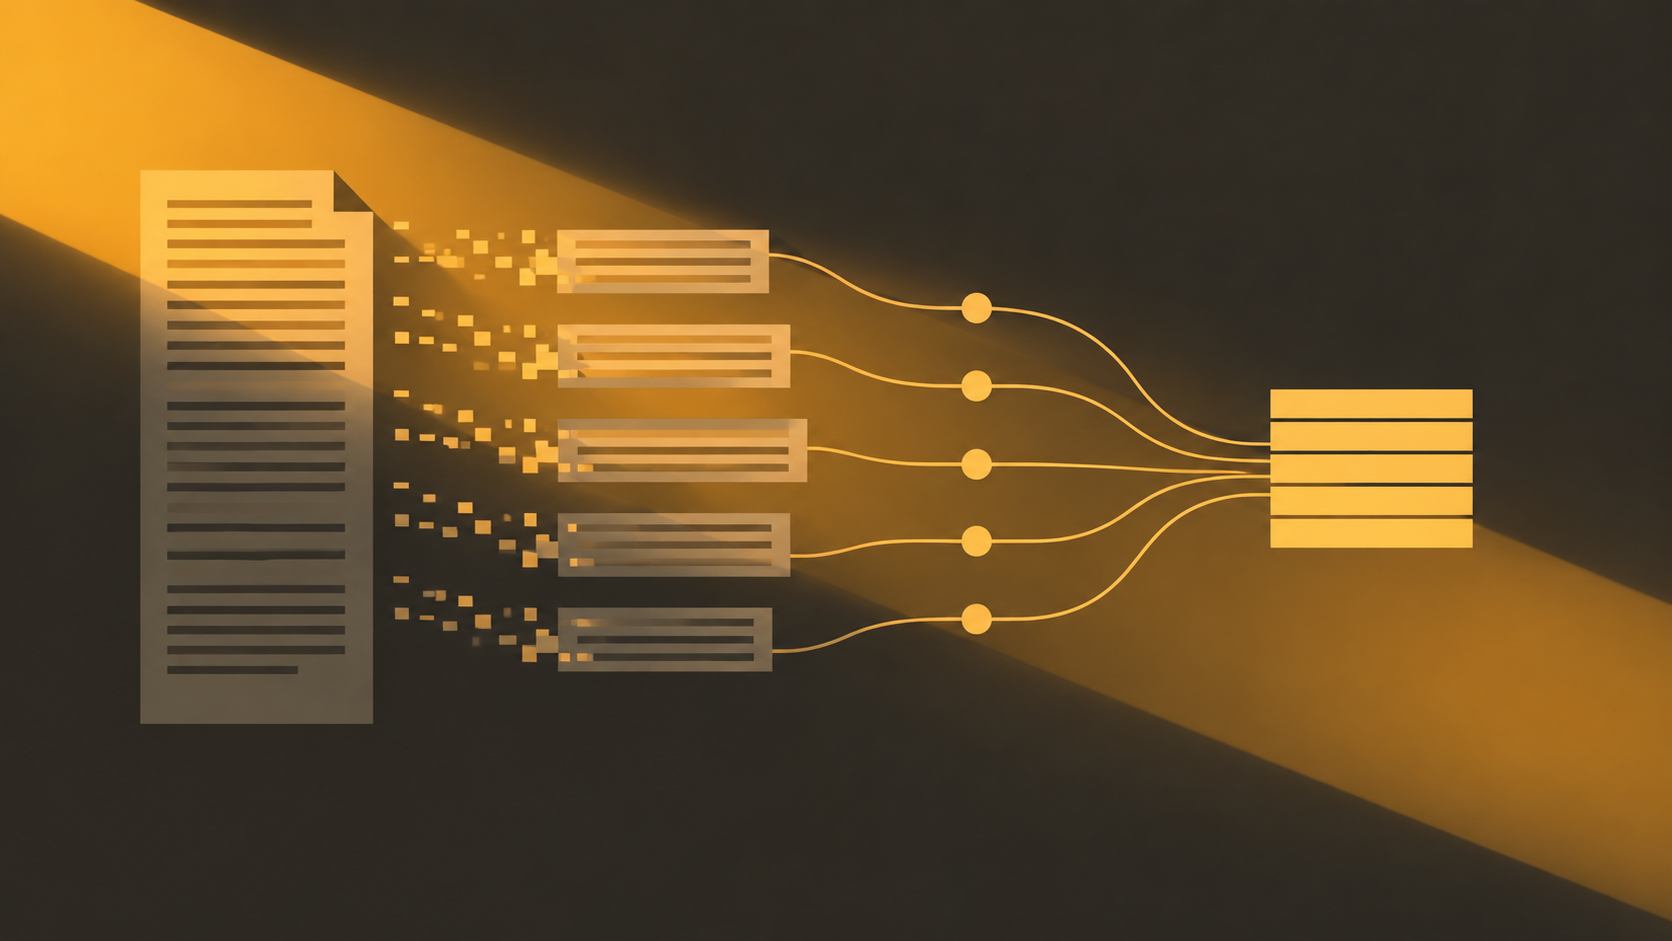
Il flusso complessivo è in tre fasi: «suddivisione — estrazione — fusione». Prima si suddivide il documento lungo in blocchi per gerarchia dei titoli o per lunghezza fissa, aggiungendo a ogni blocco informazioni di posizione (numero di pagina, percorso della sezione); poi si chiede al modello di produrre i campi secondo uno schema predefinito; infine si eseguono fusione e risoluzione dei conflitti a livello applicativo.
Lo schema va fissato in anticipo, e nel prompt bisogna indicare i tipi di campo, gli intervalli di valori ammessi e come rappresentare i valori mancanti. Far sì che il modello restituisca «sconosciuto» invece di inventare un valore è molto più semplice che andare poi a cercare gli errori nei dati sporchi.
{
  "party_a": "string | null",
  "effective_date": "YYYY-MM-DD | null",
  "payment_terms": "string | null",
  "termination_clause": "string | null"
}
Punti chiave per la valutazione e la tolleranza agli errori
Non giudicare la qualità dell'estrazione con un «sembra corretto». Prepara un set annotato che copra vari layout e casi limite, calcola l'accuratezza campo per campo e raccogli statistiche separate per i campi critici (importi, date, nomi delle parti). Per i campi numerici si consiglia di eseguire a livello applicativo un ulteriore controllo di formato e di intervallo: se il valore estratto dal modello non supera la validazione, si torna all'intervento umano.
Con i documenti lunghi ci sono altri due problemi frequenti: i campi che attraversano i blocchi (ad esempio l'importo totale scritto nel riepilogo finale, con le clausole distribuite su più blocchi) e il rumore dovuto a tabelle, intestazioni e piè di pagina. Il primo si può gestire con una seconda fusione in fase di unione; per il secondo conviene pulire prima della suddivisione.
La chiave per controllare i costi è non inserire l'intero documento nel contesto in una sola volta. Elaborando a blocchi e chiamando il modello solo sui blocchi pertinenti si riduce in modo significativo il consumo di token di input.
Scenario due: assegnazione intelligente di richieste di assistenza e ticket
Il cuore dell'assegnazione dei ticket è costituito da due giudizi: di che problema si tratta (intento) e quanto è urgente (priorità). Entrambe sono attività di classificazione testuale, ideali da affidare a un modello testuale.
Dalla classificazione libera alla classificazione controllata
L'errore più grave è lasciare che il modello generi liberamente i nomi delle categorie: ciò fa crescere rapidamente il sistema di etichette e lo rende non statisticabile. L'approccio corretto è fornire un insieme chiuso di intenti tra cui scegliere, chiedendo al contempo il livello di confidenza e la motivazione della decisione.
请将下面这条工单归入以下意图之一:
[账单争议 / 功能故障 / 使用咨询 / 账号安全 / 其他]
并给出优先级 [P0 / P1 / P2] 与不超过 30 字的理由。
工单内容:{{ticket_text}}
Chiedere al modello di motivare la scelta non serve a mostrare qualcosa, ma a fare troubleshooting. Quando gli errori di una certa categoria si concentrano, leggere le motivazioni permette di capire rapidamente se il problema è una definizione ambigua delle etichette o un prompt carente di informazioni.
Strategia di fallback per la confidenza
Quando il modello fornisce una confidenza bassa, non assegnare forzatamente. L'approccio più solido è seguire una catena di fallback: la bassa confidenza entra nella coda di intervento umano, oppure si effettua solo l'assegnazione alla «macro-categoria» senza quella alla «sotto-categoria», lasciando il giudizio di dettaglio agli operatori. Così, anche se il modello non è stabile, il ticket non viene assegnato al team sbagliato né si ritardano i tempi di risposta.
Manutenzione in produzione
Il sistema di intenti evolve con il business e i confini delle categorie cambiano. Si consiglia di registrare i risultati di ogni riassegnazione manuale e di riversarli periodicamente nel set di valutazione, per verificare se il prompt e le definizioni delle etichette sono ancora validi. Bisogna prestare particolare attenzione alla determinazione della priorità: per i ticket di sicurezza è preferibile adottare la regola secondo cui «il modello fa solo una pre-selezione e l'operatore deve obbligatoriamente verificare».
Scenario tre: riscrittura in batch e localizzazione nella produzione di contenuti
Testi di marketing, descrizioni di prodotti, avvisi e comunicazioni: contenuti con grandi volumi, elevata omogeneità ma che devono mantenere uno stile coerente sono lo scenario naturale per la riscrittura in batch. Qui il modello testuale svolge il ruolo di «un input, più output».
Un input, più output
Separare il testo di origine dai vincoli di stile. Il testo di origine è il contenuto, i vincoli di stile sono i parametri: tono (formale/amichevole), lunghezza (entro quante parole), pubblico (nuovi utenti/clienti esistenti), abitudini espressive regionali. Così un insieme di testi di origine può produrre in parallelo più versioni, e le differenze tra le versioni derivano dai parametri, non dalla casualità.
请基于以下原文改写一版文案:
- 语气:{{tone}}
- 目标读者:{{audience}}
- 字数上限:{{max_chars}}
- 必须保留的信息点:{{must_keep}}
原文:{{source_text}}
Il campo «informazioni da conservare obbligatoriamente» è cruciale. L'errore più comune nella riscrittura in batch è omettere informazioni chiave (fascia di prezzo, periodo della promozione, condizioni di applicabilità); elencarle esplicitamente attribuisce al modello un obbligo chiaro di conservarle.
Meccanismo di campionamento della qualità
Non sperare in una revisione umana totale. L'approccio più realistico è un campionamento a più livelli: revisione umana completa per i contenuti ad alto rischio (promozioni, dichiarazioni di conformità, comunicazioni esterne); campionamento proporzionale per i contenuti a basso rischio. Oltre al campionamento, aggiungi un livello di controlli automatici: verifica che le informazioni chiave siano conservate, che la lunghezza non superi il limite e che non compaiano parole vietate. Questi controlli si possono implementare con regole e hanno costi quasi nulli.
Dettagli da gestire nella localizzazione
L'adattamento a più regioni non è solo cambiare le parole. Unità di misura, formati di data, abitudini di cortesia, metafore vietate: tutto va specificato nei vincoli. Si consiglia di mantenere per ogni regione di destinazione una guida di stile, fissata come parte del prompt, per evitare di doverla descrivere improvvisando a ogni chiamata.
Per le attività in batch bisogna anche considerare l'idempotenza dei retry: assegna a ogni attività di riscrittura un identificatore stabile, così una riesecuzione sovrascrive invece di duplicare.
Scenario quattro: supporto alla diagnosi di codice e log
Quando si verifica un errore in produzione, gli ingegneri passano gran parte del tempo a leggere i log e a ipotizzare la causa. Il valore del modello testuale in questi compiti non è sostituire le persone, ma comprimere una massa di rumore in alcune ipotesi ordinate.
Un modo pratico di organizzare l'input
Passare decine di megabyte di log al modello è uno spreco. Prima filtra con regole, estrai un segmento di contesto prima e dopo l'errore, aggiungi le informazioni ambientali necessarie (nome del servizio, versione, catena di chiamate), poi chiedi al modello di produrre una classifica delle ipotesi di causa radice.
以下是某服务的一段错误日志与环境信息:
{{log_snippet}}
环境:{{env_info}}
请给出 3 条按可能性排序的根因假设,每条附上验证方法与需要补充的信息。
Chiedere al modello di fornire metodi di verifica è molto più utile che dare solo conclusioni. Spinge l'output verso azioni di indagine eseguibili e ti aiuta a giudicare se i suggerimenti sono affidabili.
Confini di sicurezza
I log contengono spesso informazioni degli utenti, percorsi interni, frammenti di chiavi. Prima dell'invio bisogna anonimizzare, sostituendo numeri di telefono, documenti d'identità, token e indirizzi di rete interna. Questo passaggio va eseguito prima della chiamata, non ci si può affidare al fatto che il modello li ignori da solo.
Inoltre va chiarita la natura dell'output del modello: sono suggerimenti per l'indagine, non conclusioni diagnostiche. Qualsiasi operazione che comporti modifiche in produzione deve essere eseguita solo dopo la conferma di un ingegnere. Separare a livello di sistema «suggerimento» ed «esecuzione» evita molti rischi.
Come misurare l'efficacia
In questi scenari il beneficio non si misura bene con l'accuratezza, ma con indicatori di processo: tempo medio di individuazione, numero di domande di chiarimento necessarie, percentuale di suggerimenti adottati. Confrontare questi indicatori dopo un periodo di utilizzo è più convincente delle impressioni soggettive.
Scenario cinque: domande e risposte in linguaggio naturale su dati strutturati
Report e risultati di database sono spesso difficili da leggere per le funzioni aziendali; convertire i risultati delle query in una spiegazione in linguaggio naturale riduce sensibilmente la soglia di utilizzo. Qui il modello testuale fa «traduzione», non «calcolo».
Principio chiave: prima interrogare i dati, poi spiegarli
Lasciare che il modello calcoli da solo i numeri è una delle principali fonti di allucinazioni. La divisione corretta del lavoro è: query, aggregazione e statistiche vengono completate interamente nel database o a livello applicativo; il modello riceve solo i risultati già calcolati e si occupa di organizzare il linguaggio e aggiungere spiegazioni contestuali.
以下是一段已经算好的统计数据(JSON):
{{query_result}}
请用 3 句话向业务方解释这组数据的含义,并明确指出数据的时间范围与统计口径。
Tre strumenti per controllare le allucinazioni
Primo, limitare l'input. Il modello può rispondere solo in base ai risultati forniti, e il prompt deve richiedere esplicitamente di «non introdurre numeri che non compaiono nell'input».
Secondo, richiedere l'indicazione della fonte. Fai in modo che la risposta contenga intervallo temporale, dimensione del campione e dimensioni di analisi: vedendo queste informazioni, la funzione aziendale può giudicare da sé l'attendibilità.
Terzo, rilevamento delle anomalie. A livello applicativo esegui un controllo dei numeri sull'output del modello: qualsiasi numero presente nella risposta ma assente nell'input viene bloccato o degradato a un output puramente template.
Progettazione dell'esplicabilità
Per lo stesso insieme di dati, ruoli diversi sono interessati a cose diverse. Al management si raccontano le tendenze, alle operations i punti anomali, alla finanza le differenze di criteri di calcolo. Fissare questi punti di vista in alcuni template di risposta è più stabile che lasciare il modello libero, e rende più facile eseguire test di coerenza.
Integrazione e controllo dei costi: spendere i token dove servono davvero
gpt-5.6-terra ha un prezzo per token, il che significa che il costo è direttamente legato alla lunghezza di input e output. Le decisioni ingegneristiche in fase di integrazione determinano in larga misura quanto differisce la fattura a parità di volume di lavoro.
La gestione del contesto è la leva principale
I token di input sono di solito la voce di costo più rilevante. Alcune pratiche dall'effetto immediato:
- Invia solo i campi necessari: non passare l'intero record del database, proietta prima le colonne realmente usate dal prompt.
- Comprimi le conversazioni lunghe con riassunti: conserva conclusioni e vincoli, scarta convenevoli e contenuti ripetuti.
- Metti istruzioni ed esempi fissi in posizioni stabili, per facilitare il caching dei prefissi.
- Sul fronte output, controlla la lunghezza con vincoli di struttura e limiti di parole, evitando che il modello si dilunghi troppo.
Cache e riutilizzo
Molte richieste aziendali sono altamente ripetitive (stessa categoria di ticket, stesso testo template). A livello applicativo, una cache dei risultati per richieste con «input identico» riduce direttamente i costi. Attenzione: la chiave di cache deve includere la versione del prompt e l'identificativo del modello, altrimenti, appena il prompt cambia, la cache diventa una fonte di risposte errate.
Il monitoraggio dell'utilizzo va suddiviso per scenario
Non guardare solo il consumo totale. Registra per scenario e per endpoint il numero di chiamate, i token di input, i token di output e i retry falliti. Con questi quattro numeri puoi capire dove crescono i costi: se è aumentato il traffico o se il prompt di qualche scenario si è allungato senza accorgersene.
Anche i retry sono un costo nascosto. Imposta timeout e limiti di retry ragionevoli e non ritentare in caso di errori di input evidenti: si evitano così consumi inutili.
Livello di integrazione unificato
Incapsula la chiamata al modello in un'interfaccia interna, con parametri quali il template del prompt, le variabili e i vincoli di output, che restituisca risultati strutturati e informazioni di utilizzo. I livelli applicativi superiori dipendono solo da questa interfaccia, non direttamente da alcun nome di modello. Così cambiare modello, rilasciare gradualmente nuove versioni o instradare per scenario richiede la modifica di un solo punto di configurazione.
Validazione e iterazione: decidere l'estensione in base al set di valutazione
Stabilire se un modello è utilizzabile in base alle sensazioni è il modo più facile per sbagliare. Preparare prima del rilascio un set di valutazione piccolo ma mirato è l'unico modo per riportare la decisione dai giudizi soggettivi ai dati.
Come costruire il set di valutazione
Non servono migliaia di elementi. Per ogni scenario, 100-300 campioni che coprano le situazioni tipiche sono sufficienti per iniziare; l'importante è che la distribuzione sia corretta: devono esserci tutte e tre le categorie, casi comuni, casi limite e problemi già incontrati in passato. Ogni campione deve avere un output atteso esplicito o un criterio di accettazione verificabile.
Le metriche di valutazione si definiscono per scenario. Per l'estrazione, accuratezza e richiamo a livello di campo; per l'assegnazione, accuratezza della classificazione e percentuale di bassa confidenza; per la riscrittura, tasso di conservazione delle informazioni chiave e valutazione umana; per le domande e risposte, coerenza dei numeri e valutazione della leggibilità umana. Le metriche sono diverse, ma il principio è lo stesso: ripetibili e confrontabili.
Rilascio graduale e A/B
Superare la valutazione non significa che non ci saranno problemi in produzione. Prima un rilascio graduale su poco traffico, confronto A/B tra il nuovo modello e la soluzione esistente, osservando sia gli indicatori di business sia quelli di costo. Nel confronto mantieni invariate le altre variabili: stesso flusso di traffico, stessa struttura del prompt, unica differenza il modello.
Il periodo di osservazione deve essere sufficientemente lungo e coprire giorni lavorativi e ore di punta. Se gli indicatori chiave non mostrano un vantaggio significativo, non affrettarti a estendere a tutti; se il vantaggio è solo sul costo ma la qualità è equivalente, anche questo è un motivo ragionevole per passare, ma va documentato chiaramente.
Ciclo di miglioramento continuo
Dopo il rilascio, riversa continuamente nel set di valutazione le correzioni manuali, i feedback degli utenti e i casi di errore in produzione. Ogni volta che modifichi un prompt, cambi la versione del modello o regoli la strategia di contesto, esegui prima il set di valutazione e poi decidi se pubblicare.
I modelli evolvono e il business cambia. Il senso di questo ciclo è che in qualsiasi momento puoi rispondere alla domanda «come sta andando davvero questo scenario», invece di dover cercare le cause a posteriori solo quando sorgono problemi. Il vero valore di nuovi modelli come gpt-5.6-terra può essere confermato solo in un sistema misurabile. Con un livello di integrazione snello e una valutazione solida, i costi di cambio si riducono naturalmente.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato