
チュートリアル
gpt-5.6-terra 実践ガイド:5つの高価値テキスト活用シーンと実装の要点
シーン選定から接続の要点まで、テキストモデルで実際の業務課題を解決する
テキストモデルをあえて個別に選定する価値
モデル選定の議論では、「画像を見られるか」「画像を生成できるか」をモデル能力の既定の尺度と見なす人が多いですが、大多数の業務システムにおいて、実際に本番の処理経路を流れているのはテキスト入力・テキスト出力の呼び出しです。gpt-5.6-terra は OpenAI が新たに提供開始したテキストモデルで、出力タイプはテキスト、課金はトークン単位です。これをマルチモーダルモデルと一括りに比較するのではなく、単独で評価することで、より明確な結論が得られます。
入力・出力の経路がよりシンプル
純粋なテキストモデルの呼び出し契約は非常にクリーンです。テキスト(または一連のメッセージ)を渡せば、テキストが返ってきます。画像エンコード、解像度のネゴシエーション、音声・動画の長さによる切り詰めといった追加の変数はありません。つまりデバッグ時に気にする必要があるのは、プロンプトとコンテキストの2つだけです。経路が短ければ問題の特定も早く、オンラインでの障害対応コストも低くなります。
コスト構造がより見積もりやすい
トークン課金の利点は計算できることです。入力長、出力長、リトライ回数が分かれば、1回の呼び出しのコストはほぼ把握できます。マルチモーダル呼び出しはメディア処理関連の課金基準が重なることが多く、見積もり時に考慮すべき分岐が増えます。業務の90%のタスクが分類、抽出、書き換え、説明といったテキスト作業であれば、テキストモデルを使うのがより直接的な選択です。
純粋なテキストモデルを使うべきとき
判断基準はとても素朴で構いません。タスクの成功基準が1つのテキストや1つの JSON で明確に説明できるなら、テキストモデルを優先的に検討しましょう。典型的なシグナルとしては、要件に「フィールドを抽出」「意図を判定」「トーンを書き換え」「このデータを説明」といった表現が現れる、受け入れ時に明確な対照回答を書ける、エラーがモダリティの変更ではなくプロンプトの修正やコンテキストの補足で修復できる、といったものがあります。
逆に、タスク自体が視覚的なレイアウト(例えばスキャン文書のレイアウトから表の帰属を判断する)や音声の韻律に依存する場合、テキストモデルは主選択肢ではありません。混合シナリオも分割できます。まず他の手段で非テキスト内容をテキストに変換し、それを gpt-5.6-terra に処理させることで、コストと品質の両方をよりよく制御できます。
選定の第二の原則は、一度に賭けないことです。モデル呼び出しを交換可能な1つのレイヤーにカプセル化しておけば、後で新モデルを段階的に導入するにせよ旧モデルにフォールバックするにせよ、設定を変えるだけですみます。
シーン1:長文ドキュメントの構造化抽出
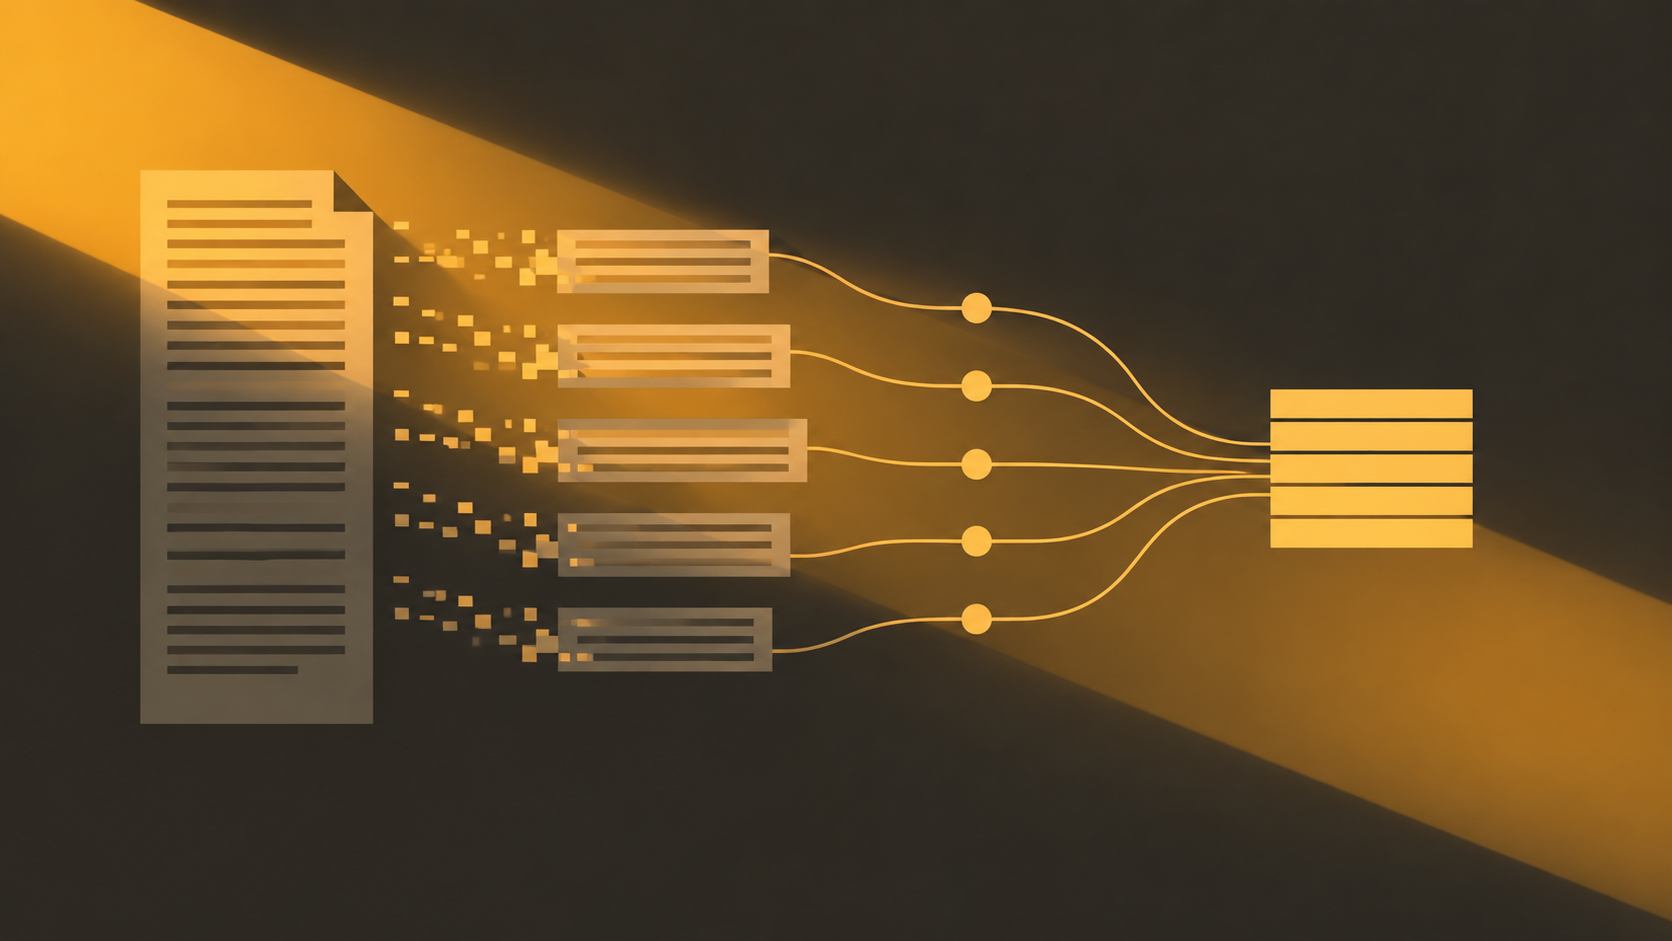
契約書、決算報告書、入札・調達文書、健康診断報告書——こうした長文ドキュメントは業務価値が高い一方、人手によるフィールド入力は極めて時間がかかります。非構造化の長文テキストを構造化 JSON に変換することは、テキストモデルが最も成熟して実装されているシーンの1つです。
実装の考え方
全体は「分割—抽出—統合」の3段構成です。まず長文ドキュメントを見出し階層または固定長でチャンクに分割し、各チャンクに位置情報(ページ番号、章のパス)を付与します。次にモデルに事前定義した schema でフィールドを出力させます。最後にアプリケーション層で統合と競合の解消を行います。
schema は必ず事前に固定し、プロンプトにはフィールド型、値の範囲、欠落時の表現方法を明記します。モデルには値をでっち上げさせるのではなく「不明」を出力させるようにしてください。後から汚いデータの中からエラーを拾い上げるよりはるかに楽です。
{
  "party_a": "string | null",
  "effective_date": "YYYY-MM-DD | null",
  "payment_terms": "string | null",
  "termination_clause": "string | null"
}
評価とフォールトトレランスの要点
「正しく見えるかどうか」で抽出品質を判断してはいけません。各種レイアウトや境界ケースをカバーするアノテーションセットを用意し、フィールド単位で精度を計算し、重要フィールド(金額、日付、主体名)を個別に統計します。数値系のフィールドはアプリケーション層で再度フォーマット検証と範囲検証を行うことを推奨します。モデルが抽出した値が検証を通らなければ人手に戻します。
長文ドキュメントにはさらに頻出する2つの落とし穴があります。1つはチャンクをまたぐフィールド(例えば総額が末尾の集計に書かれ、条項が複数のチャンクに分散している)、もう1つは表やヘッダー・フッターによるノイズです。前者は統合段階で二次的なマージを行い、後者は分割前にクリーニングする方が費用対効果が高いです。
コスト管理の鍵は、ドキュメント全体を一度にコンテキストへ詰め込まないことです。チャンク単位で処理し、ヒットしたチャンクにのみモデルを呼び出すことで、入力トークンの消費を大幅に削減できます。
シーン2:カスタマーサポートとチケットのスマート割り当て
チケット割り当ての中核は2つの判断です。これはどんな問題か(意図)、どれくらい急ぎか(優先度)。この2つはいずれもテキスト分類タスクであり、テキストモデルに任せるのに非常に適しています。
自由分類から制御された分類へ
最も避けるべきは、モデルに自由にカテゴリ名を生成させることです。それではタグ体系が急速に膨張し、統計が取れなくなります。正しい方法は、閉じた意図集合を提示してその中から選ばせ、同時に信頼度と判断根拠を出させることです。
以下のチケットを次の意図のいずれかに分類してください:
[請求紛争 / 機能障害 / 利用相談 / アカウントセキュリティ / その他]
併せて優先度 [P0 / P1 / P2] と30文字以内の理由を提示してください。
チケット内容:{{ticket_text}}
モデルに理由を出力させるのは表示のためではなく、調査のためです。ある分類の誤判定が集中して現れたとき、理由を見ればラベル定義が曖昧なのかプロンプトに情報が足りないのかを素早く特定できます。
信頼度によるフォールバック戦略
モデルが低い信頼度を示したときは、無理に割り当ててはいけません。より安定した方法はフォールバック経路を通すことです。低信頼度は人手キューへ回す、あるいは「大分類」のみ割り当てて「小分類」は行わず、細粒度の判断を人手に委ねます。こうすればモデルの判断が不安定でも、チケットを誤ったチームに送って対応時間を遅らせることがありません。
オンライン運用
意図体系は業務の進化とともに変わり、分類の境界もずれていきます。人手による再割り当ての結果を毎回記録し、定期的に評価セットへ戻して、プロンプトとラベル定義がまだ成立しているかを検証することを推奨します。優先度の判断は特に慎重に。セキュリティ系のチケットが絡む場合は、「モデルは一次スクリーニングのみ、人手によるレビューを必須とする」ルールを設定する方が安全です。
シーン3:コンテンツ制作の一括書き換えとローカライズ
マーケティングコピー、商品説明、告知通知といったコンテンツは、量が多く、同質性が高く、しかもスタイルの統一を保つ必要があり、一括書き換えの自然なシーンです。テキストモデルはここで「1回の入力、複数の出力」という役割を担います。
1回の入力、複数経路の出力
ソーステキストとスタイル制約を分けて渡します。ソーステキストは内容、スタイル制約はパラメータです。トーン(フォーマル/カジュアル)、長さ(何文字以内に圧縮するか)、対象読者(新規ユーザー/既存顧客)、地域の表現習慣。こうすれば1つのソーステキストから複数バージョンを並行して生成でき、各バージョンの差異はランダム性ではなくパラメータに由来します。
以下の原文に基づいてコピーを1版書き換えてください:
- トーン:{{tone}}
- 対象読者:{{audience}}
- 文字数上限:{{max_chars}}
- 必ず保持する情報ポイント:{{must_keep}}
原文:{{source_text}}
「必ず保持する情報ポイント」というフィールドが非常に重要です。一括書き換えで最もよくある失敗は、重要情報(価格帯、キャンペーン期間、適用条件)を落とすことです。これを明示的に列挙することで、モデルに明確な保持義務を持たせられます。
品質サンプリング検査の仕組み
全量を人手で審査することを期待してはいけません。より現実的な方法は階層的なサンプリング検査です。高リスクのコンテンツ(プロモーション、コンプライアンス声明、対外公表)は全量を人手で一度通し、低リスクのコンテンツは比率に応じてサンプリングします。サンプリング検査に加えて自動チェックの層を重ねます。重要情報が保持されているか、文字数が上限を超えていないか、禁止用語が現れていないか。これらはすべてルールで実装でき、コストはほぼゼロです。
ローカライズで処理すべき細部
多地域対応は単に言い回しを変えるだけではありません。度量衡の単位、日付形式、呼称の習慣、禁止される比喩をすべて制約に明記します。対象地域ごとにスタイル説明を1つ維持し、プロンプトの一部として固定しておくことを推奨します。そうすれば毎回の呼び出しで場当たり的な記述に頼らずにすみます。
一括タスクでは失敗時のリトライの冪等性も考慮します。各書き換えタスクに安定した識別子を付与し、再実行時に重複書き込みではなく上書きできるようにします。
シーン4:コードとログのトラブルシューティング支援
オンラインでエラーが発生したとき、エンジニアの時間はログを読み、根本原因を推測することに大量に費やされます。テキストモデルのこの種のタスクにおける価値は人を置き換えることではなく、大量のノイズを順位付けされたいくつかの仮説に圧縮することです。
実用的な入力の組み立て方
数十メガバイトのログをそのままモデルに投げるのは無駄です。まずルールでフィルタリングし、エラー前後の上下文を切り出し、必要な環境情報(サービス名、バージョン、呼び出しチェーン)を補い、その上でモデルに根本原因仮説の順位付けを出力させます。
以下はあるサービスのエラーログの一部と環境情報です:
{{log_snippet}}
環境:{{env_info}}
可能性の高い順に根本原因仮説を3つ提示し、それぞれに検証方法と補足が必要な情報を付けてください。
モデルに検証方法を出させることは、結論だけを出させるよりはるかに有用です。出力を実行可能な調査アクションに落とし込むよう促し、提案が信頼できるかどうかの判断もしやすくなります。
セキュリティ境界
ログにはユーザー情報、内部パス、キーの断片が含まれることがよくあります。送信前に必ずマスキングを行い、電話番号、身分証明書番号、token、社内アドレスなどを置換します。この層は呼び出し前に完了させるべきであり、モデルが自分で無視することに依存してはいけません。
さらに、モデル出力の位置づけを明確にします。それは調査の提案であり、診断の結論ではありません。オンライン変更を伴うあらゆる操作は、エンジニアの確認後に実行する必要があります。「提案」と「実行」をシステム層で分離することで、多くのリスクを避けられます。
効果の測定方法
この種のシーンの効果は精度では測りにくいですが、プロセス指標では測れます。平均特定時間、人手による追加質問の回数、提案が採用された割合。稼働から一定期間後にこれらの指標を比較する方が、主観的な感覚より説得力があります。
シーン5:構造化データの自然言語 Q&A
レポートやデータベースの結果は業務側にとって読みにくいことが多く、クエリ結果を自然言語の説明に変換すれば、利用のハードルを大幅に下げられます。テキストモデルはここで「翻訳」を担い、「計算」はしません。
鍵となる原則:まずデータを取得し、それから説明する
モデル自身に数字を計算させるのは幻覚の多発地帯です。正しい分業は、クエリ、集計、統計をすべてデータベースまたはアプリケーション層で完了させ、モデルにはすでに計算済みの結果だけを渡し、言語の組織化とコンテキストの補足説明を担当させることです。
以下はすでに計算済みの統計データ(JSON)です:
{{query_result}}
このデータの意味を業務側に3文で説明し、データの時間範囲と統計基準を明確に示してください。
幻覚を抑える3つの手段
第一に、入力を限定する。モデルは与えられた結果にのみ基づいて回答でき、プロンプトに「入力に存在しない数字を持ち込んではならない」と明記します。
第二に、出典の明示を求める。回答に時間範囲、サンプル量、統計次元を含めさせ、業務側がこれらの情報を見れば信頼性を自分で判断できます。
第三に、異常検出。アプリケーション層でモデル出力の数字を一度回収し、回答に現れたが入力に存在しない数字は、そのままブロックするか、純粋なテンプレート出力へ降格します。
説明可能性の設計
同じデータでも、役割によって関心のある点は異なります。経営層にはトレンドを、運用担当には異常点を、財務には基準の差異を説明します。これらの視点を数種類の回答テンプレートとして固定する方が、モデルに自由に発揮させるより安定し、一貫性テストもしやすくなります。
接続とコスト管理:トークンを最も効果的な場所に使う
gpt-5.6-terra はトークン単位の課金であり、コストは入出力長に直接連動することを意味します。接続段階のエンジニアリング上の意思決定が、同じ業務量でも請求額がどれだけ変わるかを大きく左右します。
コンテキスト管理が最大のレバー
入力トークンは通常コストの大部分を占めます。すぐに効果が出るいくつかの方法:
- 必要なフィールドだけを渡す。データベースのレコード全体を投げ込まず、プロンプトで実際に使う列をまず射影する。
- 長い会話は要約圧縮し、結論と制約を残し、挨拶や重複内容は捨てる。
- 固定不変の指示と例を安定した位置に置き、後でプレフィックスキャッシュを行いやすくする。
- 出力側は構造制約と文字数上限で長さを制御し、モデルが過度に展開するのを避ける。
キャッシュと再利用
多くの業務リクエストは高度に重複しています(同じ種類のチケット、同じテンプレートコピー)。アプリケーション層で「入力が完全に一致する」リクエストの結果をキャッシュすれば、コストは直接下げられます。キャッシュキーにはプロンプトのバージョンとモデル識別子も含めるよう注意してください。そうしなければプロンプトを変えた途端、キャッシュが誤った回答になってしまいます。
利用量の監視はシーン別に分解する
総消費量だけを見てはいけません。シーン別、インターフェース別に呼び出し回数、入力トークン、出力トークン、失敗リトライ回数を記録します。この4つの数値があれば、コストがどこで増えたのかを判断できます。トラフィックが増えたのか、それともあるシーンのプロンプトが知らぬ間に長くなったのか。
リトライも隠れたコストです。適切なタイムアウトとリトライ上限を設定し、明確な入力エラーにはリトライしないことで、無駄な消費の一群を避けられます。
統一された接続層
モデル呼び出しを内部インターフェース1つにカプセル化します。パラメータはプロンプトテンプレート、変数、出力制約、返り値は構造化結果と利用量情報です。上位の業務はこのインターフェースにのみ依存し、特定のモデル名には直接依存しません。こうすればモデルの切り替え、新バージョンの段階的導入、シーン別ルーティングは、いずれも1か所の設定変更で済みます。
検証とイテレーション:評価セットでリリース拡大を決める
モデルが使えるかどうかを感覚で判断するのが最も間違えやすいやり方です。リリース前に小さく精緻な評価セットを用意することが、意思決定を主観からデータへ引き戻す唯一の方法です。
評価セットの組み方
数千件は必要ありません。各シーン100〜300件の典型的な状況をカバーするサンプルで開始するのに十分です。重要なのは分布が正しいことです。よくある状況、境界状況、過去に踏んだ落とし穴の3種類をすべて含めます。各サンプルには明確な期待出力または判定可能な受け入れ基準が必要です。
評価指標はシーンごとに定めます。抽出はフィールド単位の適合率と再現率、割り当ては分類精度と低信頼度の割合、書き換えは重要情報の保持率と人手評価、Q&A は数値の一致性と人手の可読性スコア。指標は異なりますが原則は同じです。再現可能で比較可能であること。
段階的導入と A/B テスト
評価を通過したからといってオンラインで問題がないわけではありません。まず少量のトラフィックで段階的に導入し、新モデルと既存手法を A/B 比較し、業務指標とコスト指標の2本の線を観察します。比較時は他の変数を一定に保ちます。同じトラフィック、同じプロンプト構造で、モデルだけが唯一の差異です。
観察期間は十分に長く取り、平日とピーク時間帯をカバーします。重要指標に顕著な優位性がなければ、急いで全量展開しないでください。コスト面でのみ優位で品質が同等という場合も切り替えの合理的な理由になりますが、明確に書き記すべきです。
継続的イテレーションの閉環
リリース後は、人手による修正、ユーザーフィードバック、オンラインの失敗事例を継続的に評価セットへ戻します。プロンプトを変更するたび、モデルバージョンを切り替えるたび、コンテキスト戦略を調整するたびに、まず評価セットを走らせてからリリースを決めます。
モデルはイテレーションし、業務もドリフトします。この閉環の意義は、いつでも「現在このシーンの効果は実際どうなのか」に答えられることであり、問題が起きてから原因を探しに戻ることではありません。gpt-5.6-terra のような新モデルの真の価値も、計測可能な体系の中でしか確認できません。接続層を薄く、評価を厚くすれば、切り替えコストは自然と低くなります。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする