
Tutorial
Guia prático do gpt-5.6-terra: 5 cenários de alto valor para aplicações de texto e pontos-chave de implementação
Da escolha do cenário aos pontos de integração: usando modelos de texto para resolver problemas reais de negócio
Por que vale a pena avaliar modelos de texto separadamente
Nas discussões de escolha de modelo, muita gente trata "consegue ver imagens" e "consegue gerar imagens" como critério padrão de capacidade. Mas, para a grande maioria dos sistemas de negócio, o que realmente roda na linha de produção continua sendo chamadas de entrada de texto e saída de texto. O gpt-5.6-terra é o novo modelo de texto da OpenAI, com saída do tipo texto e cobrança por token. Avaliá-lo isoladamente, em vez de compará-lo de forma genérica com modelos multimodais, leva a conclusões mais claras.
Cadeia de entrada e saída mais simples
O contrato de chamada de um modelo puramente textual é muito limpo: você envia um texto (ou um conjunto de mensagens) e ele devolve texto. Não há variáveis extras como codificação de imagem, negociação de resolução ou truncamento de duração de áudio e vídeo. Isso significa que, ao depurar, você só precisa se preocupar com duas coisas — prompt e contexto. A cadeia é curta, a localização de problemas é rápida e o custo de diagnóstico em produção é menor.
Estrutura de custos mais fácil de estimar
A vantagem da cobrança por token é que dá para calcular. Comprimento de entrada, comprimento de saída e número de tentativas bastam para delimitar o custo de uma chamada. Chamadas multimodais costumam somar regras de cobrança ligadas ao processamento de mídia, o que aumenta as ramificações a considerar na estimativa. Se 90% das tarefas do seu negócio são trabalho textual como classificação, extração, reescrita e explicação, usar um modelo de texto é a escolha mais direta.
Quando usar um modelo puramente textual
O critério pode ser bem simples: se o padrão de sucesso da tarefa pode ser descrito em um texto ou em um JSON, priorize o modelo de texto. Sinais típicos incluem — o requisito menciona "extrair campos", "identificar intenção", "reescrever o tom", "explicar estes dados"; na validação você consegue escrever respostas de referência claras; os erros podem ser corrigidos ajustando o prompt ou complementando o contexto, em vez de trocar de modalidade.
Por outro lado, se a tarefa em si depende do layout visual (por exemplo, decidir a qual tabela pertence um conteúdo a partir do layout de um documento digitalizado) ou depende da prosódia do áudio, o modelo de texto não é a escolha principal. Cenários mistos também podem ser divididos: primeiro converta o conteúdo não textual em texto por outros meios e depois entregue ao gpt-5.6-terra, o que permite controlar melhor tanto o custo quanto a qualidade.
O segundo princípio da escolha é não apostar tudo de uma vez. Encapsule a chamada ao modelo em uma camada substituível; depois, seja para liberar gradualmente um novo modelo ou para voltar ao antigo, será apenas uma questão de mudar configuração.
Cenário 1: extração estruturada de documentos longos
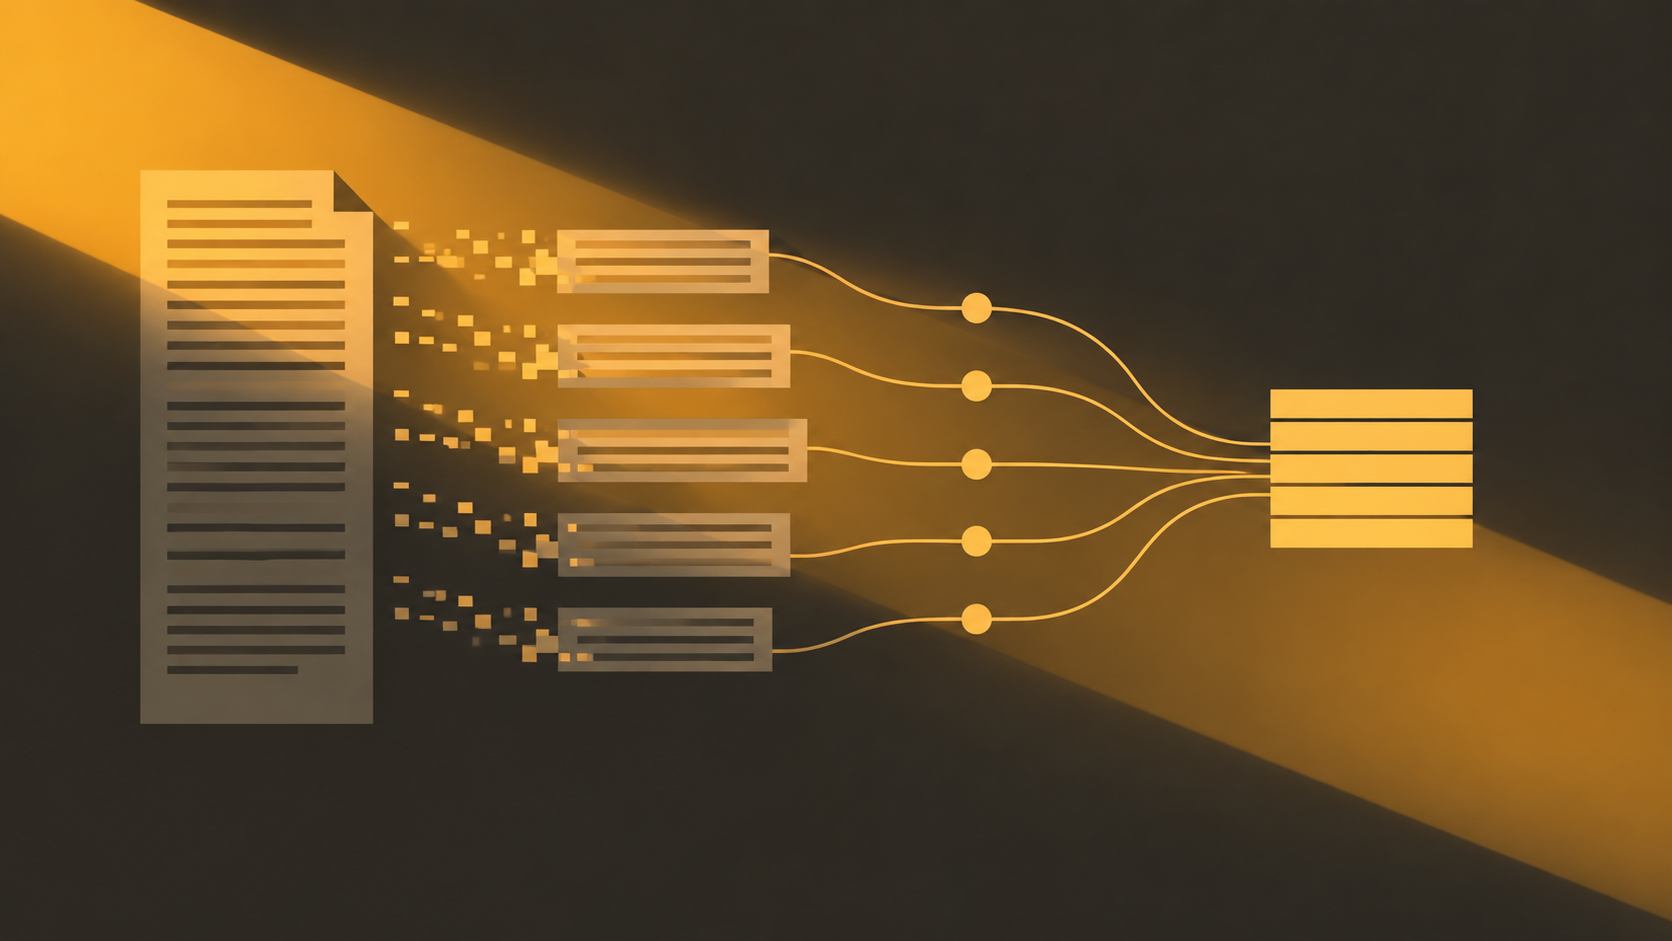
Contratos, relatórios financeiros, documentos de licitação, laudos médicos — esse tipo de documento longo tem alto valor de negócio, mas o preenchimento manual de campos é extremamente demorado. Converter texto longo não estruturado em JSON estruturado é um dos cenários de aplicação mais maduros para modelos de texto.
Abordagem de implementação
No geral, é um processo em três etapas: "dividir — extrair — mesclar". Primeiro, divida o documento longo em blocos por níveis de título ou comprimento fixo, anexando a cada bloco informações de posição (página, caminho da seção); depois, peça ao modelo que produza os campos conforme um schema previamente definido; por fim, faça a mesclagem e a resolução de conflitos na camada de aplicação.
O schema deve ser definido antecipadamente e de forma rígida, e o prompt deve indicar os tipos dos campos, as faixas de valores e a forma de representação quando ausentes. Pedir ao modelo que produza "desconhecido" em vez de inventar um valor economiza muito mais esforço do que caçar erros depois em dados sujos.
{
  "party_a": "string | null",
  "effective_date": "YYYY-MM-DD | null",
  "payment_terms": "string | null",
  "termination_clause": "string | null"
}
Pontos-chave de avaliação e tolerância a falhas
Não julgue a qualidade da extração por "parece certo". Prepare um conjunto anotado que cubra diversos layouts e casos de borda, calcule a acurácia campo a campo e faça estatísticas separadas para os campos críticos (valores, datas, nomes das partes). Para campos numéricos, recomenda-se uma validação adicional de formato e faixa na camada de aplicação; se o valor extraído pelo modelo não passar na validação, volte para revisão humana.
Documentos longos têm dois problemas recorrentes: um são os campos que atravessam blocos (por exemplo, o valor total está no resumo final, enquanto as cláusulas estão espalhadas por vários blocos); o outro é o ruído causado por tabelas, cabeçalhos e rodapés. Para o primeiro, pode-se fazer uma segunda consolidação na etapa de mesclagem; para o segundo, é mais vantajoso limpar antes da divisão.
A chave para controlar custos é não enfiar o documento inteiro no contexto de uma vez. Processar por blocos, chamando o modelo apenas para os blocos relevantes, reduz significativamente o consumo de tokens de entrada.
Cenário 2: distribuição inteligente de atendimento e tickets
O núcleo da distribuição de tickets são duas decisões: qual é o problema (intenção) e quão urgente é (prioridade). Ambas são tarefas de classificação de texto, muito adequadas para um modelo de texto.
De classificação livre para classificação controlada
O maior erro é deixar o modelo criar nomes de categoria livremente, o que faz o sistema de rótulos inflar rapidamente e se tornar imensurável. A abordagem correta é fornecer um conjunto fechado de intenções, pedir ao modelo que escolha uma delas e exigir também o nível de confiança e a justificativa.
Classifique o ticket abaixo em uma das seguintes intenções:
[disputa de cobrança / falha de funcionalidade / dúvida de uso / segurança da conta / outro]
E informe a prioridade [P0 / P1 / P2] e uma justificativa de no máximo 30 caracteres.
Conteúdo do ticket: {{ticket_text}}
Pedir ao modelo que produza a justificativa não é para exibição, mas para diagnóstico. Quando erros de uma determinada categoria se concentram, ler as justificativas ajuda a identificar rapidamente se a definição do rótulo está vaga ou se falta informação no prompt.
Estratégia de fallback por confiança
Quando o modelo indica baixa confiança, não force a distribuição. A abordagem mais segura é acionar a cadeia de fallback: baixa confiança entra na fila manual, ou faz-se apenas a distribuição por "categoria ampla" sem a distribuição por "subgrupo", deixando o julgamento refinado para humanos. Assim, mesmo que o julgamento do modelo seja instável, o ticket não será enviado à equipe errada nem atrasará o tempo de resposta.
Manutenção em produção
O sistema de intenções evolui com o negócio, e as fronteiras de classificação também mudam. Recomenda-se registrar cada resultado de reatribuição manual e realimentar periodicamente o conjunto de avaliação, usando-o para verificar se o prompt e as definições de rótulo ainda são válidos. Tenha cuidado especial com a decisão de prioridade: em tickets de segurança, prefira a regra "o modelo faz apenas a triagem inicial e a revisão humana é obrigatória".
Cenário 3: reescrita em lote e localização para produção de conteúdo
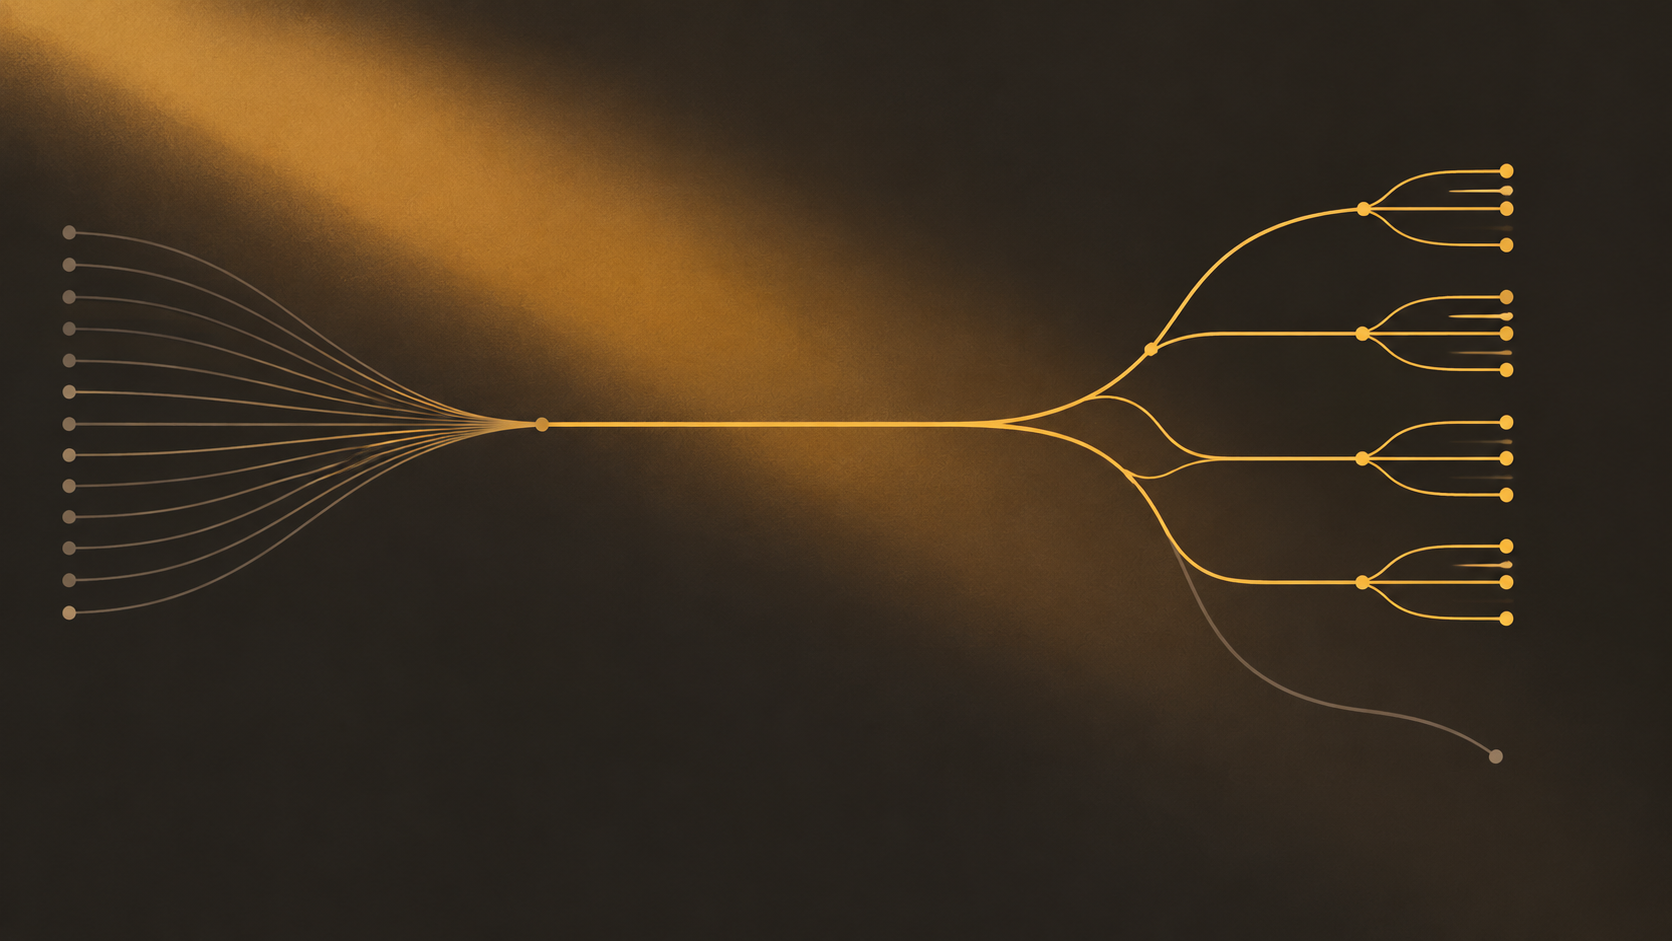
Textos de marketing, descrições de produtos, comunicados e avisos — conteúdos com grande volume, alta homogeneidade e necessidade de manter estilo consistente são o cenário natural para reescrita em lote. O modelo de texto aqui desempenha o papel de "uma entrada, várias saídas".
Uma entrada, múltiplas saídas
Envie o texto-fonte e as restrições de estilo separadamente. O texto-fonte é o conteúdo; as restrições de estilo são parâmetros: tom (formal/descontraído), comprimento (comprimir para até quantos caracteres), público (novos usuários/clientes antigos), hábitos de expressão regionais. Assim, um conjunto de textos-fonte pode gerar várias versões em paralelo, e as diferenças entre as versões vêm dos parâmetros, não da aleatoriedade.
Reescreva uma versão do texto abaixo:
- Tom: {{tone}}
- Público-alvo: {{audience}}
- Limite de caracteres: {{max_chars}}
- Pontos de informação que devem ser preservados: {{must_keep}}
Texto original: {{source_text}}
O campo "pontos de informação que devem ser preservados" é crucial. O erro mais comum na reescrita em lote é omitir informações-chave (faixa de preço, período da promoção, condições de aplicação); listá-las explicitamente dá ao modelo uma obrigação clara de preservação.
Mecanismo de inspeção por amostragem de qualidade
Não conte com revisão humana de 100%. Uma abordagem mais realista é a inspeção estratificada: para conteúdo de alto risco (promoções, declarações de conformidade, comunicados externos), revisão humana integral; para conteúdo de baixo risco, amostragem proporcional. Além da inspeção, adicione uma camada de verificação automática — se as informações-chave foram preservadas, se o limite de caracteres foi ultrapassado, se apareceram palavras proibidas — tudo isso pode ser feito com regras, a custo praticamente zero.
Detalhes a tratar na localização
A adaptação para múltiplas regiões não é só trocar palavras. Unidades de medida, formatos de data, formas de tratamento e metáforas proibidas devem estar claramente nas restrições. Recomenda-se manter um guia de estilo para cada região de destino, fixado como parte do prompt, para evitar depender de descrições improvisadas a cada chamada.
Tarefas em lote também precisam considerar a idempotência de novas tentativas em caso de falha: dê a cada tarefa de reescrita um identificador estável, para que, ao reprocessar, o resultado sobrescreva em vez de duplicar a gravação.
Cenário 4: investigação assistida de código e logs
Quando ocorre um erro em produção, os engenheiros gastam muito tempo lendo logs e adivinhando a causa raiz. O valor do modelo de texto nesse tipo de tarefa não é substituir pessoas, mas comprimir um monte de ruído em algumas hipóteses ordenadas.
Forma prática de organizar a entrada
Jogar dezenas de megabytes de log no modelo é desperdício. Primeiro faça filtragem por regras, recorte um trecho de contexto antes e depois do erro, complemente com as informações de ambiente necessárias (nome do serviço, versão, cadeia de chamadas) e então peça ao modelo que produza uma ordenação das hipóteses de causa raiz.
A seguir está um trecho de log de erro de um serviço e informações de ambiente:
{{log_snippet}}
Ambiente: {{env_info}}
Forneça 3 hipóteses de causa raiz ordenadas por probabilidade, cada uma com método de verificação e informações adicionais necessárias.
Pedir ao modelo que forneça métodos de verificação é muito mais útil do que apenas dar conclusões. Isso força a saída a recair sobre ações de investigação executáveis e também facilita julgar se a sugestão é confiável.
Fronteiras de segurança
Logs frequentemente contêm informações de usuários, caminhos internos e fragmentos de chaves. Antes de enviar, é obrigatório fazer a desidentificação, substituindo telefones, documentos de identidade, tokens e endereços de rede interna. Essa camada deve ser concluída antes da chamada, não se pode depender de o modelo ignorar por conta própria.
Além disso, deixe clara a posição da saída do modelo: é sugestão de investigação, não conclusão de diagnóstico. Qualquer operação que envolva mudança em produção deve ser confirmada por um engenheiro antes de ser executada. Separar "sugestão" e "execução" no nível do sistema evita muitos riscos.
Como medir o efeito
O ganho desse tipo de cenário não é fácil de medir por acurácia, mas pode ser medido por indicadores de processo: tempo médio de localização, quantas perguntas adicionais humanas são necessárias, proporção de sugestões adotadas. Após algum tempo em produção, comparar esses indicadores é mais convincente do que impressões subjetivas.
Cenário 5: perguntas e respostas em linguagem natural sobre dados estruturados
Relatórios e resultados de banco de dados costumam ser difíceis de ler para as áreas de negócio; converter resultados de consulta em uma explicação em linguagem natural reduz significativamente a barreira de uso. O modelo de texto aqui faz "tradução", não "cálculo".
Princípio-chave: primeiro consultar os números, depois explicar
Deixar o modelo calcular números por conta própria é terreno fértil para alucinações. A divisão correta é: consulta, agregação e estatística são feitas inteiramente no banco de dados ou na camada de aplicação; o modelo recebe apenas o resultado já calculado e se encarrega de organizar a linguagem e complementar a explicação do contexto.
A seguir está um conjunto de estatísticas já calculadas (JSON):
{{query_result}}
Explique em 3 frases para a área de negócio o significado desses dados e indique claramente o período e o critério estatístico.
Três meios de controlar alucinações
Primeiro, limitar a entrada. O modelo só pode responder com base no resultado fornecido; o prompt deve exigir explicitamente que "não sejam introduzidos números que não estejam na entrada".
Segundo, exigir a indicação da fonte. Faça a resposta incluir período, tamanho da amostra e dimensões estatísticas; ao ver essas informações, a área de negócio pode julgar por si mesma a confiabilidade.
Terceiro, detecção de anomalias. Na camada de aplicação, faça uma recuperação dos números da saída do modelo; qualquer número que apareça na resposta mas não exista na entrada deve ser bloqueado ou rebaixado para uma saída puramente baseada em template.
Design de explicabilidade
Para o mesmo conjunto de dados, diferentes papéis se importam com coisas diferentes. Para a gestão, fale de tendências; para operações, fale de pontos anômalos; para finanças, fale de diferenças de critério. Fixar essas perspectivas em alguns templates de resposta é mais estável do que deixar o modelo improvisar e também facilita testes de consistência.
Integração e controle de custos: gastar tokens onde importa
O gpt-5.6-terra cobra por token, o que significa que o custo está diretamente ligado ao comprimento de entrada e saída. As decisões de engenharia na fase de integração determinam em grande parte a diferença na fatura para o mesmo volume de negócio.
Gestão de contexto é a maior alavanca
Tokens de entrada costumam ser a maior parte do custo. Algumas práticas de efeito imediato:
- Envie apenas os campos necessários; não jogue o registro inteiro do banco de dados, projete antes apenas as colunas que o prompt realmente usa.
- Comprima sessões longas com resumos, mantendo conclusões e restrições e descartando saudações e conteúdo repetido.
- Coloque instruções e exemplos fixos em posições estáveis, para facilitar o cache de prefixo posteriormente.
- No lado da saída, use restrições estruturais e limite de caracteres para controlar o comprimento, evitando que o modelo se estenda demais.
Cache e reutilização
Muitas requisições de negócio são altamente repetitivas (o mesmo tipo de ticket, o mesmo texto de template). Fazer cache de resultados na camada de aplicação para requisições com "entrada idêntica" reduz o custo diretamente. Atenção: a chave de cache deve incluir a versão do prompt e o identificador do modelo; caso contrário, quando o prompt mudar, o cache se torna uma resposta errada.
Monitoramento de uso deve ser detalhado por cenário
Não olhe apenas o consumo total. Registre, por cenário e por interface, o número de chamadas, tokens de entrada, tokens de saída e número de novas tentativas por falha. Com esses quatro números, você consegue identificar onde o custo aumentou: se foi aumento de tráfego ou se o prompt de algum cenário ficou mais longo sem que você percebesse.
As novas tentativas também são um custo oculto. Defina timeouts e limites de tentativas razoáveis e não repita tentativas para erros claros de entrada, evitando um lote de consumo inútil.
Camada de integração unificada
Encapsule a chamada ao modelo em uma interface interna, cujos parâmetros são template de prompt, variáveis e restrições de saída, retornando resultado estruturado e informações de uso. As camadas de negócio dependem apenas dessa interface, sem depender diretamente de nenhum nome de modelo. Assim, trocar de modelo, liberar gradualmente uma nova versão ou rotear por cenário exige apenas mudar uma configuração.
Validação e iteração: usar o conjunto de avaliação para decidir a liberação em escala
Julgar se um modelo serve com base na sensação é o caminho mais fácil para errar. Preparar um conjunto de avaliação pequeno e refinado antes da entrada em produção é a única forma de trazer a decisão da subjetividade para os dados.
Como montar o conjunto de avaliação
Não são necessários milhares de itens. De 100 a 300 amostras por cenário, cobrindo situações típicas, já bastam para começar; o importante é que a distribuição esteja correta: situações comuns, situações de borda e problemas já enfrentados historicamente — as três categorias devem estar presentes. Cada amostra deve ter uma saída esperada clara ou um critério de aceitação verificável.
As métricas de avaliação são definidas por cenário. Extração olha acurácia e recall por campo; distribuição olha acurácia de classificação e proporção de baixa confiança; reescrita olha taxa de preservação de informações-chave e avaliação humana; perguntas e respostas olham consistência numérica e avaliação de legibilidade humana. As métricas são diferentes, mas o princípio é o mesmo: repetível e comparável.
Implementação gradual e A/B
Passar na avaliação não significa que não haverá problemas em produção. Primeiro faça uma implementação gradual com pouco tráfego, comparando o novo modelo com a solução atual em A/B, observando as duas linhas de indicadores: negócio e custo. Na comparação, mantenha as demais variáveis constantes — o mesmo lote de tráfego, a mesma estrutura de prompt, apenas o modelo como diferença.
O período de observação deve ser longo o suficiente para cobrir dias úteis e horários de pico. Se os indicadores-chave não tiverem vantagem significativa, não tenha pressa em liberar totalmente; se houver vantagem apenas em custo com qualidade equivalente, essa também é uma razão razoável para trocar, mas deixe isso documentado.
Ciclo de iteração contínua
Após a entrada em produção, realimente continuamente o conjunto de avaliação com correções humanas, feedback de usuários e casos de falha em produção. A cada mudança de prompt, troca de versão do modelo ou ajuste de estratégia de contexto, rode primeiro o conjunto de avaliação e só então decida se publica.
Os modelos evoluem, e o negócio também muda. O sentido desse ciclo é: a qualquer momento você consegue responder "como está o desempenho deste cenário agora", em vez de só procurar a causa depois que o problema aparece. O valor real de novos modelos como o gpt-5.6-terra só pode ser confirmado dentro de um sistema mensurável. Mantenha a camada de integração simples e a avaliação robusta, e o custo de troca naturalmente diminui.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado