
Tutoriel
Guide pratique de gpt-5.6-terra : 5 scénarios d'application textuelle à forte valeur et points clés de mise en œuvre
Du choix des scénarios aux points d'intégration, résoudre de vrais problèmes métier avec un modèle textuel
Pourquoi un modèle textuel mérite une évaluation dédiée
Dans les discussions de sélection, beaucoup considèrent « sait-il voir des images » ou « sait-il générer des images » comme le critère par défaut des capacités d'un modèle. Pourtant, pour la grande majorité des systèmes métier, ce qui tourne réellement en production reste l'appel entrée texte / sortie texte. gpt-5.6-terra est un modèle textuel récemment lancé par OpenAI, dont la sortie est du texte, facturé au token. L'évaluer séparément, plutôt que de le comparer pêle-mêle avec des modèles multimodaux, permet d'aboutir à des conclusions plus claires.
Une chaîne d'entrée/sortie plus simple
Le contrat d'appel d'un modèle purement textuel est très propre : vous fournissez un texte (ou un ensemble de messages), il renvoie du texte. Pas d'encodage d'image, de négociation de résolution, ni de troncature de durée audio/vidéo comme variables supplémentaires. Cela signifie qu'au débogage, vous n'avez que deux choses à surveiller : le prompt et le contexte. Une chaîne courte, c'est un diagnostic rapide et un coût de dépannage en production plus faible.
Une structure de coûts plus facile à prévoir
L'avantage de la facturation au token, c'est qu'elle se calcule. Longueur d'entrée, longueur de sortie, nombre de tentatives : de quoi encadrer le coût d'un appel. Les appels multimodaux ajoutent souvent des barèmes de facturation liés au traitement des médias, ce qui multiplie les branches à considérer dans l'estimation. Si 90 % des tâches de votre activité sont des tâches textuelles comme la classification, l'extraction, la réécriture ou l'explication, un modèle textuel est le choix le plus direct.
Quand utiliser un modèle purement textuel
Le critère peut être très simple : si le critère de réussite d'une tâche peut s'exprimer par un texte ou un JSON, privilégiez le modèle textuel. Les signaux typiques incluent — l'apparition dans le besoin de « extraire des champs », « déterminer l'intention », « réécrire le ton », « expliquer ces données » ; la capacité à rédiger une réponse de référence explicite lors de la recette ; la possibilité de corriger une erreur en modifiant le prompt ou en complétant le contexte, plutôt qu'en changeant de modalité.
À l'inverse, si la tâche dépend elle-même de la mise en page visuelle (par exemple déterminer l'appartenance d'un tableau à partir de la disposition d'un document scanné) ou de la prosodie audio, le modèle textuel n'est pas le premier choix. Les scénarios mixtes peuvent aussi être découpés : convertir d'abord le contenu non textuel en texte par d'autres moyens, puis le confier à gpt-5.6-terra, ce qui permet de mieux maîtriser coût et qualité.
Le deuxième principe de sélection : ne misez pas tout d'un coup. Encapsulez les appels de modèle dans une couche remplaçable ; ensuite, qu'il s'agisse de déployer progressivement un nouveau modèle ou de revenir à l'ancien, il ne s'agit que d'un changement de configuration.
Scénario 1 : extraction structurée à partir de documents longs
Contrats, rapports financiers, appels d'offres, bilans de santé — ces documents longs ont une forte valeur métier, mais la saisie manuelle des champs est extrêmement chronophage. Convertir un long texte non structuré en JSON structuré est l'un des scénarios les plus matures pour un modèle textuel.
Approche de mise en œuvre
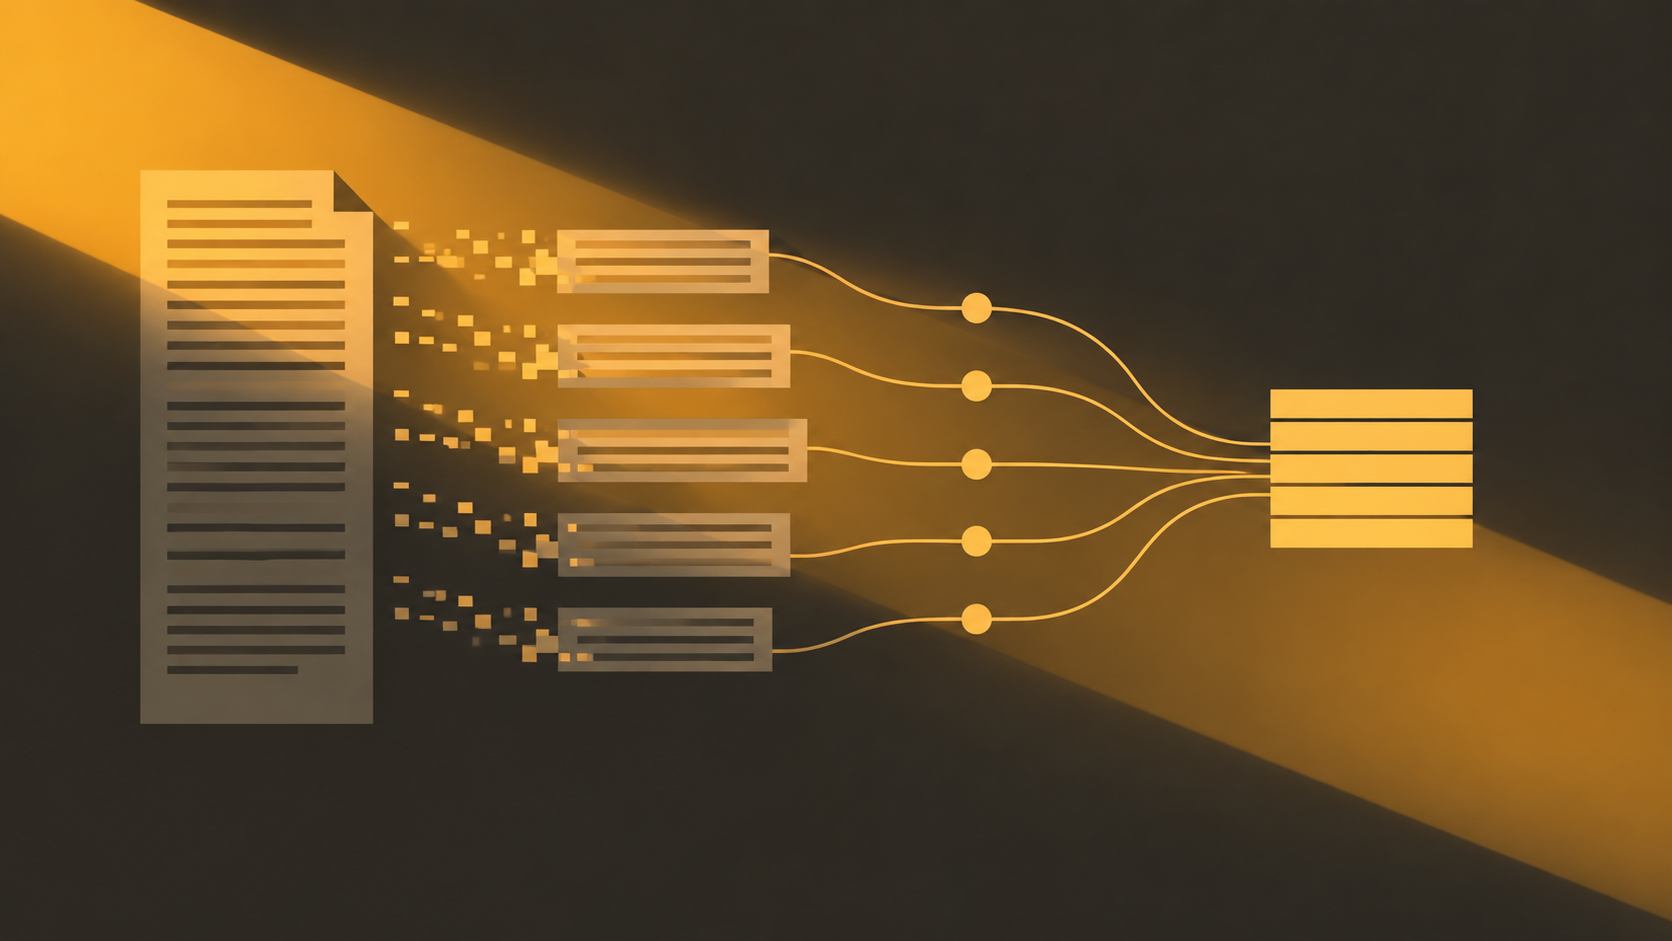
Le principe global est en trois étapes : « découpage — extraction — fusion ». On découpe d'abord le document long en blocs selon la hiérarchie des titres ou une longueur fixe, chaque bloc étant accompagné d'informations de position (numéro de page, chemin de section) ; on demande ensuite au modèle de produire les champs selon un schéma prédéfini ; enfin, la couche applicative réalise la fusion et la résolution des conflits.
Le schéma doit être figé à l'avance, et le prompt doit préciser les types de champs, les plages de valeurs et la manière de représenter une valeur manquante. Demander au modèle de produire « inconnu » plutôt que d'inventer une valeur est bien plus pratique que de rattraper ensuite les erreurs dans des données sales.
{
  "party_a": "string | null",
  "effective_date": "YYYY-MM-DD | null",
  "payment_terms": "string | null",
  "termination_clause": "string | null"
}
Points clés d'évaluation et de tolérance aux erreurs
Ne jugez pas la qualité de l'extraction à l'œil, en vous demandant si « ça a l'air juste ». Préparez un jeu annoté couvrant divers formats et cas limites, calculez la précision champ par champ, et statistiquez séparément les champs critiques (montants, dates, noms des parties). Pour les champs numériques, il est conseillé d'ajouter une validation de format et de plage dans la couche applicative ; si la valeur extraite par le modèle échoue à la validation, elle repasse en traitement manuel.
Les documents longs présentent aussi deux pièges fréquents : les champs inter-blocs (par exemple un montant total indiqué dans le récapitulatif final, avec des clauses réparties sur plusieurs blocs), et le bruit introduit par les tableaux et les en-têtes/pieds de page. Pour le premier, une seconde fusion peut être faite au stade de la consolidation ; pour le second, un nettoyage avant le découpage est plus rentable.
La clé de la maîtrise des coûts : ne pas insérer tout le document d'un coup dans le contexte. Un traitement par blocs, en n'appelant le modèle que sur les blocs pertinents, réduit sensiblement la consommation de tokens d'entrée.
Scénario 2 : attribution intelligente des demandes client et des tickets
L'attribution des tickets repose sur deux jugements : de quoi s'agit-il (l'intention) et à quel point est-ce urgent (la priorité). Ces deux éléments relèvent de la classification de texte, ce qui convient parfaitement à un modèle textuel.
De la classification libre à la classification contrôlée
La pire erreur est de laisser le modèle générer librement des noms de catégories : le système d'étiquettes enfle rapidement et devient impossible à statistiquer. La bonne pratique consiste à fournir un ensemble fermé d'intentions, à laisser le modèle choisir parmi elles, et à exiger qu'il fournisse en même temps un niveau de confiance et une justification.
请将下面这条工单归入以下意图之一:
[账单争议 / 功能故障 / 使用咨询 / 账号安全 / 其他]
并给出优先级 [P0 / P1 / P2] 与不超过 30 字的理由。
工单内容:{{ticket_text}}
Demander au modèle une justification n'est pas pour l'affichage, mais pour le diagnostic. Lorsque les erreurs de classification d'une catégorie se concentrent, la justification permet d'identifier rapidement si la définition de l'étiquette est floue ou si le prompt manque d'informations.
Stratégie de repli en cas de faible confiance
Lorsque le modèle donne un faible niveau de confiance, ne forcez pas l'attribution. Une approche plus sûre consiste à passer par une chaîne de repli : les cas à faible confiance vont dans une file de traitement manuel, ou bien seule l'attribution de la « grande catégorie » est faite sans attribution de la « sous-catégorie », le jugement fin étant laissé à l'humain. Ainsi, même si le jugement du modèle est instable, le ticket ne sera pas envoyé à la mauvaise équipe et le temps de réponse ne sera pas retardé.
Maintenance en production
Le système d'intentions évolue avec l'activité, et les frontières de classification dérivent. Il est conseillé d'enregistrer chaque réaffectation manuelle et de la réinjecter périodiquement dans le jeu d'évaluation, pour vérifier si le prompt et les définitions d'étiquettes sont toujours valides. La priorisation demande une attention particulière : pour les tickets liés à la sécurité, mieux vaut poser la règle « le modèle ne fait qu'un pré-filtrage, un humain doit obligatoirement vérifier ».
Scénario 3 : réécriture et localisation en masse pour la production de contenu
Textes marketing, descriptions de produits, annonces et notifications : ce type de contenu se caractérise par un fort volume, une forte homogénéité et un besoin de cohérence stylistique, ce qui en fait un scénario naturel de réécriture en masse. Le modèle textuel y joue le rôle de « une entrée, plusieurs sorties ».
Une entrée, plusieurs sorties
Séparez le texte source et les contraintes de style. Le texte source est le contenu, les contraintes de style sont des paramètres : ton (formel/décontracté), longueur (en deçà de combien de caractères), audience (nouveaux utilisateurs/clients existants), habitudes d'expression régionales. Ainsi, un même texte source peut produire plusieurs versions en parallèle, et les différences entre versions proviennent des paramètres et non du hasard.
请基于以下原文改写一版文案:
- 语气:{{tone}}
- 目标读者:{{audience}}
- 字数上限:{{max_chars}}
- 必须保留的信息点:{{must_keep}}
原文:{{source_text}}
Le champ « informations à conserver impérativement » est crucial. L'échec le plus fréquent en réécriture en masse est l'omission d'informations clés (fourchette de prix, période de l'opération, conditions d'éligibilité) ; les lister explicitement donne au modèle une obligation de conservation claire.
Mécanisme de contrôle qualité par échantillonnage
N'espérez pas tout faire relire par un humain. Une approche plus réaliste est l'échantillonnage par niveaux : pour les contenus à haut risque (promotions, mentions de conformité, annonces publiques), relecture humaine intégrale ; pour les contenus à faible risque, échantillonnage proportionnel. En complément, ajoutez une couche de vérification automatique — les informations clés sont-elles conservées, la limite de caractères est-elle respectée, des termes interdits apparaissent-ils ; tout cela peut se faire par règles, à coût quasi nul.
Détails à traiter pour la localisation
L'adaptation multi-régions ne se limite pas à changer les formulations. Unités de mesure, formats de date, habitudes d'adresse, métaphores à éviter : tout doit être précisé dans les contraintes. Il est conseillé de maintenir un guide de style pour chaque région cible, fixé comme partie du prompt, afin d'éviter de dépendre d'une description improvisée à chaque appel.
Les tâches en masse doivent aussi prendre en compte l'idempotence des nouvelles tentatives : attribuez un identifiant stable à chaque tâche de réécriture, afin qu'une ré-exécution écrase plutôt que de dupliquer l'écriture.
Scénario 4 : aide au diagnostic du code et des journaux
Lors d'une erreur en production, les ingénieurs passent beaucoup de temps à lire les journaux et à deviner la cause racine. La valeur d'un modèle textuel sur ce type de tâche n'est pas de remplacer l'humain, mais de compresser un amas de bruit en quelques hypothèses classées.
Une organisation des entrées réellement utile
Envoyer des dizaines de mégaoctets de journaux au modèle est un gaspillage. Filtrez d'abord par règles, extrayez un extrait de contexte autour de l'erreur, ajoutez les informations d'environnement nécessaires (nom du service, version, chaîne d'appels), puis demandez au modèle de classer les hypothèses de cause racine.
以下是某服务的一段错误日志与环境信息:
{{log_snippet}}
环境:{{env_info}}
请给出 3 条按可能性排序的根因假设,每条附上验证方法与需要补充的信息。
Demander au modèle des méthodes de vérification est bien plus utile que de ne donner que des conclusions. Cela pousse la sortie vers des actions de diagnostic exécutables et vous aide à juger de la fiabilité des suggestions.
Frontières de sécurité
Les journaux contiennent souvent des informations utilisateur, des chemins internes, des fragments de clés. Avant l'envoi, il est indispensable de les anonymiser : remplacez numéros de téléphone, pièces d'identité, tokens, adresses intranet, etc. Cette étape doit être réalisée avant l'appel, et non confiée au modèle qui serait censé les ignorer.
Il faut aussi définir clairement le statut de la sortie du modèle : ce sont des suggestions de diagnostic, pas des conclusions. Toute opération touchant la production doit être confirmée par un ingénieur avant exécution. Séparer « suggestion » et « exécution » au niveau du système permet d'éviter de nombreux risques.
Comment mesurer l'efficacité
Le bénéfice de ce type de scénario se mesure mal en précision, mais peut se mesurer par des indicateurs de processus : temps moyen de localisation, nombre de relances humaines nécessaires, proportion de suggestions adoptées. Comparer ces indicateurs après une période de production est plus convaincant qu'une impression subjective.
Scénario 5 : questions-réponses en langage naturel sur des données structurées
Les rapports et les résultats de base de données sont souvent peu lisibles pour les équipes métier ; convertir un résultat de requête en une explication en langage naturel réduit nettement le seuil d'utilisation. Le modèle textuel y joue le rôle de « traducteur », pas de « calculateur ».
Principe clé : d'abord interroger les données, ensuite expliquer
Laisser le modèle calculer lui-même les chiffres est une zone à forte production d'hallucinations. La bonne répartition est la suivante : requêtes, agrégations et statistiques sont toutes réalisées dans la base de données ou la couche applicative ; le modèle ne reçoit que des résultats déjà calculés et se charge d'organiser le langage et d'ajouter des explications contextuelles.
以下是一段已经算好的统计数据(JSON):
{{query_result}}
请用 3 句话向业务方解释这组数据的含义,并明确指出数据的时间范围与统计口径。
Trois moyens de limiter les hallucinations
Premièrement, limiter l'entrée. Le modèle ne peut répondre qu'à partir des résultats fournis ; le prompt exige explicitement de « ne pas introduire de chiffres absents de l'entrée ».
Deuxièmement, exiger la source. La réponse doit mentionner la période couverte, la taille de l'échantillon, les dimensions statistiques ; les équipes métier peuvent ainsi juger elles-mêmes de la fiabilité.
Troisièmement, la détection d'anomalies. Dans la couche applicative, effectuez une re-extraction des nombres de la sortie du modèle : tout nombre présent dans la réponse mais absent de l'entrée est bloqué ou rétrogradé en sortie purement basée sur un modèle.
Conception de l'explicabilité
Sur un même jeu de données, les centres d'intérêt diffèrent selon les rôles. À la direction, on parle de tendances ; aux opérations, d'anomalies ; à la finance, de différences de périmètre. Figer ces perspectives sous forme de quelques modèles de réponse est plus stable que de laisser le modèle improvise, et facilite les tests de cohérence.
Intégration et maîtrise des coûts : dépenser les tokens à bon escient
gpt-5.6-terra étant facturé au token, le coût est directement lié à la longueur d'entrée et de sortie. Les décisions d'ingénierie au moment de l'intégration déterminent en grande partie l'écart de facture pour un même volume d'activité.
La gestion du contexte est le principal levier
Les tokens d'entrée représentent généralement le gros du coût. Quelques pratiques à effet immédiat :
- Ne transmettez que les champs nécessaires ; n'envoyez pas l'enregistrement complet de la base de données, projetez d'abord les colonnes réellement utilisées par le prompt.
- Résumez et compressez les longues conversations : conservez conclusions et contraintes, écartez les formules de politesse et les redondances.
- Placez les instructions et exemples fixes à des emplacements stables, pour faciliter ensuite la mise en cache de préfixe.
- Côté sortie, utilisez des contraintes structurelles et une limite de caractères pour éviter que le modèle ne développe excessivement.
Cache et réutilisation
Beaucoup de requêtes métier sont fortement répétitives (même type de ticket, même modèle de texte). Mettre en cache au niveau applicatif les requêtes dont « l'entrée est identique » fait baisser directement le coût. Attention : la clé de cache doit inclure la version du prompt et l'identifiant du modèle, sinon une modification du prompt transforme le cache en mauvaise réponse.
Surveiller l'usage par scénario
Ne regardez pas seulement la consommation totale. Enregistrez le nombre d'appels, les tokens d'entrée, les tokens de sortie et le nombre de nouvelles tentatives échouées par scénario et par interface. Avec ces quatre chiffres, vous pouvez déterminer où le coût augmente : le trafic a-t-il augmenté, ou le prompt d'un scénario s'est-il discrètement allongé ?
Les nouvelles tentatives sont aussi un coût caché. Fixez des délais d'attente et une limite de tentatives raisonnables, et ne réessayez pas en cas d'erreur d'entrée manifeste, pour éviter une série de consommations inutiles.
Une couche d'intégration unifiée
Encapsulez les appels de modèle dans une interface interne, dont les paramètres sont le modèle de prompt, les variables, les contraintes de sortie, et qui renvoie un résultat structuré et les informations d'usage. Les couches métier ne dépendent que de cette interface, et non directement d'un nom de modèle. Ainsi, changer de modèle, déployer progressivement une nouvelle version ou router par scénario ne nécessite qu'une modification de configuration à un seul endroit.
Validation et itération : décider du déploiement à grande échelle grâce au jeu d'évaluation
Juger de l'utilisabilité d'un modèle à l'instinct est la source d'erreur la plus fréquente. Préparer un jeu d'évaluation petit mais précis avant la mise en production est le seul moyen de ramener la décision du subjectif vers les données.
Comment construire le jeu d'évaluation
Pas besoin de milliers d'éléments. 100 à 300 échantillons couvrant les cas typiques par scénario suffisent pour démarrer ; l'important est que la distribution soit correcte : cas courants, cas limites, pièges rencontrés par le passé, les trois catégories doivent être présentes. Chaque échantillon doit avoir une sortie attendue explicite ou un critère d'acceptation vérifiable.
Les indicateurs d'évaluation dépendent du scénario. Pour l'extraction : précision et rappel au niveau des champs ; pour l'attribution : précision de classification et proportion de faible confiance ; pour la réécriture : taux de conservation des informations clés et note humaine ; pour les questions-réponses : cohérence des chiffres et note de lisibilité humaine. Les indicateurs diffèrent, mais le principe est le même : reproductibles et comparables.
Déploiement progressif et A/B
Réussir l'évaluation ne signifie pas que la production est sans problème. Commencez par un déploiement progressif à faible trafic, comparez le nouveau modèle et la solution existante en A/B, en observant les indicateurs métier et les indicateurs de coût. Lors de la comparaison, maintenez les autres variables constantes — même lot de trafic, même structure de prompt, seule différence : le modèle.
La période d'observation doit être suffisamment longue, couvrant les jours ouvrés et les heures de pointe. Si les indicateurs clés n'ont pas d'avantage significatif, ne précipitez pas le déploiement complet ; si l'avantage ne porte que sur le coût mais que la qualité est équivalente, c'est aussi une raison valable de basculer, à condition de le documenter clairement.
Une boucle d'itération continue
Après la mise en production, réinjectez continuellement dans le jeu d'évaluation les corrections manuelles, les retours utilisateurs et les cas d'échec en production. À chaque modification de prompt, changement de version de modèle ou ajustement de la stratégie de contexte, exécutez d'abord le jeu d'évaluation, puis décidez de publier ou non.
Les modèles évoluent, l'activité aussi. L'intérêt de cette boucle est que vous pouvez à tout moment répondre à la question « quelle est réellement la performance de ce scénario aujourd'hui », au lieu de chercher la cause après qu'un problème est survenu. La véritable valeur d'un nouveau modèle comme gpt-5.6-terra ne peut elle aussi être confirmée que dans un système mesurable. Gardez la couche d'intégration fine et l'évaluation riche : le coût de bascule diminuera naturellement.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat