
Руководство по использованию
Промпты для преобразования текста в видео MiniMax H3 Max: готовые к копированию практические рецепты и реальные результаты
Большинство промптов для преобразования текста в видео спотыкаются об одном и том же: они описывают картинку, а не кадр. В итоге вы получаете красивый, но почти неподвижный кадр — или кадр, который при любом движении превращается в кашу. MiniMax H3 Max вознаграждает прямо противоположную привычку — писать промпты как режиссёр. Укажите, где кадр начинается и где заканчивается, как распределены эти несколько секунд и как сцена звучит, — и модель удержит кадр с настоящей логикой движения камеры и подходящей звуковой дорожкой.
В этом руководстве приведены три готовых к копированию рецепта, и каждый строится вокруг одной действительно нужной точки контроля: движение камеры, распределение ритма в фиксированной длительности и слаженная постановка нескольких движущихся элементов. Каждый фрагмент ниже сгенерирован на hiapi по исходному промпту, напечатанному прямо рядом с ним, — без отбора и без последующей чистки. Скопируйте промпт, замените объект — и публикуйте собственную работу.
Все три примера отрендерены в 480P для быстрой и дешёвой итерации (самый дешёвый тариф); когда нужен результат для сдачи, те же промпты можно напрямую масштабировать до 768P и 1080P.
Как MiniMax H3 Max понимает промпты
Вызов требует передать prompt плюс три параметра, а сам prompt несёт ещё и четвёртый невидимый параметр — звук. Если построить правильную мысленную модель, рецепты ниже перестают казаться магией:
prompt— описание кадра, а не подпись. Модель откликается на глаголы движения камеры ("push in", "crane up", "orbit"), слова о свете и атмосфере, а также на явную строкуAmbient sound:, которая управляет сгенерированным звуком.duration— число от0.92до15секунд. Это ваш бюджет ритма. Больше секунд — больше тактов можно уложить; меньше секунд — сосредоточьтесь на одном действии.resolution—480P,768Pили1080P. Дешёвая итерация, чёткая сдача.aspect_ratio—21:9,16:9,4:3,1:1,3:4или9:16. Выбирайте под площадку размещения до написания промпта (кинематографично, вертикально для соцсетей, квадратно для товара), потому что формат кадра меняет то, как вы описываете композицию.
В каждом рецепте есть две важные привычки. Во-первых, закрепляйте кадр: укажите, где он начинается и где заканчивается, — тогда движение между ними останется связным. Во-вторых, перечисляйте негативы — no people, no text, no cuts, no speech — потому что модели преобразования текста в видео очень любят из ниоткуда добавлять субтитры и резкие склейки в кадре, который должен быть непрерывным.
Рецепт 1 — движение камеры: наезд и раскрытие краном
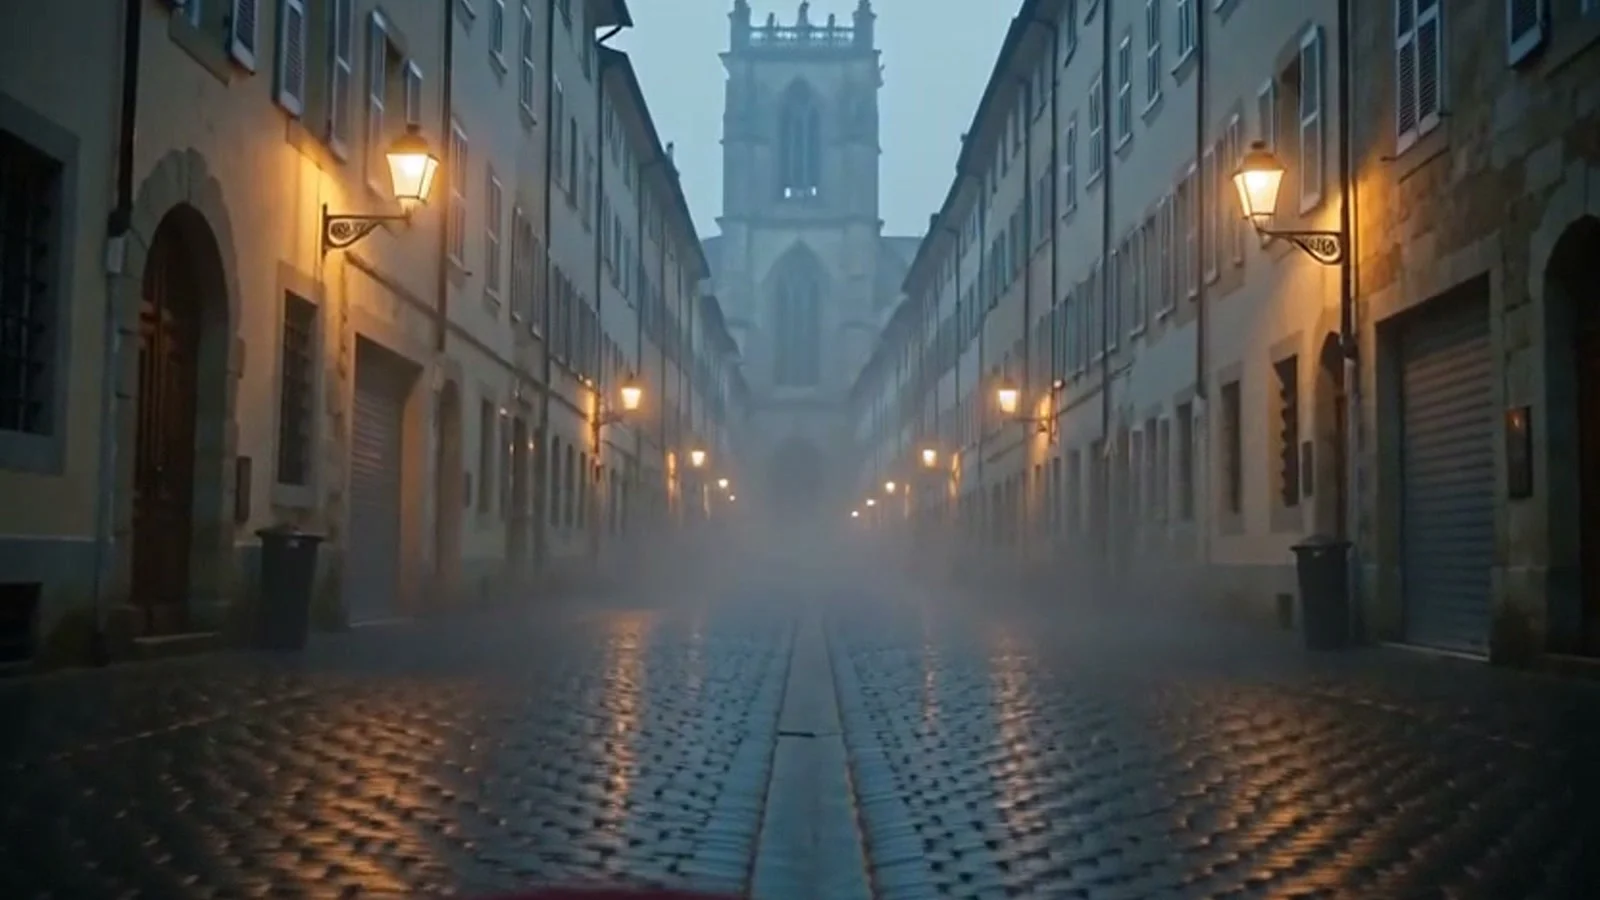
Самое полезное одиночное движение — начать с крупного плана и затем открыть обзор. Здесь камера начинает в нескольких сантиметрах от красного зонта на мокрой брусчатке, затем наезжает вперёд и поднимается краном вверх, раскрывая весь переулок. Один объект, одно непрерывное движение, награда в конце.
Single continuous shot. A lone open red umbrella lies on wet cobblestones
in an empty European alley at dawn, thin fog, puddles mirroring amber
streetlamps. The camera starts low and close on the umbrella, then slowly
pushes forward and cranes upward into a wide reveal of the long alley
stretching toward a misty cathedral. Gentle natural motion: drifting fog,
a few slow raindrops rippling the puddles. Cinematic, shallow depth of
field, warm-cool color contrast, stable geometry, seamless temporal
consistency, no people, no text, no cuts. Ambient sound: soft rain,
distant church bells, faint wind, no speech.
Параметры: aspect_ratio: 16:9 · duration: 6 · resolution: 480P
Почему это работает:
- Одно предложение, две позиции камеры. "starts low and close… then pushes forward and cranes upward into a wide reveal" даёт модели начальный и конечный кадр. Она интерполирует между ними правдоподобное движение, а не блуждает бесцельно.
- Движение не самой камеры. "drifting fog" и "raindrops rippling the puddles" оживляют сцену, не перетягивая внимание с движения камеры. Второстепенное движение не даёт картинке выглядеть замороженной.
- Слова об атмосфере действительно работают. "warm-cool color contrast" и "shallow depth of field" подталкивают вид к кинематографичности; контраст янтарного и тумана в результате идёт прямо из этой фразы.
- Тест на замену: замените зонт и переулок на "a vintage motorcycle in a neon-lit garage", сохранив фразу о движении камеры без изменений, — движение камеры перенесётся чисто.
Рецепт 2 — ритм: тратим фиксированную длительность на размеренные такты
Когда у вас больше нескольких секунд, не описывайте один статичный момент на весь фрагмент — распишите такты как сценарий. Отметьте в промпте временные окна, чтобы указать модели, как распределить длительность. Этот 8-секундный вертикальный фрагмент ведёт трёхтактную последовательность наливания.
Vertical social clip, one continuous take, three beats.
Beat 1 (0-3s): a barista's hands pour hot espresso over a glass of ice,
close macro, dark crema swirling.
Beat 2 (3-6s): milk cascades in slow motion, blooming into feathered
clouds through the coffee.
Beat 3 (6-8s): the camera pulls back to reveal the finished iced latte on
a sunlit marble counter beside fresh mint.
Warm morning light, crisp condensation on the glass, smooth natural
motion, high detail, stable focus, no text. Ambient sound: gentle pour,
ice clink, soft cafe hum, no speech.
Параметры: aspect_ratio: 9:16 · duration: 8 · resolution: 480P
Почему это работает:
- Такты соответствуют секундам. "Beat 1 (0-3s)… Beat 2 (3-6s)… Beat 3 (6-8s)" говорит модели, как распределить длительность, поэтому действие продвигается вперёд, а не повторяет один и тот же жест. Сумма ваших окон тактов должна равняться запрошенному
duration. - Один такт = одно изменение. Каждый такт вводит только одну новую вещь (наливание → раскрытие молочных облаков → отъезд камеры для раскрытия). Если впихнуть в один такт два изменения, модель часто спешит или смешивает их.
- Оставьте раскрытие напоследок. Отъезд камеры в Beat 3 — это награда. Завершение более широким кадром читается как осознанная концовка, а не как фрагмент, у которого кончилось время.
- Вертикаль — это выбор композиции, а не просто обрезка. Используя
9:16, вы описываете высокий кадр — чашка заполняет центр, — а не втискиваете горизонтальную картинку в экран телефона.
Рецепт 3 — постановка сцены: несколько элементов движутся вместе
Самая сложная сцена — когда несколько вещей движутся одновременно, а кадр не разваливается. Хитрость в том, чтобы дать каждому элементу свой глагол и путь, а камере — простую задачу. Здесь: лента обвивается вокруг флакона, лёгкая дымка плывёт на фоне, камера медленно облетает по кругу.
Square product shot, single continuous take. On a dark reflective stage,
three frosted glass perfume bottles stand in a row. A ribbon of golden
silk floats in from the left and spirals around the center bottle, while
a soft burst of white mist drifts across the background and settles. The
camera orbits slowly clockwise around the bottles. Studio rim lighting,
deep shadows, physically accurate reflections on the glass and stage,
premium luxury commercial finish, controlled elegant motion, stable
geometry, no people, no logos, no text. Ambient sound: low cinematic hum,
soft whoosh of silk, delicate chime, no speech.
Параметры: aspect_ratio: 1:1 · duration: 6 · resolution: 480P
Почему это работает:
- У каждого элемента есть глагол и направление. Лента "floats in from the left and spirals around the center bottle"; дымка "drifts across the background and settles". Указание пути для каждого элемента не даёт им слипнуться в шум.
- Дайте камере простую задачу. Когда объект сам выполняет постановку, достаточно простого "orbits slowly clockwise". Именно момент, когда камера делает сложное движение и одновременно управляет тремя элементами, — это момент, когда кадр разваливается.
- Физические слова дают реалистичность. "physically accurate reflections on the glass and stage" — именно поэтому флаконы правильно отражаются в полу; на отражающие материалы нужно указывать явно.
no logosоправдывает себя. В товарных кадрах модель иначе выдумывает брендовые логотипы. Негативы — это способ сохранить кадр чистым и пригодным к использованию.
Запустите сами
Каждый фрагмент выше — это асинхронная задача на эндпоинте hiapi /v1/tasks: отправка, опрос, скачивание. Поля ввода — ровно те четыре параметра из рецептов:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3-max/text-to-video",
    "input": {
      "prompt": "Single continuous shot. A lone open red umbrella on wet cobblestones... Ambient sound: soft rain, distant church bells, no speech.",
      "duration": 6,
      "resolution": "480P",
      "aspect_ratio": "16:9"
    }
  }'
Ответ вернёт taskId; опрашивайте GET /v1/tasks/{taskId}, пока status не станет success, затем заберите фрагмент по выходному URL (это краткосрочная ссылка — скачивайте сразу).
Стоимость растёт от запрошенных секунд, а не от фактически возвращённых. По состоянию на октябрь 2026 года преобразование текста в видео MiniMax H3 Max тарифицируется по запрошенным секундам видео: 480P — $0.072/сек, 768P — $0.115/сек, 1080P — $0.229/сек. Так что три 480P-фрагмента здесь (6 сек + 8 сек + 6 сек) в сумме стоят около $1.44. Сначала итерируйте промпты в 480P, затем перезапускайте выбранную версию в 1080P. Актуальные цены — на странице цен hiapi.
Уже есть нужный первый кадр? Тот же синтаксис промптов подходит и для преобразования изображения в видео MiniMax H3 Max — передайте ему статичный кадр и описывайте движение и звук, а не всю сцену.
Частые вопросы
MiniMax H3 Max генерирует звук, или я добавляю его потом?
Он генерирует аудио по вашему промпту. Строка Ambient sound: в каждом рецепте — именно источник шума дождя, гула кафе и шороха шёлка во фрагментах выше — постпродакшн не нужен. Если только вы не хотите диалог явно, пишите no speech и описывайте нужную атмосферу, а не полагайтесь на случай.
Какова максимальная длина фрагмента? Длительность каждой задачи — от 0.92 до 15 секунд. Для более длинного контента генерируйте несколько фрагментов и склеивайте их — и расписывайте такты для каждого фрагмента, как в рецепте 2, чтобы они чисто монтировались вместе.
Почему мой фрагмент выглядит мягким или серым? Обычно проблема в уровне разрешения, а не в промпте. Эти примеры — 480P для дешёвой итерации. Перезапустите финальный промпт в 768P или 1080P для чёткости при сдаче. Также добавляйте слова о материалах и свете ("physically accurate reflections", "studio rim lighting") — они улучшают вид не меньше, чем количество пикселей.
Как не дать ему добавить текст или субтитры?
Укажите в негативах no text (для товаров ещё no subtitles, no logos). Модели преобразования текста в видео часто из ниоткуда генерируют экранный текст; явное перечисление — надёжное решение.
Какое соотношение сторон использовать?
Под площадку размещения: 16:9 или 21:9 для кинематографичности и горизонтали, 9:16 или 3:4 для соцсетей и мобильных, 1:1 для товарных кадров и лент. Выбирайте до написания промпта, потому что формат кадра меняет то, как вы описываете композицию.
Начните режиссировать
Модель за всеми тремя рецептами одна и та же: укажите начало и конец кадра, потратьте длительность на такты, дайте каждому движущемуся элементу собственный глагол и опишите звук. Скопируйте эти промпты, подставьте свой объект, итерируйте в 480P, пока движение камеры не станет правильным.
Когда всё правильно, перезапустите в 1080P и заберите финальный фрагмент со страницы модели преобразования текста в видео MiniMax H3 Max — те же промпты, качество для сдачи.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков