
使用指南
MiniMax H3 Max 文生视频提示词:可直接复制粘贴的实战配方与真实输出
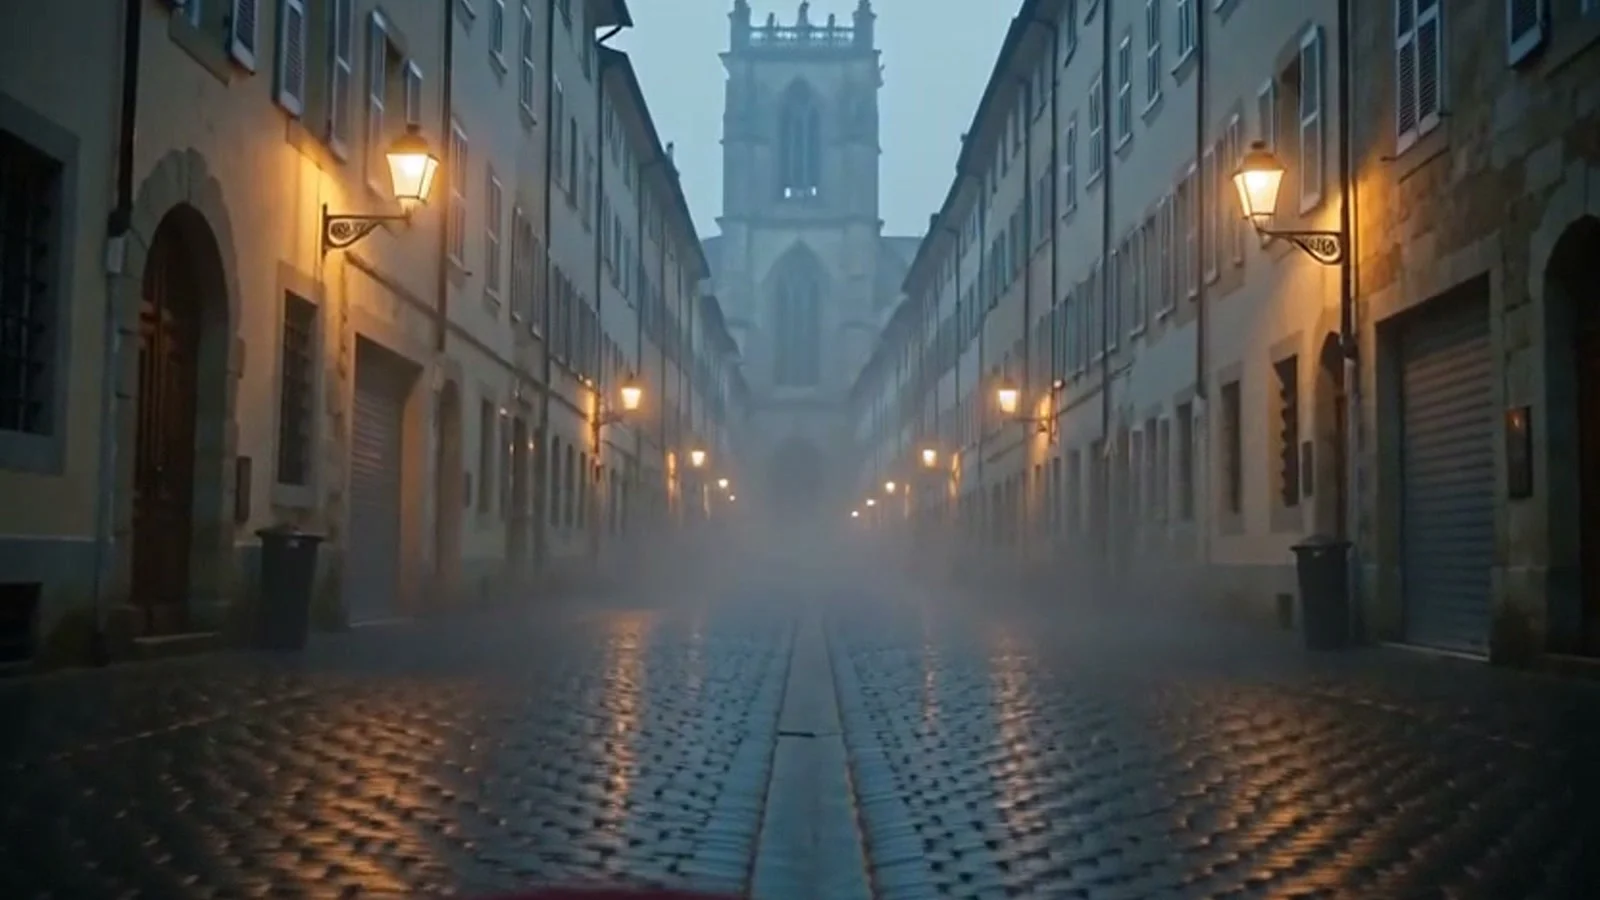
大多数文生视频提示词都栽在同一个地方:它们描述的是一幅画面,而不是一个镜头。你得到的是一帧漂亮但几乎不动,或者一动就糊成一团的画面。MiniMax H3 Max 奖励的恰恰是相反的习惯——像导演一样写提示词。告诉它镜头从哪里开始、到哪里结束、这几秒钟怎么分配,以及场景听起来是什么样,它就会用真实的运镜逻辑和匹配的音轨把这个镜头撑住。
本指南给出三份可直接复制粘贴的配方,每一份都围绕一个你真正需要的控制点:镜头运动、固定时长内的节奏分配,以及多个运动元素的协同编排。下面每个片段都是在 hiapi 上用紧挨着它印出的原始提示词生成的——没有精挑细选,也没有事后清理。复制提示词,换掉主体,就能发布你自己的作品。
三个样例都以 480P 渲染,用于快速、廉价的迭代(最便宜的档位);当你需要交付质量时,同样的提示词可以直接放大到 768P 和 1080P。
MiniMax H3 Max 如何解读提示词
调用需要传入一个 prompt 加三个参数,而 prompt 本身还携带第四个隐形参数——声音。把心智模型建立正确,下面的配方就不再像魔法了:
prompt—— 镜头描述,而不是配文。模型会响应运镜动词("push in"、"crane up"、"orbit")、光照和氛围词,以及一条明确的Ambient sound:行,由它驱动生成的音频。duration—— 从0.92到15秒的数字。这是你的节奏预算。秒数越多,你就能安排更多节拍;秒数越少,就专注完成一个动作。resolution——480P、768P或1080P。廉价迭代,清晰交付。aspect_ratio——21:9、16:9、4:3、1:1、3:4或9:16。在写提示词之前就按投放场景选定(电影感、社交竖版、方形产品图),因为画幅会改变你描述构图的方式。
每条配方都有两个重要习惯。第一,锚定镜头:说明它从哪里开始、到哪里结束,中间的运动就能保持连贯。第二,列出负面项——no people, no text, no cuts, no speech——因为文生视频模型很喜欢在一个本该一镜到底的镜头里凭空捏造字幕和硬切。
配方 1 —— 镜头运动:推近与摇臂揭示
最有用的单一动作是从近景开始再打开视野。这里镜头从湿石板上的一把红伞几英寸处开始,然后向前推进并向上摇起,揭示整条小巷。一个主体,一个连续动作,结尾有回报。
Single continuous shot. A lone open red umbrella lies on wet cobblestones
in an empty European alley at dawn, thin fog, puddles mirroring amber
streetlamps. The camera starts low and close on the umbrella, then slowly
pushes forward and cranes upward into a wide reveal of the long alley
stretching toward a misty cathedral. Gentle natural motion: drifting fog,
a few slow raindrops rippling the puddles. Cinematic, shallow depth of
field, warm-cool color contrast, stable geometry, seamless temporal
consistency, no people, no text, no cuts. Ambient sound: soft rain,
distant church bells, faint wind, no speech.
参数: aspect_ratio: 16:9 · duration: 6 · resolution: 480P
为什么有效:
- 一句话,两个机位。 "starts low and close… then pushes forward and cranes upward into a wide reveal" 给了模型一个起始帧和一个结束帧。它会在两者之间插值出一个可信的动作,而不是漫无目的地游走。
- 不是镜头本身的运动。 "drifting fog" 和 "raindrops rippling the puddles" 让场景有了生命力,又不会与镜头运动抢戏。次要运动能防止画面看起来像冻住了。
- 氛围词确实在干活。 "warm-cool color contrast" 和 "shallow depth of field" 把观感推向电影感;结果中琥珀色与雾气的色彩对比就直接来自这一句。
- 替换测试: 把伞和小巷换成 "a vintage motorcycle in a neon-lit garage",原样保留镜头那句话——运镜可以干净地迁移过去。
配方 2 —— 节奏:用定时节拍花掉固定时长
当你有超过几秒的时长时,不要为整个片段描述一个静态瞬间——要把节拍写成脚本。在提示词里标注时间窗口,告诉模型如何分配时长。这个 8 秒竖版片段运行一段三拍倒液序列。
Vertical social clip, one continuous take, three beats.
Beat 1 (0-3s): a barista's hands pour hot espresso over a glass of ice,
close macro, dark crema swirling.
Beat 2 (3-6s): milk cascades in slow motion, blooming into feathered
clouds through the coffee.
Beat 3 (6-8s): the camera pulls back to reveal the finished iced latte on
a sunlit marble counter beside fresh mint.
Warm morning light, crisp condensation on the glass, smooth natural
motion, high detail, stable focus, no text. Ambient sound: gentle pour,
ice clink, soft cafe hum, no speech.
参数: aspect_ratio: 9:16 · duration: 8 · resolution: 480P
为什么有效:
- 节拍对应秒数。 "Beat 1 (0-3s)… Beat 2 (3-6s)… Beat 3 (6-8s)" 告诉模型如何分配时长,于是动作向前推进,而不是循环同一个手势。让你的节拍窗口之和等于你请求的
duration。 - 一个节拍 = 一个变化。 每个节拍只引入一件新事物(倒液 → 奶泡绽开 → 拉远揭示)。把一个节拍里塞进两个变化,模型往往会赶进度或把它们糊在一起。
- 把揭示留到最后。 Beat 3 里的拉远就是回报。以更宽的画幅结束读起来像是有意的收尾,而不是一段跑到没时间的片段。
- 竖版是构图选择,不只是裁剪。 使用
9:16时,你描述的是一幅高画幅——一只杯子填满中心——而不是把一幅横版画面硬塞进手机屏幕。
配方 3 —— 场景编排:多个元素一起运动
最难的场景是多个东西同时运动而镜头不散架。诀窍是给每个元素它自己的动词和路径,然后给镜头一件简单的活儿。这里:一条丝带绕着一只瓶子盘旋,薄雾在背景中飘过,镜头缓慢环绕。
Square product shot, single continuous take. On a dark reflective stage,
three frosted glass perfume bottles stand in a row. A ribbon of golden
silk floats in from the left and spirals around the center bottle, while
a soft burst of white mist drifts across the background and settles. The
camera orbits slowly clockwise around the bottles. Studio rim lighting,
deep shadows, physically accurate reflections on the glass and stage,
premium luxury commercial finish, controlled elegant motion, stable
geometry, no people, no logos, no text. Ambient sound: low cinematic hum,
soft whoosh of silk, delicate chime, no speech.
参数: aspect_ratio: 1:1 · duration: 6 · resolution: 480P
为什么有效:
- 每个元素都有动词和方向。 丝带 "floats in from the left and spirals around the center bottle";薄雾 "drifts across the background and settles"。为每个元素指明路径,能防止它们碰撞成一团噪声。
- 给镜头简单的活儿。 主体已经在做编排时,一句朴素的 "orbits slowly clockwise" 就够了。既让镜头做复杂动作又同时驱动三个元素,正是镜头崩掉的时刻。
- 物理词换来真实感。 "physically accurate reflections on the glass and stage" 正是瓶子能在地面上正确映出倒影的原因——反光材质需要被明确点出来。
no logos名副其实。 在产品镜头里,模型否则会凭空发明品牌标识。负面项就是保持画面干净可用的手段。
自己动手运行
上面每个片段都是 hiapi 的 /v1/tasks 端点上的一个异步任务——提交、轮询、下载。输入字段正好是配方中的四个参数:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3-max/text-to-video",
    "input": {
      "prompt": "Single continuous shot. A lone open red umbrella on wet cobblestones... Ambient sound: soft rain, distant church bells, no speech.",
      "duration": 6,
      "resolution": "480P",
      "aspect_ratio": "16:9"
    }
  }'
响应会返回一个 taskId;轮询 GET /v1/tasks/{taskId} 直到 status 为 success,然后从输出 URL 取回片段(这是一个短期有效的链接——立刻下载)。
费用随你请求的秒数增长,而不是实际返回的秒数。 截至 2026 年 10 月,MiniMax H3 Max 文生视频按请求的视频秒数计费:480P 为 $0.072/秒、768P 为 $0.115/秒、1080P 为 $0.229/秒。所以这里三个 480P 片段(6 秒 + 8 秒 + 6 秒)总共约 $1.44。先在 480P 下迭代提示词,再把选中的版本以 1080P 重跑。实时价格见 hiapi 价格页面。
已经有想要的首帧了?同样的提示词语法也适用于 MiniMax H3 Max 图生视频——交给它一张静帧,转而描述运动和声音,而不是整个场景。
常见问题
MiniMax H3 Max 会生成声音,还是我之后自己加?
它会根据你的提示词生成音频。每条配方里的 Ambient sound: 行正是上面片段中雨声、咖啡馆嗡鸣和丝绸嗖声的来源——无需后期制作。除非你明确想要对白,否则写 no speech,并描述你想要的氛围,而不是听天由命。
最大片段长度是多少? 每个任务的时长从 0.92 到 15 秒。更长的内容就生成多个片段拼接起来——并像配方 2 那样为每个片段编排节拍,让它们能干净地剪辑在一起。
为什么我的片段看起来发软或发灰? 通常问题在分辨率档位,而不在提示词。这些样例是 480P,用于廉价迭代。把最终提示词以 768P 或 1080P 重跑以获得交付清晰度。同时加上材质和光照词("physically accurate reflections"、"studio rim lighting")——它们对观感的锐化效果不亚于像素数量。
如何阻止它添加文字或字幕?
在负面项里写上 no text(产品类再加 no subtitles、no logos)。文生视频模型经常凭空生成屏幕文字;明确列出才是可靠的解决办法。
我应该用哪种宽高比?
匹配投放场景:16:9 或 21:9 用于电影感和横版,9:16 或 3:4 用于社交和移动端,1:1 用于产品图和信息流。在写提示词之前就选好,因为画幅会改变你描述构图的方式。
开始当导演
三条配方背后的模式都一样:写明镜头的起点和终点,用节拍花掉时长,给每个运动元素它自己的动词,并写出声音。抄走这些提示词,换进你的主体,在 480P 下迭代,直到运镜正确。
正确之后,以 1080P 重跑,并从 MiniMax H3 Max 文生视频模型页面取回最终片段——同样的提示词,交付质量。


