
Guía de uso
Prompts de texto a video de MiniMax H3 Max: fórmulas prácticas listas para copiar y pegar con resultados reales
La mayoría de los prompts de texto a video fallan en el mismo punto: describen una imagen, no una toma. Lo que obtienes es un fotograma bonito que apenas se mueve, o que se convierte en un amasijo en cuanto se mueve. MiniMax H3 Max premia justo el hábito contrario: escribir prompts como un director. Dile dónde empieza la toma, dónde termina, cómo repartir esos segundos y cómo suena la escena, y sostendrá la toma con una lógica de movimiento de cámara real y una pista de audio que encaja.
Esta guía ofrece tres fórmulas listas para copiar y pegar, cada una centrada en un punto de control que de verdad necesitas: el movimiento de cámara, el reparto del ritmo dentro de una duración fija y la coreografía coordinada de varios elementos en movimiento. Cada clip de abajo se generó en hiapi con el prompt en bruto impreso justo al lado: sin selección previa ni limpieza posterior. Copia el prompt, cambia el sujeto y publica tu propia pieza.
Los tres ejemplos se renderizaron a 480P para iterar rápido y barato (el nivel más económico); cuando necesites calidad de entrega, los mismos prompts se pueden escalar directamente a 768P y 1080P.
Cómo interpreta los prompts MiniMax H3 Max
La llamada requiere un prompt más tres parámetros, y el propio prompt lleva un cuarto parámetro invisible: el sonido. Si construyes bien el modelo mental, las fórmulas de abajo dejan de parecer magia:
prompt—— descripción de la toma, no un pie de foto. El modelo responde a verbos de movimiento de cámara ("push in", "crane up", "orbit"), a palabras de iluminación y atmósfera, y a una línea explícitaAmbient sound:que impulsa el audio generado.duration—— un número de0.92a15segundos. Es tu presupuesto de ritmo. Con más segundos puedes programar más tiempos; con menos, céntrate en completar una sola acción.resolution——480P,768Po1080P. Iteración barata, entrega nítida.aspect_ratio——21:9,16:9,4:3,1:1,3:4o9:16. Elígelo según el destino antes de escribir el prompt (cine, vertical para redes, foto de producto cuadrada), porque el formato cambia la forma en que describes la composición.
Cada fórmula tiene dos hábitos importantes. Primero, anclar la cámara: indica de dónde parte y a dónde llega, y el movimiento intermedio se mantendrá coherente. Segundo, enumerar los negativos —— no people, no text, no cuts, no speech —— porque los modelos de texto a video adoran inventar subtítulos y cortes duros dentro de una toma que debería ser continua.
Fórmula 1 —— Movimiento de cámara: acercamiento y revelado con grúa
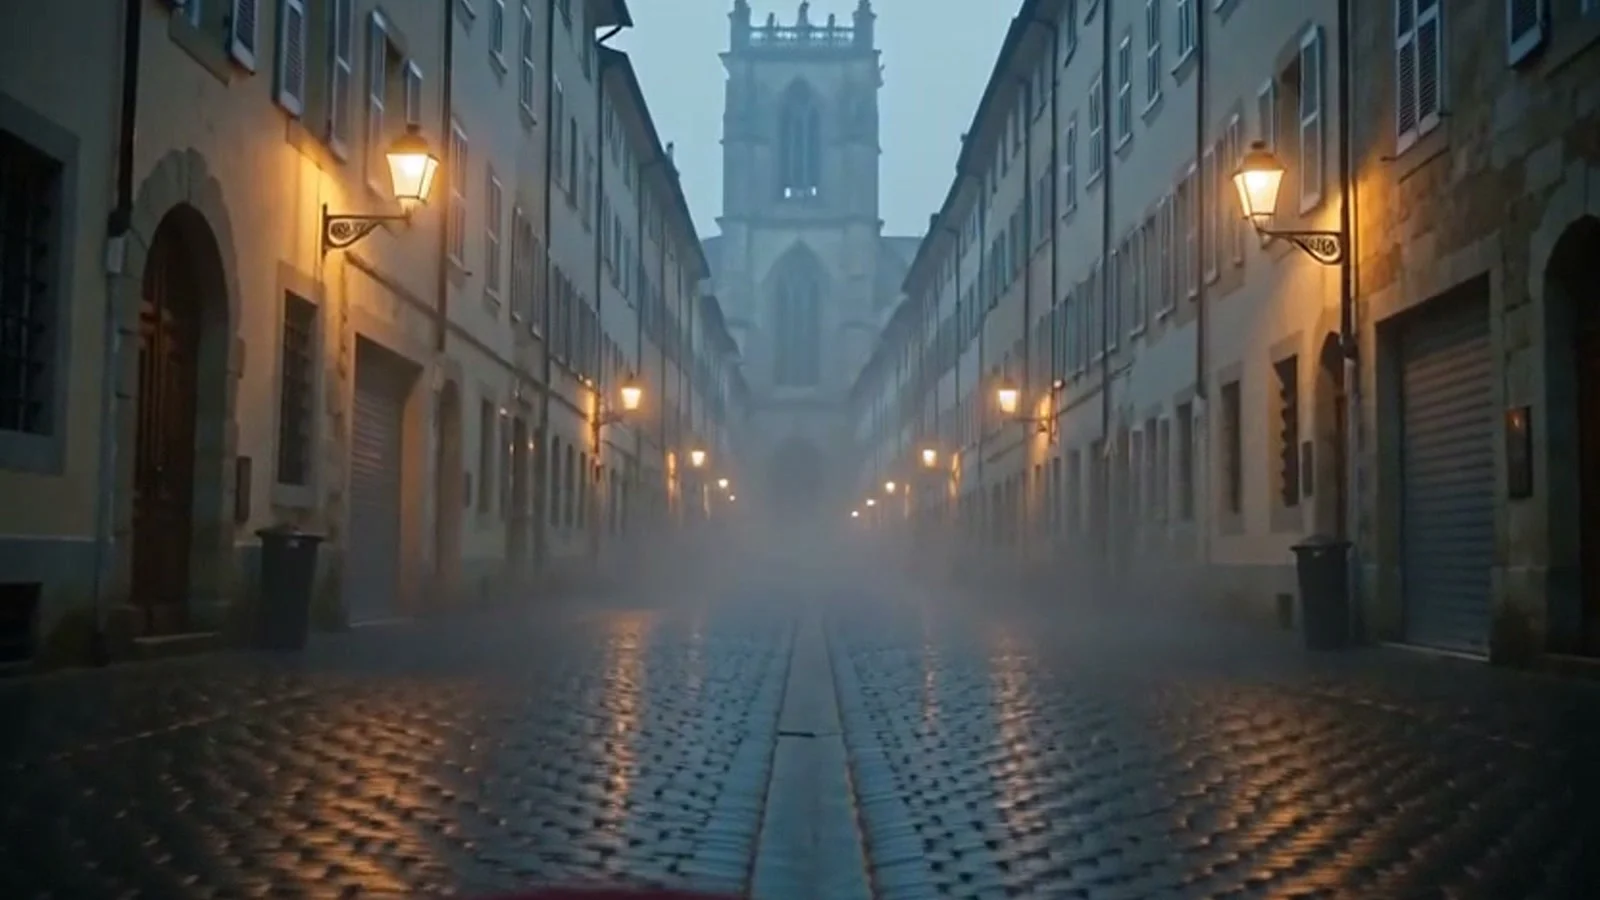
La acción única más útil es empezar cerca y luego abrir el campo de visión. Aquí la cámara arranca a pocos centímetros de un paraguas rojo sobre adoquines mojados, y después avanza y sube con la grúa para revelar todo el callejón. Un sujeto, una acción continua, una recompensa al final.
Single continuous shot. A lone open red umbrella lies on wet cobblestones
in an empty European alley at dawn, thin fog, puddles mirroring amber
streetlamps. The camera starts low and close on the umbrella, then slowly
pushes forward and cranes upward into a wide reveal of the long alley
stretching toward a misty cathedral. Gentle natural motion: drifting fog,
a few slow raindrops rippling the puddles. Cinematic, shallow depth of
field, warm-cool color contrast, stable geometry, seamless temporal
consistency, no people, no text, no cuts. Ambient sound: soft rain,
distant church bells, faint wind, no speech.
Parámetros: aspect_ratio: 16:9 · duration: 6 · resolution: 480P
Por qué funciona:
- Una frase, dos posiciones de cámara. "starts low and close… then pushes forward and cranes upward into a wide reveal" da al modelo un fotograma inicial y uno final. Interpola entre ambos un movimiento creíble en lugar de vagar sin rumbo.
- Movimiento que no es de la cámara. "drifting fog" y "raindrops rippling the puddles" dan vida a la escena sin competir con el movimiento de cámara. El movimiento secundario evita que la imagen parezca congelada.
- Las palabras de atmósfera sí trabajan. "warm-cool color contrast" y "shallow depth of field" empujan el aspecto hacia lo cinematográfico; el contraste entre ámbar y niebla del resultado viene directamente de esa frase.
- Prueba de sustitución: cambia el paraguas y el callejón por "a vintage motorcycle in a neon-lit garage" y conserva la frase de cámara tal cual: el movimiento se traslada limpiamente.
Fórmula 2 —— Ritmo: gastar una duración fija con tiempos programados
Cuando tienes más de unos pocos segundos, no describas un instante estático para todo el clip: guioniza los tiempos. Anota ventanas temporales en el prompt para indicar al modelo cómo repartir la duración. Este clip vertical de 8 segundos ejecuta una secuencia de vertido en tres tiempos.
Vertical social clip, one continuous take, three beats.
Beat 1 (0-3s): a barista's hands pour hot espresso over a glass of ice,
close macro, dark crema swirling.
Beat 2 (3-6s): milk cascades in slow motion, blooming into feathered
clouds through the coffee.
Beat 3 (6-8s): the camera pulls back to reveal the finished iced latte on
a sunlit marble counter beside fresh mint.
Warm morning light, crisp condensation on the glass, smooth natural
motion, high detail, stable focus, no text. Ambient sound: gentle pour,
ice clink, soft cafe hum, no speech.
Parámetros: aspect_ratio: 9:16 · duration: 8 · resolution: 480P
Por qué funciona:
- Los tiempos corresponden a los segundos. "Beat 1 (0-3s)… Beat 2 (3-6s)… Beat 3 (6-8s)" indica al modelo cómo repartir la duración, de modo que la acción avanza en lugar de repetir el mismo gesto. Haz que la suma de tus ventanas de tiempo sea igual a la
durationque pides. - Un tiempo = un cambio. Cada tiempo introduce solo una cosa nueva (vertido → florecimiento de la leche → alejamiento revelador). Si metes dos cambios en un tiempo, el modelo suele acelerar o mezclarlos.
- Guarda la revelación para el final. El alejamiento del Beat 3 es la recompensa. Terminar con un encuadre más amplio se lee como un cierre intencionado, no como un clip que se quedó sin tiempo.
- El vertical es una decisión de composición, no solo un recorte. Con
9:16describes un encuadre alto —una taza que llena el centro— en lugar de meter a la fuerza un encuadre horizontal en la pantalla del móvil.
Fórmula 3 —— Coreografía de escena: varios elementos moviéndose juntos
Las escenas más difíciles son aquellas en las que varias cosas se mueven a la vez sin que la cámara se desmorone. El truco es dar a cada elemento su propio verbo y trayectoria, y luego dar a la cámara una tarea sencilla. Aquí: una cinta gira en espiral alrededor de una botella, una niebla fina cruza el fondo y la cámara orbita lentamente.
Square product shot, single continuous take. On a dark reflective stage,
three frosted glass perfume bottles stand in a row. A ribbon of golden
silk floats in from the left and spirals around the center bottle, while
a soft burst of white mist drifts across the background and settles. The
camera orbits slowly clockwise around the bottles. Studio rim lighting,
deep shadows, physically accurate reflections on the glass and stage,
premium luxury commercial finish, controlled elegant motion, stable
geometry, no people, no logos, no text. Ambient sound: low cinematic hum,
soft whoosh of silk, delicate chime, no speech.
Parámetros: aspect_ratio: 1:1 · duration: 6 · resolution: 480P
Por qué funciona:
- Cada elemento tiene verbo y dirección. La cinta "floats in from the left and spirals around the center bottle"; la niebla "drifts across the background and settles". Dar una trayectoria a cada elemento evita que choquen y formen una masa de ruido.
- Dale a la cámara una tarea sencilla. Cuando el sujeto ya está coreografiado, basta con un sobrio "orbits slowly clockwise". Hacer que la cámara ejecute un movimiento complejo y dirigir tres elementos a la vez es justo el momento en que la toma se rompe.
- Las palabras físicas aportan realismo. "physically accurate reflections on the glass and stage" es exactamente la razón por la que las botellas se reflejan correctamente en el suelo: los materiales reflectantes deben mencionarse explícitamente.
no logoscumple lo que promete. En una toma de producto, el modelo inventaría de otro modo logotipos de marca. Los negativos son el medio para mantener la imagen limpia y utilizable.
Ejecútalo tú mismo
Cada clip de arriba es una tarea asíncrona en el endpoint /v1/tasks de hiapi: envías, consultas, descargas. Los campos de entrada son exactamente los cuatro parámetros de las fórmulas:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3-max/text-to-video",
    "input": {
      "prompt": "Single continuous shot. A lone open red umbrella on wet cobblestones... Ambient sound: soft rain, distant church bells, no speech.",
      "duration": 6,
      "resolution": "480P",
      "aspect_ratio": "16:9"
    }
  }'
La respuesta devuelve un taskId; consulta GET /v1/tasks/{taskId} hasta que status sea success y luego recupera el clip desde la URL de salida (es un enlace de corta duración: descárgalo de inmediato).
El coste crece con los segundos que pides, no con los que se devuelven realmente. A octubre de 2026, el texto a video de MiniMax H3 Max se factura por segundo de vídeo solicitado: 480P a $0.072/segundo, 768P a $0.115/segundo, 1080P a $0.229/segundo. Así que los tres clips de 480P de aquí (6 s + 8 s + 6 s) suman unos $1.44. Itera los prompts en 480P y luego vuelve a ejecutar la versión elegida en 1080P. Consulta los precios en tiempo real en la página de precios de hiapi.
¿Ya tienes el primer fotograma que quieres? La misma sintaxis de prompt sirve para MiniMax H3 Max imagen a video: dale una imagen fija y describe el movimiento y el sonido en lugar de toda la escena.
Preguntas frecuentes
¿MiniMax H3 Max genera sonido, o lo añado yo después?
Genera audio a partir de tu prompt. La línea Ambient sound: de cada fórmula es justo el origen de la lluvia, el murmullo de cafetería y el susurro de seda de los clips de arriba: sin posproducción. Escribe no speech salvo que quieras diálogo explícitamente, y describe la atmósfera que deseas en lugar de dejarlo al azar.
¿Cuál es la duración máxima de un clip? La duración por tarea va de 0.92 a 15 segundos. Para contenido más largo, genera varios clips y únelos, y programa los tiempos de cada clip como en la fórmula 2 para que se puedan montar limpiamente.
¿Por qué mi clip se ve blando o grisáceo? Normalmente el problema está en el nivel de resolución, no en el prompt. Estos ejemplos son 480P, para iteración barata. Vuelve a ejecutar el prompt final en 768P o 1080P para obtener nitidez de entrega. Añade además palabras de material e iluminación ("physically accurate reflections", "studio rim lighting"): afinan el aspecto tanto como el número de píxeles.
¿Cómo evito que añada texto o subtítulos?
Incluye no text en los negativos (y para producto también no subtitles, no logos). Los modelos de texto a video generan a menudo texto en pantalla de la nada; enumerarlo explícitamente es la solución fiable.
¿Qué relación de aspecto debería usar?
Coincide con el destino: 16:9 o 21:9 para cine y horizontal, 9:16 o 3:4 para redes y móvil, 1:1 para fotos de producto y feeds. Elígelo antes de escribir el prompt, porque el formato cambia la forma en que describes la composición.
Empieza a dirigir
El patrón detrás de las tres fórmulas es el mismo: indica el punto de inicio y el de fin de la cámara, gasta la duración en tiempos, da a cada elemento en movimiento su propio verbo y escribe el sonido. Copia estos prompts, sustituye tu sujeto e itera en 480P hasta que el movimiento de cámara sea correcto.
Cuando lo sea, vuelve a ejecutar en 1080P y recupera el clip final desde la página del modelo de texto a video MiniMax H3 Max: el mismo prompt, calidad de entrega.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores