
Benutzerhandbuch
MiniMax H3 Max Text-zu-Video-Prompts: direkt kopierbare Praxisrezepte und echte Ergebnisse
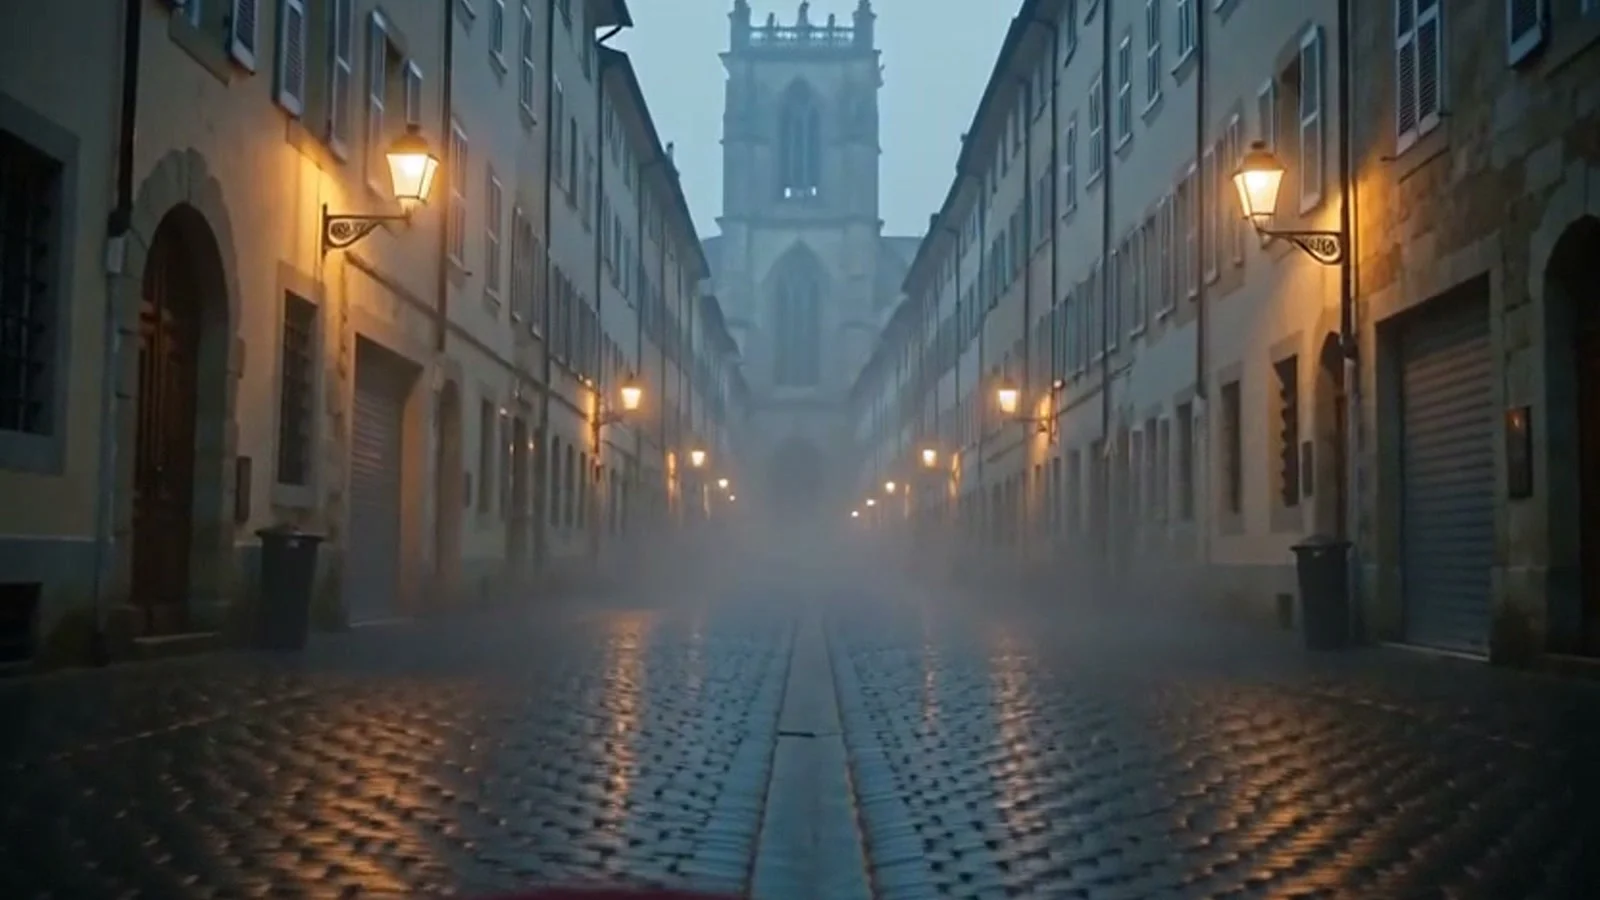
Die meisten Text-zu-Video-Prompts scheitern an derselben Stelle: Sie beschreiben ein Bild, nicht eine Einstellung. Was du bekommst, ist ein hübsches, aber kaum bewegtes Bild – oder eines, das bei der ersten Bewegung zu einem Brei verschwimmt. MiniMax H3 Max belohnt genau die entgegengesetzte Gewohnheit – schreibe Prompts wie ein Regisseur. Sag ihm, wo die Kamera beginnt, wo sie endet, wie diese paar Sekunden aufgeteilt werden und wie die Szene klingt, und es trägt die Einstellung mit echter Kameraführungslogik und passender Tonspur.
Dieser Leitfaden liefert drei direkt kopierbare Rezepte, jedes um einen Kontrollpunkt herum aufgebaut, den du wirklich brauchst: Kamerabewegung, Rhythmusverteilung innerhalb einer festen Dauer und die koordinierte Choreografie mehrerer Bewegungselemente. Jeder Clip unten wurde auf hiapi mit dem direkt daneben abgedruckten Original-Prompt generiert – keine Rosinenpickerei, keine Nachbearbeitung. Kopiere den Prompt, tausche das Motiv aus und veröffentliche dein eigenes Werk.
Alle drei Beispiele wurden in 480P gerendert, für schnelle, günstige Iteration (die billigste Stufe); wenn du Lieferqualität brauchst, lassen sich dieselben Prompts direkt auf 768P und 1080P hochskalieren.
Wie MiniMax H3 Max Prompts interpretiert
Ein Aufruf übergibt einen Prompt plus drei Parameter, und der Prompt selbst trägt noch einen vierten unsichtbaren Parameter – den Ton. Wenn du das mentale Modell richtig aufbaust, wirken die folgenden Rezepte nicht mehr wie Magie:
prompt– eine Einstellungsbeschreibung, keine Bildunterschrift. Das Modell reagiert auf Kameraführungsverben ("push in", "crane up", "orbit"), Licht- und Stimmungswörter sowie auf eine explizite ZeileAmbient sound:, die das generierte Audio steuert.duration– eine Zahl von0.92bis15Sekunden. Das ist dein Rhythmusbudget. Mehr Sekunden bedeuten mehr Takt-Schläge, die du setzen kannst; weniger Sekunden bedeuten, dass du dich auf eine einzige Aktion konzentrierst.resolution–480P,768Poder1080P. Günstig iterieren, scharf liefern.aspect_ratio–21:9,16:9,4:3,1:1,3:4oder9:16. Wähle es vor dem Schreiben des Prompts passend zum Einsatzort (filmisch, vertikal für Social, quadratisch für Produktaufnahmen), denn das Format verändert, wie du die Komposition beschreibst.
Jedes Rezept hat zwei wichtige Gewohnheiten. Erstens: die Einstellung verankern – gib an, wo sie beginnt und wo sie endet, damit die Bewegung dazwischen zusammenhängend bleibt. Zweitens: Negativpunkte auflisten – no people, no text, no cuts, no speech – denn Text-zu-Video-Modelle erfinden nur zu gern Untertitel und harte Schnitte in einer Einstellung, die eigentlich durchgehend sein soll.
Rezept 1 – Kamerabewegung: Push-in und Kran-Enthüllung
Die nützlichste einzelne Bewegung beginnt nah und öffnet dann das Blickfeld. Hier startet die Kamera wenige Zentimeter von einem roten Regenschirm auf nassem Pflaster entfernt und fährt dann vorwärts und schwenkt nach oben, um die ganze Gasse zu enthüllen. Ein Motiv, eine kontinuierliche Bewegung, eine Belohnung am Ende.
Single continuous shot. A lone open red umbrella lies on wet cobblestones
in an empty European alley at dawn, thin fog, puddles mirroring amber
streetlamps. The camera starts low and close on the umbrella, then slowly
pushes forward and cranes upward into a wide reveal of the long alley
stretching toward a misty cathedral. Gentle natural motion: drifting fog,
a few slow raindrops rippling the puddles. Cinematic, shallow depth of
field, warm-cool color contrast, stable geometry, seamless temporal
consistency, no people, no text, no cuts. Ambient sound: soft rain,
distant church bells, faint wind, no speech.
Parameter: aspect_ratio: 16:9 · duration: 6 · resolution: 480P
Warum es funktioniert:
- Ein Satz, zwei Kamerapositionen. "starts low and close… then pushes forward and cranes upward into a wide reveal" gibt dem Modell ein Startbild und ein Endbild. Es interpoliert dazwischen eine glaubwürdige Bewegung, statt ziellos umherzuwandern.
- Bewegung, die nicht die Kamera selbst ist. "drifting fog" und "raindrops rippling the puddles" erwecken die Szene zum Leben, ohne der Kamerabewegung die Show zu stehlen. Sekundärbewegung verhindert, dass das Bild eingefroren wirkt.
- Stimmungswörter arbeiten tatsächlich. "warm-cool color contrast" und "shallow depth of field" treiben die Optik ins Filmische; der Farbkontrast aus Amber und Nebel im Ergebnis stammt direkt aus diesem Satz.
- Austauschtest: Ersetze den Regenschirm und die Gasse durch "a vintage motorcycle in a neon-lit garage" und behalte den Kamerabewegungssatz unverändert – die Kameraführung lässt sich sauber übertragen.
Rezept 2 – Rhythmus: eine feste Dauer mit getakteten Beats ausfüllen
Wenn du mehr als ein paar Sekunden hast, beschreibe nicht einen statischen Moment für den ganzen Clip – schreibe die Beats wie ein Drehbuch. Markiere Zeitfenster im Prompt, um dem Modell zu sagen, wie es die Dauer aufteilen soll. Dieser 8-sekündige vertikale Clip inszeniert eine dreiteilige Abfolge, bei der Flüssigkeit eingegossen wird.
Vertical social clip, one continuous take, three beats.
Beat 1 (0-3s): a barista's hands pour hot espresso over a glass of ice,
close macro, dark crema swirling.
Beat 2 (3-6s): milk cascades in slow motion, blooming into feathered
clouds through the coffee.
Beat 3 (6-8s): the camera pulls back to reveal the finished iced latte on
a sunlit marble counter beside fresh mint.
Warm morning light, crisp condensation on the glass, smooth natural
motion, high detail, stable focus, no text. Ambient sound: gentle pour,
ice clink, soft cafe hum, no speech.
Parameter: aspect_ratio: 9:16 · duration: 8 · resolution: 480P
Warum es funktioniert:
- Beats entsprechen Sekunden. "Beat 1 (0-3s)… Beat 2 (3-6s)… Beat 3 (6-8s)" sagt dem Modell, wie es die Dauer aufteilen soll, sodass die Aktion voranschreitet statt dieselbe Geste zu wiederholen. Lass die Summe deiner Beat-Fenster der angefragten
durationentsprechen. - Ein Beat = eine Veränderung. Jeder Beat führt nur eine neue Sache ein (Eingießen → Milchschaum blüht auf → Zurückziehen zur Enthüllung). Packst du zwei Veränderungen in einen Beat, hetzt das Modell oft oder verschmiert sie.
- Bewahre die Enthüllung für den Schluss auf. Das Zurückziehen in Beat 3 ist die Belohnung. Mit einer weiteren Einstellung zu enden liest sich als bewusster Abschluss und nicht als ein Clip, dem die Zeit ausgeht.
- Vertikal ist eine Kompositionsentscheidung, nicht bloßes Zuschneiden. Bei
9:16beschreibst du ein hohes Bildformat – ein Glas füllt die Mitte – statt ein Querformat in einen Handybildschirm zu quetschen.
Rezept 3 – Szenen-Choreografie: mehrere Elemente bewegen sich gemeinsam
Die schwierigste Szene ist die, in der sich mehrere Dinge gleichzeitig bewegen, ohne dass die Einstellung auseinanderfällt. Der Trick: Gib jedem Element sein eigenes Verb und seinen eigenen Pfad, und gib der Kamera eine einfache Aufgabe. Hier: ein Seidenband windet sich um einen Flakon, feiner Nebel zieht im Hintergrund vorbei, und die Kamera umkreist langsam.
Square product shot, single continuous take. On a dark reflective stage,
three frosted glass perfume bottles stand in a row. A ribbon of golden
silk floats in from the left and spirals around the center bottle, while
a soft burst of white mist drifts across the background and settles. The
camera orbits slowly clockwise around the bottles. Studio rim lighting,
deep shadows, physically accurate reflections on the glass and stage,
premium luxury commercial finish, controlled elegant motion, stable
geometry, no people, no logos, no text. Ambient sound: low cinematic hum,
soft whoosh of silk, delicate chime, no speech.
Parameter: aspect_ratio: 1:1 · duration: 6 · resolution: 480P
Warum es funktioniert:
- Jedes Element hat ein Verb und eine Richtung. Das Band "floats in from the left and spirals around the center bottle"; der Nebel "drifts across the background and settles". Jedem Element einen Pfad zu geben, verhindert, dass sie zu einem Rauschbrei kollidieren.
- Gib der Kamera eine einfache Aufgabe. Wenn die Motive bereits choreografiert sind, reicht ein schlichtes "orbits slowly clockwise". Die Kamera und gleichzeitig drei Elemente komplizierte Dinge tun zu lassen, ist genau der Moment, in dem die Einstellung zusammenbricht.
- Physikwörter bringen Realismus. "physically accurate reflections on the glass and stage" ist der Grund, warum sich die Flakons korrekt auf dem Boden spiegeln – reflektierende Materialien müssen explizit benannt werden.
no logoswirkt wirklich. In Produktaufnahmen erfindet das Modell sonst Markenzeichen. Negativpunkte sind das Mittel, um das Bild sauber und verwendbar zu halten.
Selbst ausführen
Jeder Clip oben ist eine asynchrone Aufgabe am /v1/tasks-Endpoint von hiapi – einreichen, abfragen, herunterladen. Die Eingabefelder sind genau die vier Parameter aus den Rezepten:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3-max/text-to-video",
    "input": {
      "prompt": "Single continuous shot. A lone open red umbrella on wet cobblestones... Ambient sound: soft rain, distant church bells, no speech.",
      "duration": 6,
      "resolution": "480P",
      "aspect_ratio": "16:9"
    }
  }'
Die Antwort liefert eine taskId; frage GET /v1/tasks/{taskId} ab, bis status success ist, und hole den Clip dann von der Ausgabe-URL ab (das ist ein kurzlebiger Link – lade ihn sofort herunter).
Die Kosten richten sich nach den angefragten Sekunden, nicht nach den tatsächlich zurückgegebenen. Stand Oktober 2026 wird MiniMax H3 Max Text-zu-Video pro angefragter Videosekunde abgerechnet: $0.072/Sekunde bei 480P, $0.115/Sekunde bei 768P, $0.229/Sekunde bei 1080P. Die drei 480P-Clips hier (6 s + 8 s + 6 s) kosten also insgesamt etwa $1.44. Iteriere die Prompts zuerst in 480P und lasse die ausgewählten Versionen dann in 1080P erneut laufen. Aktuelle Preise findest du auf der hiapi-Preisseite.
Du hast schon ein Wunsch-Startbild? Dieselbe Prompt-Syntax funktioniert auch für MiniMax H3 Max Image-zu-Video – gib ihm ein Standbild und beschreibe stattdessen Bewegung und Ton statt der ganzen Szene.
Häufige Fragen
Generiert MiniMax H3 Max den Ton, oder füge ich ihn später selbst hinzu?
Es generiert Audio aus deinem Prompt. Die Zeile Ambient sound: in jedem Rezept ist genau die Quelle für das Regenrauschen, das Café-Brummen und das Seiden-Whoosh in den Clips oben – keine Postproduktion nötig. Schreibe no speech, es sei denn, du willst ausdrücklich Dialog, und beschreibe die gewünschte Atmosphäre, statt auf Glück zu hoffen.
Wie lang ist ein Clip maximal? Die Dauer pro Aufgabe reicht von 0.92 bis 15 Sekunden. Für längere Inhalte generiere mehrere Clips und setze sie zusammen – und choreografiere die Beats wie in Rezept 2 für jeden Clip, damit sie sich sauber aneinander schneiden lassen.
Warum wirkt mein Clip weich oder grau? Meist liegt das Problem an der Auflösungsstufe, nicht am Prompt. Diese Beispiele sind 480P für günstige Iteration. Lasse den finalen Prompt in 768P oder 1080P erneut laufen, um Lieferqualität zu bekommen. Füge außerdem Material- und Lichtwörter hinzu ("physically accurate reflections", "studio rim lighting") – sie schärfen den Look nicht minder als die Pixelzahl.
Wie verhindere ich, dass Text oder Untertitel hinzugefügt werden?
Schreibe no text in die Negativpunkte (bei Produkten zusätzlich no subtitles, no logos). Text-zu-Video-Modelle erzeugen oft spontan Bildschirmtext; das explizite Auflisten ist die zuverlässige Lösung.
Welches Seitenverhältnis sollte ich verwenden?
Passend zum Einsatzort: 16:9 oder 21:9 für Filmisches und Querformat, 9:16 oder 3:4 für Social und Mobil, 1:1 für Produktaufnahmen und Feeds. Wähle es vor dem Schreiben des Prompts, denn das Format verändert, wie du die Komposition beschreibst.
Fang an, Regie zu führen
Das Muster hinter allen drei Rezepten ist dasselbe: Beschreibe Start- und Endpunkt der Einstellung, fülle die Dauer mit Beats, gib jedem Bewegungselement sein eigenes Verb und beschreibe den Ton. Übernimm diese Prompts, setze dein Motiv ein und iteriere in 480P, bis die Kameraführung stimmt.
Wenn sie stimmt, lasse den Prompt in 1080P erneut laufen und hole den finalen Clip von der MiniMax H3 Max Text-zu-Video-Modellseite ab – gleicher Prompt, Lieferqualität.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte