
Guida all'uso
Prompt di text-to-video per MiniMax H3 Max: ricette pratiche da copiare e incollare con output reali
La maggior parte dei prompt di text-to-video fallisce nello stesso punto: descrive un'immagine, non un'inquadratura. Quello che ottieni è un fotogramma bello ma quasi immobile, oppure un'immagine che, appena si muove, diventa una macchia confusa. MiniMax H3 Max premia esattamente l'abitudine opposta: scrivere i prompt come un regista. Digli dove inizia l'inquadratura, dove finisce, come distribuire quei secondi e che suono ha la scena, e lui sosterrà l'inquadratura con una vera logica di movimento di camera e una traccia audio coerente.
Questa guida offre tre ricette da copiare e incollare, ciascuna centrata su un punto di controllo che ti serve davvero: movimento di camera, distribuzione del ritmo entro una durata fissa e coreografia coordinata di più elementi in movimento. Ogni clip qui sotto è stata generata su hiapi con il prompt originale stampato subito accanto — senza selezione accurata né ripuliture a posteriori. Copia il prompt, sostituisci il soggetto e pubblica il tuo lavoro.
Tutti e tre gli esempi sono renderizzati a 480P, per iterazioni rapide ed economiche (il livello più economico); quando ti serve qualità da consegna, gli stessi prompt si possono scalare direttamente a 768P e 1080P.
Come MiniMax H3 Max interpreta i prompt
La chiamata richiede un prompt più tre parametri, e il prompt stesso porta con sé un quarto parametro invisibile: il suono. Se costruisci correttamente il modello mentale, le ricette qui sotto smettono di sembrare magia:
prompt— descrizione dell'inquadratura, non didascalia. Il modello risponde ai verbi di movimento di camera ("push in", "crane up", "orbit"), alle parole su luce e atmosfera, e a una riga esplicitaAmbient sound:che guida l'audio generato.duration— un numero da0.92a15secondi. È il tuo budget ritmico. Più secondi, più battute puoi pianificare; meno secondi, concentrati su una sola azione.resolution—480P,768Po1080P. Iterazione economica, consegna nitida.aspect_ratio—21:9,16:9,4:3,1:1,3:4o9:16. Sceglilo in base al canale di destinazione prima di scrivere il prompt (cinematografico, verticale per social, prodotto quadrato), perché il formato cambia il modo in cui descrivi la composizione.
Ogni ricetta ha due abitudini importanti. Primo, ancorare l'inquadratura: indica dove inizia e dove finisce, così il movimento intermedio resta coerente. Secondo, elencare i negativi — no people, no text, no cuts, no speech — perché i modelli di text-to-video amano inventare sottotitoli e stacchi netti in un'inquadratura che dovrebbe essere un unico piano sequenza.
Ricetta 1 — Movimento di camera: push-in e rivelazione con gru
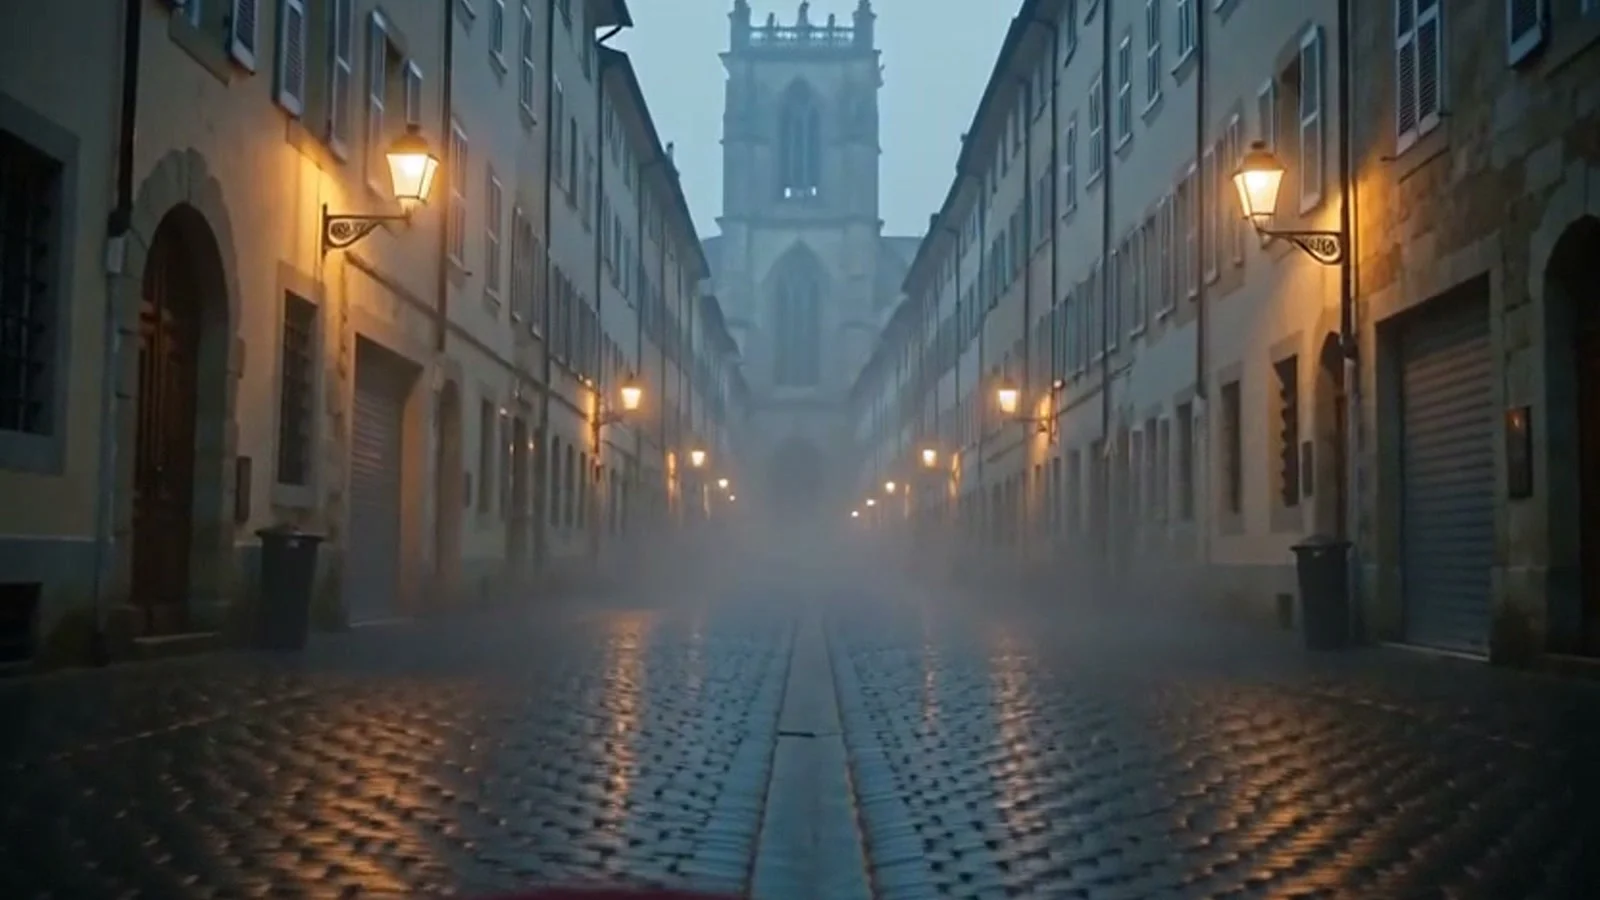
L'azione singola più utile è partire da vicino e poi aprire il campo visivo. Qui la camera parte a pochi centimetri da un ombrello rosso su lastre di pietra bagnate, poi avanza e si solleva con la gru, rivelando l'intero vicolo. Un soggetto, un'azione continua, una ricompensa finale.
Single continuous shot. A lone open red umbrella lies on wet cobblestones
in an empty European alley at dawn, thin fog, puddles mirroring amber
streetlamps. The camera starts low and close on the umbrella, then slowly
pushes forward and cranes upward into a wide reveal of the long alley
stretching toward a misty cathedral. Gentle natural motion: drifting fog,
a few slow raindrops rippling the puddles. Cinematic, shallow depth of
field, warm-cool color contrast, stable geometry, seamless temporal
consistency, no people, no text, no cuts. Ambient sound: soft rain,
distant church bells, faint wind, no speech.
Parametri: aspect_ratio: 16:9 · duration: 6 · resolution: 480P
Perché funziona:
- Una frase, due posizioni di camera. "starts low and close… then pushes forward and cranes upward into a wide reveal" dà al modello un fotogramma iniziale e uno finale. Interpola un movimento credibile tra i due, invece di vagare senza meta.
- Movimento che non è della camera. "drifting fog" e "raindrops rippling the puddles" danno vita alla scena senza rubare la scena al movimento di camera. Il movimento secondario evita che l'immagine sembri congelata.
- Le parole d'atmosfera fanno davvero il loro lavoro. "warm-cool color contrast" e "shallow depth of field" spingono il look verso il cinematografico; il contrasto cromatico tra ambra e nebbia nel risultato viene direttamente da questa frase.
- Test di sostituzione: sostituisci l'ombrello e il vicolo con "a vintage motorcycle in a neon-lit garage" e lascia intatta la frase sulla camera — il movimento si trasferisce pulito.
Ricetta 2 — Ritmo: spendere una durata fissa con battute temporizzate
Quando hai più di qualche secondo a disposizione, non descrivere un istante statico per l'intera clip — scrivi le battute come un copione. Annota le finestre temporali nel prompt per dire al modello come distribuire la durata. Questa clip verticale di 8 secondi esegue una sequenza di versamento in tre battute.
Vertical social clip, one continuous take, three beats.
Beat 1 (0-3s): a barista's hands pour hot espresso over a glass of ice,
close macro, dark crema swirling.
Beat 2 (3-6s): milk cascades in slow motion, blooming into feathered
clouds through the coffee.
Beat 3 (6-8s): the camera pulls back to reveal the finished iced latte on
a sunlit marble counter beside fresh mint.
Warm morning light, crisp condensation on the glass, smooth natural
motion, high detail, stable focus, no text. Ambient sound: gentle pour,
ice clink, soft cafe hum, no speech.
Parametri: aspect_ratio: 9:16 · duration: 8 · resolution: 480P
Perché funziona:
- Le battute corrispondono ai secondi. "Beat 1 (0-3s)… Beat 2 (3-6s)… Beat 3 (6-8s)" dice al modello come distribuire la durata, così l'azione avanza invece di ripetere lo stesso gesto. Fai in modo che la somma delle finestre delle tue battute sia uguale alla
durationrichiesta. - Una battuta = un cambiamento. Ogni battuta introduce una sola cosa nuova (versamento → fioritura della schiuma di latte → allontanamento e rivelazione). Se infili due cambiamenti in una battuta, il modello tende a correre o a fonderli insieme.
- Lascia la rivelazione per ultima. L'allontanamento nella Beat 3 è la ricompensa. Chiudere con un'inquadratura più ampia si legge come una conclusione intenzionale, non come una clip che è finita senza tempo.
- Il verticale è una scelta di composizione, non solo un ritaglio. Quando usi
9:16, descrivi un formato alto — una tazza che riempie il centro — invece di schiacciare un'inquadratura orizzontale nello schermo del telefono.
Ricetta 3 — Coreografia di scena: più elementi in movimento insieme
Le scene più difficili sono quelle in cui più cose si muovono contemporaneamente senza che la camera vada in pezzi. Il trucco è dare a ogni elemento il proprio verbo e il proprio percorso, e poi dare alla camera un compito semplice. Qui: un nastro che si avvolge a spirale attorno a una boccetta, una nebbiolina che passa sullo sfondo, e la camera che orbita lentamente.
Square product shot, single continuous take. On a dark reflective stage,
three frosted glass perfume bottles stand in a row. A ribbon of golden
silk floats in from the left and spirals around the center bottle, while
a soft burst of white mist drifts across the background and settles. The
camera orbits slowly clockwise around the bottles. Studio rim lighting,
deep shadows, physically accurate reflections on the glass and stage,
premium luxury commercial finish, controlled elegant motion, stable
geometry, no people, no logos, no text. Ambient sound: low cinematic hum,
soft whoosh of silk, delicate chime, no speech.
Parametri: aspect_ratio: 1:1 · duration: 6 · resolution: 480P
Perché funziona:
- Ogni elemento ha un verbo e una direzione. Il nastro "floats in from the left and spirals around the center bottle"; la nebbiolina "drifts across the background and settles". Indicare il percorso di ogni elemento impedisce che si scontrino in un ammasso di rumore.
- Dai alla camera un compito semplice. Quando i soggetti stanno già eseguendo una coreografia, basta un semplice "orbits slowly clockwise". Far eseguire alla camera un movimento complesso e pilotare tre elementi contemporaneamente è il momento esatto in cui la camera crolla.
- Le parole fisiche ripagano in realismo. "physically accurate reflections on the glass and stage" è esattamente il motivo per cui le boccette riflettono correttamente sul pavimento — i materiali riflettenti devono essere indicati esplicitamente.
no logosè lì per una ragione. Nelle inquadrature di prodotto il modello altrimenti inventa loghi di marca. I negativi sono il modo per mantenere l'immagine pulita e utilizzabile.
Esegui tu stesso
Ogni clip qui sopra è un task asincrono sull'endpoint /v1/tasks di hiapi — invia, interroga, scarica. I campi di input sono esattamente i quattro parametri delle ricette:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3-max/text-to-video",
    "input": {
      "prompt": "Single continuous shot. A lone open red umbrella on wet cobblestones... Ambient sound: soft rain, distant church bells, no speech.",
      "duration": 6,
      "resolution": "480P",
      "aspect_ratio": "16:9"
    }
  }'
La risposta restituisce un taskId; interroga GET /v1/tasks/{taskId} finché status non è success, poi recupera la clip dall'URL di output (è un link a scadenza breve — scaricalo subito).
Il costo cresce in base ai secondi che richiedi, non ai secondi effettivamente restituiti. A ottobre 2026, il text-to-video di MiniMax H3 Max viene fatturato per i secondi video richiesti: $0.072/secondo a 480P, $0.115/secondo a 768P, $0.229/secondo a 1080P. Quindi le tre clip a 480P di qui (6 s + 8 s + 6 s) costano in totale circa $1.44. Itera il prompt a 480P, poi rilancia la versione scelta a 1080P. Per i prezzi in tempo reale vedi la pagina dei prezzi di hiapi.
Hai già il primo fotogramma che vuoi? La stessa sintassi dei prompt vale anche per MiniMax H3 Max image-to-video — passagli un fotogramma fermo e descrivi movimento e suono invece dell'intera scena.
Domande frequenti
MiniMax H3 Max genera l'audio o lo aggiungo io dopo?
Genera l'audio in base al tuo prompt. La riga Ambient sound: di ogni ricetta è esattamente l'origine della pioggia, del brusio del caffè e del fruscio della seta nelle clip qui sopra — nessuna post-produzione necessaria. A meno che tu non voglia esplicitamente un dialogo, scrivi no speech e descrivi l'atmosfera che desideri, invece di lasciarla al caso.
Qual è la durata massima di una clip? Ogni task va da 0.92 a 15 secondi. Per contenuti più lunghi genera più clip e montale insieme — e organizza le battute di ogni clip come nella ricetta 2, così da poterle montare in modo pulito.
Perché la mia clip sembra morbida o slavata? Di solito il problema è il livello di risoluzione, non il prompt. Questi esempi sono a 480P, per un'iterazione economica. Rilancia il prompt finale a 768P o 1080P per la nitidezza da consegna. Aggiungi anche parole su materiali e illuminazione ("physically accurate reflections", "studio rim lighting") — rendono il look più nitido tanto quanto il numero di pixel.
Come evito che aggiunga testo o sottotitoli?
Scrivi no text nei negativi (per i prodotti aggiungi anche no subtitles, no logos). I modelli di text-to-video generano spesso testo sullo schermo dal nulla; elencarli esplicitamente è la soluzione affidabile.
Quale rapporto d'aspetto dovrei usare?
Fallo corrispondere al canale di destinazione: 16:9 o 21:9 per il cinematografico e l'orizzontale, 9:16 o 3:4 per i social e il mobile, 1:1 per le immagini di prodotto e i feed. Sceglilo prima di scrivere il prompt, perché il formato cambia il modo in cui descrivi la composizione.
Inizia a fare il regista
Lo schema dietro le tre ricette è sempre lo stesso: scrivi il punto di inizio e di fine della camera, spendi la durata con battute, dai a ogni elemento in movimento il proprio verbo e scrivi il suono. Prendi in prestito questi prompt, inserisci il tuo soggetto, itera a 480P finché il movimento di camera è corretto.
Quando lo è, rilancia a 1080P e recupera la clip finale dalla pagina del modello text-to-video MiniMax H3 Max — stessi prompt, qualità da consegna.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori