
사용 가이드
MiniMax H3 Max 텍스트 투 비디오 프롬프트: 바로 복사해 붙여넣을 수 있는 실전 레시피와 실제 출력
대부분의 텍스트 투 비디오 프롬프트는 같은 지점에서 실패합니다. 그것들은 한 장의 화면을 묘사할 뿐, 하나의 쇼트를 묘사하지 않습니다. 그 결과 아름답지만 거의 움직이지 않거나, 움직이면 뭉개지는 프레임을 얻게 됩니다. MiniMax H3 Max가 보상하는 것은 정반대의 습관입니다. 바로 감독처럼 프롬프트를 쓰는 것입니다. 카메라가 어디서 시작해 어디서 끝나는지, 이 몇 초를 어떻게 배분할지, 그리고 장면이 어떻게 들리는지를 알려주면, 실제 카메라 워크 논리와 어울리는 사운드트랙으로 그 쇼트를 지탱해 줍니다.
이 가이드는 바로 복사해 붙여넣을 수 있는 세 가지 레시피를 제공하며, 각각 당신이 실제로 필요로 하는 하나의 제어점을 중심으로 합니다. 카메라 움직임, 고정된 길이 안에서의 리듬 배분, 그리고 여러 움직이는 요소의 협응 안무입니다. 아래의 각 클립은 hiapi에서 바로 옆에 인쇄된 원본 프롬프트로 생성되었습니다. 선별도, 사후 정리도 없습니다. 프롬프트를 복사하고 주제만 바꾸면 당신의 작품을 게시할 수 있습니다.
세 샘플은 모두 빠르고 저렴한 반복을 위해 480P로 렌더링되었습니다(가장 저렴한 등급). 납품 품질이 필요할 때는 같은 프롬프트를 그대로 768P와 1080P로 확대할 수 있습니다.
MiniMax H3 Max가 프롬프트를 해석하는 방식
호출에는 prompt 하나와 세 개의 파라미터를 전달하며, prompt 자체는 네 번째 보이지 않는 파라미터, 즉 사운드를 담고 있습니다. 멘탈 모델을 올바르게 세우면 아래 레시피는 더 이상 마법처럼 느껴지지 않습니다.
prompt— 캡션이 아니라 쇼트 묘사입니다. 모델은 카메라 움직임 동사("push in", "crane up", "orbit"), 조명과 분위기 단어, 그리고 생성 오디오를 구동하는 명시적인Ambient sound:한 줄에 반응합니다.duration—0.92에서15초 사이의 숫자입니다. 이것이 당신의 리듬 예산입니다. 초가 많을수록 더 많은 비트를 배치할 수 있고, 초가 적을수록 한 동작에 집중하세요.resolution—480P,768P, 또는1080P. 저렴하게 반복하고, 선명하게 납품하세요.aspect_ratio—21:9,16:9,4:3,1:1,3:4, 또는9:16. 프롬프트를 쓰기 전에 게시 채널에 맞춰 선택하세요(시네마틱, 소셜 세로형, 정사각형 제품 이미지). 화면 비율이 구도를 묘사하는 방식을 바꾸기 때문입니다.
모든 레시피에는 두 가지 중요한 습관이 있습니다. 첫째, 카메라 앵커링: 어디서 시작해 어디서 끝나는지 밝히면 중간의 움직임이 일관되게 유지됩니다. 둘째, 네거티브 항목 나열 — no people, no text, no cuts, no speech — 텍스트 투 비디오 모델은 한 번에 이어지는 쇼트에서 자막과 하드 컷을 만들어내길 좋아하기 때문입니다.
레시피 1 — 카메라 움직임: 푸시인과 크레인 리빌
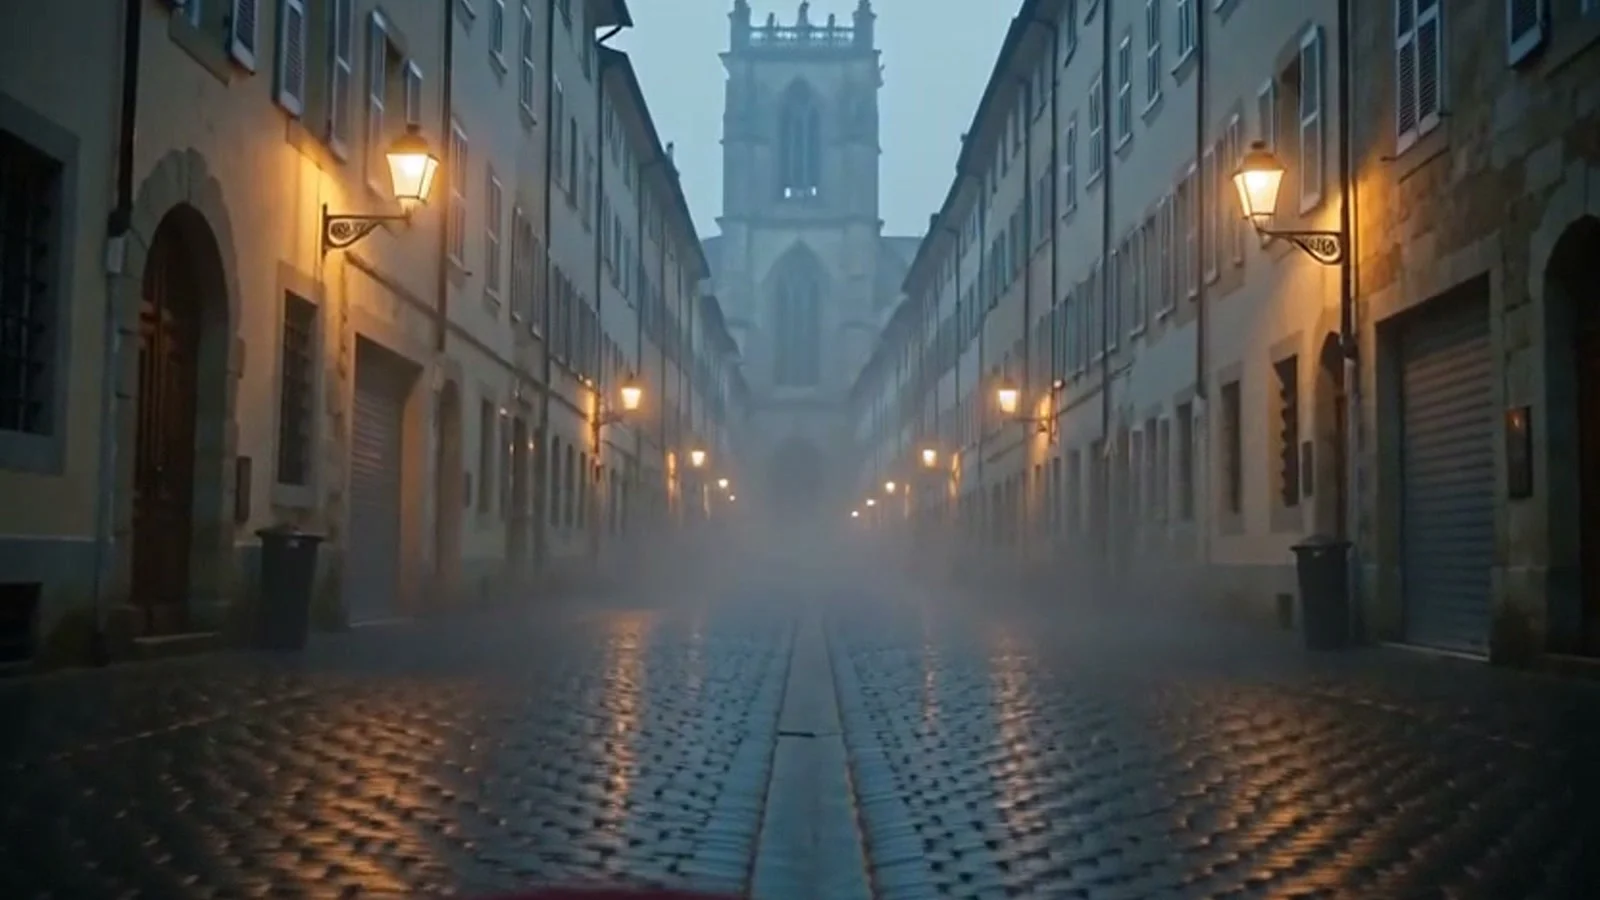
가장 유용한 단일 동작은 근접 쇼트로 시작해 시야를 여는 것입니다. 여기서 카메라는 젖은石板 바닥 위 빨간 우산에서 몇 인치 거리로 시작한 뒤 앞으로 나아가며 위로 크레인 업되어 골목 전체를 드러냅니다. 하나의 주제, 하나의 연속 동작, 끝에는 보상이 있습니다.
Single continuous shot. A lone open red umbrella lies on wet cobblestones
in an empty European alley at dawn, thin fog, puddles mirroring amber
streetlamps. The camera starts low and close on the umbrella, then slowly
pushes forward and cranes upward into a wide reveal of the long alley
stretching toward a misty cathedral. Gentle natural motion: drifting fog,
a few slow raindrops rippling the puddles. Cinematic, shallow depth of
field, warm-cool color contrast, stable geometry, seamless temporal
consistency, no people, no text, no cuts. Ambient sound: soft rain,
distant church bells, faint wind, no speech.
파라미터: aspect_ratio: 16:9 · duration: 6 · resolution: 480P
왜 효과적인가:
- 한 문장, 두 개의 카메라 위치. "starts low and close… then pushes forward and cranes upward into a wide reveal"는 모델에게 시작 프레임과 종료 프레임을 줍니다. 모델은 그 사이를 보간해 그럴듯한 동작을 만들어내며, 목적 없이 배회하지 않습니다.
- 카메라 자체의 움직임이 아닌 것. "drifting fog"와 "raindrops rippling the puddles"는 장면에 생명을 불어넣으면서 카메라 움직임과 경쟁하지 않습니다. 부차적 움직임은 화면이 얼어붙은 것처럼 보이는 것을 막아줍니다.
- 분위기 단어가 실제로 일합니다. "warm-cool color contrast"와 "shallow depth of field"가 룩을 영화적으로 밀어붙입니다. 결과의 호박색과 안개 색 대비는 바로 이 문장에서 나옵니다.
- 치환 테스트: 우산과 골목을 "a vintage motorcycle in a neon-lit garage"로 바꾸고 카메라 문장은 그대로 두세요. 카메라 워크는 깔끔하게 옮겨갑니다.
레시피 2 — 리듬: 타이밍 비트로 고정 길이를 소진하기
몇 초를 넘는 길이가 있을 때는 전체 클립에 대해 정적인 순간 하나를 묘사하지 마세요. 비트를 대본처럼 쓰세요. 프롬프트에 시간 창을 표시해 모델에게 길이를 어떻게 배분할지 알려주세요. 이 8초 세로형 클립은 세 박자의 액체 붓기 시퀀스를 진행합니다.
Vertical social clip, one continuous take, three beats.
Beat 1 (0-3s): a barista's hands pour hot espresso over a glass of ice,
close macro, dark crema swirling.
Beat 2 (3-6s): milk cascades in slow motion, blooming into feathered
clouds through the coffee.
Beat 3 (6-8s): the camera pulls back to reveal the finished iced latte on
a sunlit marble counter beside fresh mint.
Warm morning light, crisp condensation on the glass, smooth natural
motion, high detail, stable focus, no text. Ambient sound: gentle pour,
ice clink, soft cafe hum, no speech.
파라미터: aspect_ratio: 9:16 · duration: 8 · resolution: 480P
왜 효과적인가:
- 비트가 초에 대응합니다. "Beat 1 (0-3s)… Beat 2 (3-6s)… Beat 3 (6-8s)"는 모델에게 길이를 어떻게 배분할지 알려주므로, 동작이 같은 제스처를 반복하지 않고 앞으로 나아갑니다. 비트 창의 합이 요청한
duration과 같아지게 하세요. - 하나의 비트 = 하나의 변화. 각 비트는 새로운 것을 하나만 도입합니다(붓기 → 우유 거품 피어남 → 풀백 리빌). 한 비트에 두 가지 변화를 넣으면 모델은 종종 서두르거나 둘을 뭉개버립니다.
- 리빌은 마지막에 남겨두세요. Beat 3의 풀백이 보상입니다. 더 넓은 화면으로 끝나는 것은 시간이 다해 끝난 클립이 아니라 의도적인 마무리처럼 읽힙니다.
- 세로형은 자르기가 아니라 구도 선택입니다.
9:16을 사용하면 하나의 컵이 중앙을 채우는 세로 화면을 묘사하는 것이지, 가로 화면을 휴대폰 화면에 억지로 밀어 넣는 것이 아닙니다.
레시피 3 — 장면 안무: 여러 요소가 함께 움직이기
가장 어려운 장면은 여러 가지가 동시에 움직이면서 카메라가 흐트러지지 않는 것입니다. 요령은 각 요소에 고유한 동사와 경로를 주고, 카메라에는 단순한 일을 주는 것입니다. 여기서는 리본이 병 주위를 감고, 옅은 안개가 배경으로 흘러가고, 카메라가 천천히 궤도를 돕니다.
Square product shot, single continuous take. On a dark reflective stage,
three frosted glass perfume bottles stand in a row. A ribbon of golden
silk floats in from the left and spirals around the center bottle, while
a soft burst of white mist drifts across the background and settles. The
camera orbits slowly clockwise around the bottles. Studio rim lighting,
deep shadows, physically accurate reflections on the glass and stage,
premium luxury commercial finish, controlled elegant motion, stable
geometry, no people, no logos, no text. Ambient sound: low cinematic hum,
soft whoosh of silk, delicate chime, no speech.
파라미터: aspect_ratio: 1:1 · duration: 6 · resolution: 480P
왜 효과적인가:
- 모든 요소에 동사와 방향이 있습니다. 리본은 "floats in from the left and spirals around the center bottle", 안개는 "drifts across the background and settles". 각 요소에 경로를 지정하면 서로 충돌해 노이즈가 되는 것을 막습니다.
- 카메라에는 단순한 일을 주세요. 주제가 이미 안무 중일 때는 평범한 "orbits slowly clockwise" 한 줄이면 충분합니다. 카메라에 복잡한 동작을 시키면서 동시에 세 요소를 움직이는 것이 바로 카메라가 무너지는 순간입니다.
- 물리 단어가 사실감을 가져옵니다. "physically accurate reflections on the glass and stage"가 병이 바닥에 올바르게 반사되는 이유입니다. 반사 재질은 명시적으로 짚어줘야 합니다.
no logos는 그 말 그대로입니다. 제품 샷에서 모델은 그렇지 않으면 브랜드 로고를 만들어냅니다. 네거티브 항목이 화면을 깨끗하고 쓸 수 있게 유지하는 수단입니다.
직접 실행하기
위의 각 클립은 hiapi의 /v1/tasks 엔드포인트에서 하나의 비동기 작업입니다. 제출하고, 폴링하고, 다운로드하세요. 입력 필드는 정확히 레시피의 네 파라미터입니다.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3-max/text-to-video",
    "input": {
      "prompt": "Single continuous shot. A lone open red umbrella on wet cobblestones... Ambient sound: soft rain, distant church bells, no speech.",
      "duration": 6,
      "resolution": "480P",
      "aspect_ratio": "16:9"
    }
  }'
응답은 taskId를 반환합니다. status가 success가 될 때까지 GET /v1/tasks/{taskId}를 폴링한 다음 출력 URL에서 클립을 가져오세요(단기 유효 링크이므로 즉시 다운로드하세요).
비용은 실제로 반환된 초가 아니라 요청한 초에 따라 증가합니다. 2026년 10월 기준으로 MiniMax H3 Max 텍스트 투 비디오는 요청한 비디오 초 단위로 과금됩니다. 480P는 $0.072/초, 768P는 $0.115/초, 1080P는 $0.229/초입니다. 따라서 여기 세 개의 480P 클립(6초 + 8초 + 6초)은 총 약 $1.44입니다. 먼저 480P에서 프롬프트를 반복하고, 선택한 버전을 1080P로 다시 실행하세요. 실시간 가격은 hiapi 가격 페이지를 참조하세요.
원하는 첫 프레임이 이미 있나요? 동일한 프롬프트 문법이 MiniMax H3 Max 이미지 투 비디오에도 적용됩니다. 정지 프레임 하나를 주고 전체 장면 대신 움직임과 사운드를 묘사하세요.
자주 묻는 질문
MiniMax H3 Max는 사운드를 생성하나요, 아니면 나중에 직접 추가하나요?
프롬프트에 따라 오디오를 생성합니다. 각 레시피의 Ambient sound: 줄이 바로 위 클립의 빗소리, 카페 웅성거림, 비단 스치는 소리의 근원입니다. 후반 작업이 필요 없습니다. 명시적으로 대사를 원하지 않는 한 no speech를 적고, 원하는 분위기를 묘사하세요. 운에 맡기지 마세요.
최대 클립 길이는 얼마인가요? 작업당 길이는 0.92에서 15초입니다. 더 긴 콘텐츠는 여러 클립을 생성해 이어 붙이세요. 그리고 레시피 2처럼 각 클립의 비트를 안무해 깔끔하게 편집되게 하세요.
왜 제 클립은 흐릿하거나 칙칙해 보이나요? 보통은 프롬프트가 아니라 해상도 등급 문제입니다. 이 샘플들은 저렴한 반복을 위한 480P입니다. 최종 프롬프트를 768P나 1080P로 다시 실행해 납품 선명도를 얻으세요. 동시에 재질과 조명 단어("physically accurate reflections", "studio rim lighting")를 추가하세요. 픽셀 수 못지않게 룩을 선명하게 만듭니다.
텍스트나 자막이 추가되는 것을 어떻게 막나요?
네거티브 항목에 no text를 쓰세요(제품류는 no subtitles, no logos도 추가). 텍스트 투 비디오 모델은 화면 텍스트를 자주 만들어냅니다. 명시적으로 나열하는 것이 확실한 해결책입니다.
어떤 화면 비율을 써야 하나요?
게시 채널에 맞추세요. 16:9나 21:9는 시네마틱과 가로형, 9:16이나 3:4는 소셜과 모바일, 1:1은 제품 이미지와 피드용입니다. 프롬프트를 쓰기 전에 선택하세요. 화면 비율이 구도를 묘사하는 방식을 바꾸기 때문입니다.
감독이 되어 시작하세요
세 레시피의 패턴은 모두 같습니다. 카메라의 시작과 끝을 명시하고, 비트로 길이를 소진하며, 각 움직이는 요소에 고유한 동사를 주고, 사운드를 쓰세요. 이 프롬프트들을 가져다 주제를 바꿔 넣고 480P에서 카메라 워크가 올바를 때까지 반복하세요.
올바르게 되면 1080P로 다시 실행하고 MiniMax H3 Max 텍스트 투 비디오 모델 페이지에서 최종 클립을 가져오세요. 같은 프롬프트, 납품 품질.
관련 글
모든 아티클 보기 →-

사용 가이드
seedream-5.0-pro/image-to-image 시작 가이드: 기능, 가격 및 연동 핵심 포인트
ByteDance 이미지 편집 모델의 기능 경계, 과금 방식 및 엔지니어링 연동 실무
-

사용 가이드
seedream-5.0-pro 텍스트-이미지 생성 입문 가이드: 능력 경계, API 연동 및 비용 관리
개발자를 위한 실무 관점: 파라미터 핵심부터 장당 $0.05 비용 추정까지
-

사용 가이드
Hailuo 2.3 Fast 이미지-투-비디오 입문 가이드: 성능 범위, 가격 및 연동 실무
개발자를 위한 MiniMax 이미지-투-비디오 모델 선택과 연동 핵심 포인트