
Руководство по использованию
Qwen-Audio 3.0 TTS Flash для электронной коммерции: голосовые роботы и уведомления о заказах в реальном времени
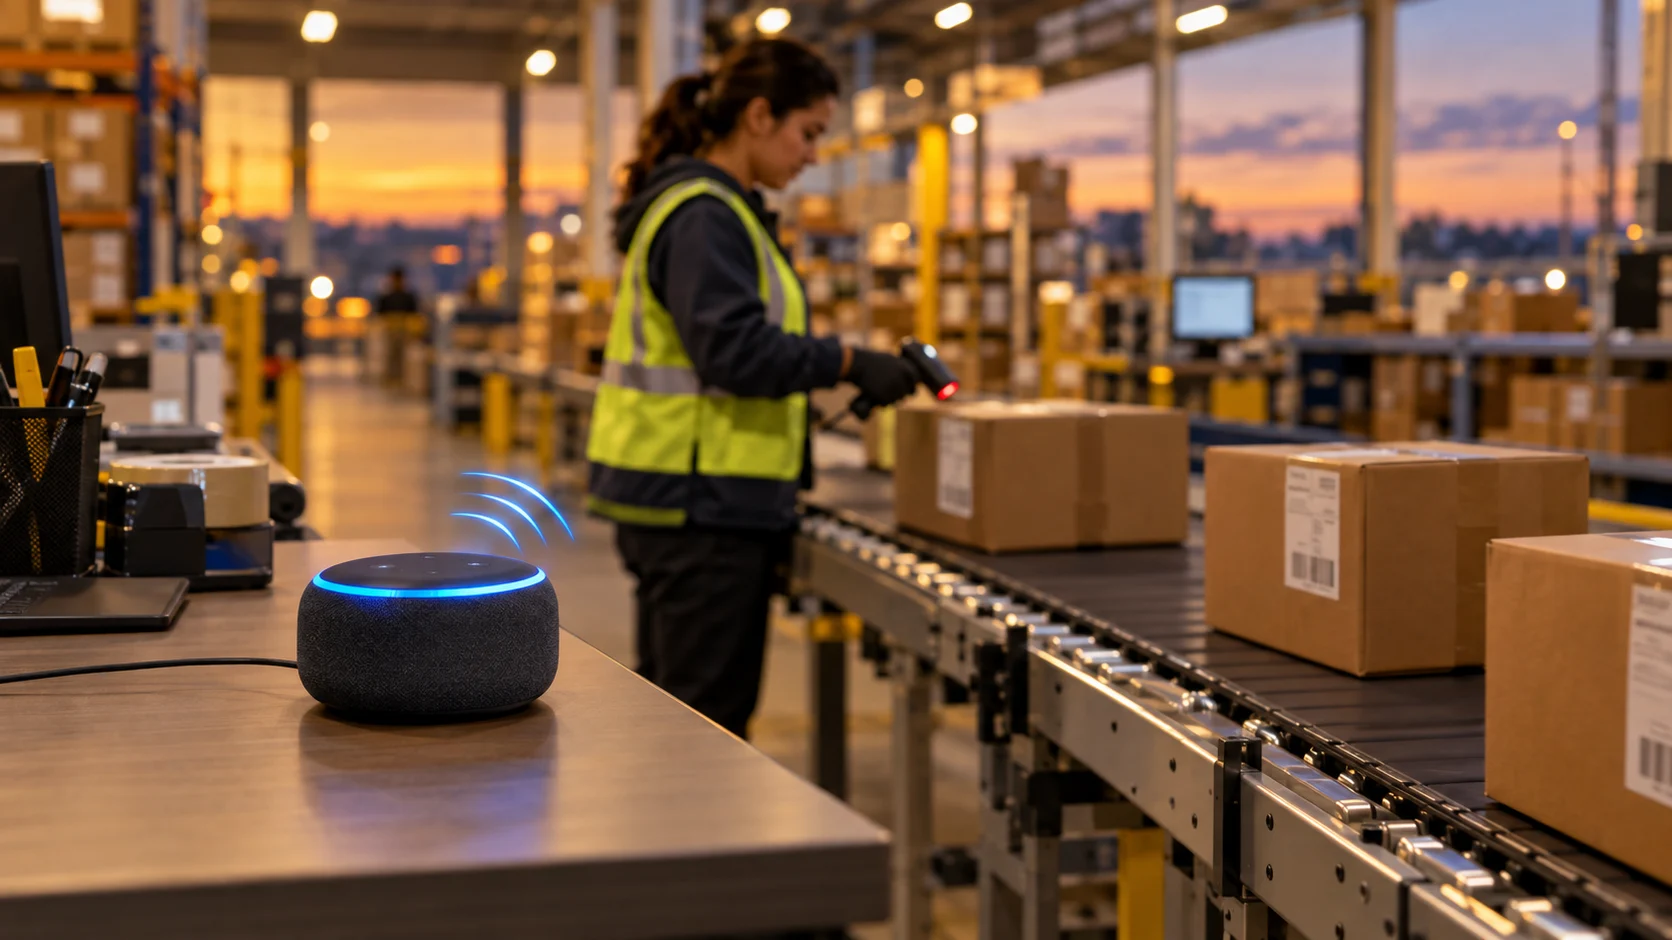
qwen-audio-3.0-tts-flash — это модель преобразования текста в речь с низкой задержкой, предоставляемая Alibaba на hiapi; её скоростные характеристики особенно хорошо подходят для двух типов задач электронной коммерции: ответов на вопросы покупателей в голосовом помощнике без неловких пауз и озвучивания обновлений в момент изменения статуса заказа или остатков на складе. Обе задачи не требуют громоздкой модели — им нужна быстрая и естественно звучащая речь.
Почему низкая задержка здесь важна
Сбои голосовых интерфейсов в электронной коммерции обычно вызваны задержкой, а не качеством звука. Робот поддержки, которому требуется три секунды, чтобы начать говорить, даже с правильным ответом кажется сломанным. Система объявлений на складе или в магазине, отстающая от описываемого события ("Заказ #4821 готов" звучит с опозданием на минуту), полностью теряет смысл. qwen-audio-3.0-tts-flash создан именно для таких задач: короткие, частые реплики, которые нужно озвучить в момент готовности текста, а не аудио, массово рендеримое для подкастов или аудиокниг.
Сценарий 1: голосовой робот поддержки
Голосовой робот поддержки обычно генерирует по несколько коротких фраз за ход — статус заказа, политика возврата, оценка доставки — и каждую фразу нужно произнести с минимальной задержкой, чтобы сохранить ощущение живого разговора. Поскольку qwen-audio-3.0-tts-flash принимает только text и voice на входе, он легко встраивается в существующий диалоговый конвейер: ваша LLM или движок правил генерирует текст ответа, а модель на следующем шаге преобразует его в аудио.
curl -X POST https://api.hiapi.ai/v1/tasks   -H "Authorization: Bearer sk-<your-api-key>"   -H "Content-Type: application/json"   -d '{
    "model": "qwen-audio-3.0-tts-flash",
    "input": {
      "text": "Your order shipped this morning and should arrive by Thursday.",
      "voice": "longanhuan_v3.6"
    }
  }'
В ответ возвращается taskId; путём опроса (или через callback) вы получаете output[0].url, указывающий на отрендеренное аудио — та же схема /v1/tasks, которую используют все модели hiapi. Полный цикл запроса/ответа на curl и Python описан в руководстве по API qwen-audio-3.0-tts-flash.
Сценарий 2: оповещения о заказах и остатках в реальном времени
Второй случай менее диалоговый и более трансляционный: производственный центр объявляет через динамики в цехе "Упаковочная станция 3, заказ готов", киоск в магазине сообщает "Товар снова в наличии", или касса громко подтверждает отсканированный товар. Это короткие шаблонные фразы, запускаемые событиями (webhook, изменение строки в базе данных, сканирование штрихкода), и критерий тот же — синтезировать и воспроизвести до того, как момент упущен.
Поскольку оплата взимается за символы, а не за запросы, генерация таких коротких шаблонных фраз по требованию обходится дёшево, и предварительно записывать каждый возможный вариант не нужно. Практичный подход — поддерживать небольшой набор шаблонов фраз, подставлять переменные во время выполнения (номер заказа, название товара, ячейка) и каждый раз заново вызывать модель:
import requests

def announce(text: str, api_key: str) -> str:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "model": "qwen-audio-3.0-tts-flash",
            "input": {"text": text, "voice": "loongeva_v3.6"},
        },
    )
    return resp.json()["data"]["taskId"]
Выбор голоса
voice принимает четыре фиксированных значения: longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 и loongjohn. Для объявлений, обращённых к клиентам, стоит сгенерировать небольшой образец для каждого голоса и выбрать тот, что соответствует тональности вашего бренда, прежде чем подключать его к производственной среде — параметров speed или pitch для настройки после этого нет, поэтому выбор голоса — главный рычаг, определяющий звучание объявления.
Цены
Стоимость составляет $0.03 за каждые 1 000 входных символов текста (по состоянию на 2026-09) — достаточно дёшево, чтобы объявления по событиям и ответы робота по ходам оставались доступными без пакетной обработки. Перед оценкой объёма использования уточните текущий тариф на странице цен hiapi, поскольку тарифы могут меняться.
Часто задаваемые вопросы
Сможет ли qwen-audio-3.0-tts-flash обрабатывать живой диалог поддержки ход за ходом? Да — он разработан для коротких, частых вызовов синтеза речи, а не для длинного повествования, что соответствует сценарию с многоходовыми ответами робота по одной фразе.
Достаточно ли он быстр для объявлений в цехе или магазине в реальном времени? Для коротких шаблонных фраз (номер заказа, название товара, слово статуса) синтез достаточно быстр, и объявление воспроизводится вскоре после triggering-события. Тестируйте на реальной длине ваших фраз, поскольку задержка растёт с длиной текста.
Нужно ли предварительно записывать фразы объявлений вместо генерации в реальном времени? Нет — благодаря оплате за символы и низкой задержке модели генерация коротких фраз по требованию обычно проще и дешевле, чем поддержание библиотеки предварительно записанных фраз.
Какой голос использовать для помощника покупателя, а какой — для складских объявлений?
Функциональных различий между четырьмя голосами нет, кроме тона — longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 и loongjohn. Сгенерируйте образцы для каждого голоса на реальном тексте ваших объявлений и выбирайте на слух.
В каком формате я получаю аудио?
pcm, wav, mp3 или opus, задаётся через input.format; если не указать, используется значение по умолчанию модели.
Готовы подключить голосовую связь в реальном времени к вашему магазину или процессу поддержки? Ознакомьтесь со страницей модели Qwen-Audio 3.0 TTS Flash, чтобы узнать полные спецификации, или начните с пошагового руководства по API, если хотите сначала получить рабочий запрос, прежде чем строить решение вокруг процессов электронной коммерции.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков