
Guia de uso
Qwen-Audio 3.0 TTS Flash para e-commerce: robôs de voz e alertas de pedidos em tempo real
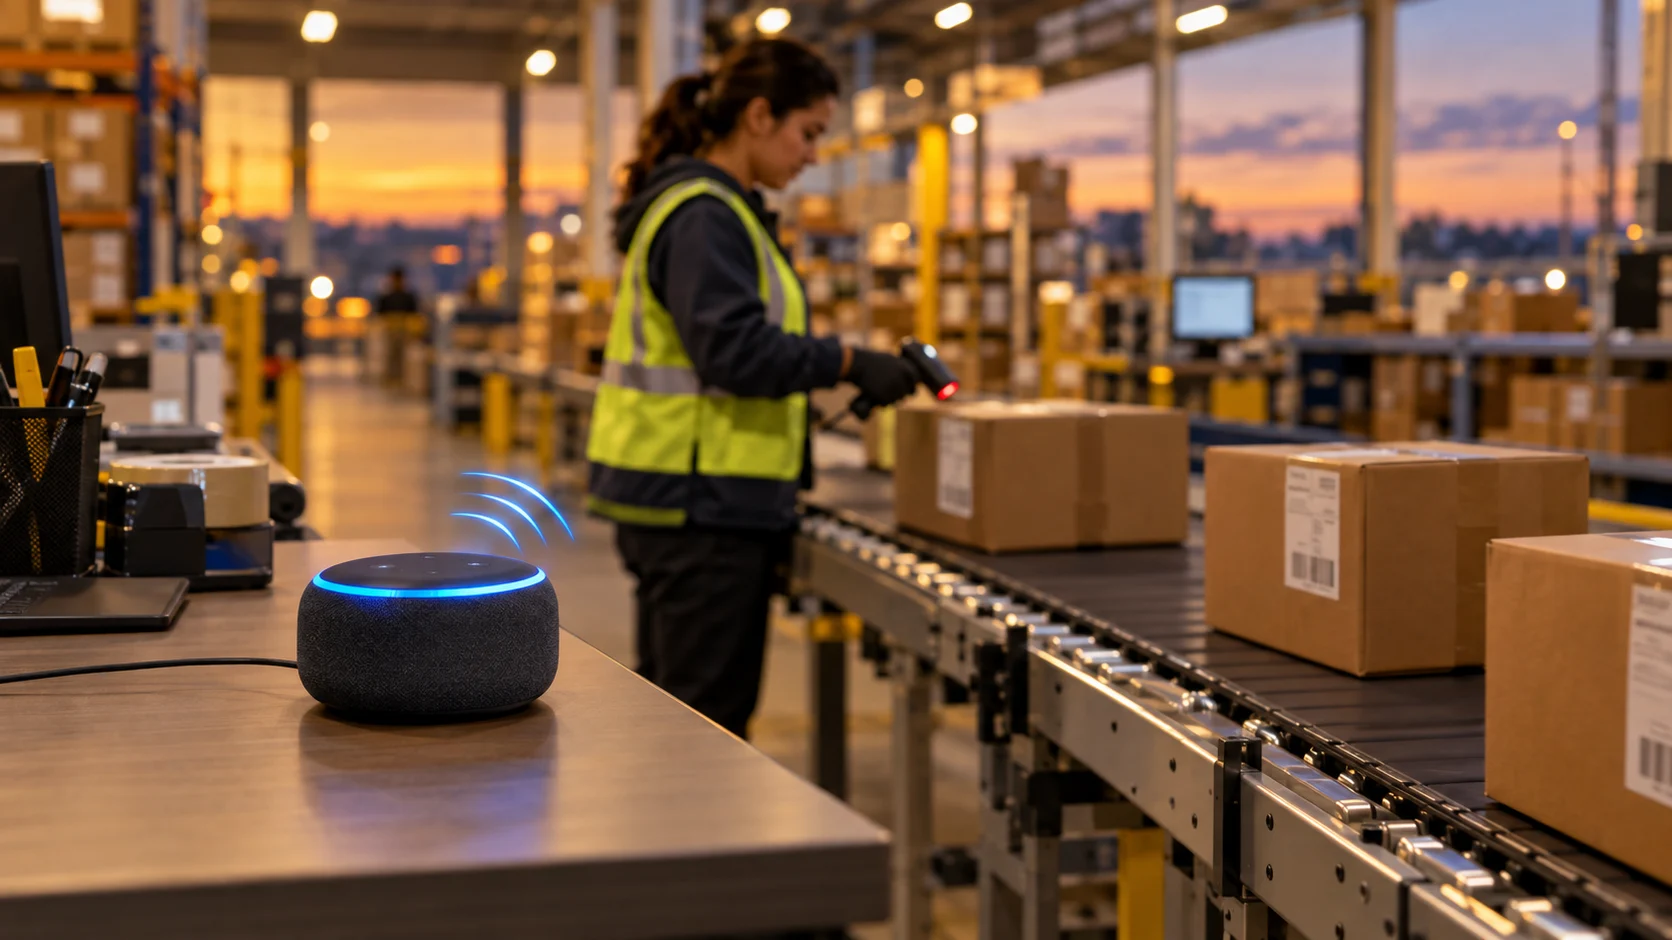
O qwen-audio-3.0-tts-flash é um modelo de conversão de texto em fala de baixa latência oferecido pela Alibaba no hiapi, cujas características de velocidade se adequam especialmente a duas tarefas de e-commerce: responder às perguntas dos compradores em um assistente de voz sem pausas constrangedoras e ler atualizações de pedidos ou estoque no exato momento em que ocorrem. Nenhuma dessas tarefas exige um modelo gigantesco — elas precisam de uma voz que inicie rapidamente e soe natural.
Por que a baixa latência importa aqui
As falhas das interfaces de voz no e-commerce costumam vir da latência, não da qualidade do áudio. Um robô de atendimento que leva três segundos para começar a falar parece quebrado, mesmo que a resposta esteja correta. Um sistema de anúncio em armazém ou loja que fica atrás do evento que descreve ("Pedido #4821 pronto", anunciado um minuto depois) perde completamente sua função. O qwen-audio-3.0-tts-flash foi construído justamente para esse tipo de problema: falas curtas e frequentes que precisam ser emitidas no momento em que o texto fica pronto, e não áudios renderizados em lote para podcasts ou audiolivros.
Cenário 1: robô de atendimento por voz
Robôs de suporte com voz normalmente geram algumas frases curtas por turno — status do pedido, política de devolução, previsão de entrega — e precisam falar cada frase com latência mínima para manter a sensação de conversa em tempo real. Como o qwen-audio-3.0-tts-flash só precisa de text e voice como entrada, ele se integra facilmente ao pipeline de diálogo existente: seu LLM ou mecanismo de regras gera o texto da resposta, e o modelo o converte em áudio no salto seguinte.
curl -X POST https://api.hiapi.ai/v1/tasks   -H "Authorization: Bearer sk-<your-api-key>"   -H "Content-Type: application/json"   -d '{
    "model": "qwen-audio-3.0-tts-flash",
    "input": {
      "text": "Your order shipped this morning and should arrive by Thursday.",
      "voice": "longanhuan_v3.6"
    }
  }'
A resposta é um taskId, e você obtém (por polling ou por callback) o output[0].url que aponta para o áudio renderizado — o mesmo padrão /v1/tasks usado pelos modelos do hiapi. Para o fluxo completo de requisição/resposta em curl e Python, consulte o tutorial da API do qwen-audio-3.0-tts-flash.
Cenário 2: anúncios de pedidos e estoque em tempo real
O segundo caso de uso é menos conversacional e mais voltado à locução: um centro de distribuição anuncia pelos alto-falantes do galpão "Estação de embalagem 3, pedido pronto", um totem de autoatendimento na loja avisa "produto reposto", ou o caixa confirma em voz alta o item escaneado. São frases curtas e padronizadas, disparadas por eventos (webhook, alteração de linha no banco de dados, leitura de código de barras), e o critério é o mesmo — concluir a síntese e a reprodução antes que o momento passe.
Como a cobrança é por caractere e não por requisição, esse tipo de frase curta e padronizada custa pouco para gerar sob demanda, sem precisar pré-gravar cada variante possível. Um padrão prático é manter um pequeno conjunto de modelos de frase, preencher as variáveis em tempo de execução (número do pedido, nome do produto, corredor) e chamar o modelo novamente a cada vez:
import requests

def announce(text: str, api_key: str) -> str:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "model": "qwen-audio-3.0-tts-flash",
            "input": {"text": text, "voice": "loongeva_v3.6"},
        },
    )
    return resp.json()["data"]["taskId"]
Escolha da voz
voice aceita quatro valores fixos: longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 e loongjohn. Para anúncios voltados ao cliente, vale gerar uma pequena amostra com cada voz e escolher a que combina com o tom da sua marca antes de integrar em produção — depois não há parâmetros speed ou pitch para ajustar, então a escolha da voz é a principal alavanca que define como o anúncio soa.
Preço
A cobrança é de $0,03 por 1.000 caracteres de texto de entrada (em 2026-09) — barato o suficiente para que anúncios por evento e respostas de robô por turno se mantenham acessíveis sem processamento em lote. Antes de estimar o uso, confirme a tarifa atual na página de preços do hiapi, pois as tarifas podem mudar.
Perguntas frequentes
O qwen-audio-3.0-tts-flash consegue lidar com conversas de atendimento em tempo real turno a turno? Sim — ele foi projetado para chamadas de conversão de texto em fala curtas e frequentes, e não para narrações longas, o que combina com o cenário de respostas frase a frase de um robô multiturno.
Ele é rápido o suficiente para anúncios em tempo real no galpão ou na loja? Para frases curtas e padronizadas (número do pedido, nome do produto, palavra de status), a velocidade de síntese é suficiente para que o anúncio seja reproduzido logo após o evento disparador. Teste com o comprimento real das suas frases, pois a latência aumenta com o comprimento do texto.
Preciso pré-gravar as frases de anúncio em vez de gerá-las em tempo real? Não — como a cobrança é por caractere e o modelo tem baixa latência, gerar frases curtas sob demanda costuma ser mais simples e mais barato do que manter uma biblioteca de frases pré-gravadas.
Qual voz devo usar para o assistente de compras e qual para os anúncios de armazém?
Não há diferença funcional entre as quatro vozes além do timbre — longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 e loongjohn. Gere amostras com cada voz usando o texto real dos seus anúncios e escolha de ouvido.
Qual é o formato do áudio que recebo?
pcm, wav, mp3 ou opus, definido via input.format; se omitido, usa o padrão do modelo.
Pronto para levar voz em tempo real para sua loja ou fluxo de suporte? Consulte a página do modelo Qwen-Audio 3.0 TTS Flash para ver as especificações completas, ou comece pelo tutorial passo a passo da API se quiser primeiro ter uma requisição funcionando antes de montar tudo em torno dos seus fluxos de e-commerce.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores