
Guía de uso
Qwen-Audio 3.0 TTS Flash para comercio electrónico: robots de voz y recordatorios de pedidos en tiempo real
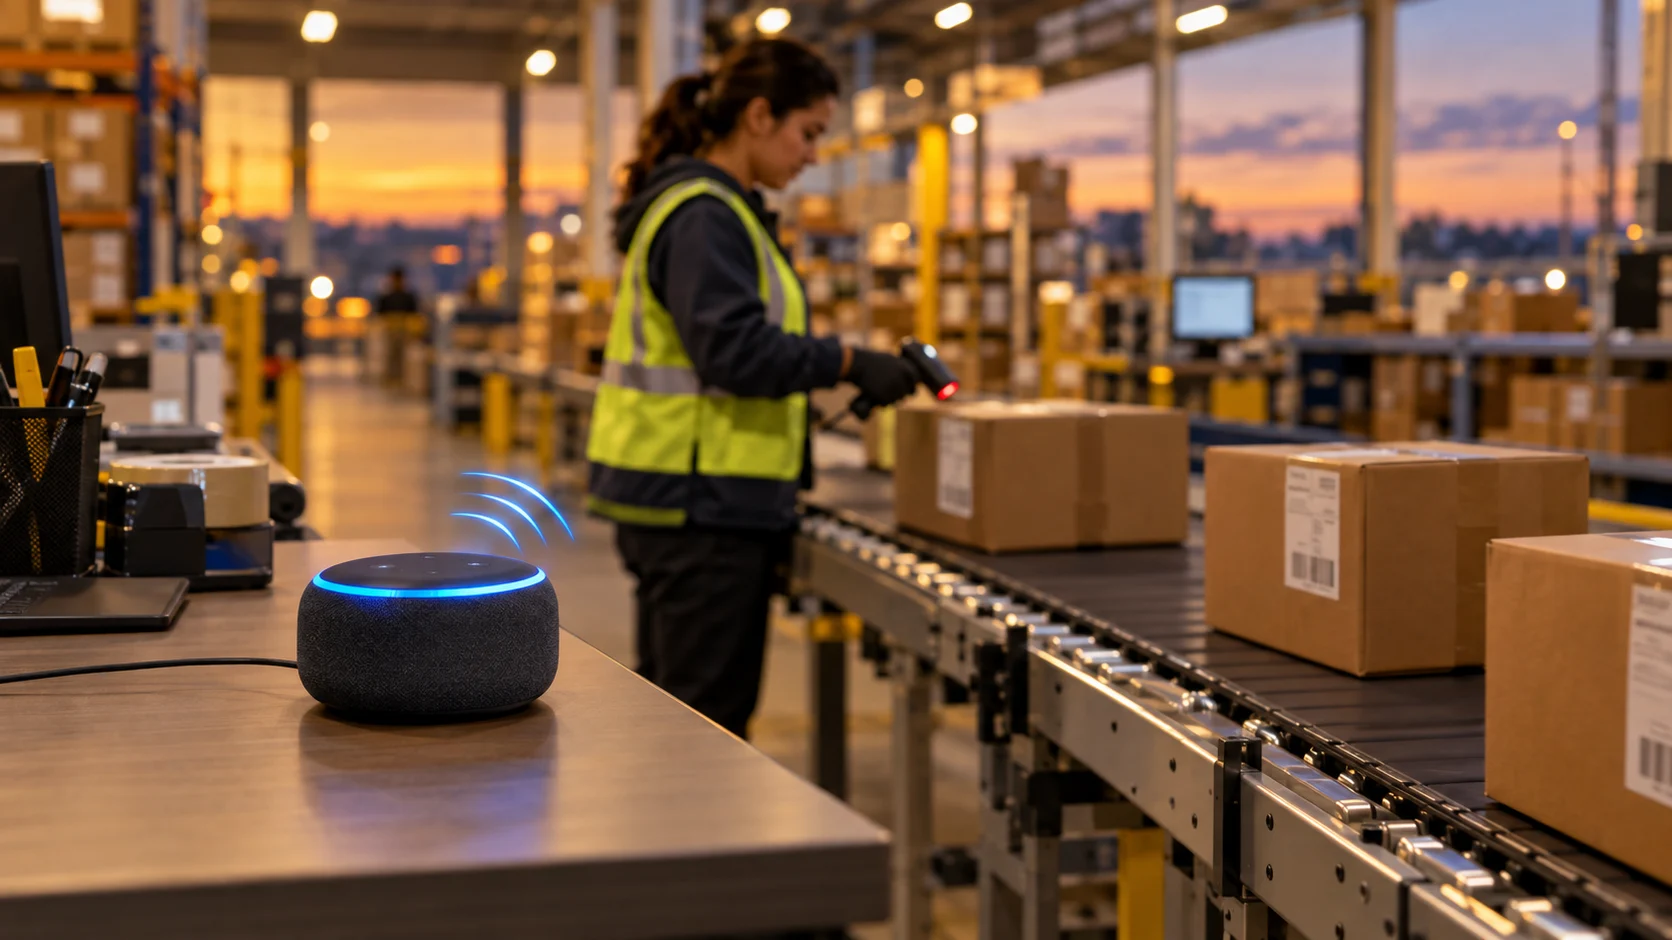
qwen-audio-3.0-tts-flash es un modelo de texto a voz de baja latencia ofrecido por Alibaba en hiapi, cuyas características de velocidad lo hacen especialmente adecuado para dos tareas de comercio electrónico: responder a las preguntas de los compradores en un asistente de voz sin pausas incómodas, y leer las actualizaciones de pedidos o inventario en el momento en que se producen. Ninguna de estas dos tareas requiere un modelo enorme; lo que necesitan es una voz que arranque rápido y suene natural.
Por qué la baja latencia importa aquí
Los fallos de las interfaces de voz en el comercio electrónico suelen deberse a la latencia, no a la calidad del sonido. Un robot de atención al cliente que tarda tres segundos en empezar a hablar, aunque su respuesta sea correcta, hace que el usuario piense que está averiado. Un sistema de megafonía de almacén o de tienda que va por detrás del evento que describe (el aviso «pedido #4821 listo» se emite un minuto tarde) pierde por completo su utilidad. qwen-audio-3.0-tts-flash está construido precisamente para este tipo de problemas: enunciados breves y frecuentes que deben emitirse en el momento en que el texto está listo, no audio renderizado por lotes para pódcasts o audiolibros.
Escenario 1: robot de voz para atención al cliente
Un robot de atención al cliente con soporte de voz suele generar unas pocas frases cortas por turno —estado del pedido, política de devoluciones, estimación de entrega— y necesita pronunciar cada una con la mínima latencia para mantener la sensación de conversación en tiempo real. Como qwen-audio-3.0-tts-flash solo requiere text y voice como entrada, es fácil integrarlo en un flujo de conversación existente: tu LLM o motor de reglas genera el texto de la respuesta y el modelo lo convierte en audio en el siguiente salto.
curl -X POST https://api.hiapi.ai/v1/tasks   -H "Authorization: Bearer sk-<your-api-key>"   -H "Content-Type: application/json"   -d '{
    "model": "qwen-audio-3.0-tts-flash",
    "input": {
      "text": "Your order shipped this morning and should arrive by Thursday.",
      "voice": "longanhuan_v3.6"
    }
  }'
La respuesta es un taskId; mediante sondeo (o recibiendo una devolución de llamada) obtienes output[0].url, que apunta al audio renderizado. Es el mismo patrón de /v1/tasks que usan los distintos modelos de hiapi. Para ver el flujo completo de petición/respuesta con curl y Python, consulta el tutorial de la API de qwen-audio-3.0-tts-flash.
Escenario 2: anuncios de pedidos e inventario en tiempo real
El segundo caso de uso es menos conversacional y más de difusión: un centro logístico anuncia por los altavoces de la nave «estación de empaquetado 3, pedido listo», un terminal de autoservicio de la tienda avisa de que «el artículo vuelve a estar disponible» o una caja confirma en voz alta el producto escaneado. Son frases breves y plantilladas que se activan por eventos (webhooks, cambios en filas de base de datos, escaneos de códigos de barras), y el criterio es el mismo: terminar la síntesis y reproducirla antes de que pase el momento oportuno.
Como la facturación se calcula por caracteres y no por petición, generar este tipo de frases breves y plantilladas bajo demanda resulta económico, sin necesidad de grabar por adelantado todas las variantes posibles. Un patrón práctico consiste en mantener un pequeño conjunto de plantillas de frases, rellenar las variables en tiempo de ejecución (número de pedido, nombre del artículo, canal de la estantería) y volver a llamar al modelo cada vez:
import requests

def announce(text: str, api_key: str) -> str:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "model": "qwen-audio-3.0-tts-flash",
            "input": {"text": text, "voice": "loongeva_v3.6"},
        },
    )
    return resp.json()["data"]["taskId"]
Elección de la voz
voice acepta cuatro valores fijos: longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 y loongjohn. Para los anuncios dirigidos al cliente, merece la pena generar una pequeña muestra con cada voz y elegir la que encaje con el tono de tu marca antes de integrarla en producción; después no hay parámetros de speed ni de pitch que ajustar, por lo que la elección de la voz es la principal palanca que determina cómo suena el anuncio.
Precios
La facturación es de 0,03 USD por cada 1.000 caracteres de texto de entrada (a fecha de 2026-09), lo bastante económica como para que los anuncios activados por eventos y las respuestas del robot por turnos sigan siendo asequibles sin necesidad de procesarlos por lotes. Antes de estimar tu consumo, confirma la tarifa vigente en la página de precios de hiapi, ya que las tarifas pueden cambiar.
Preguntas frecuentes
¿Puede qwen-audio-3.0-tts-flash gestionar conversaciones de atención al cliente en tiempo real turno a turno? Sí, está diseñado para llamadas de texto a voz breves y frecuentes, no para narraciones largas, lo que encaja con el escenario de respuestas frase a frase de un robot multiturno.
¿Es lo bastante rápido para anuncios en tiempo real en naves o tiendas? Para frases breves y plantilladas (número de pedido, nombre del artículo, palabras de estado), la velocidad de síntesis es suficiente para que el anuncio se reproduzca poco después del evento que lo activa. Prueba con la longitud real de tus frases, ya que la latencia aumenta con la longitud del texto.
¿Necesito grabar previamente las frases de los anuncios en lugar de generarlas en tiempo real? No; como la facturación es por caracteres y el modelo tiene baja latencia, generar frases breves bajo demanda suele ser más sencillo y más económico que mantener una biblioteca de frases pregrabadas.
¿Qué voz debería usar para el asistente de compras y cuál para los anuncios de almacén?
Las cuatro voces no presentan diferencias funcionales entre sí, solo de tono: longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 y loongjohn. Genera una muestra con cada voz usando el texto real de tus anuncios y elige de oído.
¿En qué formato recibo el audio?
pcm, wav, mp3 u opus, configurable mediante input.format; si se omite, se usa el valor predeterminado del modelo.
¿Listo para integrar voz en tiempo real en tu tienda o en tu flujo de soporte? Consulta la página del modelo Qwen-Audio 3.0 TTS Flash para ver las especificaciones completas, o empieza por el tutorial paso a paso de la API si prefieres tener primero una petición funcional antes de construir en torno a tus flujos de comercio electrónico.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores