
Guida all'uso
Qwen-Audio 3.0 TTS Flash per l'e-commerce: chatbot vocali e avvisi ordine in tempo reale
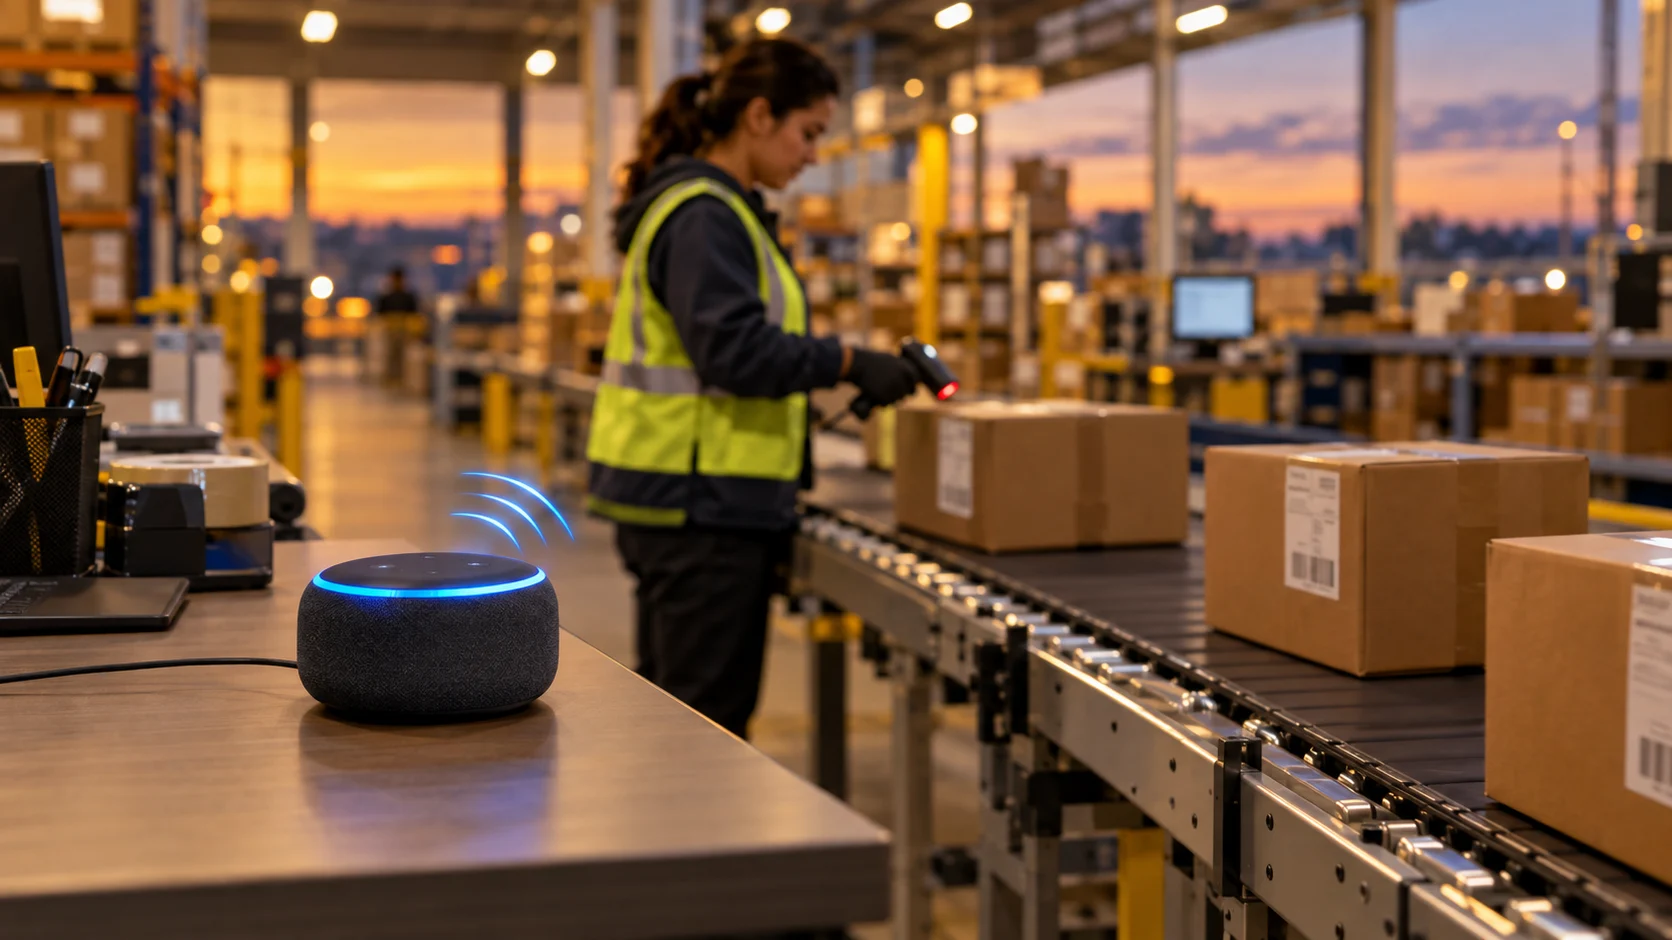
qwen-audio-3.0-tts-flash è il modello text-to-speech a bassa latenza offerto da Alibaba su hiapi; le sue caratteristiche di velocità lo rendono particolarmente adatto a due tipi di attività e-commerce: rispondere alle domande degli acquirenti in un assistente vocale senza pause imbarazzanti, e annunciare gli aggiornamenti di ordini o scorte nel momento stesso in cui avvengono. Nessuno di questi due compiti richiede un modello enorme — richiedono una voce che parta in fretta e suoni naturale.
Perché la bassa latenza è importante qui
I fallimenti delle interfacce vocali nell'e-commerce derivano spesso dalla latenza, non dalla qualità audio. Un chatbot che impiega tre secondi prima di iniziare a parlare sembra rotto anche se la risposta è corretta. Un sistema di annunci in magazzino o in negozio che arriva in ritardo rispetto all'evento che descrive ("Ordine #4821 pronto" annunciato un minuto dopo) perde completamente la sua funzione. qwen-audio-3.0-tts-flash è costruito proprio per questo tipo di problema: brevi enunciati frequenti che devono essere emessi nel momento in cui il testo è pronto, non audio renderizzato in batch per podcast o audiolibri.
Scenario 1: chatbot vocali per l'assistenza clienti
I bot vocali di supporto generano in genere poche frasi brevi per turno — stato dell'ordine, politica di reso, stima di consegna — e devono pronunciare ogni frase con la minima latenza per mantenere la sensazione di conversazione in tempo reale. Poiché qwen-audio-3.0-tts-flash richiede solo text e voice come input, è facile da integrare in una pipeline conversazionale esistente: il tuo LLM o motore di regole genera il testo della risposta, e il modello lo converte in audio al passaggio successivo.
curl -X POST https://api.hiapi.ai/v1/tasks   -H "Authorization: Bearer sk-<your-api-key>"   -H "Content-Type: application/json"   -d '{
    "model": "qwen-audio-3.0-tts-flash",
    "input": {
      "text": "Your order shipped this morning and should arrive by Thursday.",
      "voice": "longanhuan_v3.6"
    }
  }'
La risposta è un taskId; tramite polling (o ricezione via callback) ottieni l'output[0].url che punta all'audio renderizzato — lo stesso schema /v1/tasks usato dagli altri modelli hiapi. Per il flusso completo di richiesta/risposta con curl e Python, consulta il tutorial API di qwen-audio-3.0-tts-flash.
Scenario 2: annunci in tempo reale di ordini e scorte
Il secondo caso d'uso è meno conversazionale e più assimilabile a una trasmissione: un centro di evasione ordini annuncia dagli altoparlanti del reparto "Stazione 3, ordine pronto", un chiosco in negozio annuncia "Articolo rifornito", oppure una cassa conferma a voce alta l'articolo scansionato. Si tratta di brevi frasi template innescate da eventi (webhook, modifiche a righe di database, scansione di codici a barre); il requisito è lo stesso — completare la sintesi e riprodurre l'audio prima che il momento passi.
Poiché la fatturazione avviene per carattere e non per richiesta, frasi brevi e template come queste sono economiche da generare on-demand, senza dover preregistrare ogni possibile variante. Un pattern pratico consiste nel mantenere un piccolo insieme di template di frase, riempire le variabili a runtime (numero d'ordine, nome articolo, corsia) e richiamare il modello ogni volta:
import requests

def announce(text: str, api_key: str) -> str:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "model": "qwen-audio-3.0-tts-flash",
            "input": {"text": text, "voice": "loongeva_v3.6"},
        },
    )
    return resp.json()["data"]["taskId"]
Scegliere la voce
voice accetta quattro valori fissi: longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 e loongjohn. Per gli annunci rivolti ai clienti vale la pena generare un piccolo campione per ogni voce e scegliere quella che si adatta al tono del tuo brand prima di integrare in produzione — non ci sono parametri speed o pitch regolabili successivamente, quindi la scelta della voce è la leva principale che determina come suona l'annuncio.
Prezzi
La fatturazione è di $0.03 per 1.000 caratteri di testo in input (dati a 2026-09) — abbastanza economico da rendere gli annunci per evento e le risposte del bot per turno convenienti senza elaborazione batch. Prima di stimare l'utilizzo, verifica la tariffa attuale nella pagina dei prezzi di hiapi, poiché le tariffe possono variare.
Domande frequenti
qwen-audio-3.0-tts-flash può gestire una conversazione di assistenza in tempo reale turno per turno? Sì — è progettato per chiamate text-to-speech brevi e frequenti, non per narrazioni lunghe, il che si adatta allo scenario di un bot multi-turno che risponde frase per frase.
È abbastanza veloce per annunci in tempo reale in reparto o in negozio? Per frasi brevi e template (numero d'ordine, nome articolo, parole di stato), la sintesi è abbastanza rapida e l'annuncio viene riprodotto poco dopo l'evento scatenante. Testa con le lunghezze reali delle tue frasi, perché la latenza aumenta con la lunghezza del testo.
Devo preregistrare le frasi di annuncio invece di generarle in tempo reale? No — grazie alla fatturazione per carattere e alla bassa latenza del modello, generare brevi frasi on-demand è di solito più semplice ed economico che mantenere una libreria di frasi preregistrate.
Quale voce usare per l'assistente agli acquisti e quale per gli annunci in magazzino?
Non ci sono differenze funzionali tra le quattro voci oltre al timbro — longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 e loongjohn. Genera un campione con ogni voce usando i testi reali dei tuoi annunci, poi scegli ad orecchio.
In che formato ricevo l'audio?
pcm, wav, mp3 oppure opus, impostato tramite input.format; se omesso, viene usato il valore predefinito del modello.
Pronto a integrare la voce in tempo reale nel tuo negozio o nel flusso di assistenza? Consulta la pagina del modello Qwen-Audio 3.0 TTS Flash per le specifiche complete, oppure, se preferisci avere prima una richiesta funzionante prima di costruire attorno ai flussi e-commerce, inizia daltutorial API passo passo.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori