
使用指南
Qwen-Audio 3.0 TTS Flash 用于电商:语音机器人与实时订单提醒
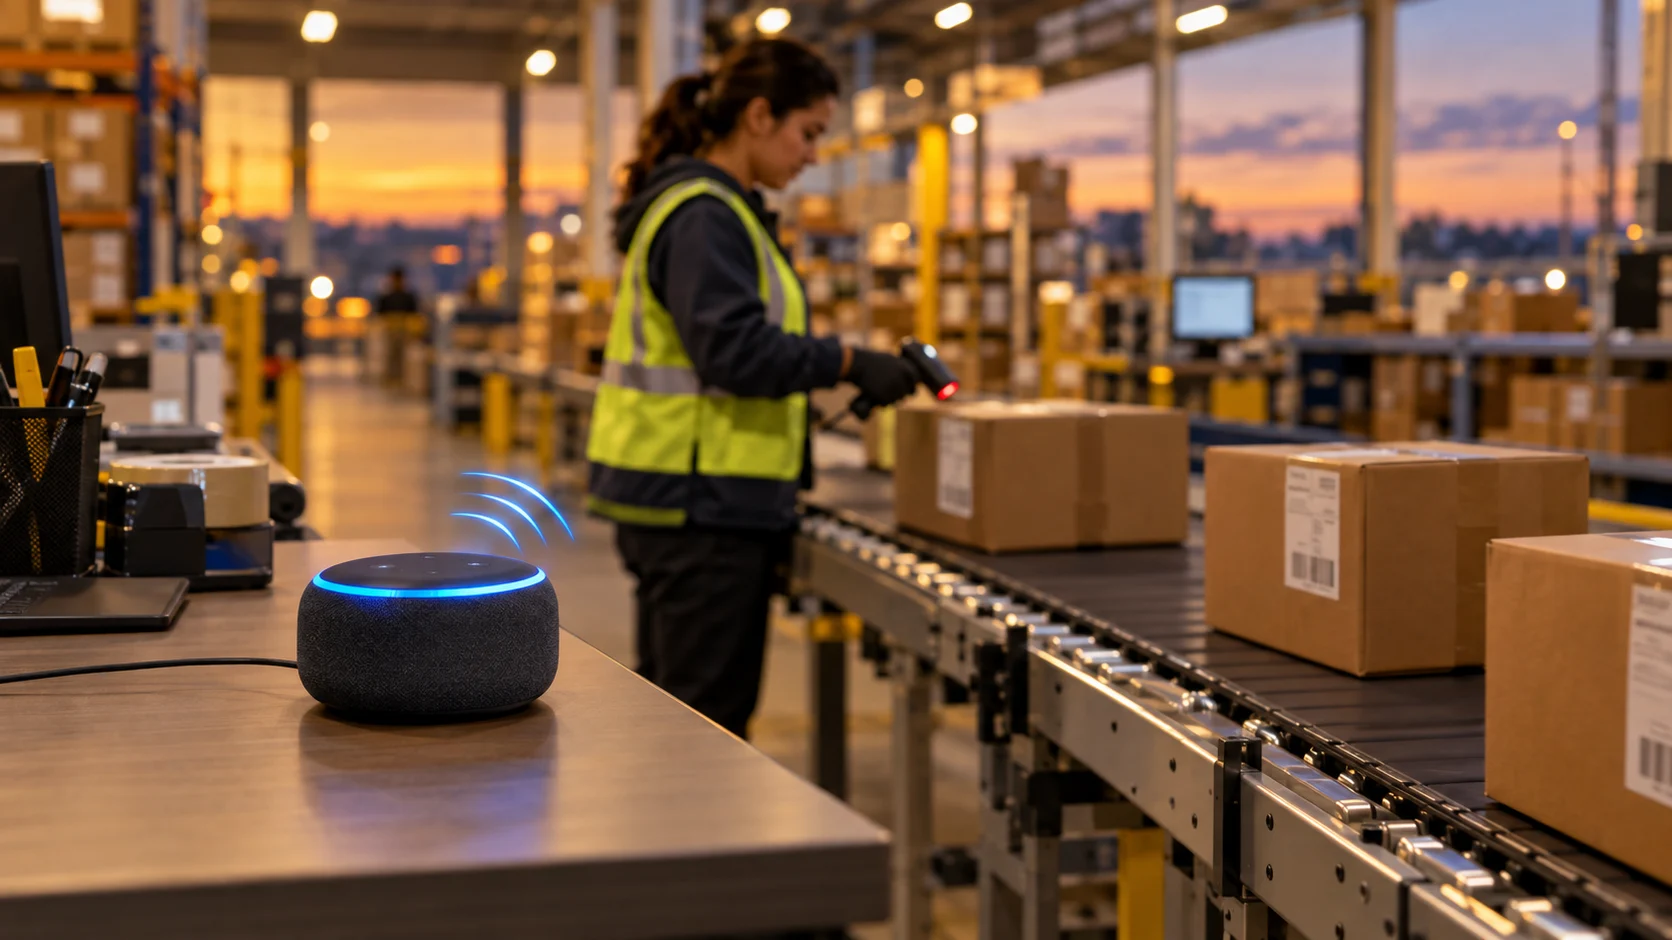
qwen-audio-3.0-tts-flash 是阿里巴巴在 hiapi 上提供的低延迟文本转语音模型,其速度特性特别适合两类电商任务:在语音助手中回答购物者问题而不会出现尴尬的停顿,以及在订单或库存更新的那一刻读出更新内容。这两类任务都不需要庞大的模型——它们需要的是启动快、听起来自然的语音。
为什么低延迟在这里很重要
电商语音界面的失败往往源于延迟,而非音质。一个需要三秒才开始说话的客服机器人即使答案正确,也会让人觉得坏了。仓库或店面广播系统如果落后于它所描述的事件(“订单 #4821 已就绪”晚了一分钟才播报),就完全失去了作用。qwen-audio-3.0-tts-flash 正是为这类问题而构建:简短、频繁的话语,需要在文本准备好的那一刻就发出,而不是为播客或有声书批量渲染的音频。
场景 1:客服语音机器人
支持语音机器人通常每轮生成少量短句——订单状态、退货政策、配送预估——并且需要以最小延迟把每句话说出来,以保持对话的实时感。由于 qwen-audio-3.0-tts-flash 只需要 text 和 voice 作为输入,它很容易接入现有的对话流水线:你的 LLM 或规则引擎生成回复文本,该模型在下一跳将其转为音频。
curl -X POST https://api.hiapi.ai/v1/tasks   -H "Authorization: Bearer sk-<your-api-key>"   -H "Content-Type: application/json"   -d '{
    "model": "qwen-audio-3.0-tts-flash",
    "input": {
      "text": "Your order shipped this morning and should arrive by Thursday.",
      "voice": "longanhuan_v3.6"
    }
  }'
响应是一个 taskId,你通过轮询(或通过回调接收)获取指向渲染音频的 output[0].url——这与 hiapi 各模型使用的 /v1/tasks 模式相同。关于 curl 和 Python 的完整请求/响应流程,请参阅 qwen-audio-3.0-tts-flash API 教程。
场景 2:实时订单与库存播报
第二个用例对话性较弱,更偏向广播式:履约中心通过车间扬声器喊出“打包站 3,订单就绪”,店面自助终端播报“商品已补货”,或收银台大声确认扫描的商品。这些是由事件(webhook、数据库行变更、条码扫描)触发的简短模板化短语,标准是一样的——在时机过去之前完成合成并播放。
由于计费按字符而非按请求计算,这类简短的模板化短语按需生成的成本很低,无需预先录制每一种可能的变体。一种实用模式是维护一小组短语模板,在运行时填入变量(订单号、商品名、货道),每次重新调用模型:
import requests

def announce(text: str, api_key: str) -> str:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "model": "qwen-audio-3.0-tts-flash",
            "input": {"text": text, "voice": "loongeva_v3.6"},
        },
    )
    return resp.json()["data"]["taskId"]
选择音色
voice 接受四个固定值:longanhuan_v3.6、longjielidou_v3.6、loongeva_v3.6 和 loongjohn。对于面向客户的播报,值得为每个音色生成一小段样本,并选择与你的品牌调性匹配的那个,然后再接入生产环境——之后没有 speed 或 pitch 参数可调,因此音色选择是决定播报听感的主要杠杆。
定价
计费为每 1,000 个输入文本字符 $0.03(截至 2026-09)——足够便宜,因此按事件播报和按轮次机器人回复无需批处理即可保持可负担。在估算用量之前,请在 hiapi 定价页面确认当前费率,因为费率可能变化。
常见问题
qwen-audio-3.0-tts-flash 能否逐轮处理实时客服对话? 可以——它专为简短、频繁的文本转语音调用而设计,而非长篇旁白,这与多轮机器人逐句回复的场景相匹配。
它对于实时车间或店面播报来说足够快吗? 对于简短的模板化短语(订单号、商品名、状态词),合成速度足够快,播报会在触发事件后很快播放。请用你实际的短语长度进行测试,因为延迟会随文本长度增加。
我是否需要预先录制播报短语,而不是实时生成? 不需要——由于按字符计费且模型低延迟,按需生成简短短语通常比维护预先录制的短语库更简单、更便宜。
购物助手与仓库播报应分别使用哪种音色?
四个音色之间除音调外没有功能差异——longanhuan_v3.6、longjielidou_v3.6、loongeva_v3.6 和 loongjohn。用你实际的播报文本为每个音色生成样本,然后凭听觉选择。
我拿回的音频格式是什么?
pcm、wav、mp3 或 opus,通过 input.format 设置;省略则使用模型默认值。
准备把实时语音接入你的店面或支持流程了吗?查看 Qwen-Audio 3.0 TTS Flash 模型页面了解完整规格,或者如果你想在围绕电商流程构建之前先有一个可用的请求,从分步 API 教程开始。


