
Guide d'utilisation
Qwen-Audio 3.0 TTS Flash pour le e-commerce : robots vocaux et alertes de commande en temps réel
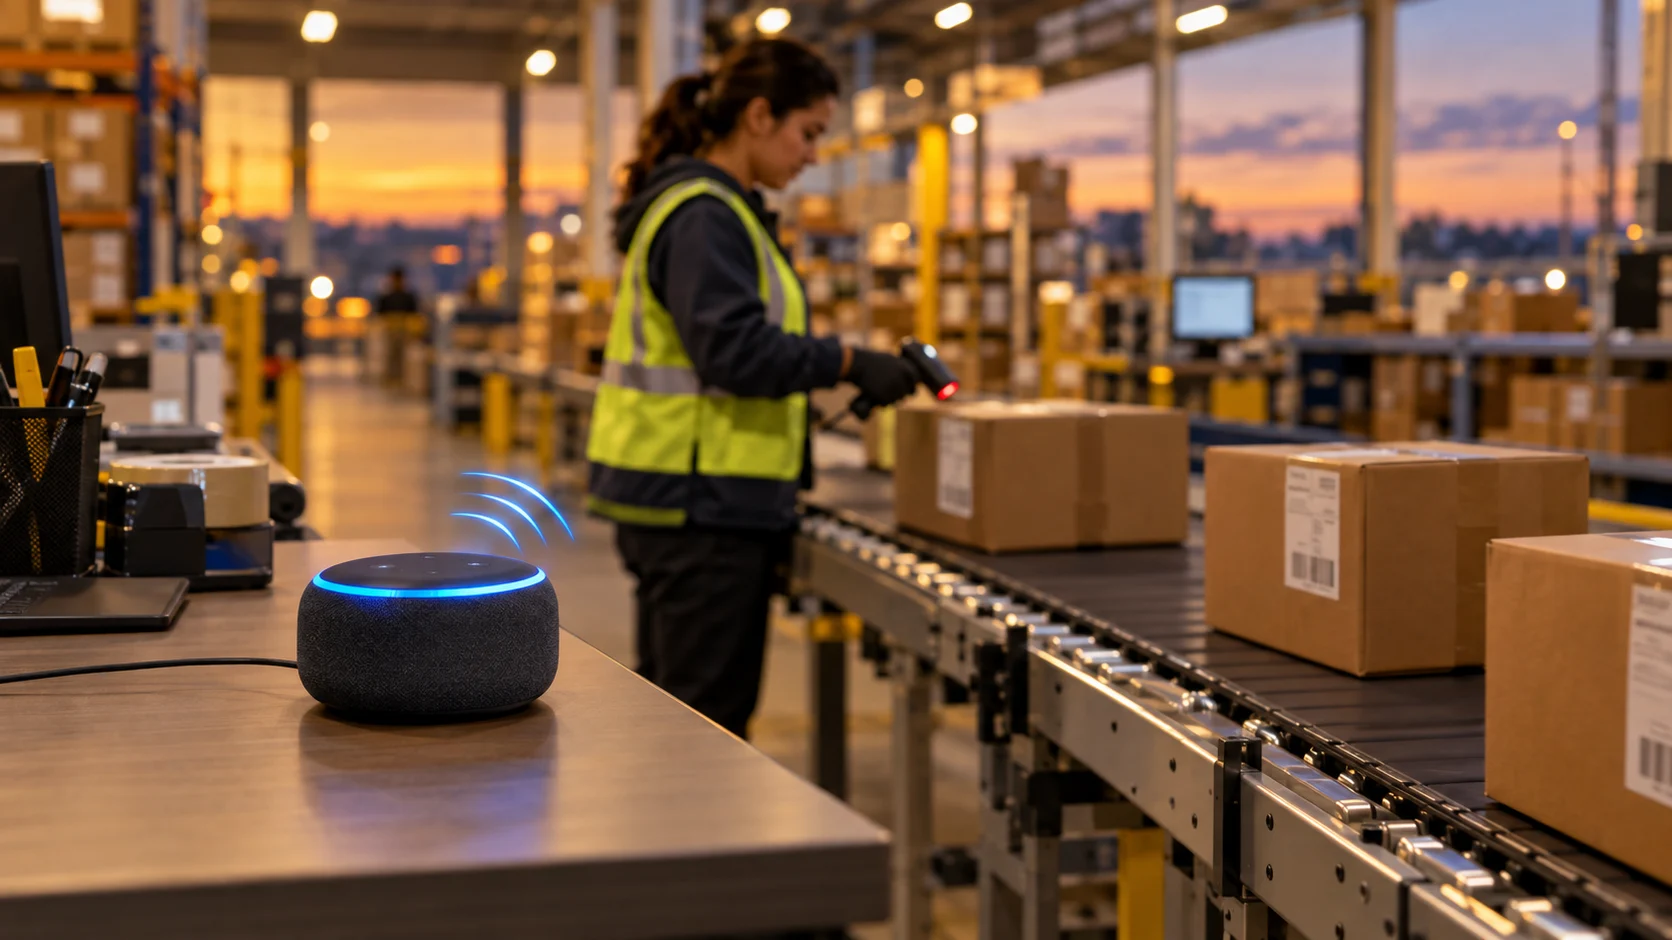
qwen-audio-3.0-tts-flash est un modèle de synthèse vocale à faible latence proposé par Alibaba sur hiapi, dont les caractéristiques de vitesse conviennent particulièrement à deux types de tâches e-commerce : répondre aux questions des acheteurs dans un assistant vocal sans pauses gênantes, et énoncer les mises à jour d'une commande ou d'un stock au moment même où elles se produisent. Aucune de ces deux tâches n'exige un modèle imposant — elles ont besoin d'une voix qui démarre vite et sonne naturellement.
Pourquoi la faible latence compte ici
Les échecs des interfaces vocales en e-commerce proviennent souvent de la latence, et non de la qualité audio. Un robot de service client qui met trois secondes avant de commencer à parler donne l'impression d'être en panne, même si sa réponse est correcte. Un système de diffusion en entrepôt ou en magasin qui prend du retard sur l'événement qu'il décrit (« commande #4821 prête » annoncée une minute plus tard) perd toute son utilité. qwen-audio-3.0-tts-flash est précisément conçu pour ce type de problème : des énoncés courts et fréquents, à émettre dès que le texte est prêt, et non des audios rendus en lot pour un podcast ou un livre audio.
Scénario 1 : robot vocal de service client
Un robot d'assistance vocale génère généralement quelques phrases courtes par tour — statut de commande, politique de retour, estimation de livraison — et doit prononcer chacune d'elles avec une latence minimale pour préserver le caractère temps réel de la conversation. Comme qwen-audio-3.0-tts-flash ne requiert que text et voice en entrée, il s'intègre facilement à un pipeline de dialogue existant : votre LLM ou votre moteur de règles génère le texte de réponse, et le modèle le convertit en audio à l'étape suivante.
curl -X POST https://api.hiapi.ai/v1/tasks   -H "Authorization: Bearer sk-<your-api-key>"   -H "Content-Type: application/json"   -d '{
    "model": "qwen-audio-3.0-tts-flash",
    "input": {
      "text": "Your order shipped this morning and should arrive by Thursday.",
      "voice": "longanhuan_v3.6"
    }
  }'
La réponse est un taskId, que vous utilisez pour récupérer par interrogation répétée (ou via un callback) l'output[0].url pointant vers l'audio rendu — le même schéma /v1/tasks que celui utilisé par les autres modèles hiapi. Pour le flux complet de requête/réponse en curl et en Python, consultez le tutoriel API qwen-audio-3.0-tts-flash.
Scénario 2 : annonces de commandes et de stocks en temps réel
Le second cas d'usage est moins conversationnel et plus proche de la diffusion : un centre de distribution annonce par haut-parleur d'atelier « poste de colisage 3, commande prête », une borne en magasin annonce « article de nouveau en stock », ou une caisse confirme à voix haute l'article scanné. Ce sont de courtes phrases modèles déclenchées par des événements (webhook, modification de ligne en base de données, scan de code-barres), et le critère reste le même — achever la synthèse et la lecture avant que le moment ne soit passé.
La facturation étant calculée au caractère et non à la requête, ce type de courtes phrases modèles coûte peu à générer à la demande, sans avoir à préenregistrer chaque variante possible. Un schéma pratique consiste à maintenir un petit ensemble de gabarits de phrases, à y injecter des variables à l'exécution (numéro de commande, nom d'article, numéro de casier) et à rappeler le modèle à chaque fois :
import requests

def announce(text: str, api_key: str) -> str:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "model": "qwen-audio-3.0-tts-flash",
            "input": {"text": text, "voice": "loongeva_v3.6"},
        },
    )
    return resp.json()["data"]["taskId"]
Choisir une voix
voice accepte quatre valeurs fixes : longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 et loongjohn. Pour les annonces destinées aux clients, il vaut la peine de générer un court échantillon pour chaque voix et de choisir celle qui correspond à l'image de votre marque avant de passer en production — il n'y a ensuite aucun paramètre speed ou pitch à ajuster, le choix de la voix est donc le principal levier qui détermine le rendu sonore des annonces.
Tarification
La facturation est de 0,03 $ pour 1 000 caractères de texte d'entrée (à la date de 2026-09) — suffisamment abordable pour que les annonces par événement et les réponses de robot par tour restent économiques sans traitement par lots. Avant d'estimer votre consommation, vérifiez les tarifs actuels sur la page de tarification hiapi, car ils sont susceptibles de changer.
Questions fréquentes
qwen-audio-3.0-tts-flash peut-il gérer une conversation de service client en temps réel, tour par tour ? Oui — il est conçu pour des appels de synthèse vocale courts et fréquents, et non pour de longues narrations, ce qui correspond au scénario d'un robot multi-tours répondant phrase par phrase.
Est-il assez rapide pour des annonces en temps réel en atelier ou en magasin ? Pour de courtes phrases modèles (numéro de commande, nom d'article, mot d'état), la synthèse est suffisamment rapide pour que l'annonce soit diffusée peu après l'événement déclencheur. Testez avec vos longueurs de phrases réelles, car la latence augmente avec la longueur du texte.
Dois-je préenregistrer les phrases d'annonce plutôt que les générer en temps réel ? Non — la facturation au caractère et la faible latence du modèle font que générer de courtes phrases à la demande est généralement plus simple et moins coûteux que de maintenir une bibliothèque de phrases préenregistrées.
Quelle voix choisir respectivement pour un assistant d'achat et pour des annonces d'entrepôt ?
Aucune différence fonctionnelle entre les quatre voix, hormis le timbre — longanhuan_v3.6, longjielidou_v3.6, loongeva_v3.6 et loongjohn. Générez un échantillon de chacune avec vos textes d'annonce réels, puis choisissez à l'écoute.
Quel format audio vais-je recevoir ?
pcm, wav, mp3 ou opus, défini via input.format ; si vous l'omettez, la valeur par défaut du modèle est utilisée.
Prêt à intégrer la voix en temps réel dans votre boutique ou votre support ? Consultez la page du modèle Qwen-Audio 3.0 TTS Flash pour les spécifications complètes, ou, si vous préférez disposer d'une requête fonctionnelle avant de construire autour des flux e-commerce, commencez par le tutoriel API pas à pas.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax