
Руководство по использованию
Рецепты промптов для генерации видео по референсам Vidu Q3 Mix: объединение нескольких изображений в один кадр
Четыре готовых к копированию промпта для генерации видео по референсам, каждый из которых объединяет 2–3 отдельных изображения — объект, сцену и реквизит — в один фрагмент q3-mix, с реальными результатами, сгенерированными на hiapi.
Резюме
- Четыре готовых к копированию промпта для генерации видео по референсам для vidu-q3-mix/reference-to-video, каждый из которых сопровождается реально сгенерированным на hiapi фрагментом — без стоковых материалов и без подмены видео одиночным статичным кадром.
- Q3 Mix — это уровень смешивания нескольких изображений: дайте ему 1–7 референсных изображений (персонаж, объект, сцена), и он объединит их в динамичный кадр. Приведённые ниже рецепты каждый раз смешивают два и три статичных изображения.
- Единственное правило, определяющее, удастся ли смешивание: пронумеруйте референсные изображения и назначьте каждому чёткую задачу — «воронка с референса 1 стоит на стеклянном кувшине с референса 2», и ни в коем случае не говорите расплывчато «объедини это».
- Проверено в этом запуске: смешивание трёх изображений (объект + эффект + фон) чисто синтезируется, выходные пиксели немного ниже номинального
size, фрагмент — H.264 (воспроизводится прямо в браузере без перекодирования), и — несмотря на метку «нативный звук» — каждый фрагмент возвращается без звука. - Скопируйте промпт, подставьте свои референсные URL и отправьте POST на
/v1/tasks.
Почему «смешивание» — это особая работа с промптами
Vidu Q3 Mix (от ShengShu) — это уровень генерации видео по референсам, специально предназначенный для одновременного смешивания нескольких изображений — до семи, объединяя персонажей, объекты и сцены в один фрагмент. Если промпт не сообщает модели, какое изображение что предоставляет, эта возможность тратится впустую.
Одна привычка, отличающая чистое смешивание от мутного: пронумеруйте референсные изображения и назначьте каждому чёткую задачу. Пишите «воронка с референса 1 стоит на стеклянном кувшине с референса 2», а не «объедини эти два в кофейную сцену». Модель привязывает каждый объект к его индексу; «объедини это» — именно там смешивание и даёт сбой: оно теряет один референс, усредняет два объекта в один или приклеивает что-то в неверном масштабе. Изображение 1 — это первый URL в reference_image_urls, изображение 2 — второй, и так далее.
Всё ниже использует этот шаблон. Каждый рецепт перечисляет точные референсные статичные изображения, которые я сгенерировал, полный промпт, который я отправил, и фрагмент, который он сгенерировал на hiapi.
Рецепт 1 — Два продукта, одна ключевая сцена (смешивание двух изображений)
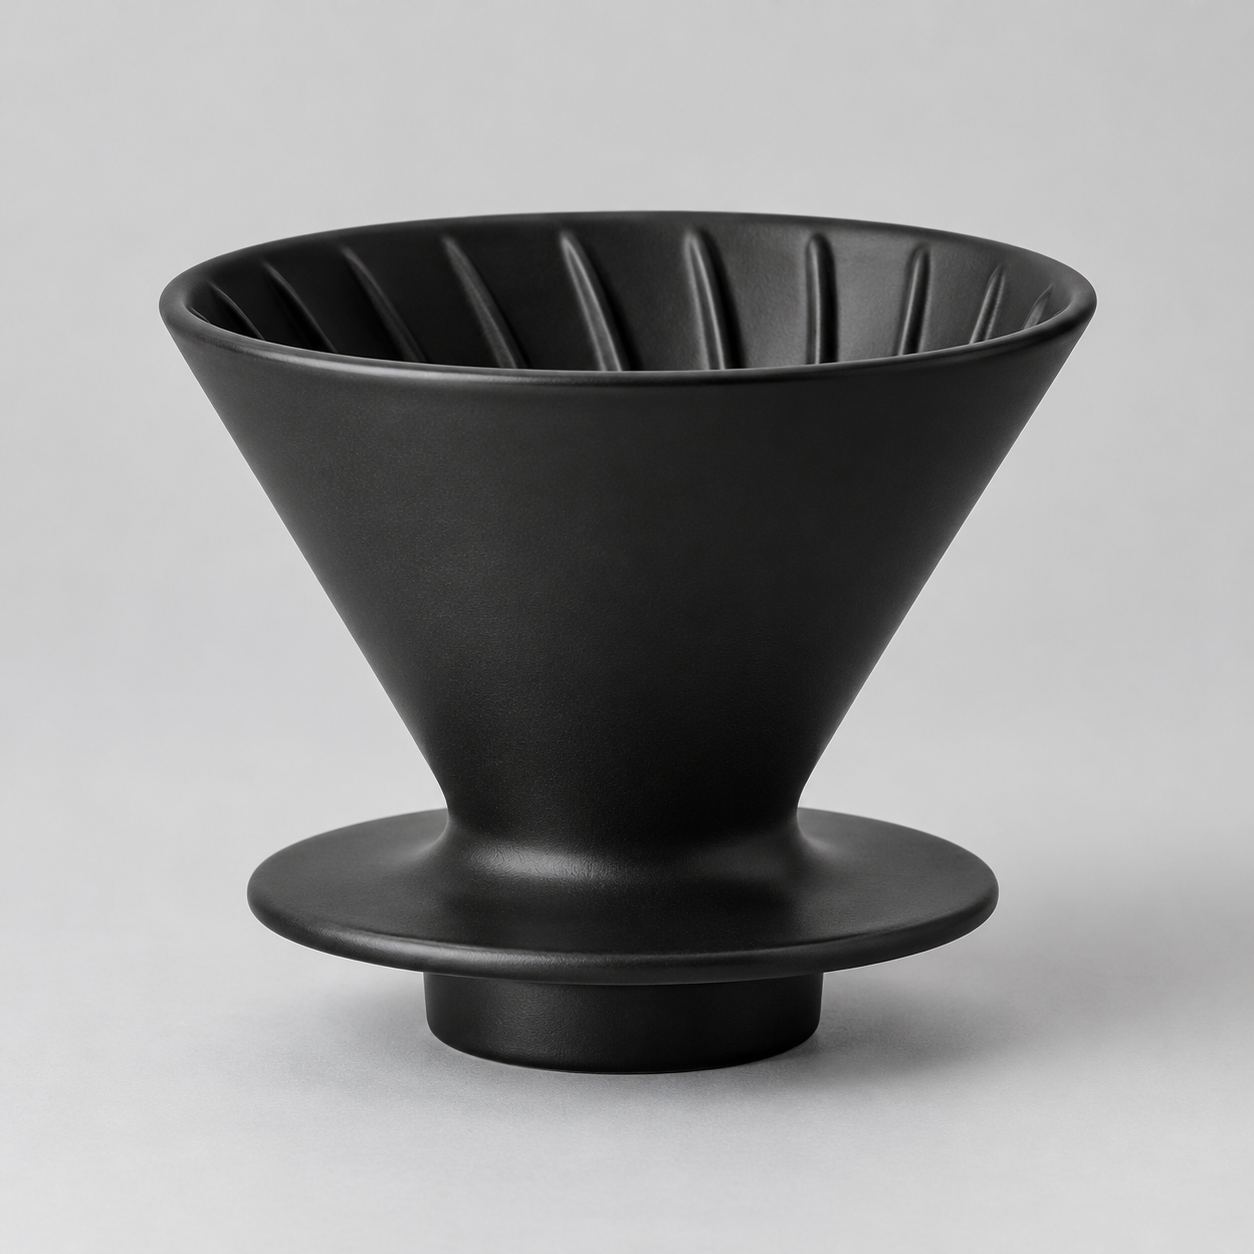
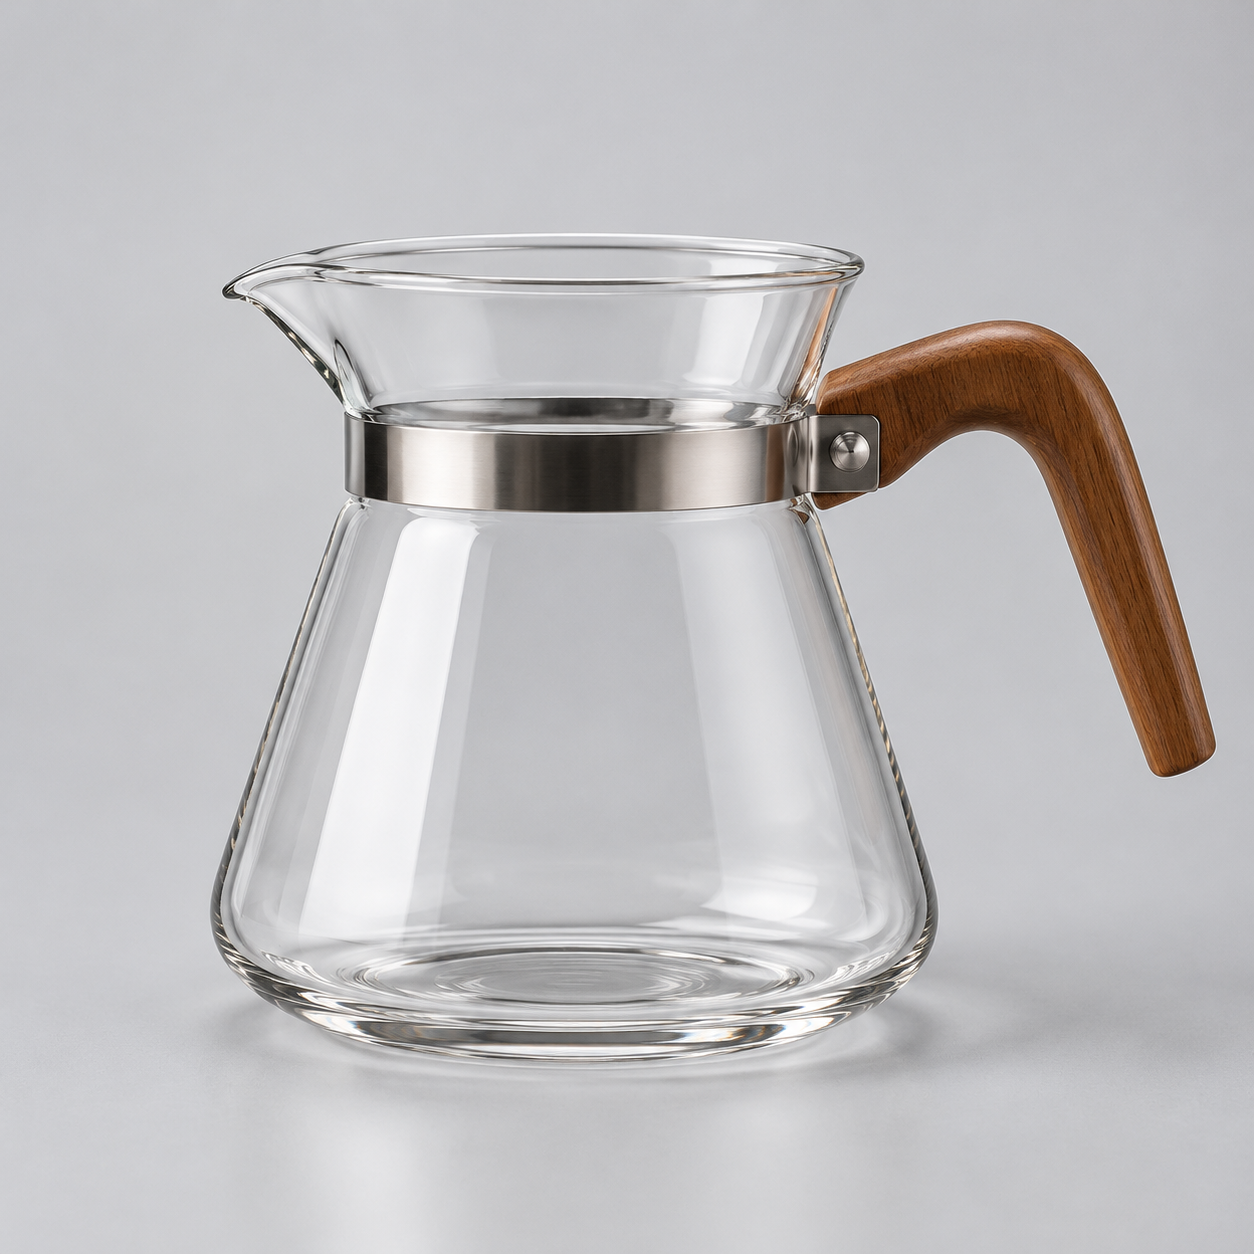
Классическая задача «смешивания»: два отдельных продуктовых кадра должны разделить одно изображение. Я дал Q3 Mix матово-чёрную воронку для пуровера и пустой стеклянный кувшин — два изображения, два объекта — и попросил их сложить друг на друга и заварить кофе.
Референс 1 (воронка) и референс 2 (стеклянный кувшин):
Матово-чёрная керамическая воронка для пуровера с референса 1 устойчиво стоит на прозрачном стеклянном кофейном кувшине с референса 2, оба вместе на светлой бетонной стойке кафе. Медленный наезд камеры, тонкая струйка свежего кофе начинает капать из воронки в кувшин, пар поднимается вверх, тёплый утренний свет косо падает из окна слева. Премиальная реклама продукта, малая глубина резкости, мягкие фоновые звуки кафе.
Что было смешано, а что модель придумала. Оба объекта правильно встали на места: воронка с изображения 1 сидит на кувшине с изображения 2, относительные пропорции верны, формы очень близки к статичным изображениям. Всё между двумя продуктами — бетонная стойка, размытое кафе позади, свет из окна, кофе, наливающийся в кувшин, пар — придумано моделью; ни одно из двух референсных изображений этого не содержит. Это и есть полезная мысленная модель Q3 Mix: вы закрепляете объекты, а он заполняет окружающий мир. Камера выполнила один наезд, о котором я просил. Отрендерено на 1920*1080 длительностью 5 секунд; поставленный файл — 1914×1084 (см. «ниже номинального размера» ниже), эта генерация стоила около $0.93.
Рецепт 2 — Поместить персонажа в совершенно новую комнату (объект + сцена)
Второй частый тип смешивания — объект плюс окружение: одно изображение отвечает за кто, другое — за где. Я отрендерил плюшевую игрушку-робота на чистом белом фоне и залитую солнцем детскую спальню без персонажей, а затем попросил модель поместить первое во второе.
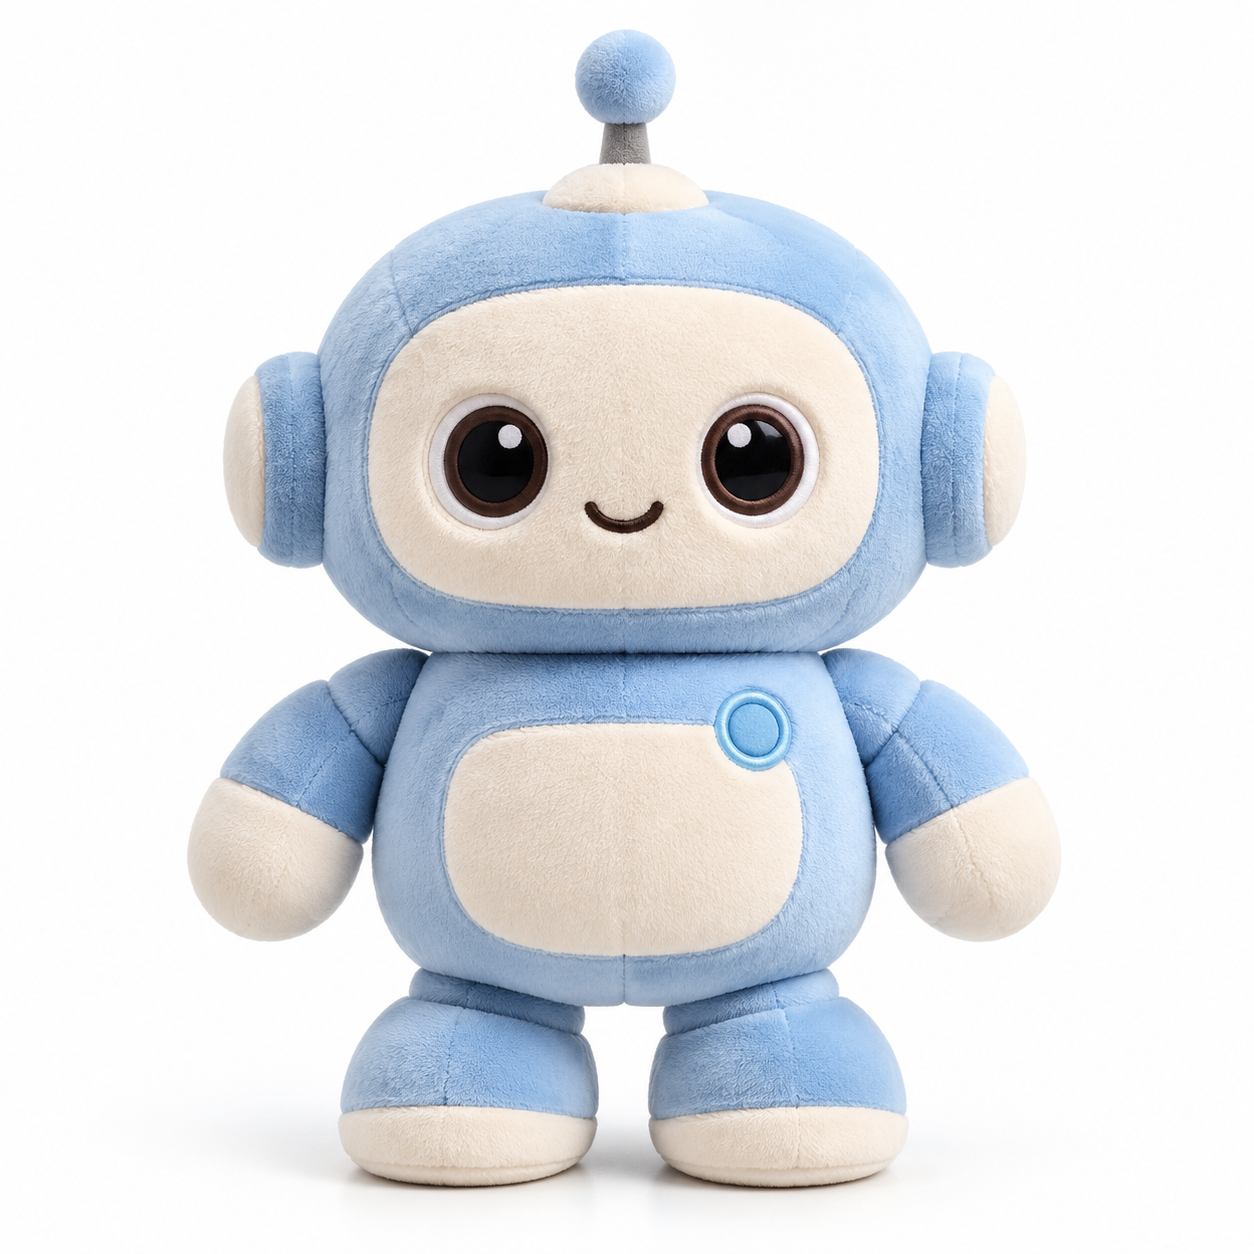
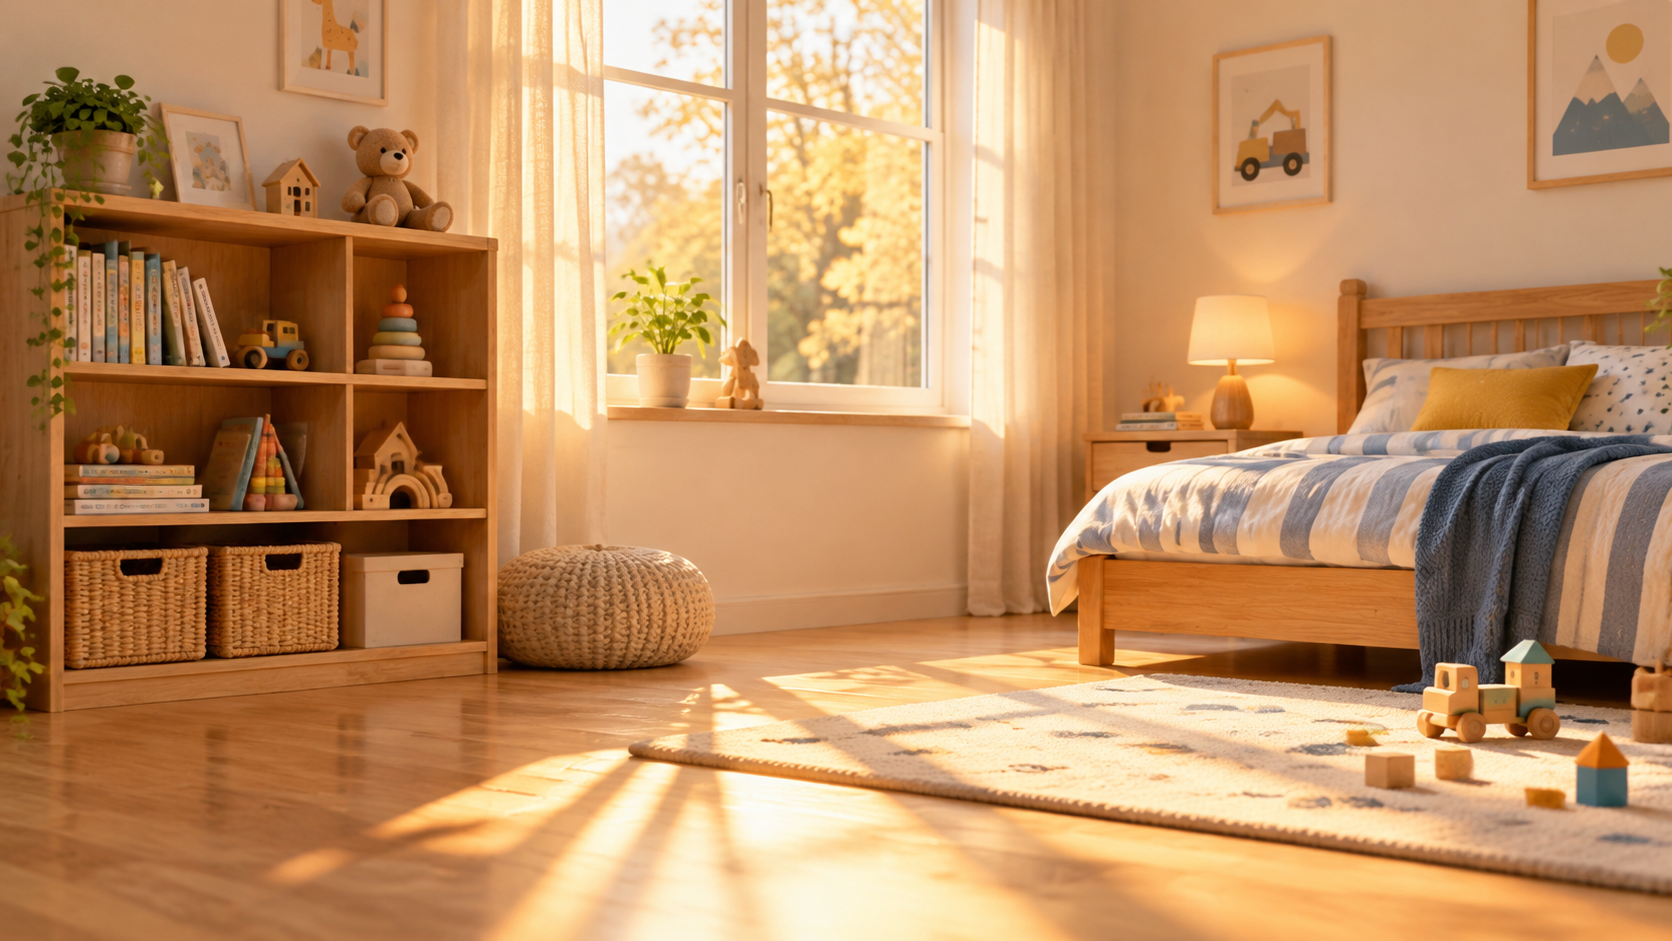
Светло-голубая плюшевая игрушка-робот с референса 1 сидит на деревянном полу залитой солнцем детской спальни с референса 2. Она медленно наклоняет голову, поднимает одну короткую руку и машет в камеру, пылинки плывут в тёплом оконном свете, мягкий наезд камеры с рук. Мягкий, жизнерадостный, кинематографичный, лёгкие фоновые звуки комнаты.
Что было смешано, а что модель придумала. Спальня с изображения 2 сохранилась почти без изменений — книжная полка, полосатая кровать, окно и его свет, кубики на ковре остались в композиции. Робот с изображения 1 помещён на этот пол и освещён в тон тёплому свету, поэтому он выглядит внутри комнаты, а не наклеенным сверху. Он выполнил заданное мной действие (наклон головы и взмах поднятой рукой), камера выполнила наезд с рук. Это шаблон «персонаж в сцене»: пусть одно референсное изображение несёт всё окружение, и модель переосветит объект под соответствие окружению. 1280*720, 5 секунд, около $0.78.
Рецепт 3 — Три изображения, один кадр: объект + эффект + фон
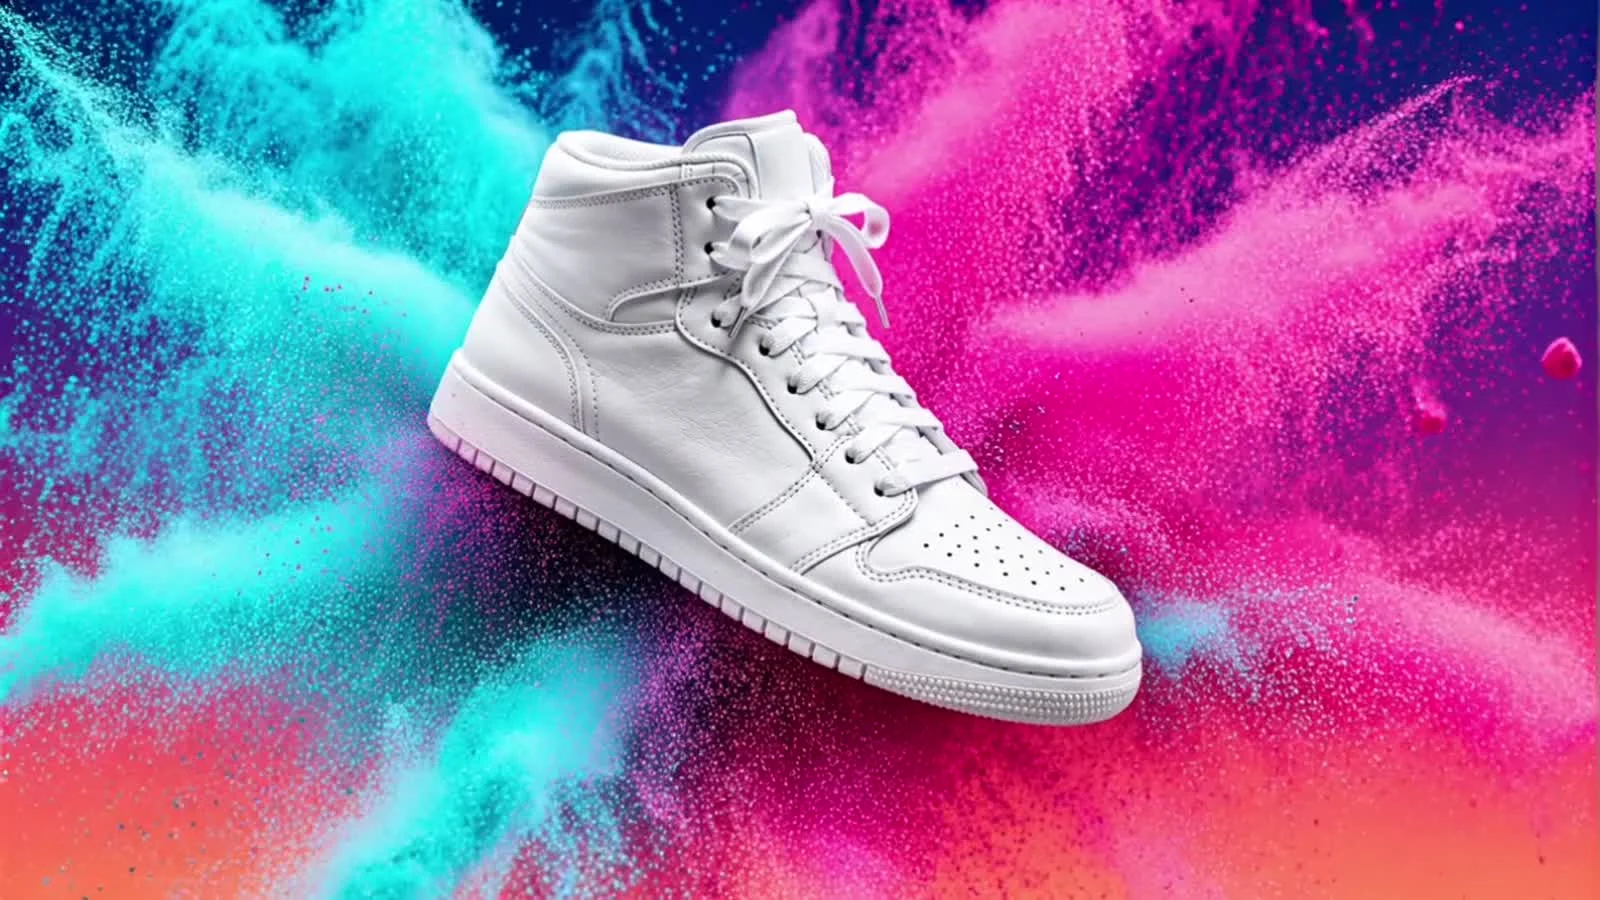
Этот рецепт оправдывает название «смешивание». Три отдельных статичных изображения — кроссовок, взрыв цветного порошка и градиентный фон — каждое с явно различной задачей, смешиваются в энергичный продуктовый кадр.
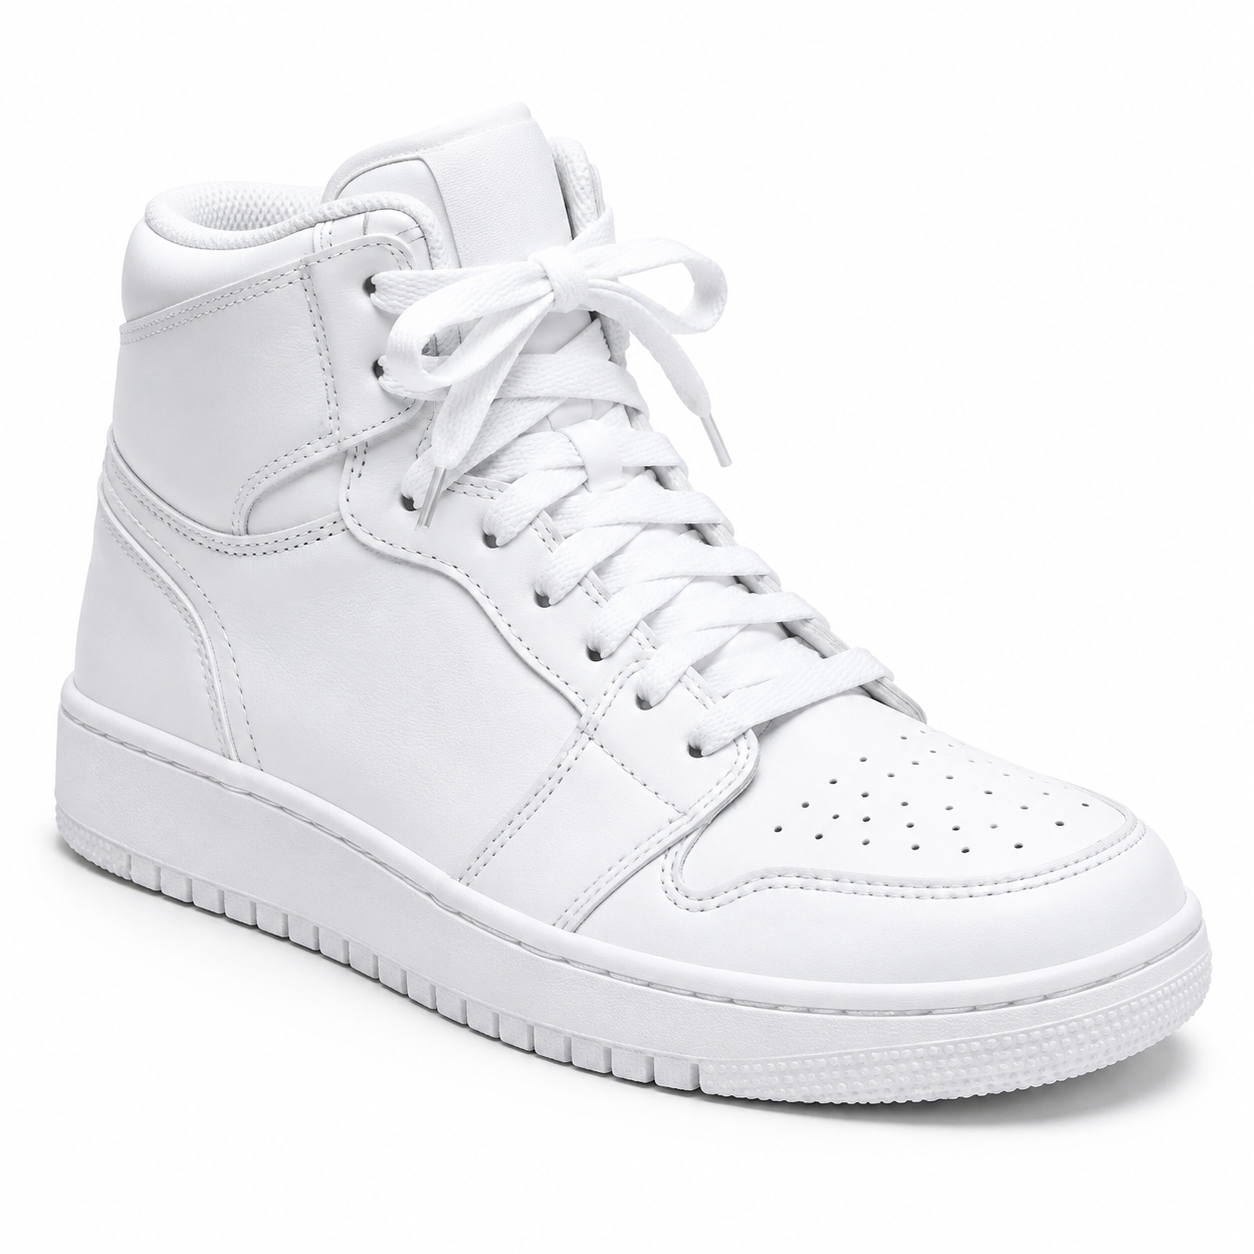
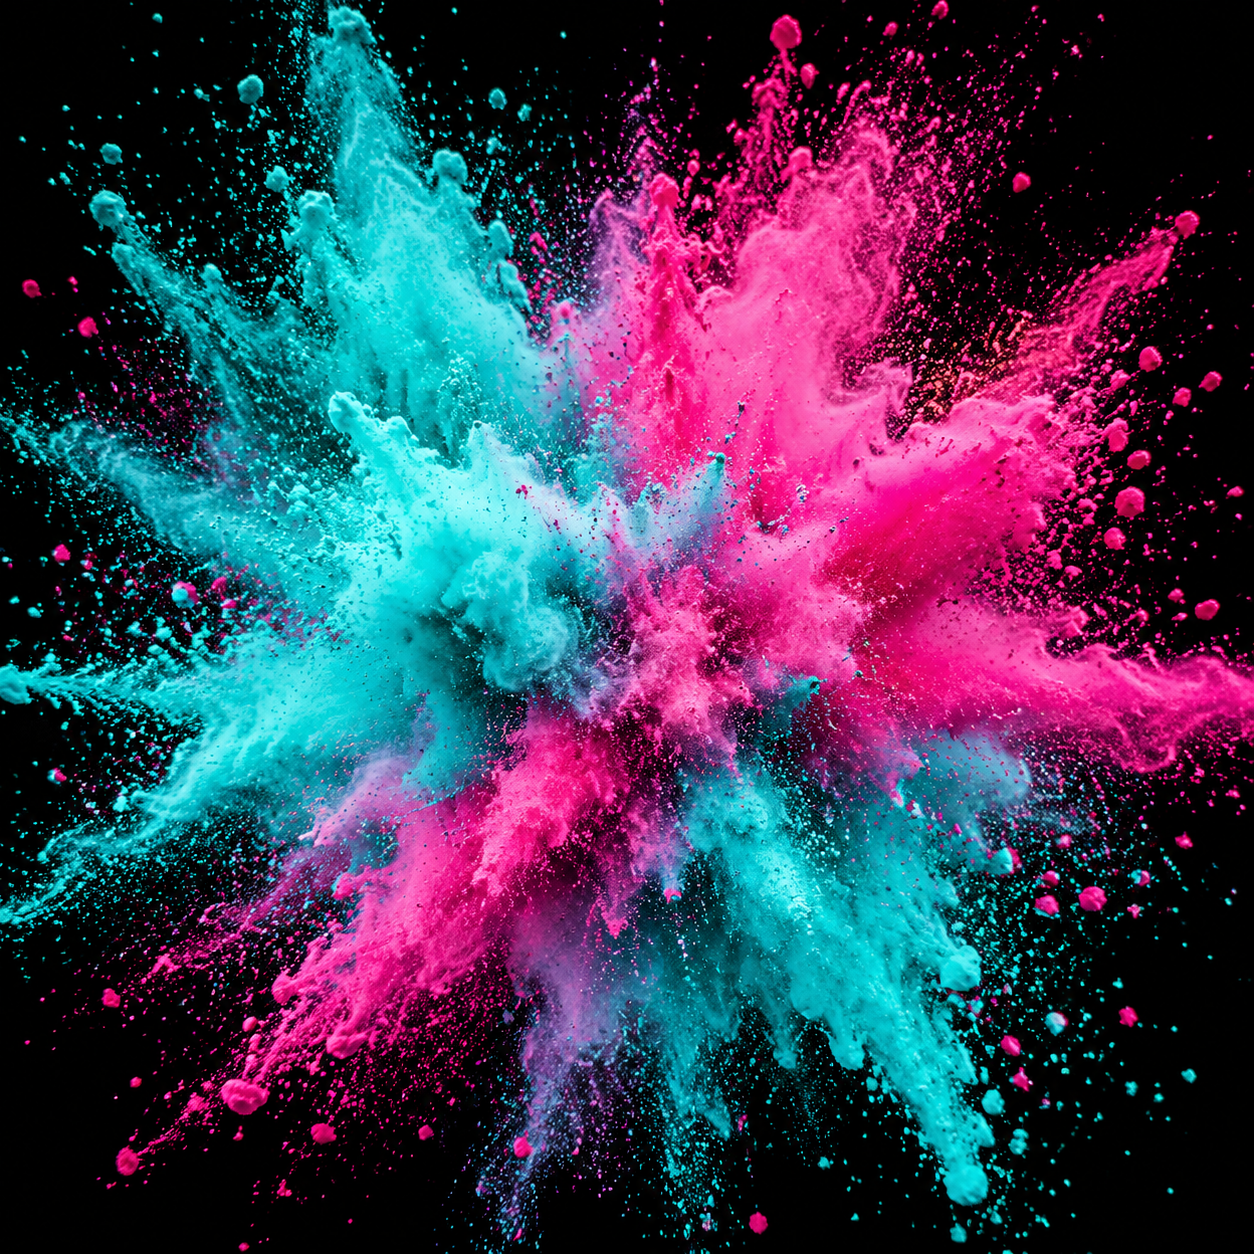
Белый высокий кроссовок с референса 1 парит в центре на градиентном фоне от индиго до кораллового с референса 3, в то время как бирюзовый и пурпурный порошок с референса 2 взрывается наружу в замедленной съёмке. Камера движется по дуге вокруг кроссовка на сорок пять градусов, шлейф порошка вращается и опадает. Энергичная реклама кроссовок, драматичный студийный свет, мощный свистящий звук.
Что было смешано, а что модель придумала. Все три референсных изображения появились и сохранили свои роли: кроссовок — объект, бирюзовый и пурпурный порошок — эффект, окутывающий его, градиент от индиго до кораллового — безошибочно фон. Запрошенная мной дуга камеры видна — кроссовок поворачивается относительно кадра за пять секунд. Причина, по которой три изображения здесь держатся вместе, тогда как более расплывчатый промпт сделал бы их мутными: каждое референсное изображение берёт на себя непересекающуюся задачу в предложении (объект / эффект / фон), и я ссылаюсь на них по индексам, включая не по порядку упомянутый «референс 3» для фона. После трёх-четырёх референсов эта дисциплина перестаёт быть необязательной — назначьте каждому изображению чёткую задачу, иначе модель молча отбросит самое слабое. 1280*720, 5 секунд, около $0.78. (Этот кадр — обложка статьи.)
Рецепт 4 — Вертикальный для соцсетей: талисман демонстрирует продукт
Последний — вертикальное смешивание 9:16 для соцсетей: одно изображение — брендовый талисман, другое — продукт, который он продаёт. Задача — заставить персонажа держать продукт, вертикально, готовым для ленты.
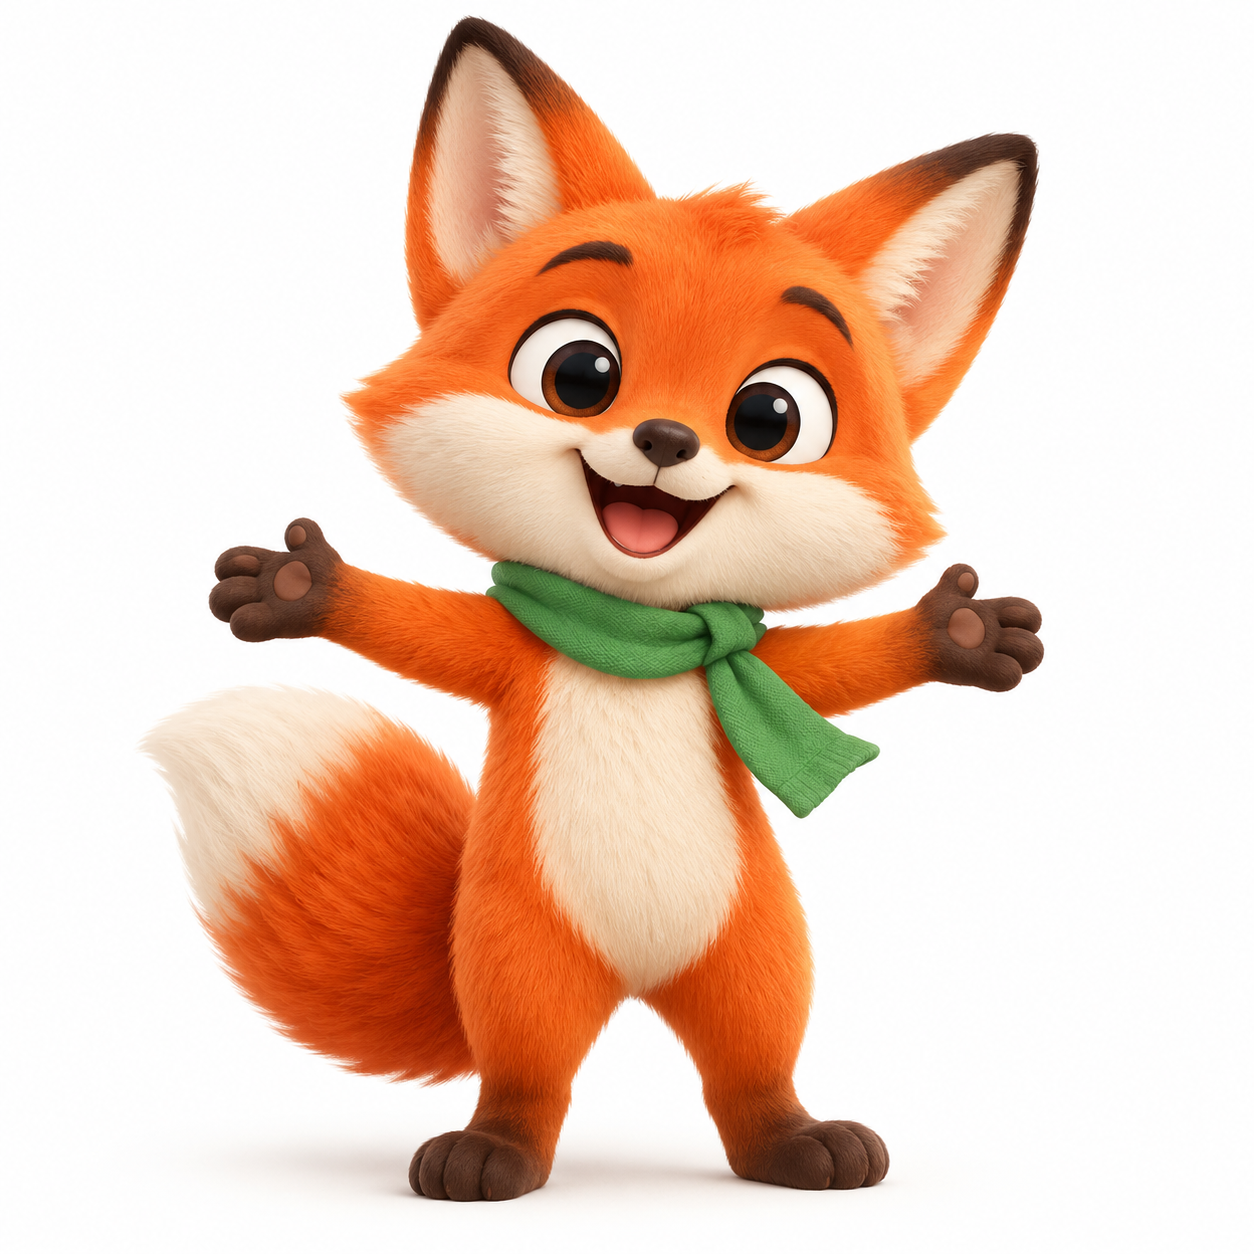
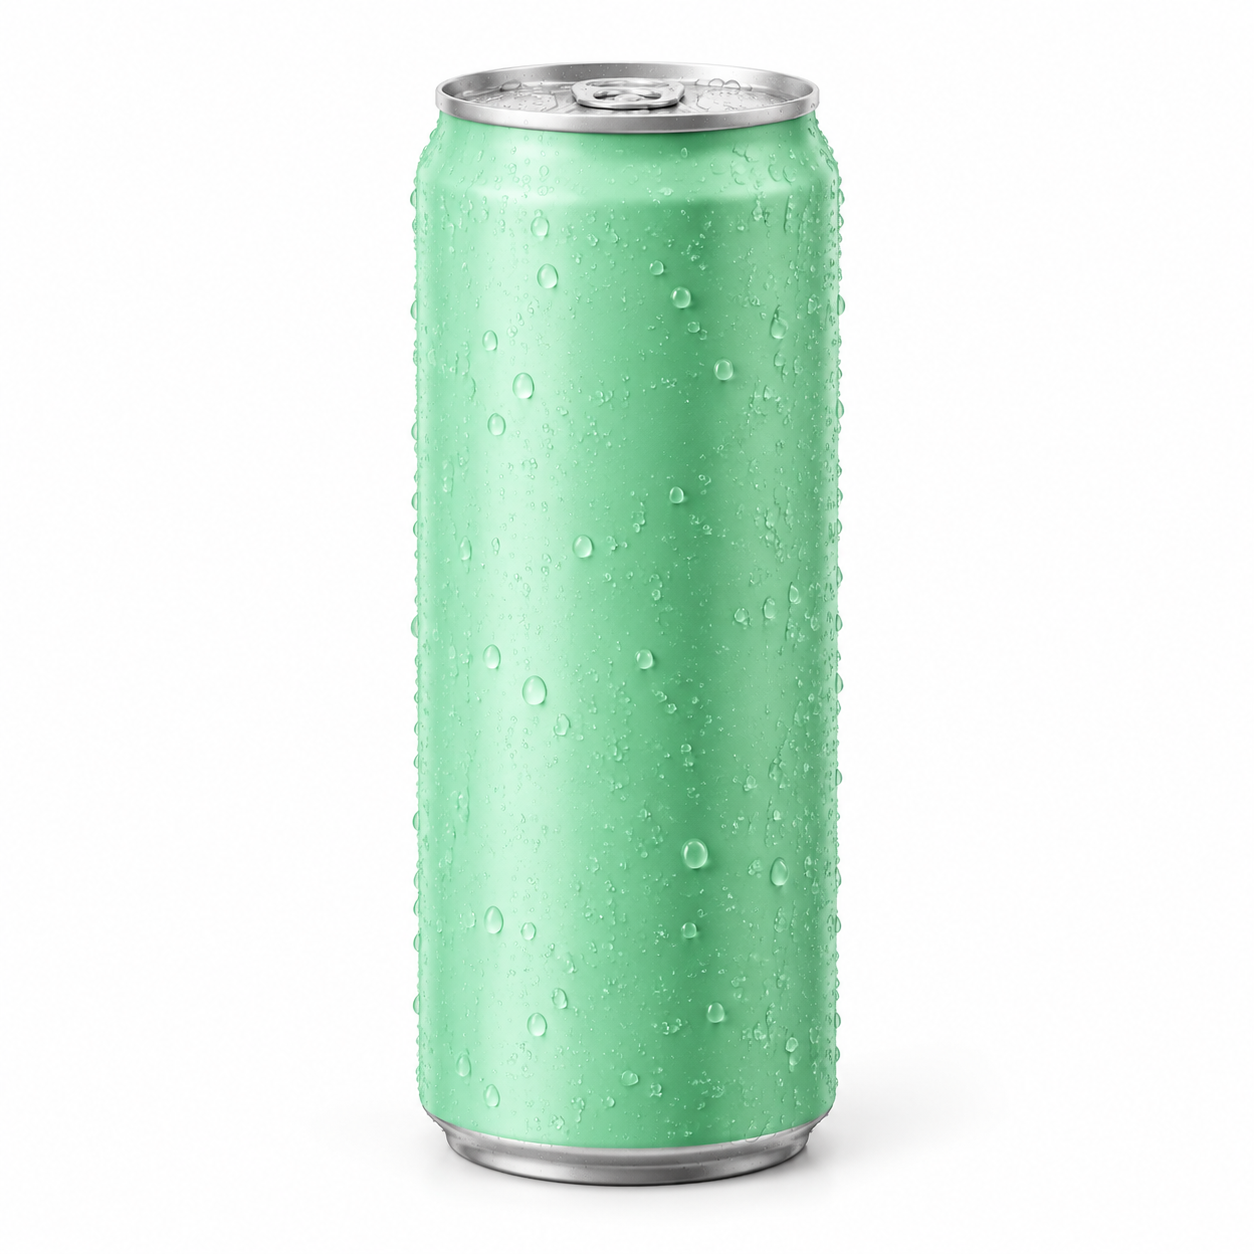
Вертикальный кадр. Оранжевый мультяшный талисман-лис с референса 1 поднимает мятно-зелёную банку газированной воды с референса 2, с радостным лёгким подпрыгиванием демонстрируя её в камеру, яркий поп-арт студийный фон, падает конфетти. Игривая реклама для соцсетей, энергичный радостный свет, оживлённые звуки пузырьков.
Что было смешано, а что модель придумала. Лис сохранил дизайн с изображения 1 (оранжевый мех, зелёный шарф, большие глаза), банка сохранила матовую мятно-зелёную поверхность с изображения 2, лапы персонажа обхватывают её — глагол «поднимает… демонстрируя в камеру» связывает два референсных изображения в одно действие, а не два объекта, делящих кадр. Поп-арт фон и конфетти придуманы. Только выбор вертикального size (720*1280) делает его вертикальным; поля aspect_ratio нет (подробности ниже). 4 секунды, около $0.62.
Чему я научился, прогнав эти рецепты
Пять вещей, которые стоит знать до траты кредитов, — всё из этой серии тестов:
- Привязка по индексу — ключевое. Каждый фрагмент здесь соблюдал «X с референса N». Когда вы хотите, чтобы два объекта взаимодействовали, дайте действию глагол, который их связывает («поднимает», «ставит на…»), а не просто перечисляйте их рядом.
- Вы закрепляете объекты; модель придумывает связующую ткань. Стойка, освещение всей комнаты, конфетти, вращающийся порошок — ничего этого нет в референсах. Для «объекта в сцене» это свойство, но это также означает, что всё, что нужно сохранить, должно присутствовать в референсном изображении.
- Выходные пиксели немного ниже номинального
size.1920*1080возвращается как 1914×1084,1280*720как 1276×722,720*1280как 722×1276. Для веба достаточно близко, но не хардкодьте точные размеры дальше по цепочке. - Выход — H.264, готов встраиваться. В отличие от 4K-уровня, отдающего HEVC, эти фрагменты воспроизводятся прямо встроенно без перекодирования — каждое видео на этой странице является файлом, напрямую возвращённым API.
- «Нативный звук» не создал звука. Каждый из четырёх фрагментов вернулся как беззвучный MP4 только с видео — несмотря на метку «нативный звук» у модели и звуковые подсказки в моих промптах («мягкие фоновые звуки кафе», «мощный свистящий звук»). Собственные примеры Q3 Mix на платформе тоже беззвучны. Планируйте добавлять звук на постпродакшене или, если голосовая дорожка критична, используйте уровень с явным аудиовходом — рецепты Vidu Q4 Preview охватывают рабочий процесс с голосовыми референсами.
Воспроизведите любой рецепт через /v1/tasks
Генерация видео по референсам работает на асинхронном API задач: отправьте задачу, опрашивайте, пока статус не станет success, затем скачайте фрагмент из output[0].url (этот URL недолговечен — сохраните файл сразу).
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-mix/reference-to-video",
    "input": {
      "prompt": "воронка с референса 1 на стеклянном кувшине с референса 2……",
      "reference_image_urls": [
        "https://your-host/dripper.png",
        "https://your-host/carafe.png"
      ],
      "duration": 5,
      "size": "1920*1080"
    }
  }'
# -> {"data":{"taskId":"tk-..."}}   затем GET /v1/tasks/tk-... пока status == "success"
import requests, time

H = {"Authorization": f"Bearer {TOKEN}"}
job = requests.post("https://api.hiapi.ai/v1/tasks", headers=H, json={
    "model": "vidu-q3-mix/reference-to-video",
    "input": {"prompt": PROMPT, "reference_image_urls": REFS,
              "duration": 5, "size": "1920*1080"},
}).json()["data"]["taskId"]

while True:
    t = requests.get(f"https://api.hiapi.ai/v1/tasks/{job}", headers=H).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("clip.mp4", "wb").write(requests.get(t["output"][0]["url"]).content)
Правила полей, которые стоит знать до копирования рецепта:
reference_image_urlsпринимает 1–7 изображений. Восьмое вернёт400 maxItems: want 7.duration— целое число от 1 до 16 секунд. Числа с плавающей точкой вроде4.5или99будут отклонены при отправке.- Форма задаётся через
size, а неaspect_ratio— передачаaspect_ratio(илиresolution) вернёт400 additional properties not allowed. Десять значенийsize— это пять соотношений сторон на двух уровнях, 720 и 1080; для вертикали выбирайте вертикальные значения, для 16:9 — горизонтальные. - Нет поля аудиореференса —
reference_audio_urlsбудет отклонён. Если вам нужно управлять голосом аудиосэмплом, это уровень Q4 Preview, а не Q3 Mix. - Оплата по секундам (уровень 720 против 1080) — на странице цен; четыре фрагмента здесь стоили около $0.62–$0.93 каждый. Сначала итерируйте композицию на уровне
size720, затем перезапускайте финальную версию на 1080.
Часто задаваемые вопросы
Сколько референсных изображений может смешать Q3 Mix? От одного до семи. Два — частый случай (объект + сцена); три всё ещё чисто синтезируются, если каждое изображение берёт на себя явно различную роль, как в рецепте с кроссовком выше. После четырёх давайте каждому референсному изображению чёткую, непересекающуюся задачу, иначе модель начнёт отбрасывать самое слабое.
Как контролировать, какое изображение является объектом, а какое — фоном?
Ссылайтесь на них по индексам и назначайте роли в одном предложении: «кроссовок с референса 1… на фоне с референса 3». Порядок URL в reference_image_urls — это порядок индексов: изображение 1 — первый URL.
Q3 Mix автоматически добавляет звук? В моих тестах нет. Несмотря на метку «нативный звук», все четыре фрагмента — как и собственные примеры Q3 Mix на платформе — возвращаются как беззвучные MP4, даже когда промпты содержат звуковые слова. Считайте Q3 Mix генератором только изображения, добавляйте аудио на постпродакшене или переходите на уровень с явным аудиовходом.
Можно ли получить 4K или пользовательское соотношение сторон?
4K нет — Q3 Mix ограничен значениями size уровня 1080. Соотношение сторон — это одна из пяти форм, которые вы выбираете в size (горизонтальная, вертикальная, квадратная). Если нужен 4K или голосовые референсы, используйте Vidu Q4 Preview.
Q3 Mix или Q3 Ad — что выбрать?
Интерфейс вызова практически идентичен (1–7 изображений, те же десять значений size, без аудиовхода), поэтому промпты переносятся почти как есть. Выбирайте Q3 Ad, когда задача — реклама продукта: он настроен на умный монтаж и маркетинговые движения камеры; выбирайте Q3 Mix для универсального смешивания нескольких объектов. Посекундные ставки близки, но не идентичны; смотрите страницу цен.
Почему моё смешивание игнорирует одно референсное изображение? Почти всегда это проблема привязки в промпте, а не ограничение модели. Если референсное изображение не имеет явной роли в предложении, оно конкурирует с другими и проигрывает. Дайте ему глагол и позицию («поднимает банку с референса 2») и держите конфликтующие референсы на расстоянии по масштабу.
Готовы попробовать? Откройте страницу модели vidu-q3-mix/reference-to-video, получите ключ из быстрого старта, затем вставьте рецепт выше и подставьте свои референсные URL. Хотите спланировать движение камеры в смешивании? Промпты кинематографичных движений камеры можно использовать прямо с любым из них.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков