
Guida all'uso
Ricette di prompt reference-to-video per Vidu Q3 Mix: fondere più immagini in un'unica inquadratura
Quattro prompt reference-to-video pronti da copiare e incollare, ognuno dei quali fonde 2–3 immagini separate — soggetto, scena e oggetto di scena — in una singola clip q3-mix, con l'output realmente generato su hiapi.
Riepilogo
- Quattro prompt reference-to-video pronti da copiare e incollare per vidu-q3-mix/reference-to-video, ciascuno con la clip realmente generata su hiapi — nessun materiale stock, nessuna immagine fissa spacciata per video.
- Q3 Mix è il livello di fusione multi-immagine: gli si passano da 1 a 7 immagini di riferimento (personaggi, oggetti, scene) e le combina in un'unica inquadratura dinamica. Le ricette seguenti fondono ogni volta due e tre immagini fisse.
- L'unica regola che determina se la fusione funziona: numerare le immagini di riferimento e assegnare a ciascuna un compito esplicito — "il dripper del riferimento 1 poggiato sulla caraffa di vetro del riferimento 2", mai un vago "combina questi".
- Verificato in questa esecuzione: la fusione a tre immagini (soggetto + effetto + sfondo) si compone in modo pulito, l'output ha pixel leggermente inferiori al
sizenominale, le clip sono H.264 (riproducibili direttamente nel browser, senza transcodifica) e — nonostante l'etichetta "audio nativo" — ogni clip viene restituita muta. - Copia un prompt, sostituisci i tuoi URL di riferimento ed esegui il POST su
/v1/tasks.
Perché la "fusione" è un lavoro di prompt diverso
Vidu Q3 Mix (di ShengShu) è il livello reference-to-video pensato per fondere più immagini contemporaneamente — fino a sette — combinando personaggi, oggetti e scene in un'unica clip. Se il prompt non dice al modello quale immagine fornisce cosa, questa capacità va sprecata.
Un'abitudine che distingue una fusione pulita da una confusa: numerare le immagini di riferimento e assegnare a ciascuna un compito esplicito. Scrivi "il dripper del riferimento 1 poggiato sulla caraffa di vetro del riferimento 2", non "combina queste due in una scena di caffè". Il modello associa ogni soggetto al suo indice; "combina queste" è proprio dove la fusione va fuori strada — perde un riferimento, media due soggetti in uno o incolla qualcosa con la proporzione sbagliata. L'immagine 1 è il primo URL in reference_image_urls, l'immagine 2 il secondo, e così via.
Tutto quanto segue usa questo schema. Ogni ricetta elenca le immagini fisse di riferimento esatte che ho generato, il prompt completo che ho inviato e la clip che ha prodotto su hiapi.
Ricetta 1 — Due prodotti, un'unica scena hero (fusione a due immagini)
Il classico compito di "fusione": due scatti di prodotto separati devono condividere un'unica inquadratura. Ho dato a Q3 Mix un dripper da caffè nero opaco e una caraffa di vetro vuota — due immagini, due oggetti — e ho chiesto che fossero impilati e che preparassero il caffè.
Riferimento 1 (dripper) e riferimento 2 (caraffa):
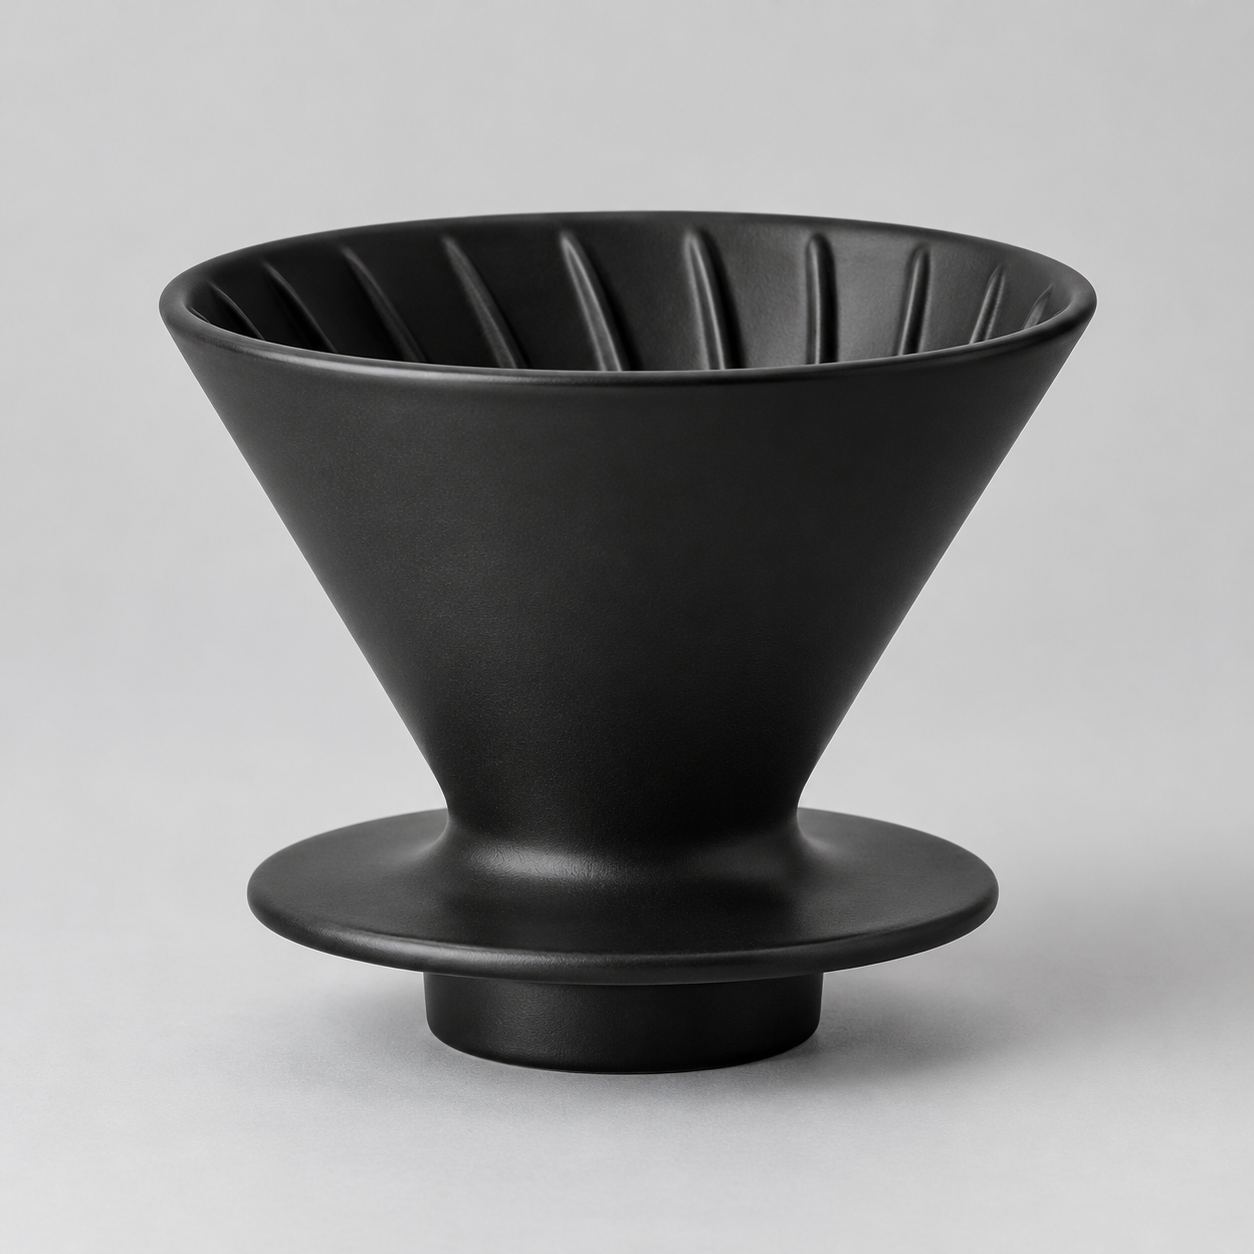
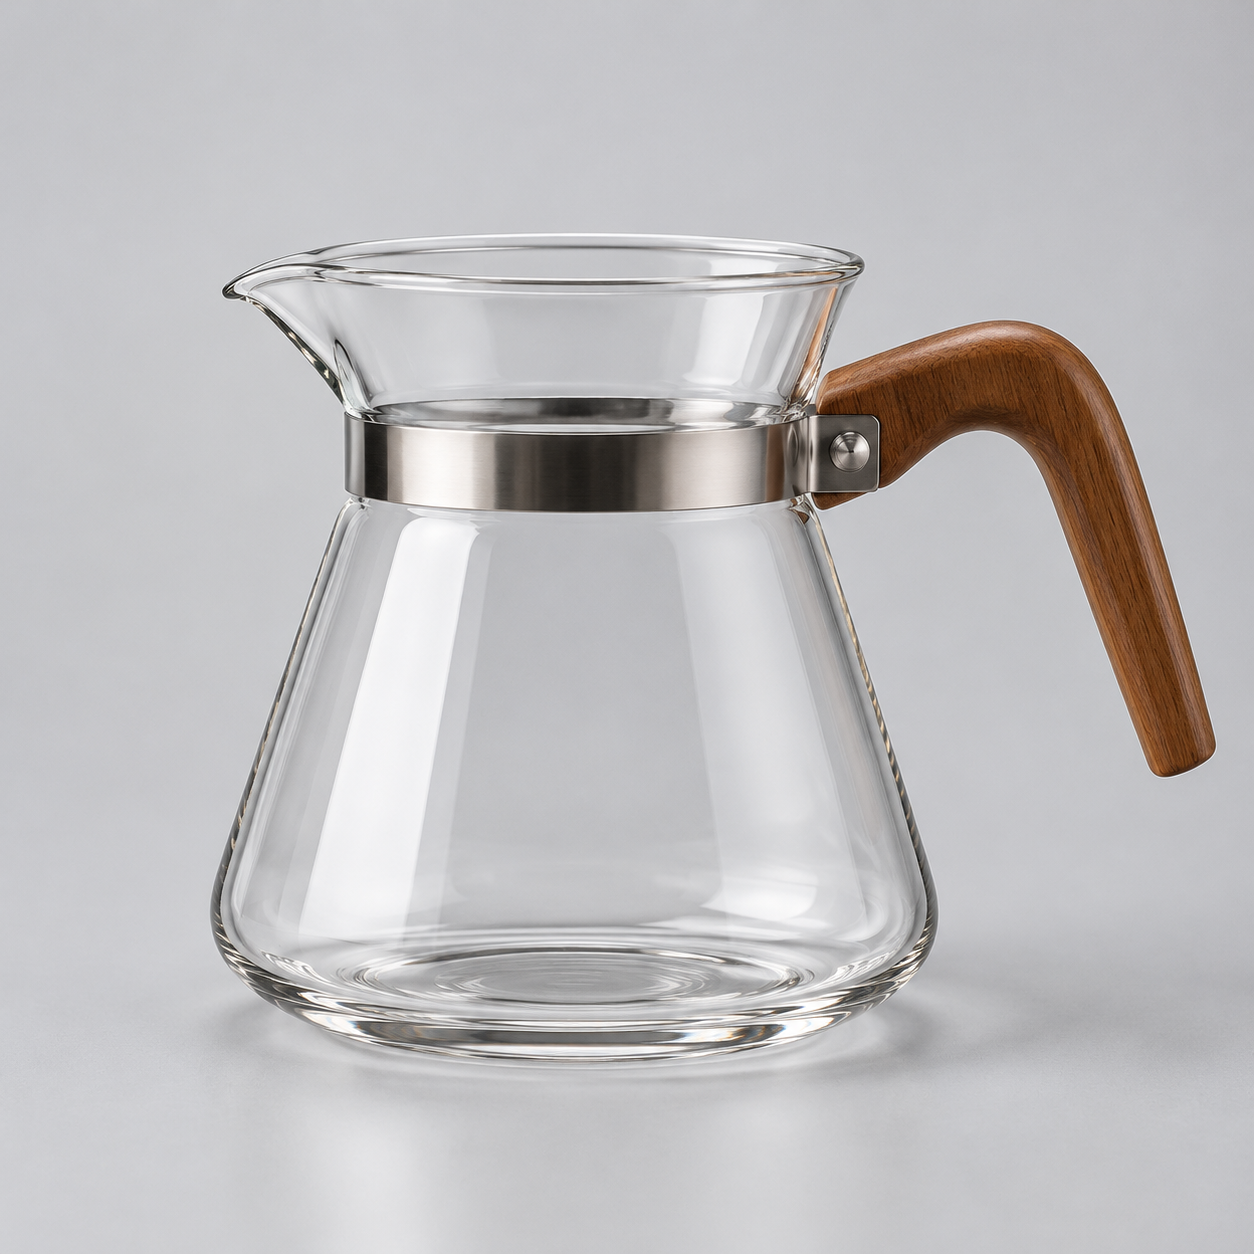
Il dripper da caffè in ceramica nera opaca del riferimento 1 poggia saldamente sopra la caraffa da caffè in vetro trasparente del riferimento 2, entrambi su un bancone da caffè in cemento chiaro. Lento push-in, un sottile filo di caffè fresco inizia a gocciolare dal dripper nella caraffa, il vapore sale arricciandosi, una calda luce mattutina entra obliqua dalla finestra a sinistra. Estetica da pubblicità di prodotto di fascia alta, profondità di campo ridotta, tenui suoni d'ambiente del caffè.
Cosa è stato fuso e cosa ha inventato il modello. Entrambi gli oggetti sono al posto giusto: il dripper dell'immagine 1 poggia sulla caraffa dell'immagine 2, con proporzioni corrette e forme molto fedeli alle immagini fisse. Tutto ciò che sta tra i due prodotti — il bancone in cemento, il caffè sfocato sullo sfondo, la luce della finestra, il caffè che si versa nella caraffa, il vapore — è stato inventato dal modello; nessuna delle due immagini di riferimento lo conteneva. Questo è il modello mentale utile per Q3 Mix: tu ancori gli oggetti, lui riempie il mondo intorno. La camera ha eseguito l'unico push-in che avevo richiesto. Renderizzato a 1920*1080 per 5 secondi; il file consegnato è 1914×1084 (vedi "sotto la dimensione nominale" più sotto), questa generazione è costata circa $0.93.
Ricetta 2 — Inserire un personaggio in una stanza tutta nuova (soggetto + scena)
La seconda fusione più comune è soggetto più ambiente: un'immagine fornisce il chi, l'altra il dove. Ho renderizzato un peluche a forma di robot su sfondo bianco puro e una camera da letto per bambini illuminata dal sole senza personaggi, poi ho chiesto al modello di inserire il primo nella seconda.
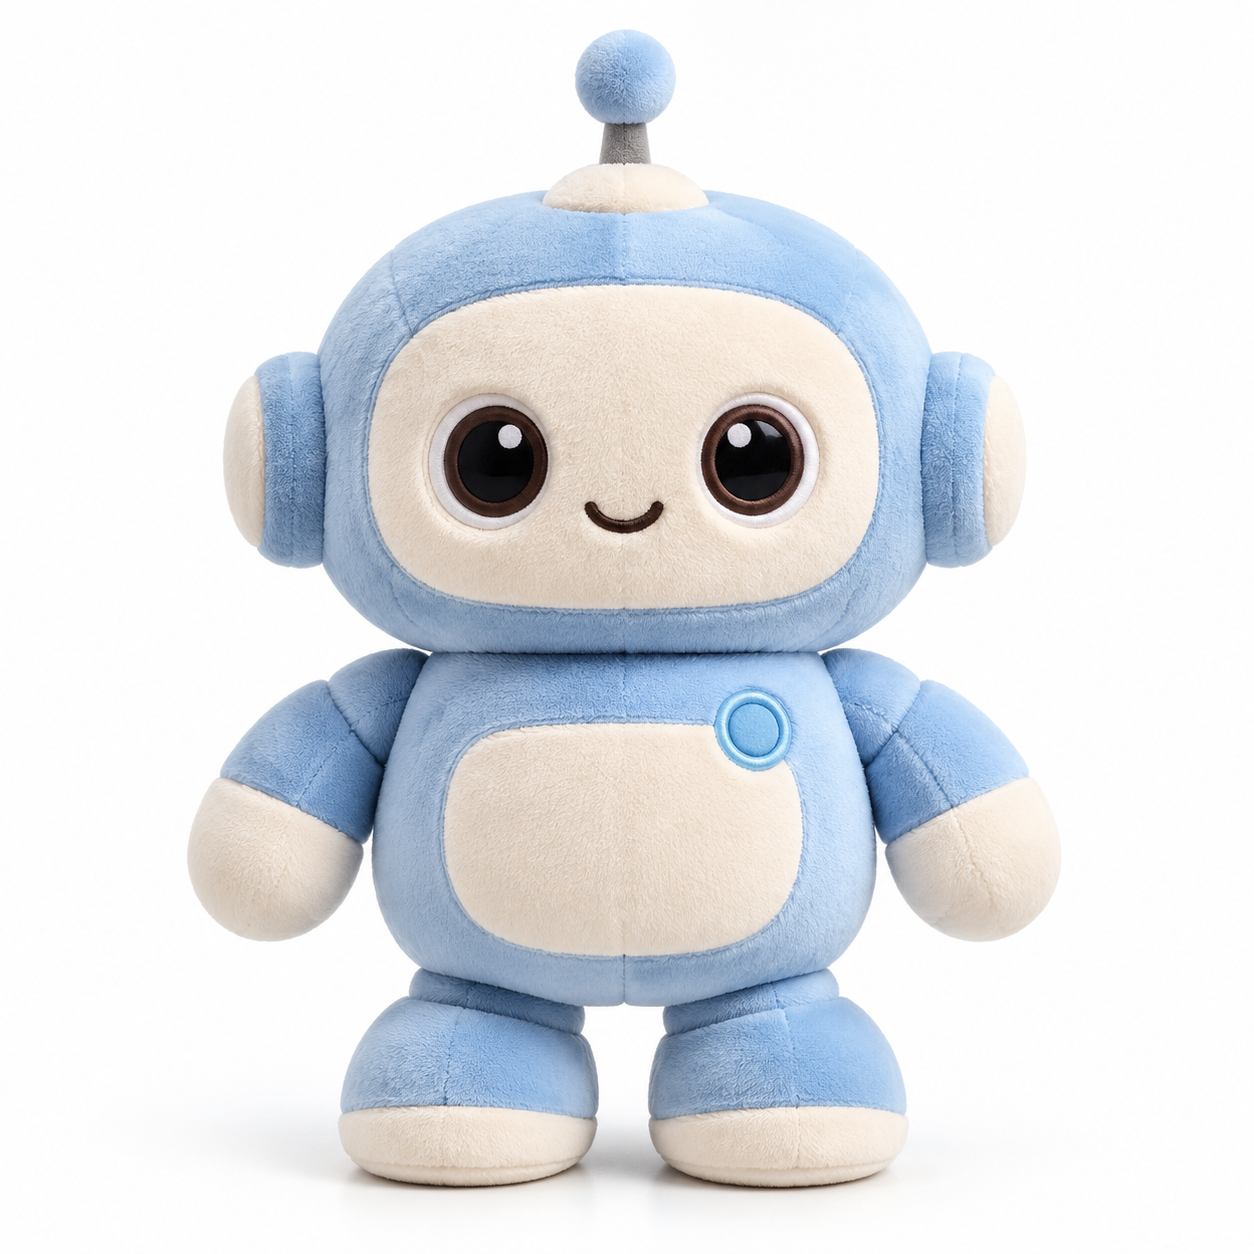
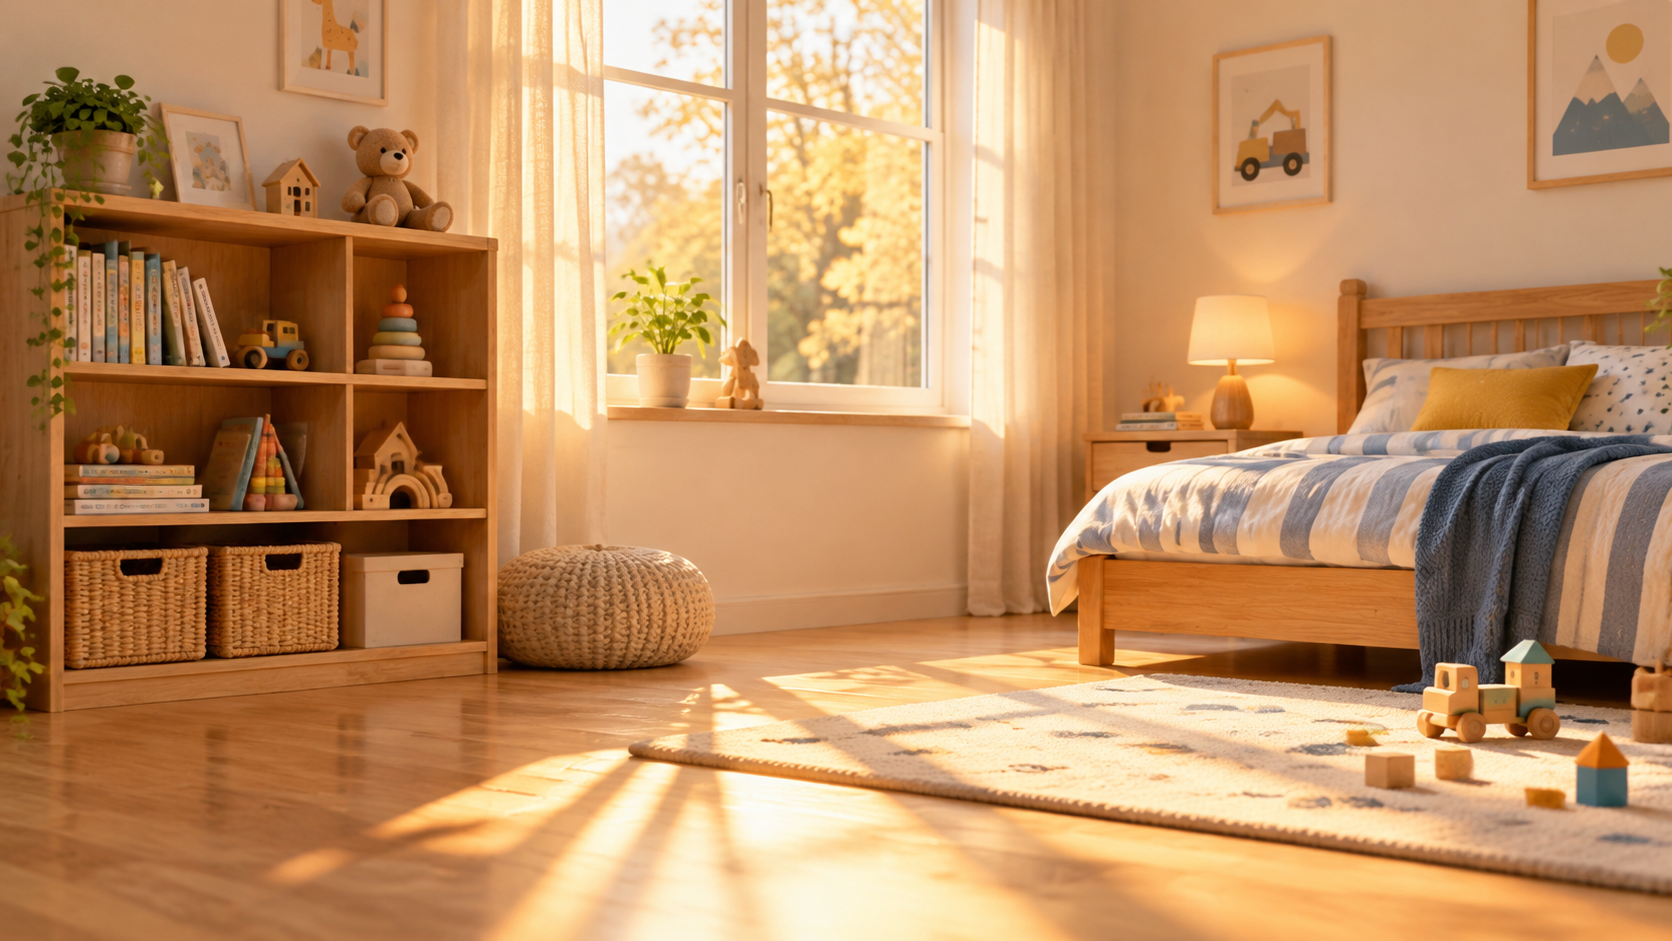
Il peluche a forma di robot azzurro del riferimento 1 è seduto sul pavimento in legno della camera da letto per bambini illuminata dal sole del riferimento 2. Inclina lentamente la testa, solleva un braccio corto e saluta verso la camera, particelle di polvere fluttuano nella calda luce della finestra, lieve push-in a mano. Morbido, allegro, cinematografico, tenui suoni d'ambiente della stanza.
Cosa è stato fuso e cosa ha inventato il modello. La camera da letto dell'immagine 2 è rimasta quasi identica — libreria, letto a righe, finestra e la sua luce, i blocchi sul tappeto sono tutti preservati nella composizione. Il robot dell'immagine 1 è stato collocato su quel pavimento e ricolorato per adattarsi alla luce calda, così sembra dentro la stanza e non incollato sopra. Ha eseguito il movimento che avevo specificato (inclinare la testa e alzare il braccio per salutare), la camera ha fatto il push-in a mano. Questo è lo schema "personaggio in scena": lascia che un'immagine di riferimento porti l'intero ambiente, e il modello ricolorerà il soggetto per adattarlo all'ambiente. 1280*720, 5 secondi, circa $0.78.
Ricetta 3 — Tre immagini, un'unica inquadratura: soggetto + effetto + sfondo
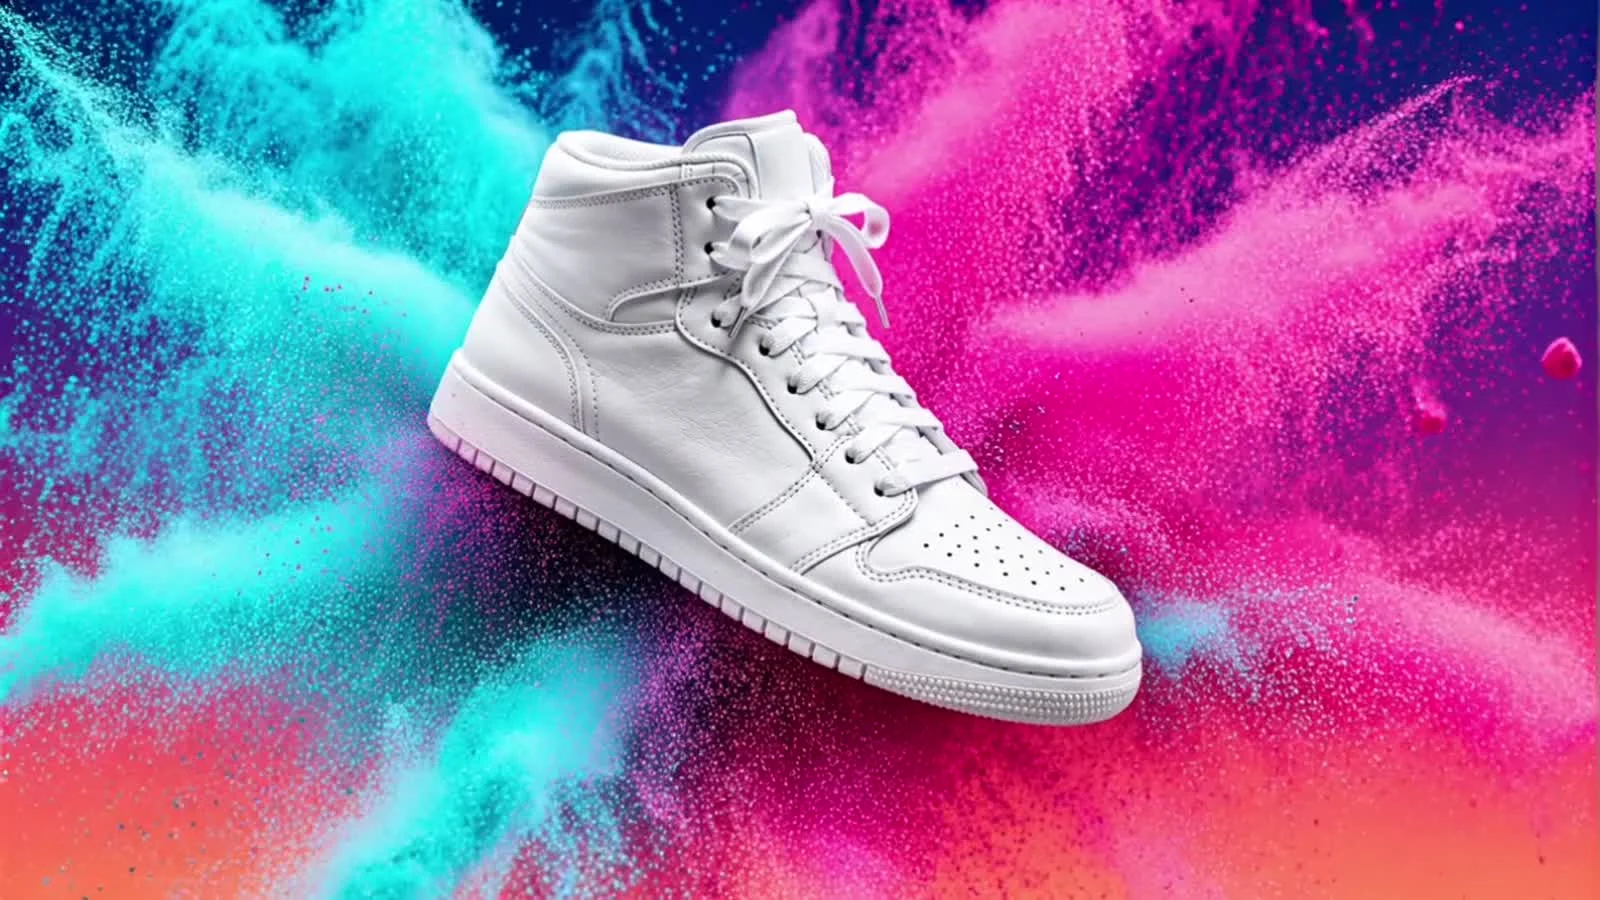
Questa ricetta dimostra il nome "fusione". Tre immagini fisse separate — una sneaker, un'esplosione di polvere colorata e uno sfondo sfumato — ognuna con un compito nettamente diverso, fuse in un vivace scatto di prodotto.
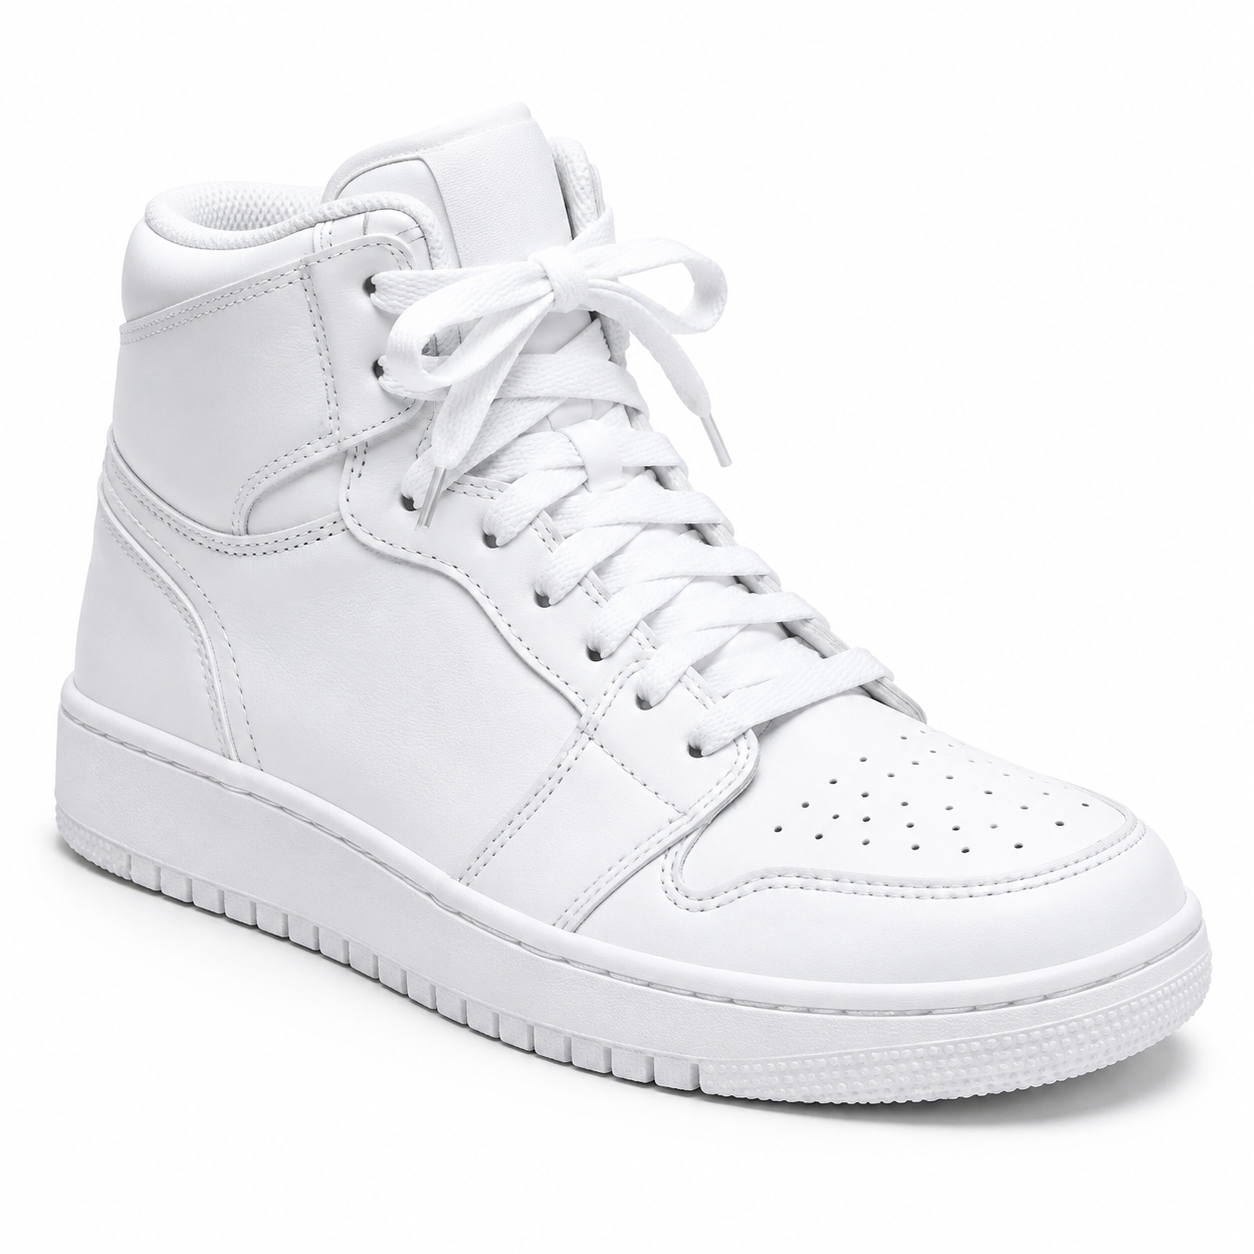
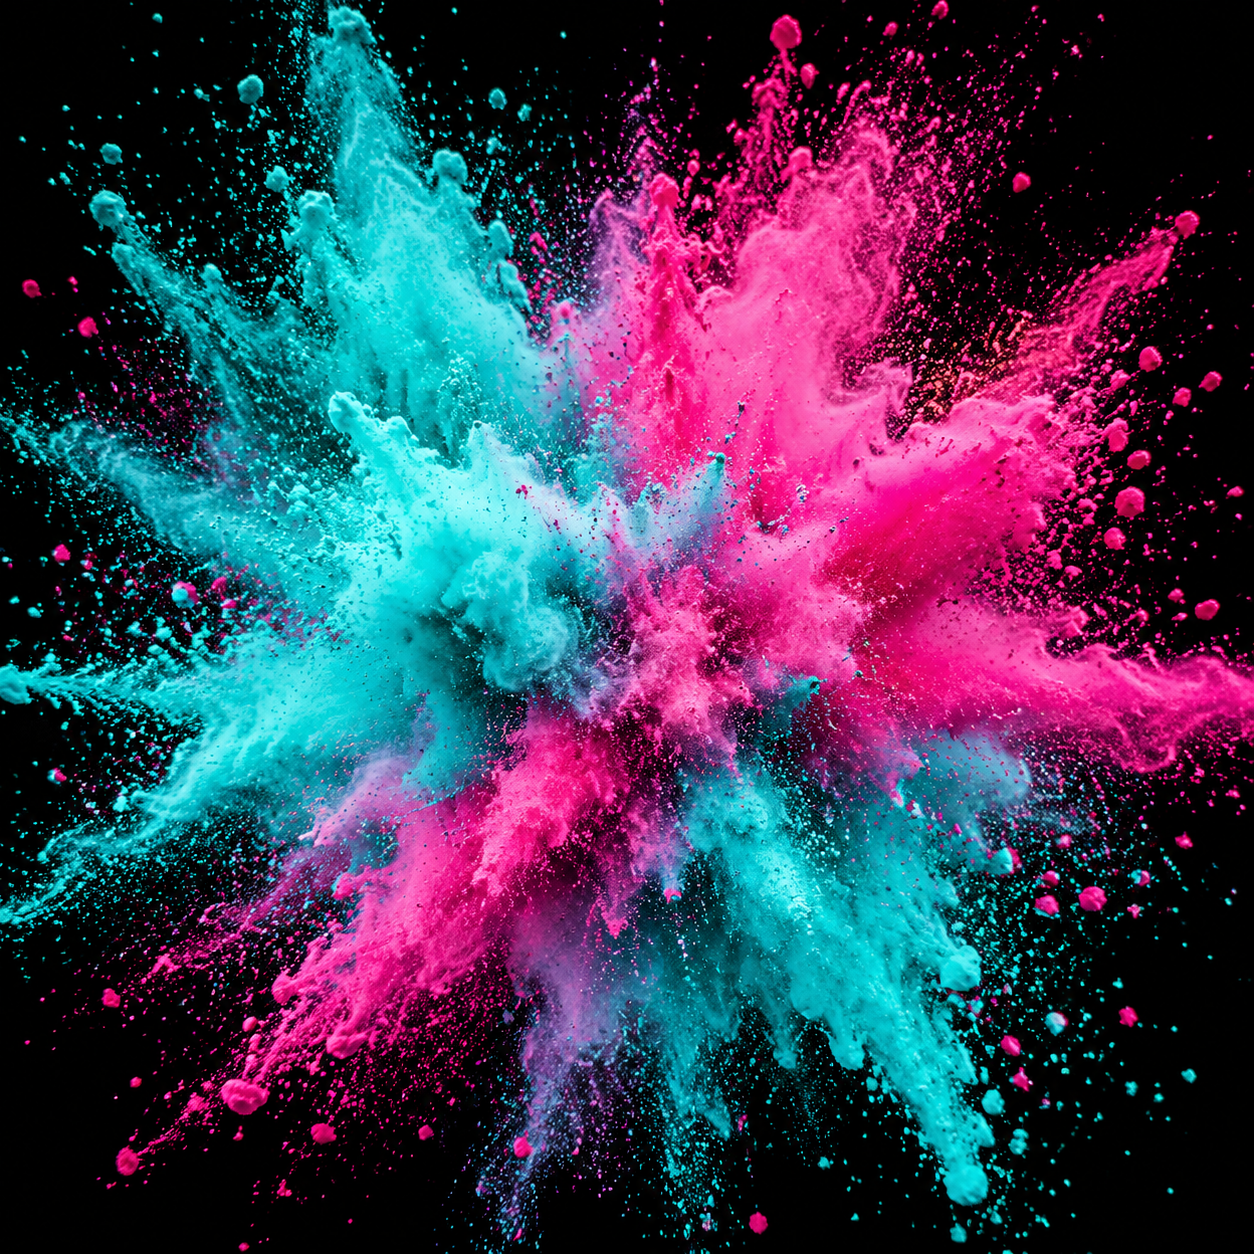
La sneaker alta bianca del riferimento 1 fluttua al centro, sullo sfondo sfumato da indaco a corallo del riferimento 3, mentre la polvere turchese e magenta del riferimento 2 esplode verso l'esterno in slow motion. La camera compie un arco di quarantacinque gradi attorno alla scarpa, le scie di polvere ruotano e ricadono. Vivace pubblicità di sneaker, illuminazione da studio drammatica, forte sibilo.
Cosa è stato fuso e cosa ha inventato il modello. Tutte e tre le immagini di riferimento compaiono e mantengono il proprio ruolo: la sneaker è il soggetto, la polvere turchese e magenta è l'effetto che la avvolge, la sfumatura da indaco a corallo è inequivocabilmente lo sfondo. L'arco di camera che avevo richiesto è visibile — la scarpa ruota rispetto all'inquadratura nell'arco dei cinque secondi. Il motivo per cui tre immagini riescono a restare insieme qui, dove un prompt più vago le confonderebbe: ogni immagine di riferimento assume un compito non sovrapposto nella frase (soggetto / effetto / sfondo), e io le referenzio per indice, anche citando lo sfondo fuori ordine come "immagine 3". Oltre tre o quattro immagini di riferimento questa disciplina non è più opzionale — assegna a ogni immagine un compito esplicito, oppure il modello scarta silenziosamente la più debole. 1280*720, 5 secondi, circa $0.78. (Questo fotogramma è la copertina dell'articolo.)
Ricetta 4 — Verticale per i social: una mascotte presenta il prodotto
L'ultima è una fusione 9:16 pensata per i social: un'immagine è la mascotte del marchio, l'altra è il prodotto che deve vendere. Il compito è far tenere il prodotto al personaggio, in verticale, pronto per il feed.
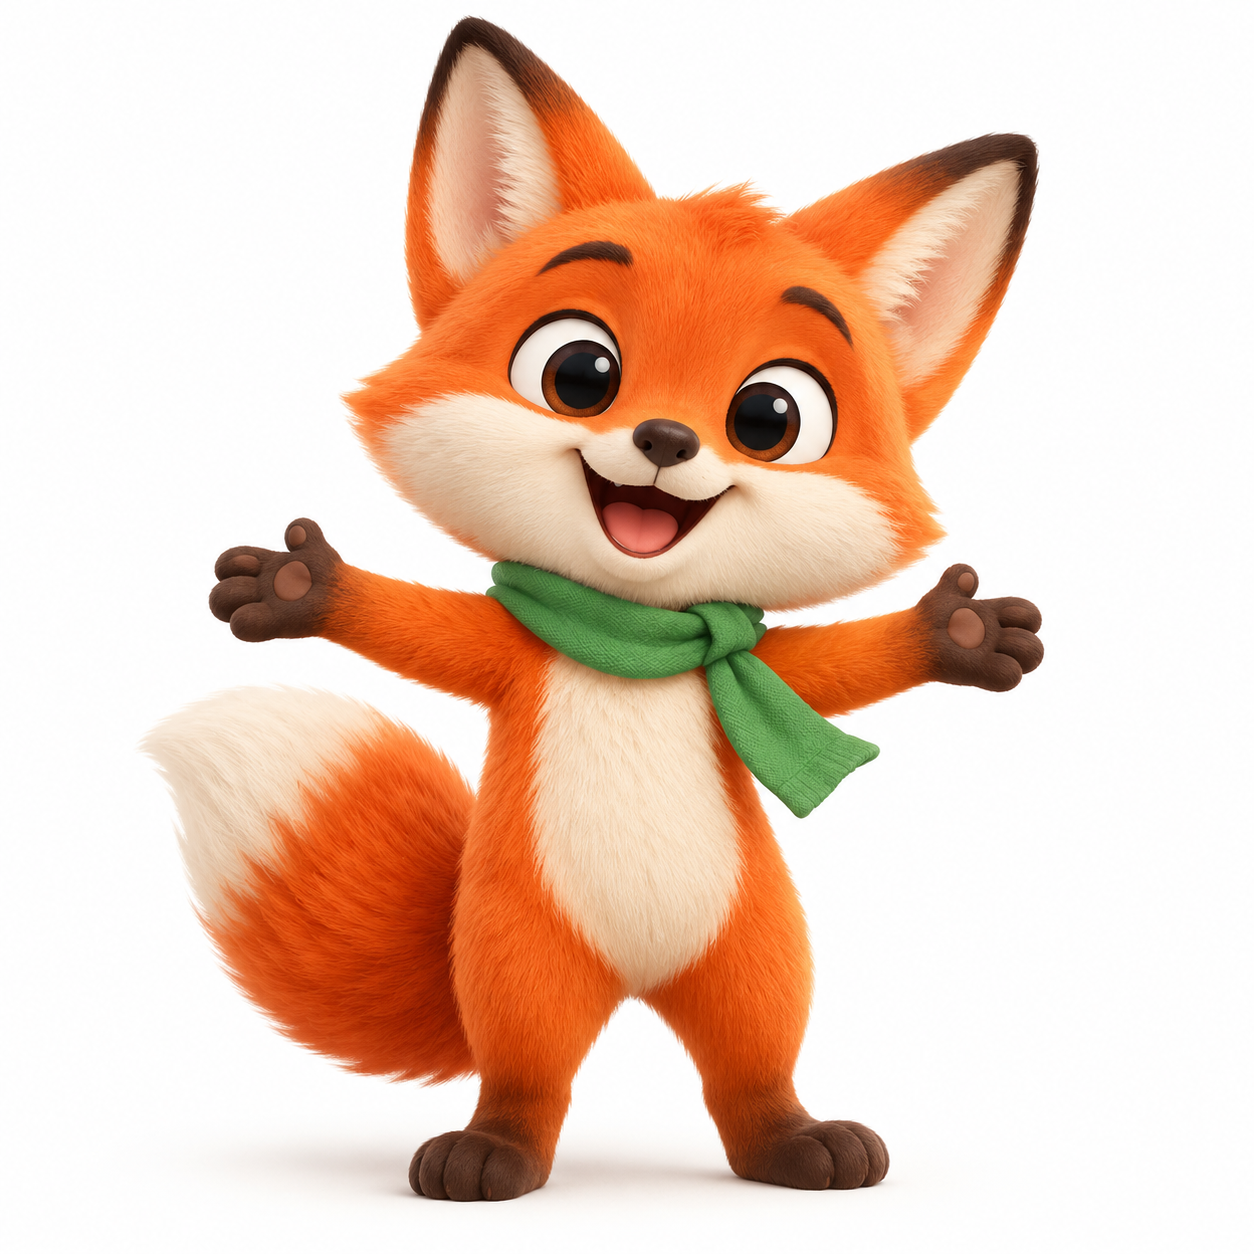
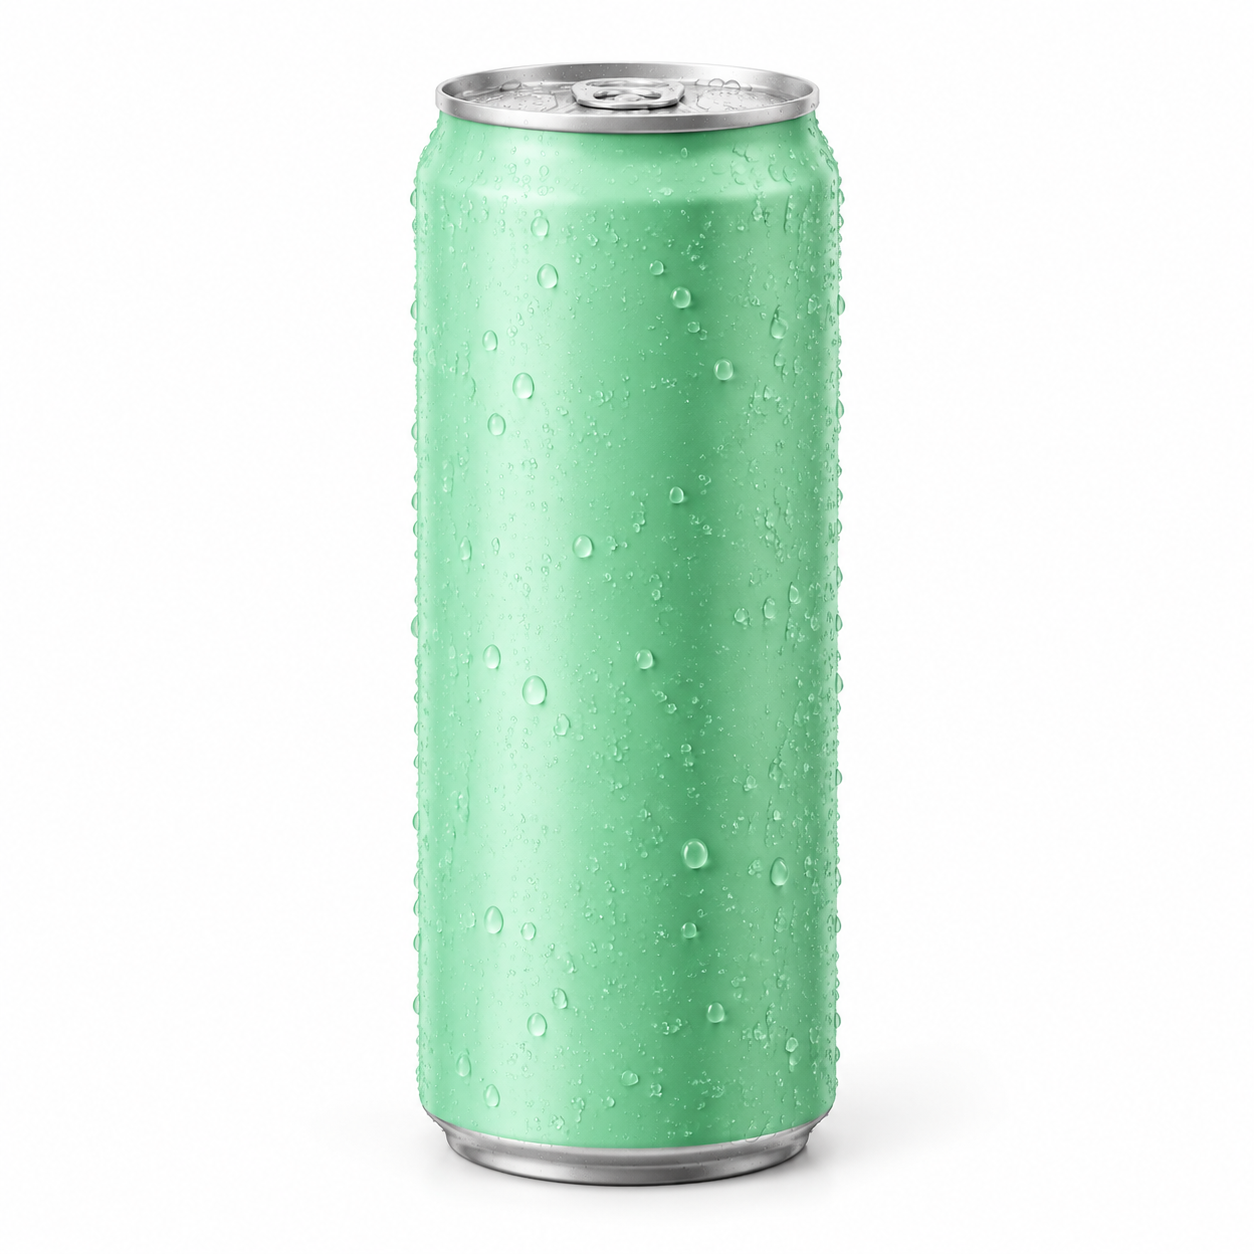
Inquadratura verticale. La mascotte volpe arancione dei cartoni animati del riferimento 1 solleva la lattina di acqua frizzante verde menta del riferimento 2, mostrandola alla camera con un piccolo balzo allegro, sfondo da studio dai colori pop brillanti, coriandoli che cadono. Giocosa pubblicità social, illuminazione energica e allegra, vivaci suoni di bollicine.
Cosa è stato fuso e cosa ha inventato il modello. La volpe mantiene il design dell'immagine 1 (pelo arancione, sciarpa verde, occhi grandi), la lattina mantiene la superficie verde menta opaca dell'immagine 2, le zampe del personaggio la avvolgono — il verbo "solleva... mostrando alla camera" lega le due immagini di riferimento in un'unica azione, invece di due oggetti che condividono l'inquadratura. Lo sfondo pop e i coriandoli sono inventati. Scegli un size verticale (720*1280) per renderla verticale; non esiste un campo aspect_ratio (vedi sotto). 4 secondi, circa $0.62.
Cosa ho imparato dopo aver eseguito queste ricette
Cinque cose che vale la pena sapere prima di spendere crediti, tutte emerse da questo ciclo di test:
- Il legame per indice è la chiave. Ogni clip qui ha rispettato "X del riferimento N". Quando vuoi che due soggetti interagiscano, dai all'azione un verbo che li collega ("solleva", "poggia su"), invece di elencarli affiancati.
- Tu ancori gli oggetti; il modello inventa il tessuto connettivo. Il bancone, la luce dell'intera stanza, i coriandoli, la polvere rotante — nessuno di questi era nelle immagini di riferimento. Per "soggetto in scena" questo è un pregio, ma significa anche che qualsiasi cosa tu debba preservare deve venire dall'immagine di riferimento.
- I pixel consegnati sono leggermente inferiori al
sizenominale.1920*1080restituisce 1914×1084,1280*720restituisce 1276×722,720*1280restituisce 722×1276. Abbastanza vicino per il web, ma non codificare le dimensioni esatte a valle. - Output H.264, pronti da incorporare. A differenza del livello 4K che consegna HEVC, queste clip si riproducono direttamente inline, senza ricodifica — ogni video di questa pagina è il file restituito direttamente dall'API.
- L'"audio nativo" non ha prodotto audio. Tutte e quattro le clip sono tornate come MP4 muti, solo video — nonostante il modello abbia l'etichetta "audio nativo" e i miei prompt contengano indizi sonori ("tenui suoni d'ambiente del caffè", "forte sibilo"). Anche le clip di esempio di Q3 Mix della piattaforma sono mute. Programma di aggiungere l'audio in post-produzione, oppure, se la traccia vocale è irrinunciabile, usa un livello con input audio esplicito — la ricetta Vidu Q4 Preview copre il flusso di lavoro con riferimento vocale.
Riprodurre qualsiasi ricetta con /v1/tasks
Il reference-to-video funziona tramite l'API asincrona a task: invia il task, esegui il polling finché lo stato non è success, poi scarica la clip da output[0].url (l'URL scade rapidamente — salva subito il file).
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-mix/reference-to-video",
    "input": {
      "prompt": "Il dripper del riferimento 1 poggia sulla caraffa del riferimento 2...",
      "reference_image_urls": [
        "https://your-host/dripper.png",
        "https://your-host/carafe.png"
      ],
      "duration": 5,
      "size": "1920*1080"
    }
  }'
# -> {"data":{"taskId":"tk-..."}}   poi GET /v1/tasks/tk-... finché status == "success"
import requests, time

H = {"Authorization": f"Bearer {TOKEN}"}
job = requests.post("https://api.hiapi.ai/v1/tasks", headers=H, json={
    "model": "vidu-q3-mix/reference-to-video",
    "input": {"prompt": PROMPT, "reference_image_urls": REFS,
              "duration": 5, "size": "1920*1080"},
}).json()["data"]["taskId"]

while True:
    t = requests.get(f"https://api.hiapi.ai/v1/tasks/{job}", headers=H).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("clip.mp4", "wb").write(requests.get(t["output"][0]["url"]).content)
Regole dei campi da conoscere prima di copiare le ricette:
reference_image_urlsaccetta da 1 a 7 immagini. Un'ottava restituisce400 maxItems: want 7.durationè un numero intero, da 1 a 16 secondi. Valori decimali come4.5o99vengono rifiutati al momento dell'invio.- La forma è impostata da
size, non daaspect_ratio— passareaspect_ratio(oresolution) restituisce400 additional properties not allowed. I dieci valori disizesono cinque proporzioni su due livelli, 720 e 1080; per il verticale scegli il valore verticale, per il 16:9 quello orizzontale. - Nessun campo di riferimento audio —
reference_audio_urlsviene rifiutato. Se ti serve pilotare la voce con un campione audio, quello è il livello Q4 Preview, non Q3 Mix. - La tariffa al secondo (livello 720 vs 1080) è sulla pagina dei prezzi; le quattro clip qui costano ciascuna circa $0.62–$0.93. Itera la composizione prima sul livello 720 di
size, poi ri-esegui la versione finale a 1080.
Domande frequenti
Quante immagini di riferimento può fondere Q3 Mix? Da una a sette. Due è il caso comune (soggetto + scena); tre si compongono ancora in modo pulito, purché ogni immagine abbia un ruolo nettamente distinto, come nella ricetta della sneaker qui sopra. Oltre quattro, assegna a ogni immagine di riferimento un compito esplicito e non sovrapposto, altrimenti il modello inizia a scartare la più debole.
Come si controlla quale immagine è il soggetto e quale lo sfondo?
Referenziale per indice e assegna i ruoli nella stessa frase: "la sneaker del riferimento 1... sullo sfondo del riferimento 3". L'ordine degli URL in reference_image_urls è l'ordine degli indici — l'immagine 1 è il primo URL.
Q3 Mix aggiunge audio automaticamente? Nei miei test no. Nonostante l'etichetta "audio nativo", tutte e quattro le clip — e anche gli esempi di Q3 Mix della piattaforma — sono tornate come MP4 muti, anche con termini sonori nel prompt. Considera Q3 Mix un generatore solo video, aggiungi l'audio in post-produzione oppure passa a un livello con input audio esplicito.
Si può ottenere il 4K o proporzioni personalizzate?
Niente 4K — Q3 Mix arriva al massimo ai valori di size di livello 1080. La proporzione è una delle cinque forme che scegli in size (orizzontale, verticale, quadrata). Per il 4K o i riferimenti vocali usa Vidu Q4 Preview.
Q3 Mix o Q3 Ad — quale scegliere?
L'interfaccia di chiamata è quasi identica (1–7 immagini, gli stessi dieci valori di size, nessun input audio), quindi i prompt si trasferiscono quasi così come sono. Scegli Q3 Ad quando l'esigenza è una pubblicità di prodotto — è ottimizzato per montaggio intelligente e movimenti di camera da marketing; scegli Q3 Mix per la fusione generica di più soggetti. La tariffa al secondo è vicina ma non identica; consulta la pagina dei prezzi.
Perché la mia fusione ignora un'immagine di riferimento? Quasi sempre è un problema di legame nel prompt, non un limite del modello. Se un'immagine di riferimento non ha un ruolo esplicito nella frase, entra in competizione con le altre e perde. Dagli un verbo e una posizione ("solleva la lattina del riferimento 2") e mantieni i riferimenti in conflitto ben distanti per proporzioni.
Pronto a provare? Apri la pagina del modello vidu-q3-mix/reference-to-video, ottieni una chiave dalla guida rapida, poi incolla una delle ricette qui sopra e sostituisci con i tuoi URL di riferimento. Vuoi pianificare il movimento di camera in una fusione? I prompt per movimenti di camera cinematografici si integrano direttamente in qualsiasi di queste ricette.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori