
使用指南
Vidu Q3 Mix 参考生视频提示词配方:将多张图片融合为单个镜头
四个可直接复制粘贴的参考生视频提示词,每个提示词将 2–3 张独立图片——主体、场景和道具——混合成一个 q3-mix 片段,并附上它在 hiapi 上真实生成的输出。
摘要
- 四个可直接复制粘贴的 参考生视频 提示词,用于 vidu-q3-mix/reference-to-video,每个都附上它在 hiapi 上真实生成的片段——没有库存素材,也没有用单张静止画面代替视频。
- Q3 Mix 是 多图混合 层级:给它 1–7 张参考图片(角色、物体、场景),它就会把它们组合成一个动态镜头。以下配方每次混合 两张和三张静止图。
- 决定混合是否成立的一条规则:给参考图编号,并给每张图分配明确任务——“来自参考图 1 的滤杯放在来自参考图 2 的玻璃壶上”,绝不能模糊地说“把这些组合起来”。
- 本次运行验证:三图混合(主体 + 效果 + 背景)能够干净地合成,输出像素略低于标称
size,片段为 H.264(可直接在浏览器播放,无需转码),并且——尽管带有“原生音频”标签——每个片段返回时都是静音的。 - 复制一个提示词,替换成你自己的参考 URL,然后 POST 到
/v1/tasks。
为什么“混合”是一种不同的提示词工作
Vidu Q3 Mix(来自 ShengShu)是参考生视频层级,专门用于同时混合多张图片——最多七张,将角色、物体和场景混合成一个片段。如果提示词没有告诉模型哪张图片提供什么内容,这种能力就会被浪费。
区分干净混合与浑浊混合的一个习惯:给参考图编号,并给每张图分配明确任务。写“来自参考图 1 的滤杯放在来自参考图 2 的玻璃壶上”,而不是“把这两张组合成一个咖啡场景”。模型会将每个主体绑定到其索引;“组合这些”正是混合发生偏移的地方——它会丢失一张参考图、将两个主体平均成一个,或以错误比例粘贴某物。图 1 是 reference_image_urls 中的第一个 URL,图 2 是第二个,依此类推。
以下所有内容都使用这种模式。每个配方都列出我生成的确切参考静止图、我提交的完整提示词,以及它在 hiapi 上生成的片段。
配方 1 — 两个产品,一个主视觉场景(双图混合)
经典的“混合”任务:两个独立的产品镜头需要共享一个画面。我给 Q3 Mix 一个哑光黑色手冲滤杯和一个空玻璃壶——两张图片,两个物体——并要求它们叠放并冲泡。
参考图 1(滤杯)和 参考图 2(玻璃壶):
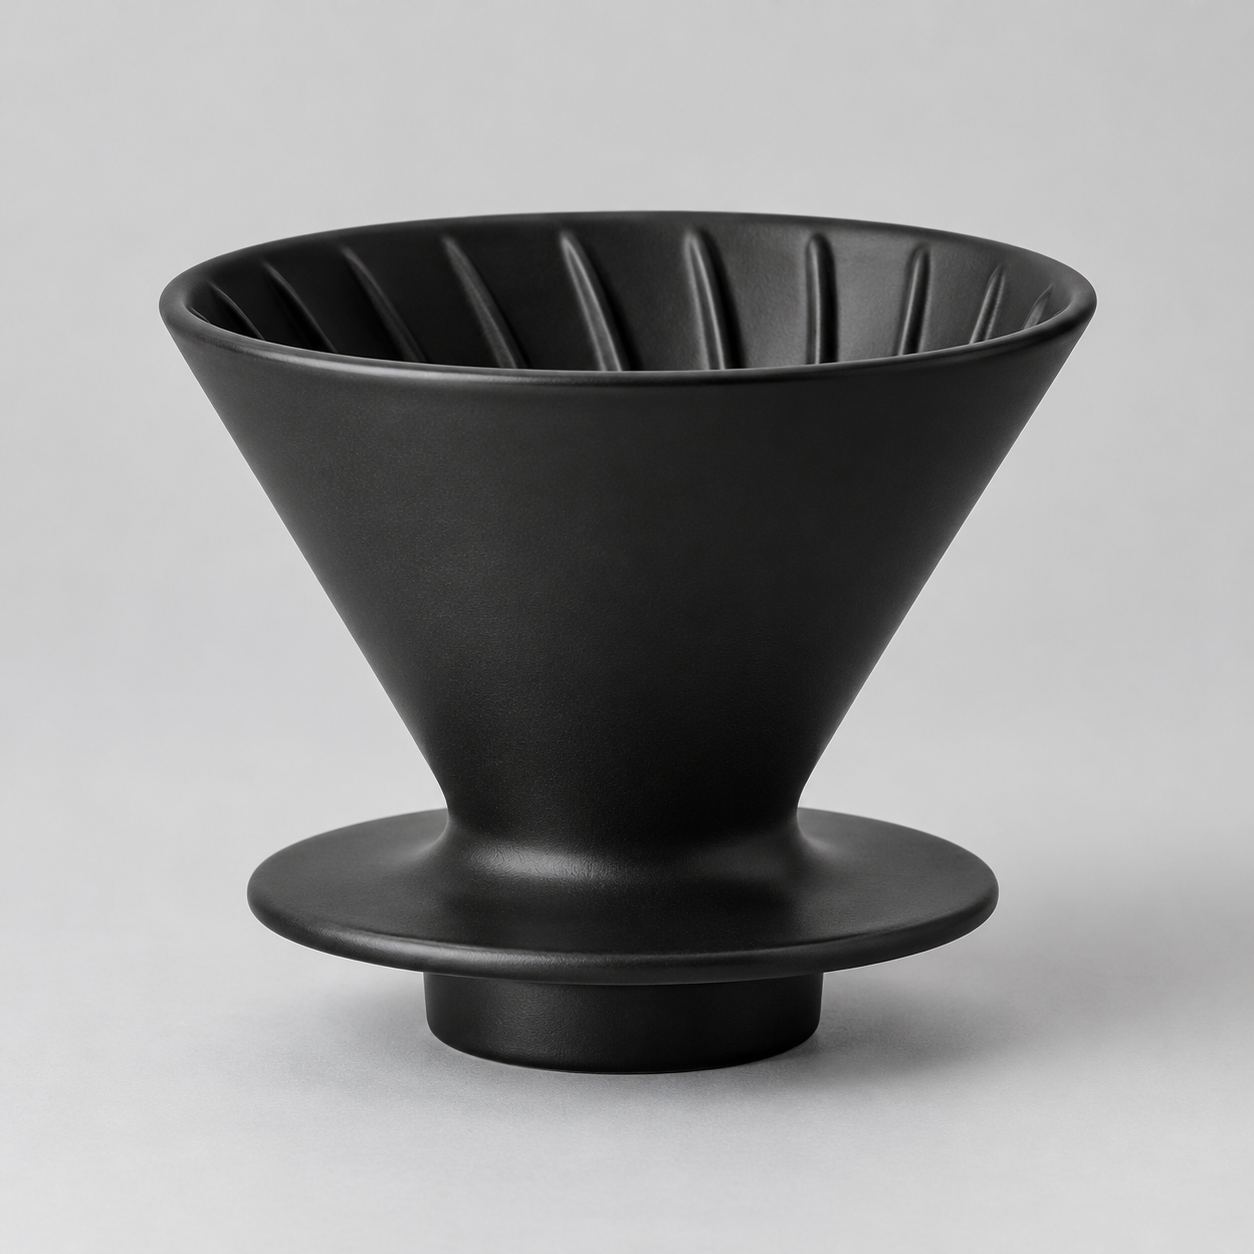
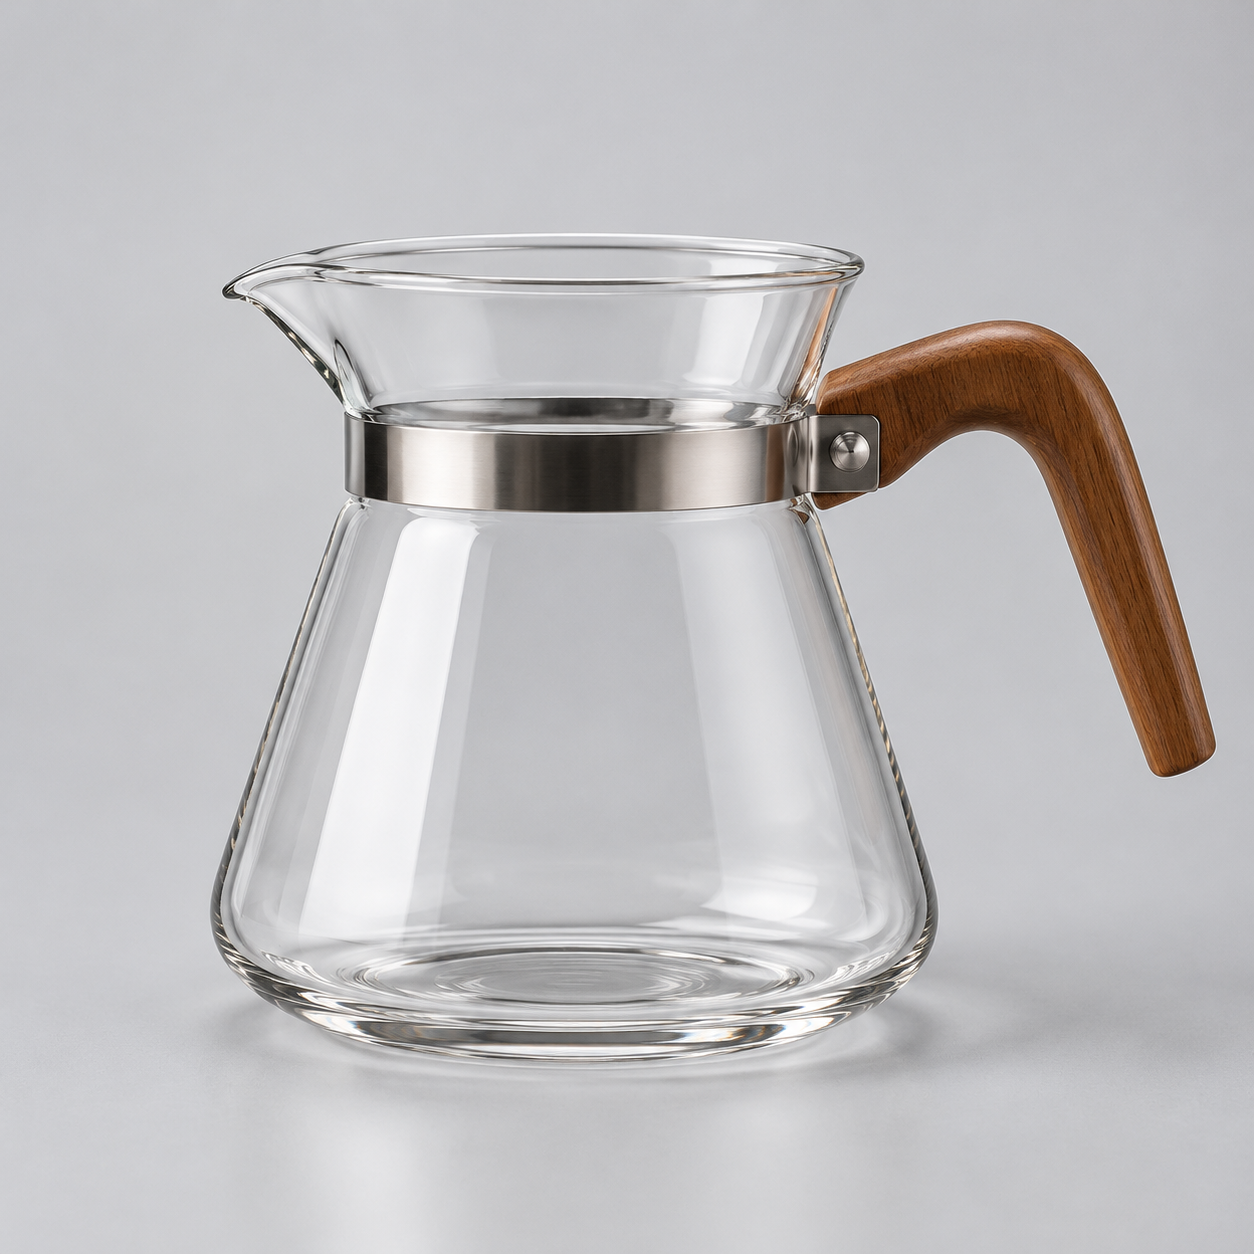
来自参考图 1 的哑光黑色陶瓷手冲滤杯平稳地放在来自参考图 2 的透明玻璃咖啡壶顶部,两者一起置于浅色混凝土咖啡馆台面上。缓慢推近镜头,一股细流的新鲜咖啡开始从滤杯滴入壶中,蒸汽向上卷曲,温暖的晨光从左侧窗户斜射进来。高端产品广告质感,浅景深,轻柔的咖啡馆环境声。
哪些内容被混合了,模型又发明了什么。两个物体都正确落位:来自图 1 的滤杯坐在来自图 2 的玻璃壶上,相对比例正确,形状与静止图高度吻合。两个产品之间的一切——混凝土台面、后方失焦的咖啡馆、窗户光线、注入壶中的咖啡、蒸汽——都由模型发明;两张参考图都不包含这些内容。这就是 Q3 Mix 有用的心理模型:你锚定物体,它填充周围的世界。摄像机完成了我要求的单次推近。以 1920*1080 渲染 5 秒;交付文件为 1914×1084(见下文“低于标称尺寸”),这次生成花费约 $0.93。
配方 2 — 将角色放入全新房间(主体 + 场景)
第二种常用混合是主体加环境:一张图片负责谁,另一张负责哪里。我渲染了一个纯白背景上的毛绒机器人玩具,以及一个没有角色的阳光儿童卧室,然后要求模型将前者放入后者。
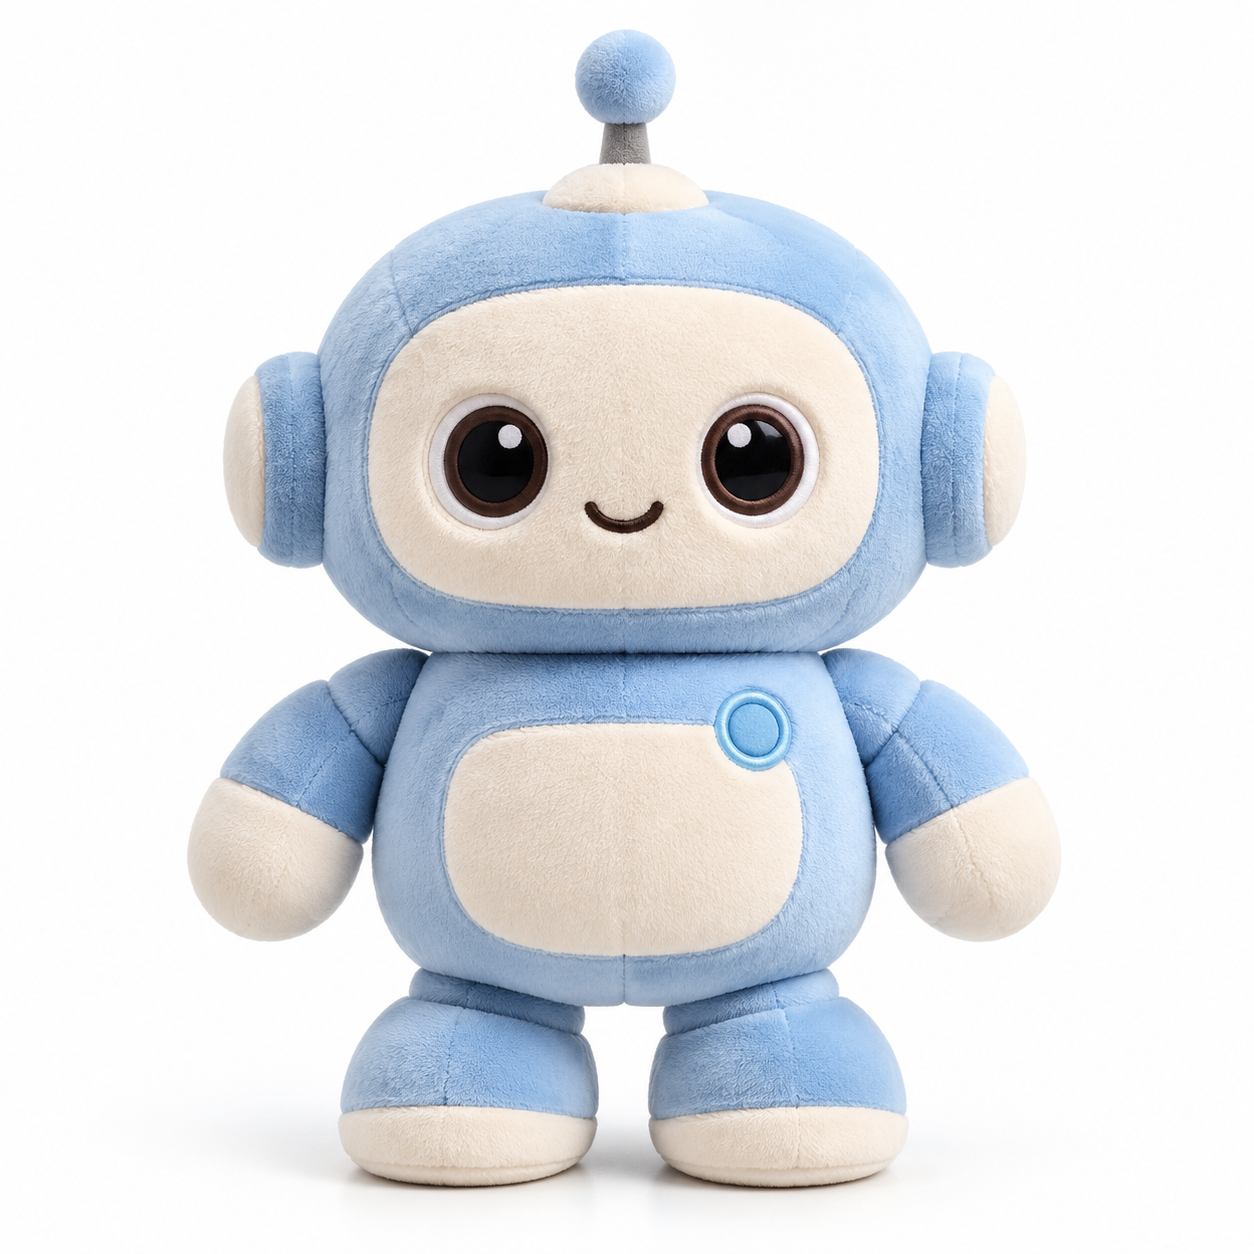
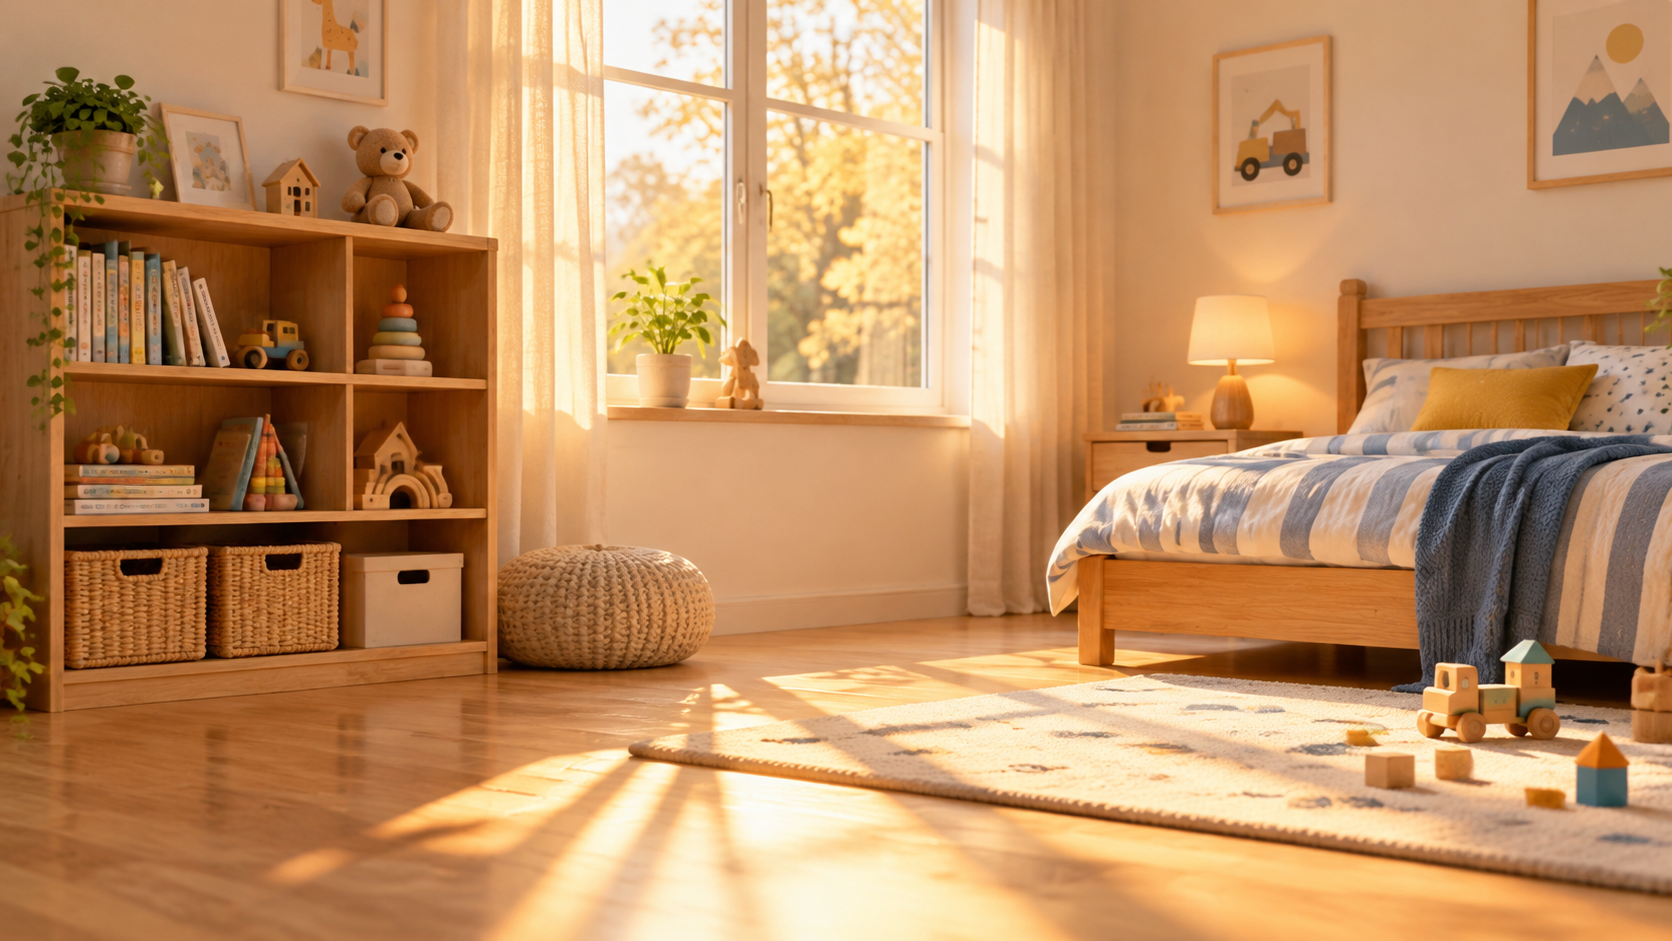
来自参考图 1 的淡蓝色毛绒机器人玩具坐在来自参考图 2 的阳光儿童卧室的木地板上。它缓慢歪头,抬起一只短手臂朝镜头挥手,尘埃微粒在温暖的窗光中飘动,轻柔的手持推近镜头。柔和、欢快、电影感,轻微的房间环境声。
哪些内容被混合了,模型又发明了什么。来自图 2 的卧室几乎原样保留——书架、条纹床、窗户及其光线、地毯上的积木都在合成中保留下来。来自图 1 的机器人被放入那个地板,并匹配暖色光线,因此它看起来是在房间里,而不是被贴上去。它执行了我指定的动作(歪头和抬臂挥手),摄像机完成了手持推近。这是“角色置于场景”的模式:让一张参考图承载整个环境,模型会为匹配环境而重新打光主体。1280*720,5 秒,约 $0.78。
配方 3 — 三张图片,一个镜头:主体 + 效果 + 背景
这个配方证明了“混合”之名。三张独立静止图——一只运动鞋、一次彩色粉末爆发和一个渐变背景——每张都有明显不同的任务,混合成一个充满活力的产品镜头。
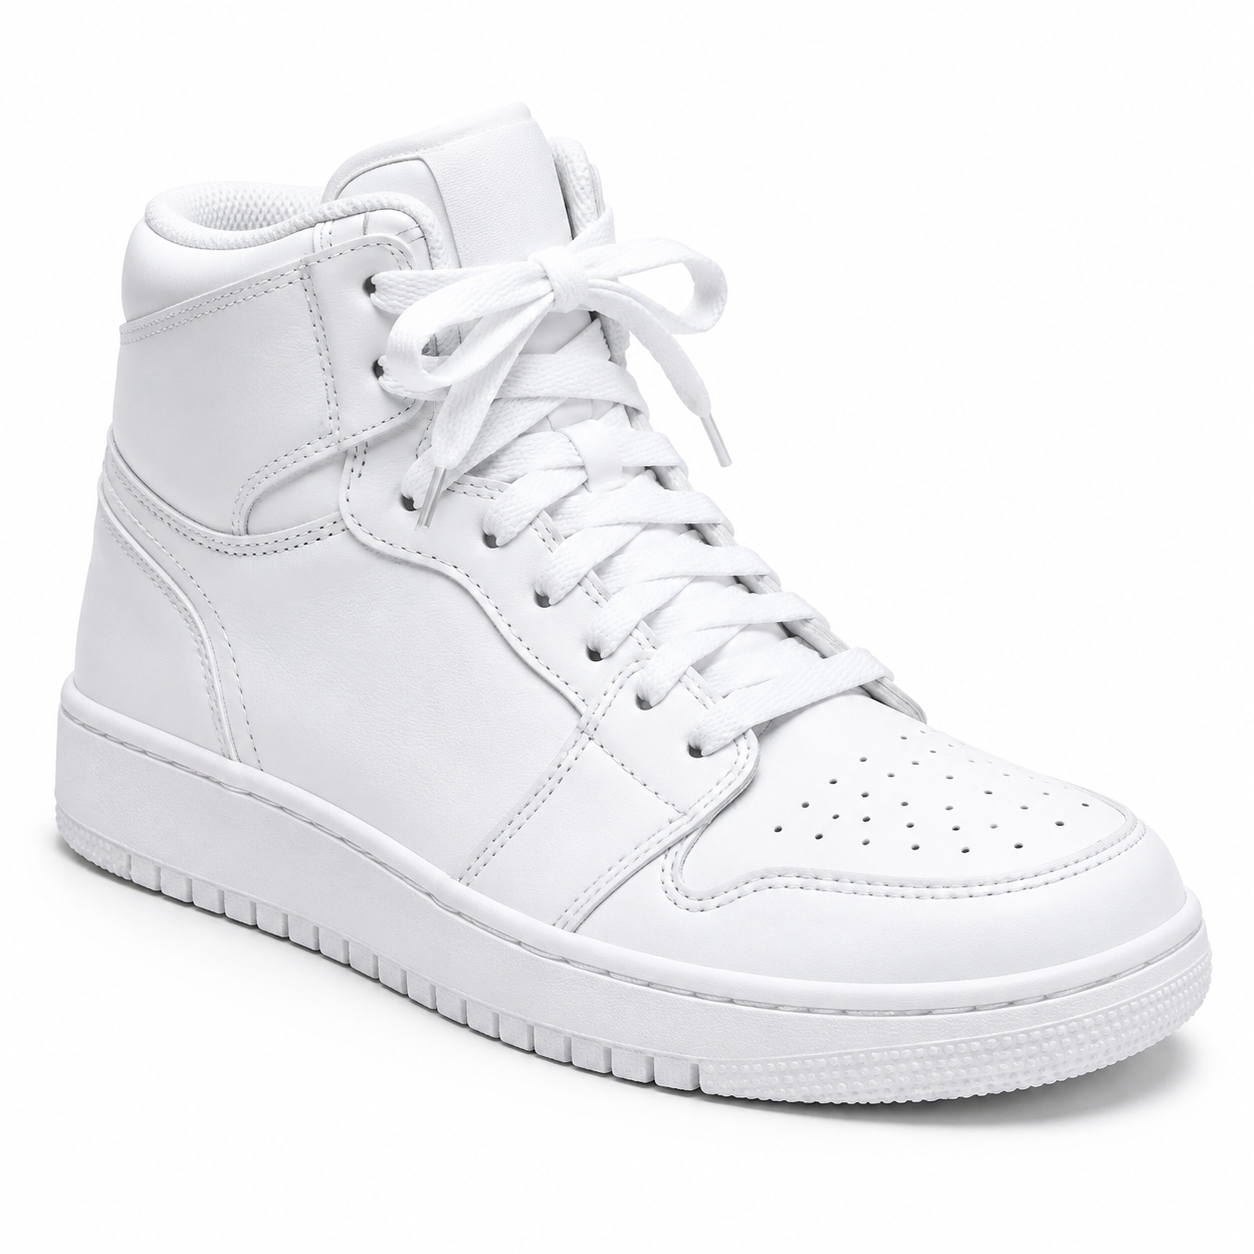
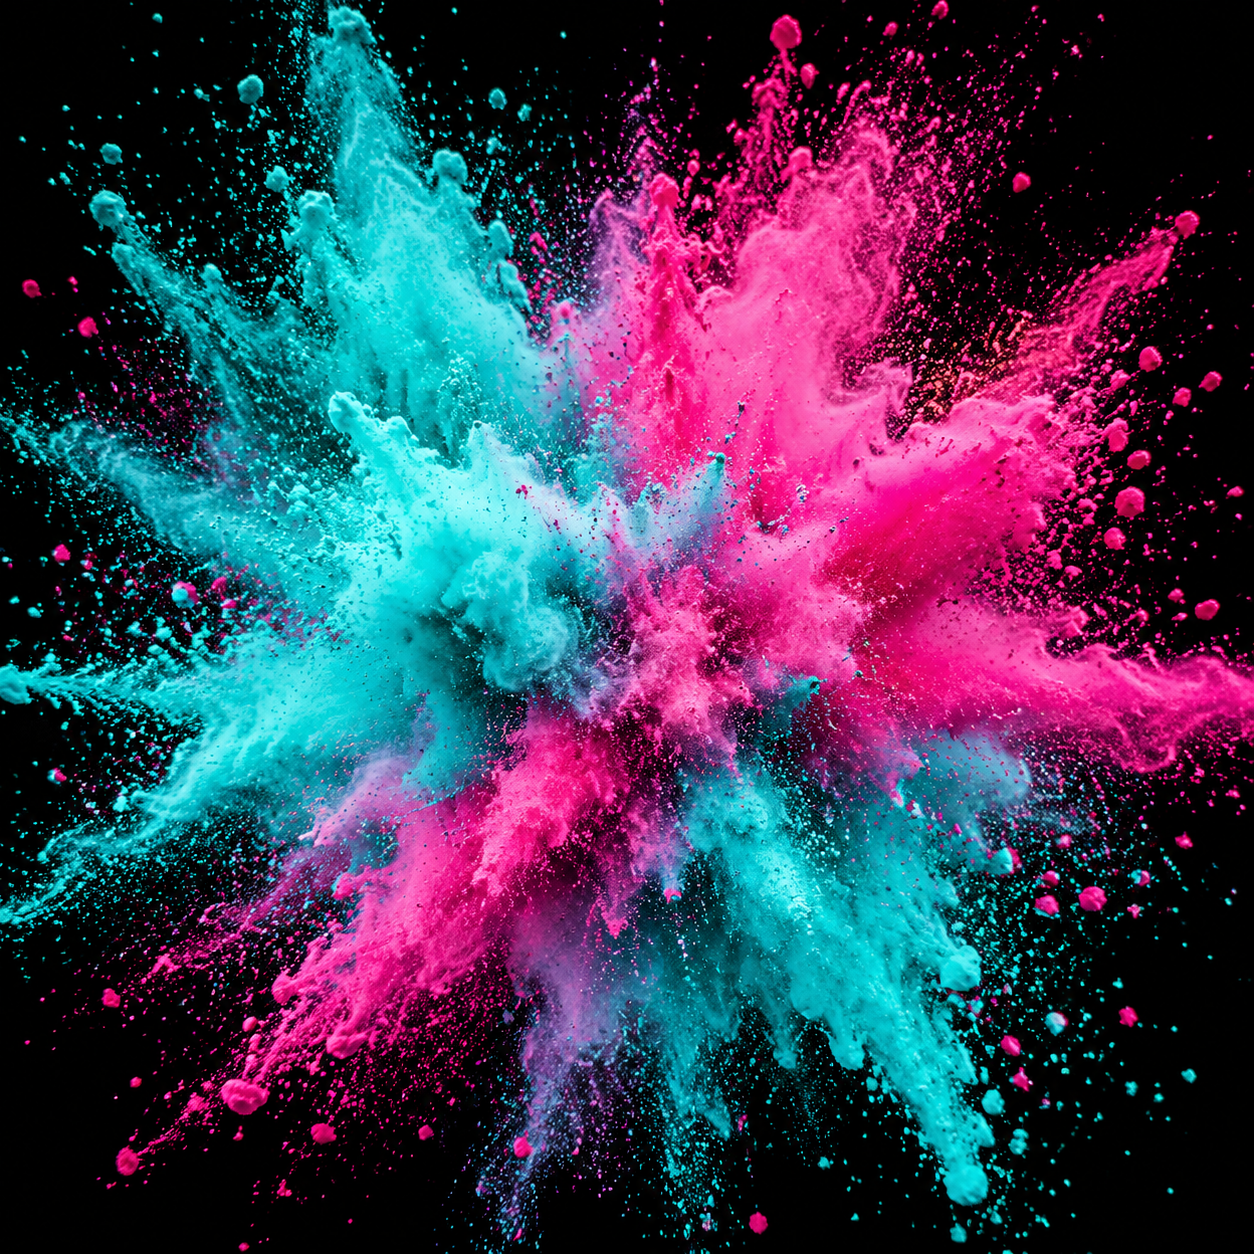
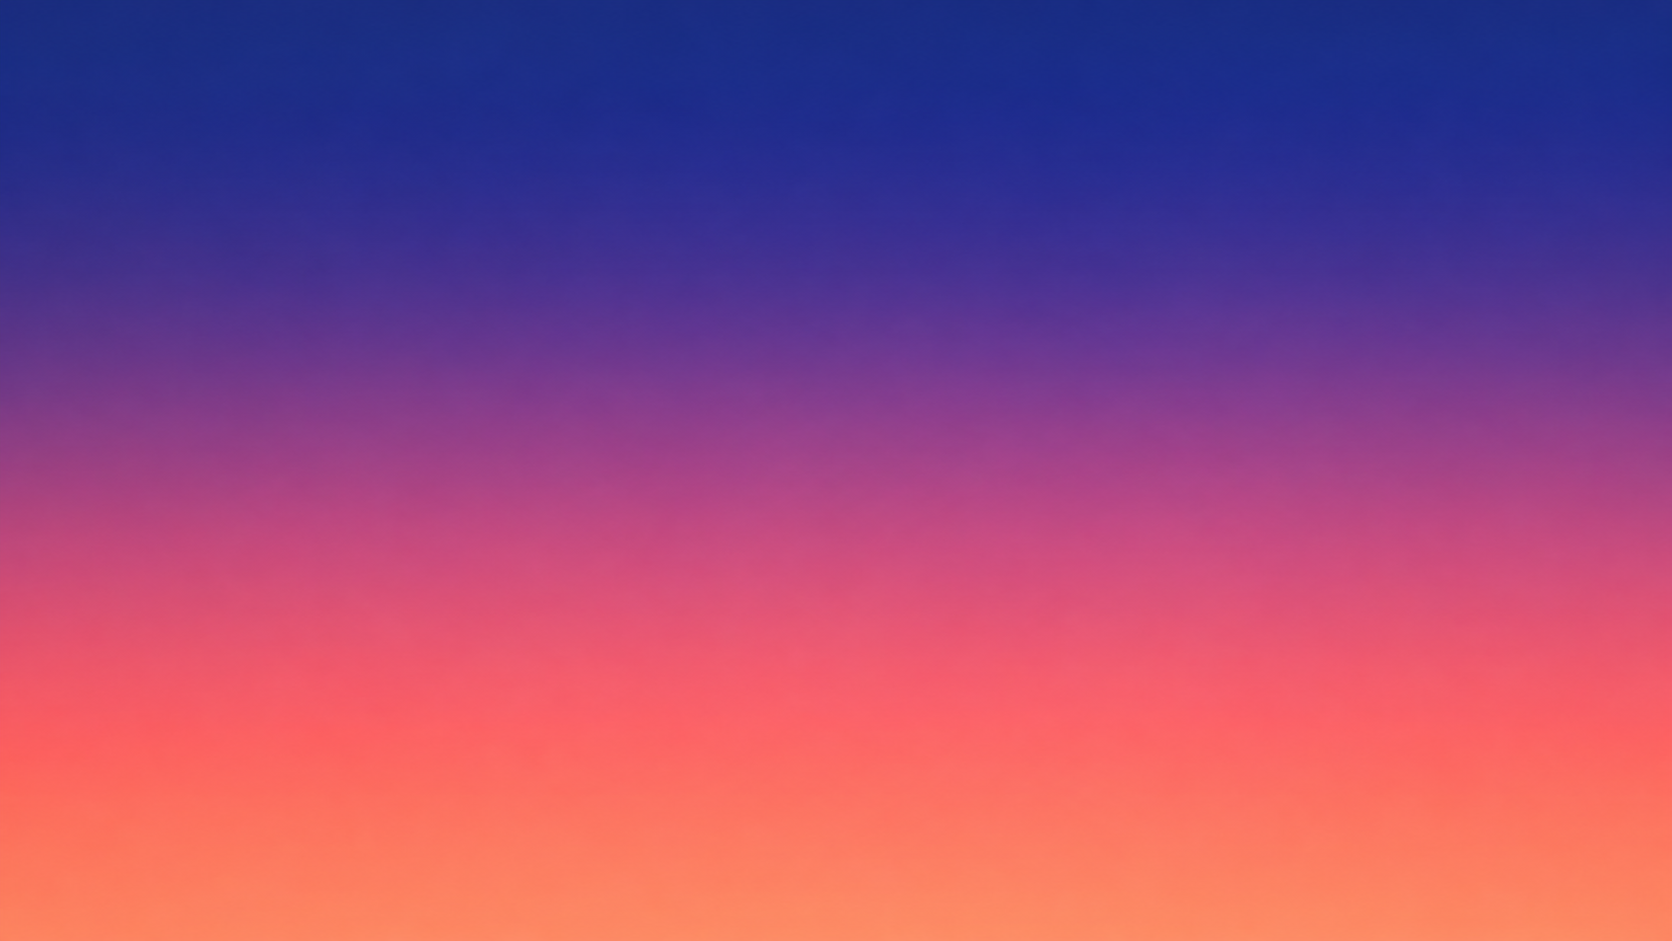
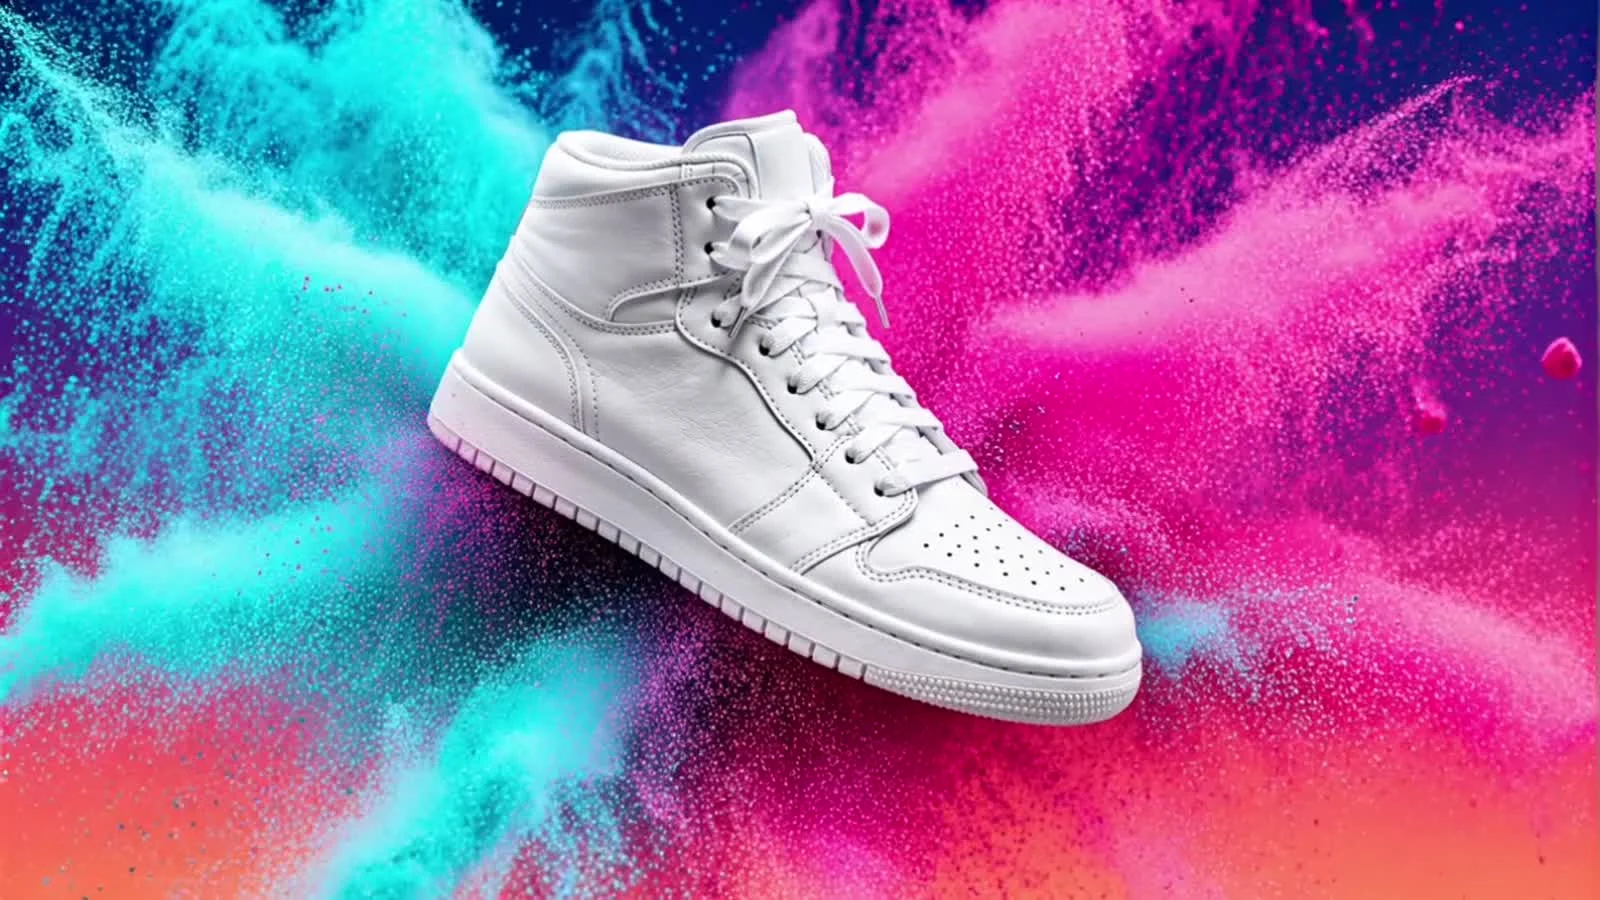
来自参考图 1 的白色高帮运动鞋漂浮在中央,背景是来自参考图 3 的靛蓝到珊瑚色渐变背景,同时来自参考图 2 的青绿色和洋红色粉末以慢动作向外爆开。摄像机围绕鞋子弧形移动四十五度,粉末尾迹旋转并落下。充满活力的运动鞋广告,戏剧性影棚灯光,有力的呼啸声。
哪些内容被混合了,模型又发明了什么。三张参考图都出现并保持各自角色:运动鞋是主体,青绿色和洋红色粉末是包裹它的效果,靛蓝到珊瑚色渐变毫无疑问是背景。我要求的摄像机弧线可见——鞋子在五秒内相对画面旋转。三张图片能在这里保持在一起、而更模糊的提示词会把它们弄浑的原因是:每张参考图在句子中承担不重叠的任务(主体 / 效果 / 背景),并且我按索引引用它们,包括为背景乱序引用的“图 3”。超过三四张参考图后,这种纪律就不再可选——给每张图片明确任务,否则模型会悄悄丢弃最弱的那张。1280*720,5 秒,约 $0.78。(这一帧是文章封面。)
配方 4 — 竖版社交:吉祥物展示产品
最后一个是为社交准备的 9:16 混合:一张图片是品牌吉祥物,另一张是它要销售的产品。任务是让角色拿着产品,竖版,可直接用于信息流。
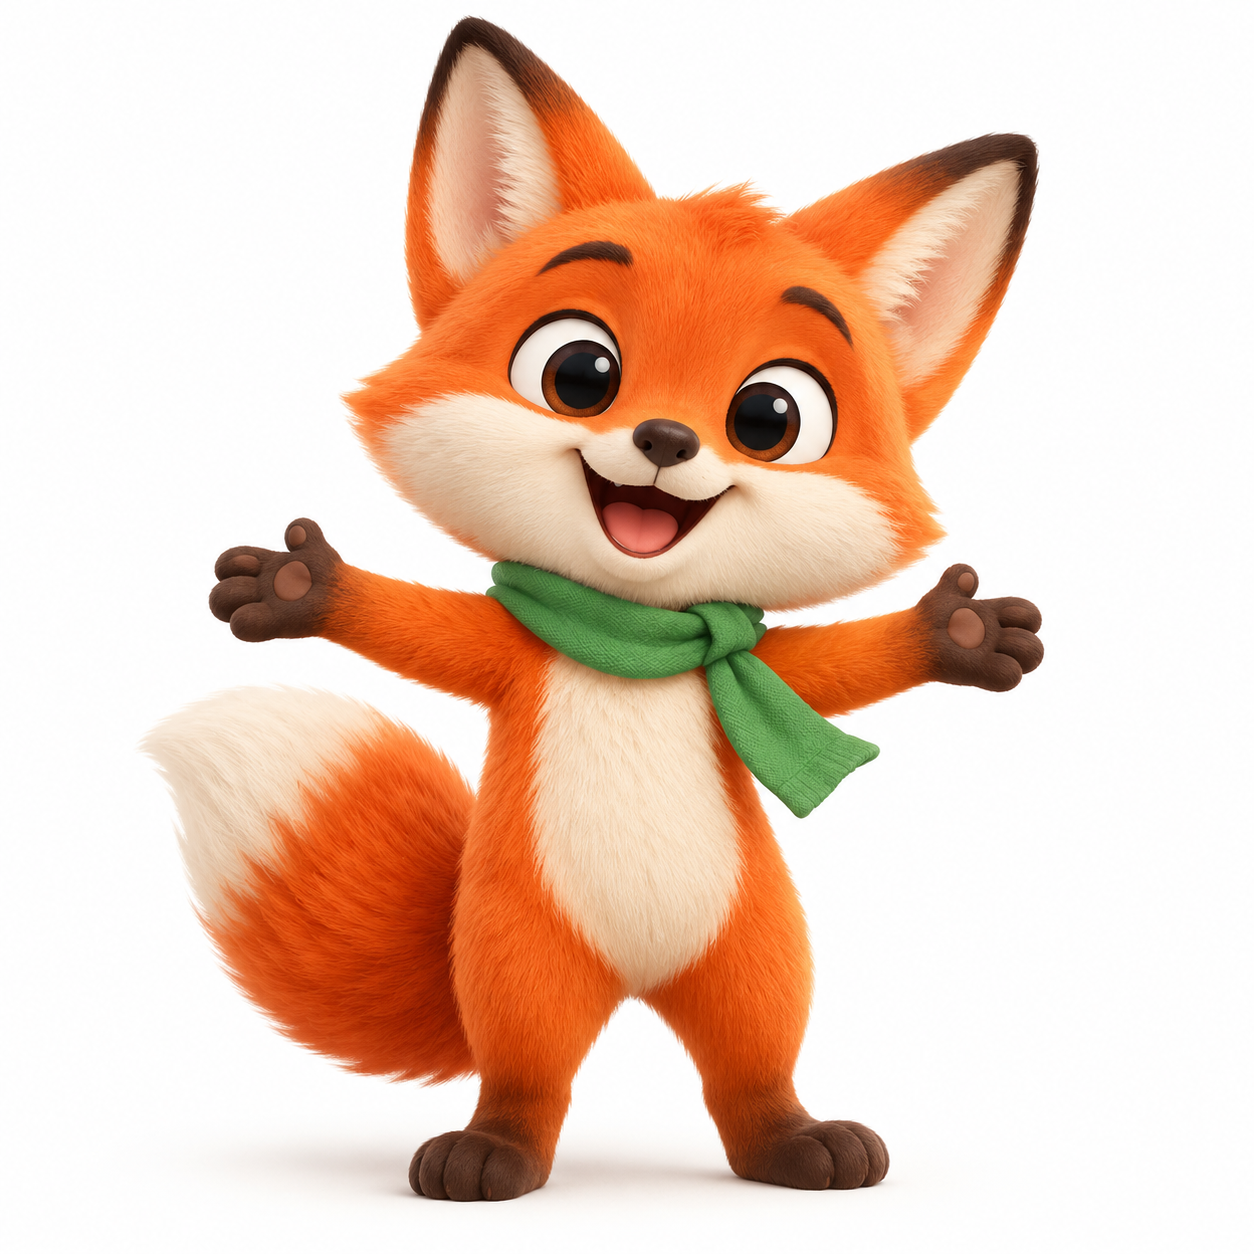
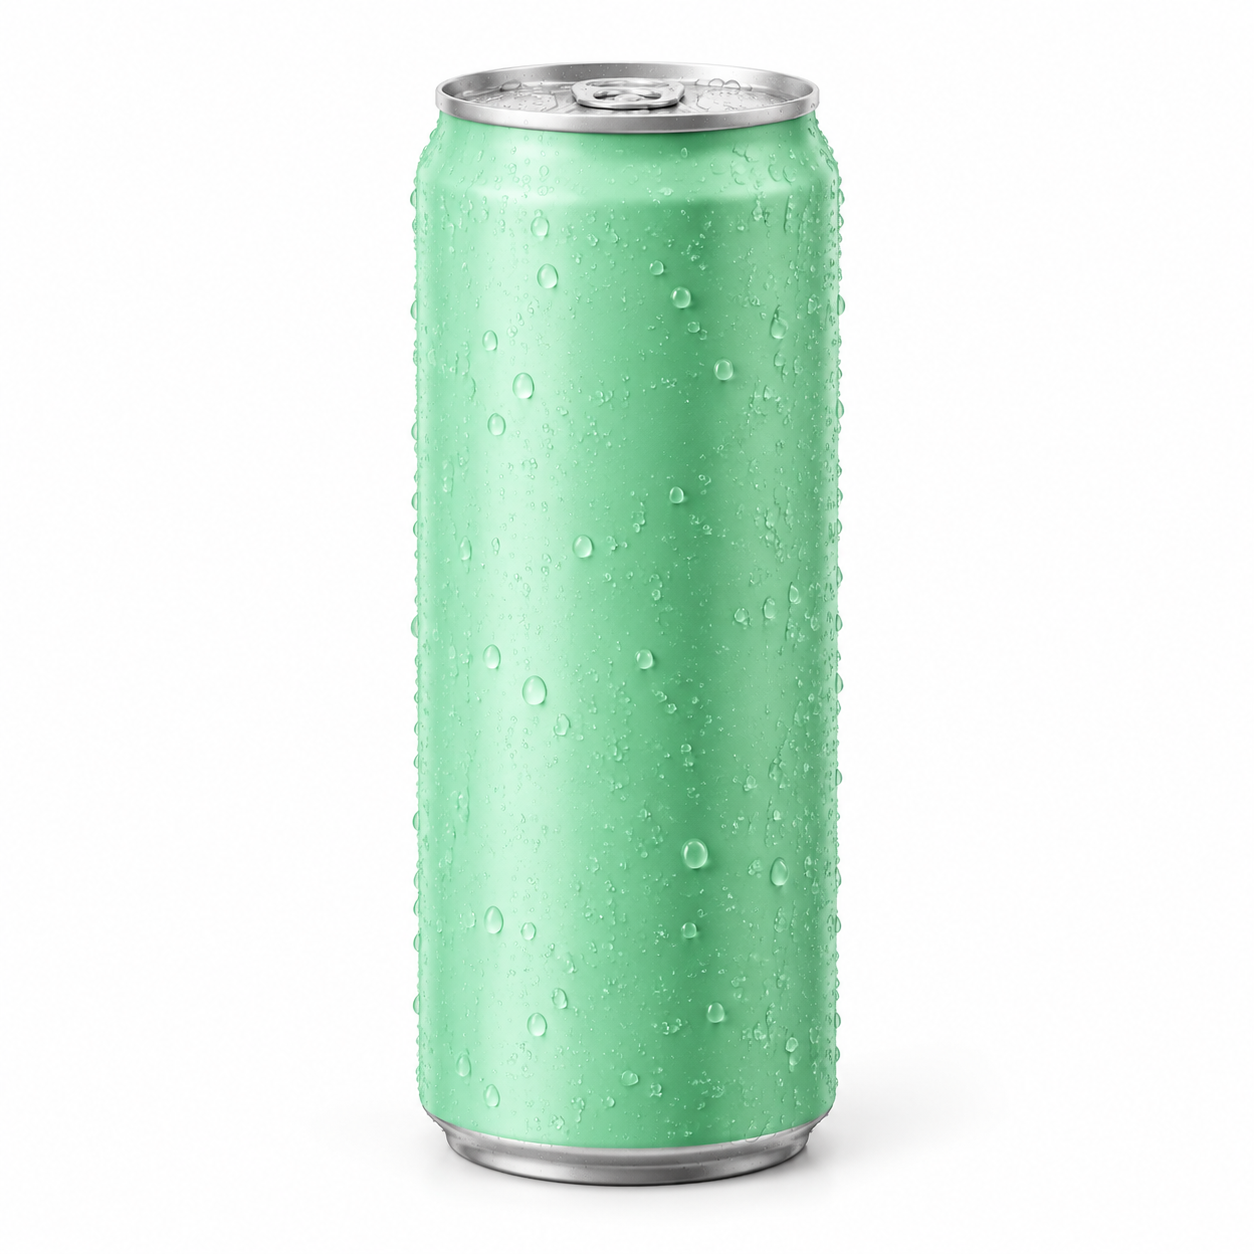
竖版镜头。来自参考图 1 的橙色卡通狐狸吉祥物举起来自参考图 2 的薄荷绿气泡水罐,带着欢快的小弹跳把它展示给镜头,明亮的波普色影棚背景,五彩纸屑飘落。俏皮的社交广告,有力欢快的灯光,活泼的气泡声。
哪些内容被混合了,模型又发明了什么。狐狸保持了图 1 的设计(橙色毛发、绿色围巾、大眼睛),罐子保持了图 2 的哑光薄荷绿表面,角色的爪子环绕着它——“举起……展示给镜头”这个动词将两张参考图绑定成一个动作,而不是两个物体共享画面。波普色背景和五彩纸屑是发明的。选择竖版 size(720*1280)才能让它成为竖版;没有 aspect_ratio 字段(详见下文)。4 秒,约 $0.62。
运行这些配方后我学到的内容
在花费积分之前值得了解的五件事,全部来自这批测试:
- 索引绑定是关键。这里的每个片段都遵守了“来自参考图 N 的 X”。当你想要两个主体互动时,给动作一个连接它们的动词(“举起”“放在……上面”),而不是把它们并排列出。
- 你锚定物体;模型发明连接组织。台面、整间房的光线、五彩纸屑、旋转粉末——这些都不在参考图中。对于“主体进入场景”来说这是特性,但这也意味着任何你需要保留的东西必须来自参考图片。
- 交付像素略低于标称
size。1920*1080返回为 1914×1084,1280*720为 1276×722,720*1280为 722×1276。对网页来说足够接近,但不要在下游硬编码精确尺寸。 - 输出为 H.264,可直接嵌入。不同于交付 HEVC 的 4K 层级,这些片段可直接内联播放,无需重新编码——本页每个视频都是 API 直接返回的文件。
- “原生音频”并未产生音频。四个片段每一个返回时都是静音、仅视频的 MP4——尽管模型带有“原生音频”标签,且我的提示词包含声音线索(“轻柔的咖啡馆环境声”“有力的呼啸声”)。平台自己的 Q3 Mix 示例片段也是静音的。计划在后期添加声音,或者如果语音轨道不可妥协,就使用带明确音频输入的层级——Vidu Q4 Preview 配方 涵盖了语音参考工作流。
用 /v1/tasks 复现任何配方
参考生视频运行在异步任务 API 上:提交任务,轮询直到状态为 success,然后从 output[0].url 下载片段(该 URL 有效期短——立即保存文件)。
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-mix/reference-to-video",
    "input": {
      "prompt": "来自参考图 1 的滤杯放在来自参考图 2 的玻璃壶上……",
      "reference_image_urls": [
        "https://your-host/dripper.png",
        "https://your-host/carafe.png"
      ],
      "duration": 5,
      "size": "1920*1080"
    }
  }'
# -> {"data":{"taskId":"tk-..."}}   然后 GET /v1/tasks/tk-... 直到 status == "success"
import requests, time

H = {"Authorization": f"Bearer {TOKEN}"}
job = requests.post("https://api.hiapi.ai/v1/tasks", headers=H, json={
    "model": "vidu-q3-mix/reference-to-video",
    "input": {"prompt": PROMPT, "reference_image_urls": REFS,
              "duration": 5, "size": "1920*1080"},
}).json()["data"]["taskId"]

while True:
    t = requests.get(f"https://api.hiapi.ai/v1/tasks/{job}", headers=H).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("clip.mp4", "wb").write(requests.get(t["output"][0]["url"]).content)
复制配方前值得了解的字段规则:
reference_image_urls接受 1–7 张图片。第八张会返回400 maxItems: want 7。duration是 整数,从 1 到 16 秒。像4.5或99这样的浮点数会在提交时被拒绝。- 形状由
size设置,而不是aspect_ratio——传入aspect_ratio(或resolution)会返回400 additional properties not allowed。十个size值是在 720 级和 1080 级两个层级上的五种宽高比;竖版选择竖版值,16:9 选择横版值。 - 没有音频参考字段——
reference_audio_urls会被拒绝。如果你需要用音频样本驱动语音,那是 Q4 Preview 层级,不是 Q3 Mix。 - 按秒计费(720 级 vs 1080 级)在 定价页面 上;这里的四个片段每个约花费 $0.62–$0.93。先在 720 级
size上迭代构图,然后在 1080 上重新运行最终版本。
常见问题
Q3 Mix 可以混合多少张参考图片? 一到七张。两张是常见情况(主体 + 场景);三张仍然可以干净合成,只要每张图片承担明显不同的角色,如上面的运动鞋配方。超过四张后,给每张参考图明确、不重叠的任务,否则模型会开始丢弃最弱的那张。
如何控制哪张图片是主体、哪张是背景?
按索引引用它们,并在同一句话中分配角色:“来自参考图 1 的运动鞋……背景为来自参考图 3 的背景。”reference_image_urls 中 URL 的顺序就是索引顺序——图 1 是第一个 URL。
Q3 Mix 会自动添加声音吗? 在我的测试中不会。尽管带有“原生音频”标签,所有四个片段——以及平台自己的 Q3 Mix 示例——返回时都是静音 MP4,即使提示词中包含声音词汇。将 Q3 Mix 视为仅画面生成器,在后期添加音频,或切换到带明确音频输入的层级。
可以获得 4K 或自定义宽高比吗?
没有 4K——Q3 Mix 最高为 1080 级 size 值。宽高比就是你在 size 中选择的五种形状之一(横版、竖版、方形)。若需要 4K 或语音参考,请改用 Vidu Q4 Preview。
Q3 Mix 与 Q3 Ad——选哪个?
调用接口几乎相同(1–7 张图片、同样的十个 size 值、无音频输入),因此提示词几乎可以原样移植。当需求是产品广告时选择 Q3 Ad——它针对智能剪辑和营销镜头运动进行了调优;选择 Q3 Mix 进行通用多主体混合。每秒费率接近但不完全相同;请查看定价页面。
为什么我的混合忽略了一张参考图? 几乎总是提示词绑定问题,而不是模型限制。如果一张参考图在句子中没有明确角色,它就会与其他参考图竞争并失败。给它一个动词和位置(“举起来自参考图 2 的罐子”),并让冲突的参考图在比例上保持距离。
准备好尝试了吗?打开 vidu-q3-mix/reference-to-video 模型页面,从快速开始获取密钥,然后粘贴上面的配方并替换成你自己的参考 URL。想在混合中规划镜头运动?电影感镜头运动提示词 可以直接用于其中任何一个。


