
Guia de uso
Receitas de prompts de referência para vídeo do Vidu Q3 Mix: fundindo várias imagens em um único plano
Quatro prompts de referência para vídeo prontos para copiar e colar, cada um misturando 2–3 imagens independentes — sujeito, cena e adereços — em um clipe q3-mix, com a saída realmente gerada no hiapi.
Resumo
- Quatro prompts de referência para vídeo prontos para copiar e colar para vidu-q3-mix/reference-to-video, cada um acompanhado do clipe realmente gerado no hiapi — sem material de banco de imagens e sem substituir o vídeo por uma única imagem estática.
- O Q3 Mix está no nível de mistura de várias imagens: entregue 1–7 imagens de referência (personagem, objeto, cena) e ele as combina em um plano dinâmico. As receitas abaixo misturam duas e três imagens estáticas por vez.
- Uma regra que decide se a mistura funciona: numere as imagens de referência e atribua a cada uma uma tarefa explícita — “o porta-filtro da imagem de referência 1 apoiado sobre a jarra de vidro da imagem de referência 2”, nunca um vago “combine tudo isso”.
- Validado nesta execução: a mistura de três imagens (sujeito + efeito + fundo) compõe de forma limpa, a saída tem pixels ligeiramente abaixo do
sizenominal, o clipe é H.264 (reproduz direto no navegador, sem transcodificação) e — apesar do rótulo “áudio nativo” — cada clipe retorna em silêncio. - Copie um prompt, substitua pelas suas próprias URLs de referência e faça POST em
/v1/tasks.
Por que “misturar” é um tipo diferente de trabalho de prompt
O Vidu Q3 Mix (da ShengShu) é o nível de referência para vídeo dedicado a misturar várias imagens ao mesmo tempo — até sete, combinando personagens, objetos e cenas em um único clipe. Se o prompt não disser ao modelo qual imagem fornece o quê, essa capacidade é desperdiçada.
Um hábito que separa a mistura limpa da confusa: numere as imagens de referência e atribua a cada uma uma tarefa explícita. Escreva “o porta-filtro da imagem de referência 1 apoiado sobre a jarra de vidro da imagem de referência 2”, em vez de “combine estas duas em uma cena de café”. O modelo vincula cada sujeito ao seu índice; “combine estas” é exatamente onde a mistura desvia — ele perde uma referência, funde dois sujeitos em um só ou cola algo na proporção errada. A imagem 1 é a primeira URL em reference_image_urls, a imagem 2 é a segunda, e assim por diante.
Tudo abaixo usa esse padrão. Cada receita lista as imagens estáticas de referência exatas que gerei, o prompt completo que enviei e o clipe que ele gerou no hiapi.
Receita 1 — Dois produtos, uma cena principal (mistura de duas imagens)
A tarefa clássica de “mistura”: duas tomadas de produto independentes precisam compartilhar um único quadro. Dei ao Q3 Mix um porta-filtro de café coado preto fosco e uma jarra de vidro vazia — duas imagens, dois objetos — e pedi que fossem empilhados e que o café fosse coado.
Imagem de referência 1 (porta-filtro) e imagem de referência 2 (jarra de vidro):
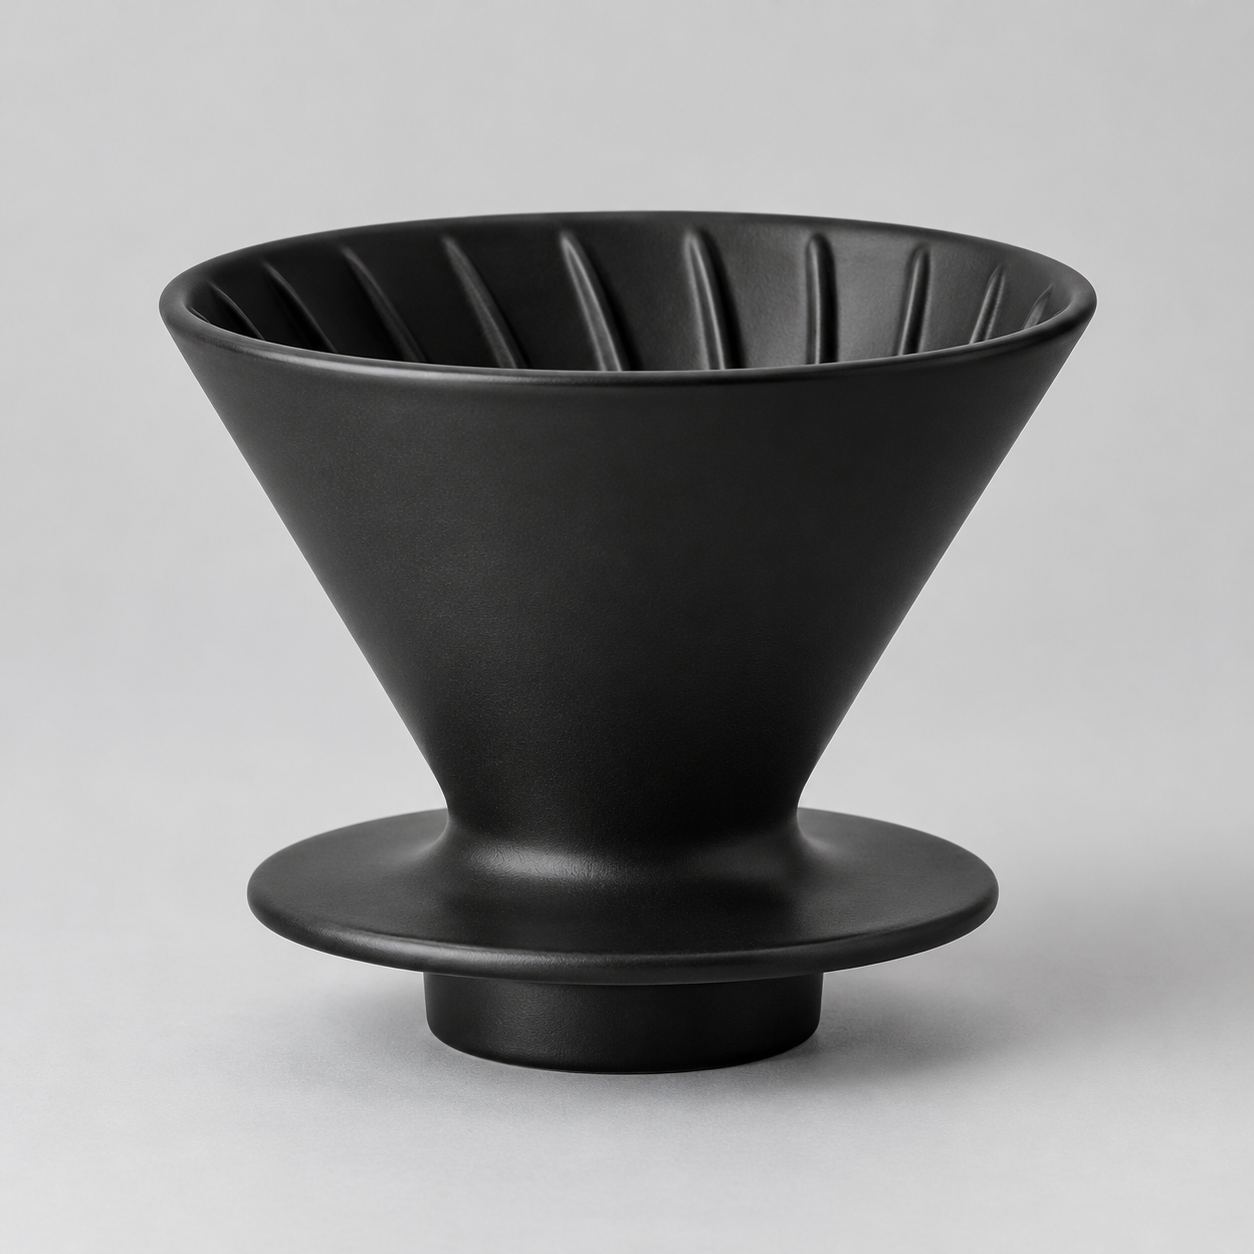
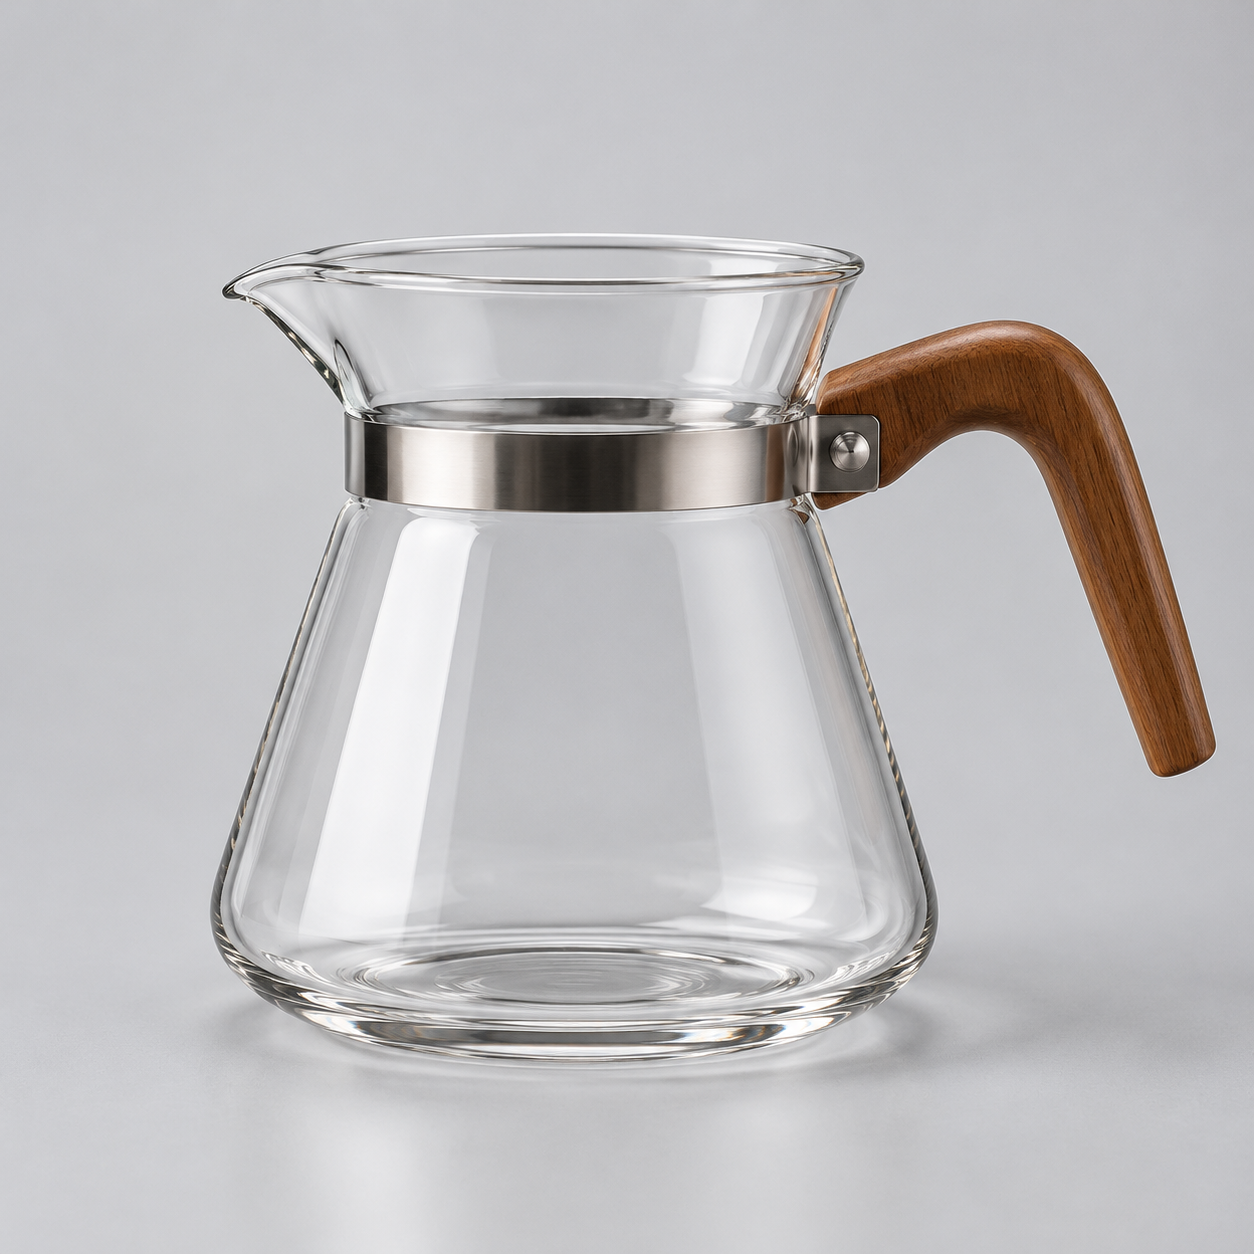
O porta-filtro de cerâmica preto fosco da imagem de referência 1 apoiado firmemente sobre a jarra de café de vidro transparente da imagem de referência 2, ambos sobre uma bancada de concreto claro de cafeteria. Push-in lento, um fio fino de café fresco começa a pingar do porta-filtro para a jarra, vapor subindo em volutas, luz quente da manhã entrando oblíqua pela janela à esquerda. Acabamento de anúncio de produto premium, profundidade de campo rasa, ambiente sonoro suave de cafeteria.
O que foi misturado e o que o modelo inventou. Os dois objetos ficaram no lugar correto: o porta-filtro da imagem 1 assentado sobre a jarra da imagem 2, com proporção relativa correta e formas muito próximas às das imagens estáticas. Tudo entre os dois produtos — a bancada de concreto, a cafeteria desfocada ao fundo, a luz da janela, o café pingando na jarra, o vapor — foi inventado pelo modelo; nenhuma das duas referências contém isso. Esse é o modelo mental útil do Q3 Mix: você ancora os objetos, ele preenche o mundo ao redor. A câmera executou o único push-in que pedi. Renderizado a 1920*1080 por 5 segundos; o arquivo entregue tem 1914×1084 (veja “abaixo do tamanho nominal” mais adiante), e esta geração custou cerca de $0.93.
Receita 2 — Colocar um personagem em um cômodo novo (sujeito + cenário)
A segunda mistura mais comum é sujeito mais ambiente: uma imagem é responsável por quem, a outra por onde. Renderizei um brinquedo robô de pelúcia sobre fundo branco puro e um quarto infantil iluminado pelo sol, sem personagens, e então pedi ao modelo que colocasse o primeiro no segundo.
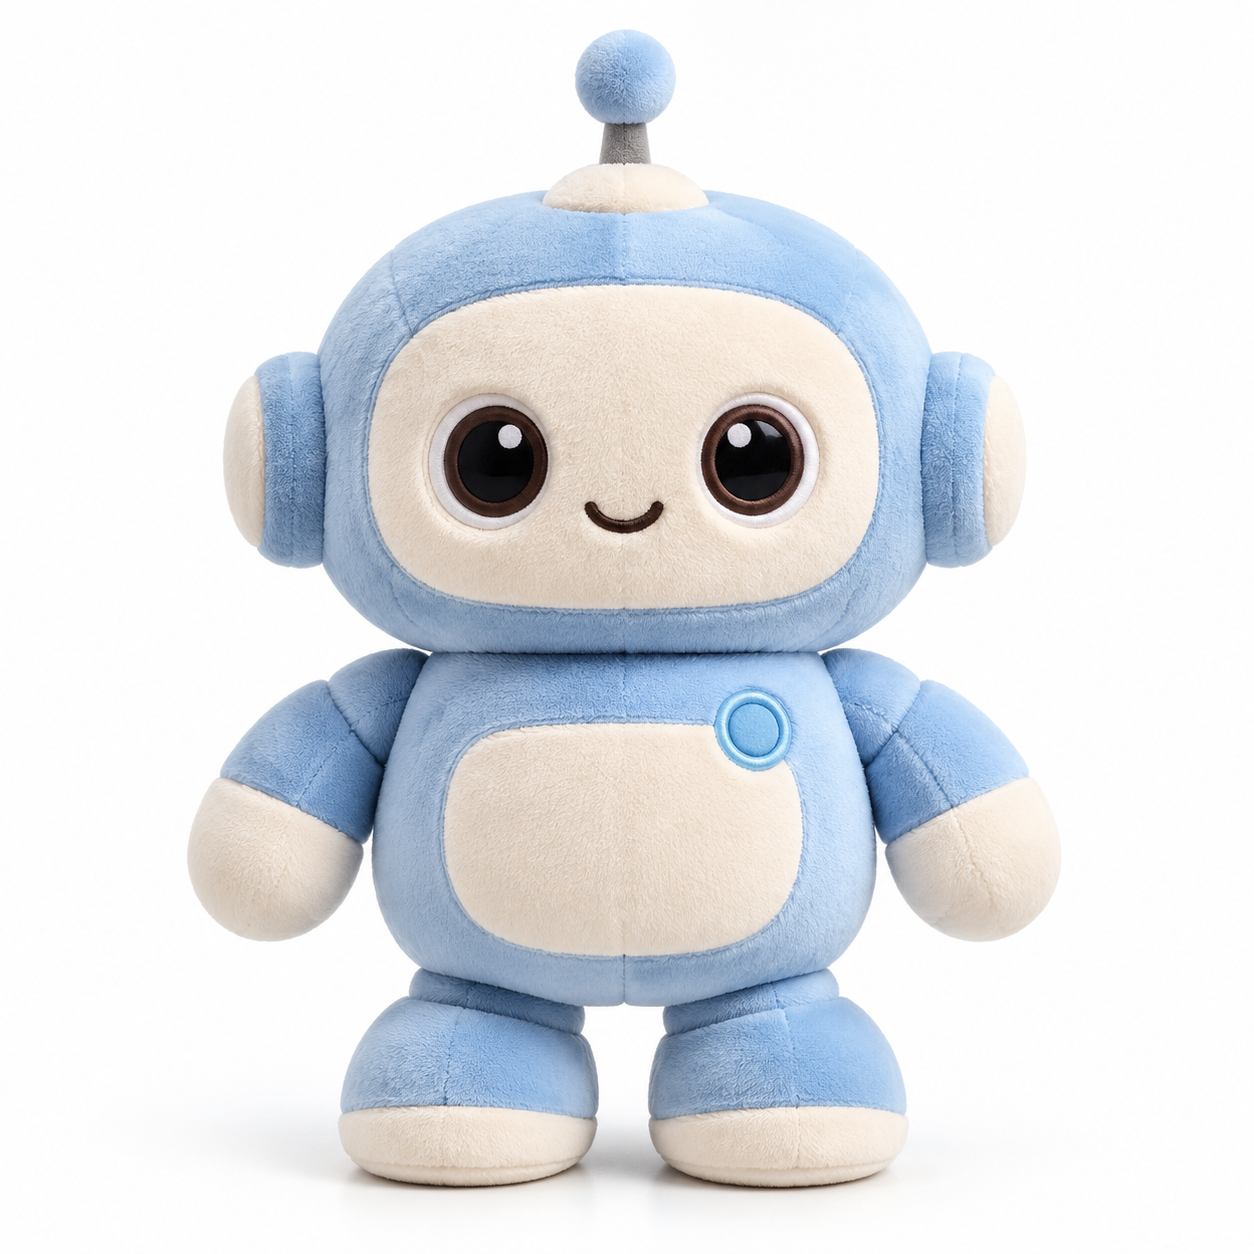
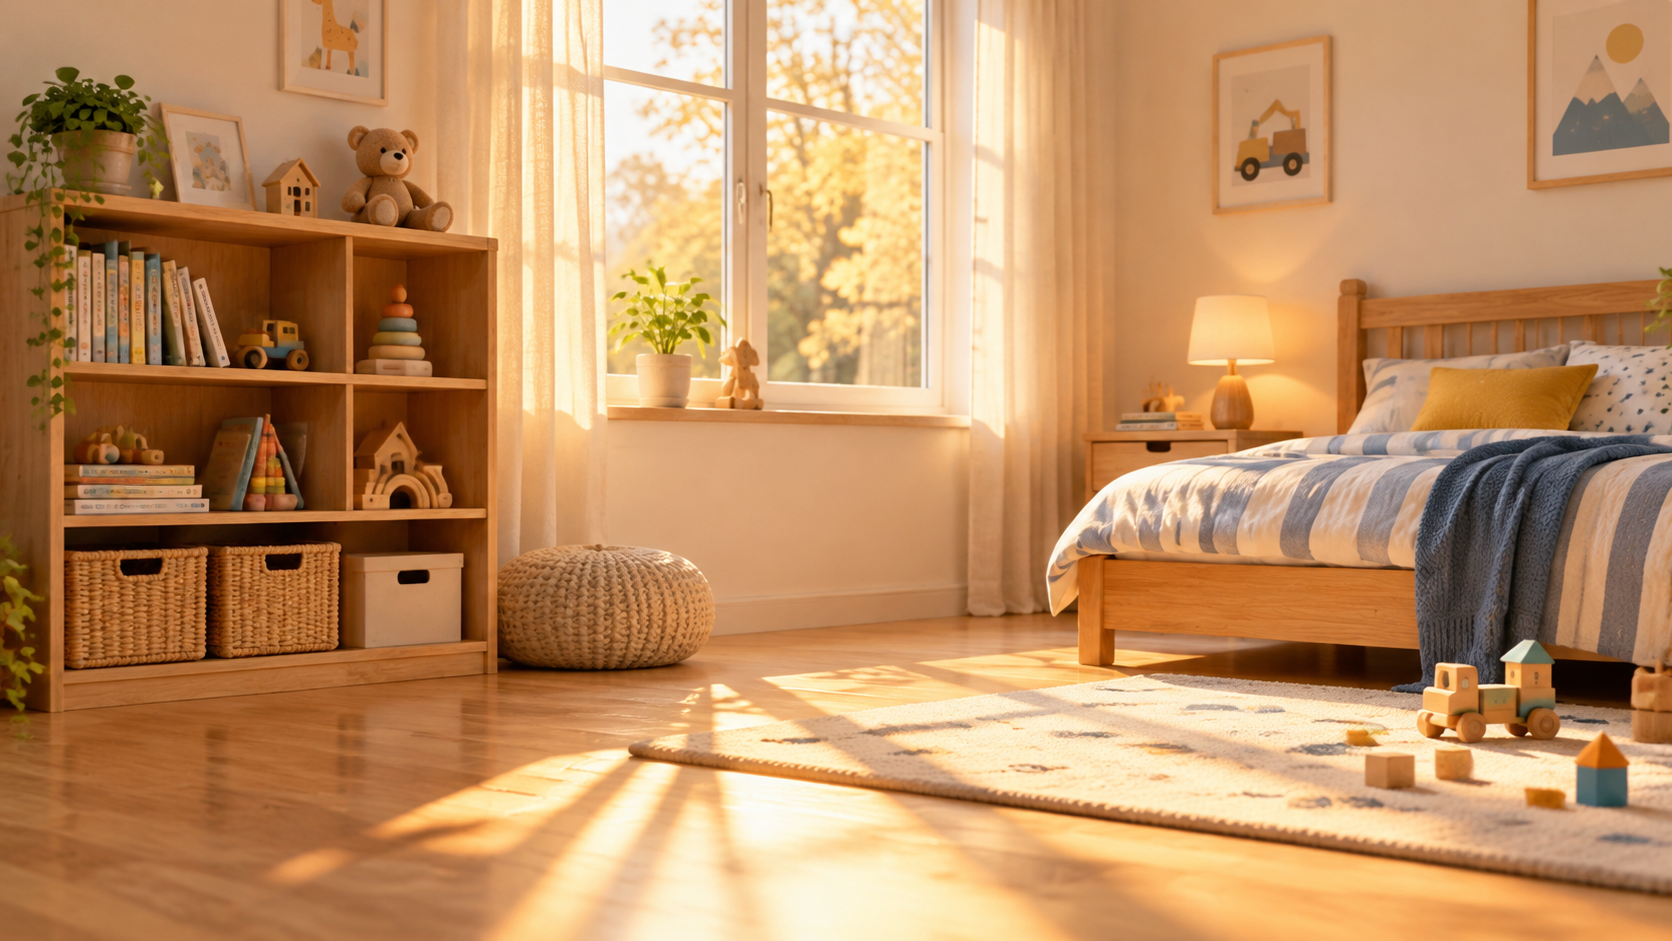
O brinquedo robô de pelúcia azul-claro da imagem de referência 1 sentado no piso de madeira do quarto infantil iluminado pelo sol da imagem de referência 2. Ele inclina a cabeça lentamente, levanta um braço curto e acena para a câmera, partículas de poeira flutuando na luz quente da janela, push-in suave com câmera na mão. Suave, alegre, cinematográfico, leve ambiente sonoro do quarto.
O que foi misturado e o que o modelo inventou. O quarto da imagem 2 foi preservado quase intacto — estante, cama listrada, janela e sua luz, blocos de montar no tapete, tudo sobreviveu à composição. O robô da imagem 1 foi colocado naquele piso e a luz quente foi ajustada nele, de modo que ele parece estar no cômodo, e não colado. Ele executou a ação que especifiquei (inclinar a cabeça e levantar o braço para acenar), e a câmera fez o push-in com câmera na mão. Esse é o padrão “personagem no cenário”: deixe uma referência carregar o ambiente inteiro e o modelo reiluminará o sujeito para combiná-lo. 1280*720, 5 segundos, cerca de $0.78.
Receita 3 — Três imagens, um plano: sujeito + efeito + fundo
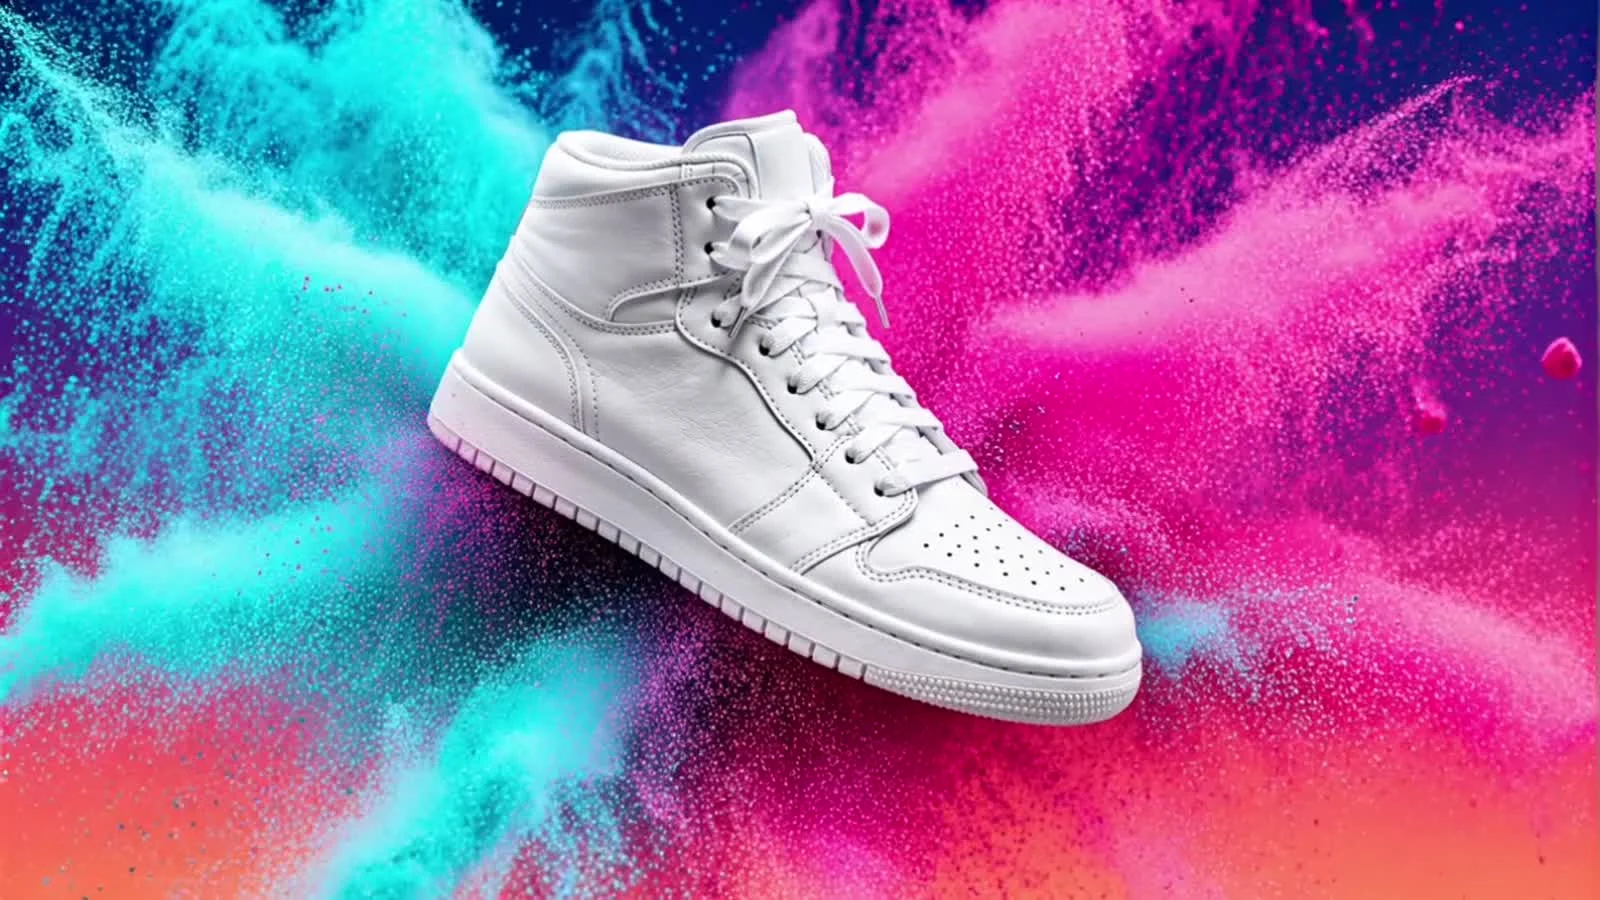
Esta receita prova o nome “mistura”. Três imagens estáticas independentes — um tênis, uma explosão de pó colorido e um fundo em degradê — cada uma com uma tarefa claramente diferente, misturadas em uma tomada de produto vibrante.
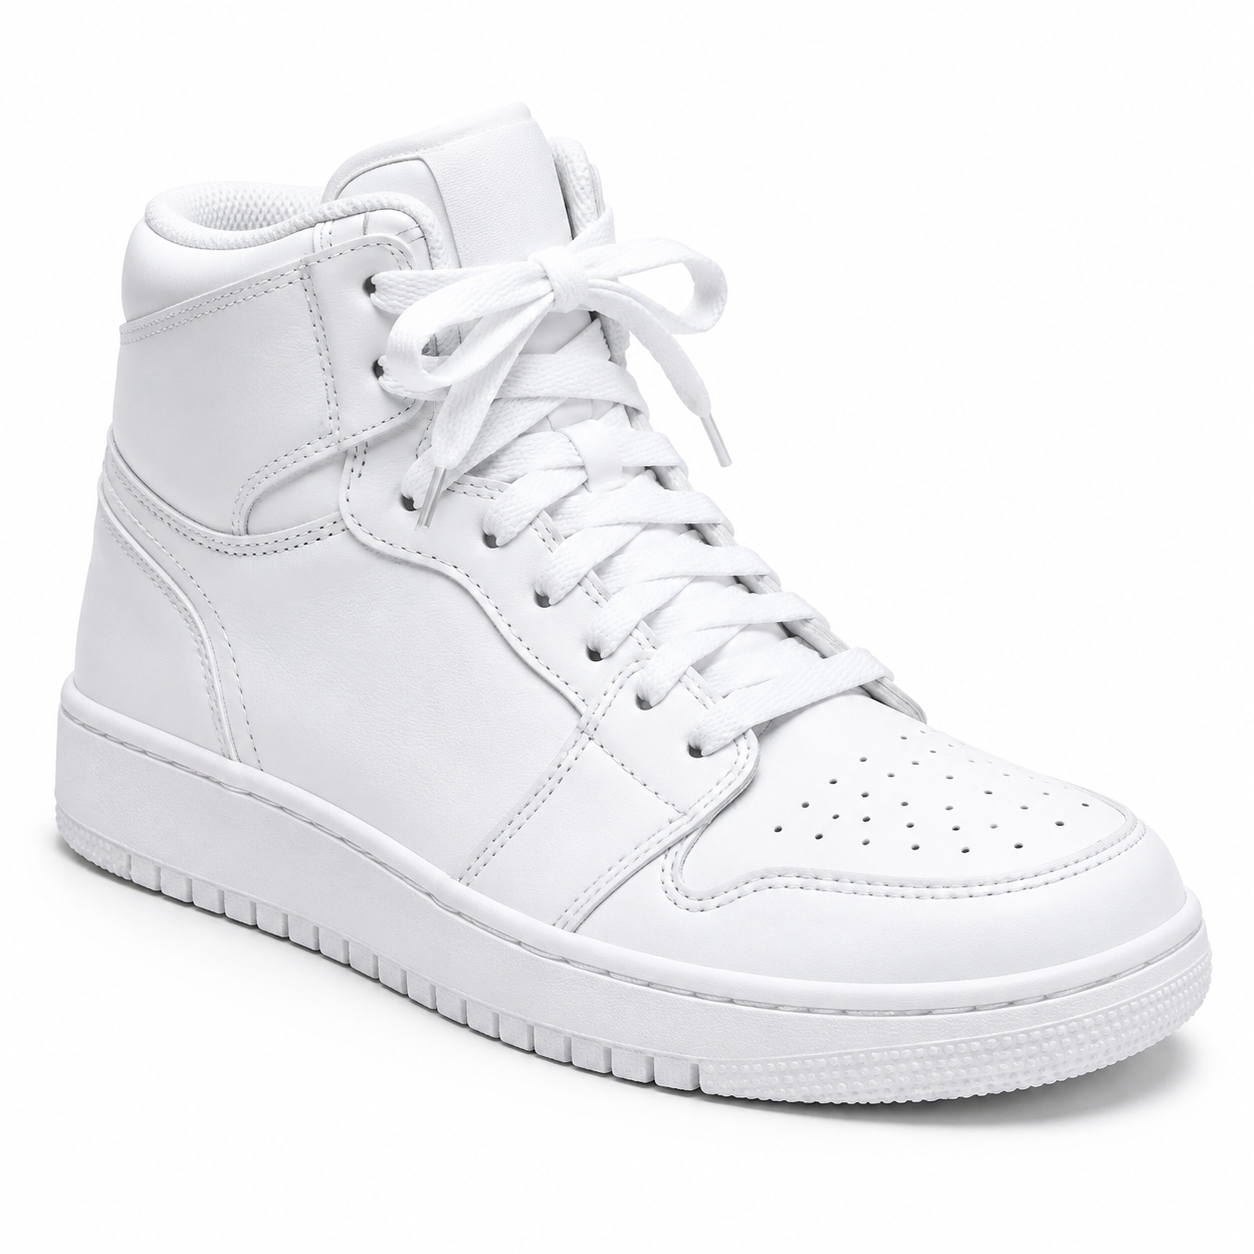
O tênis branco de cano alto da imagem de referência 1 flutuando no centro, contra o fundo em degradê de índigo a coral da imagem de referência 3, enquanto o pó em turquesa e magenta da imagem de referência 2 explode para fora em câmera lenta. A câmera faz um arco de quarenta e cinco graus ao redor do tênis, e a esteira de pó gira e cai. Anúncio vibrante de tênis, iluminação de estúdio dramática, som potente de whoosh.
O que foi misturado e o que o modelo inventou. As três referências aparecem e mantêm seus papéis: o tênis é o sujeito, o pó em turquesa e magenta é o efeito que o envolve, e o degradê de índigo a coral é inconfundivelmente o fundo. O arco de câmera que pedi é visível — o tênis gira em relação ao quadro ao longo dos cinco segundos. O motivo pelo qual três imagens permanecem juntas aqui, enquanto um prompt mais vago as turvaria, é que cada referência assume uma tarefa que não se sobrepõe (sujeito / efeito / fundo), e eu as referencio por índice, incluindo o “imagem 3” para o fundo citado fora de ordem. Acima de três ou quatro referências, essa disciplina deixa de ser opcional — atribua uma tarefa explícita a cada imagem, ou o modelo descartará silenciosamente a mais fraca. 1280*720, 5 segundos, cerca de $0.78. (Este quadro é a capa do artigo.)
Receita 4 — Social em vertical: mascote exibe o produto
A última é uma mistura 9:16 para redes sociais: uma imagem é o mascote da marca, a outra é o produto que ele deve vender. A tarefa é fazer o personagem segurar o produto, em vertical, pronto para uso direto no feed.
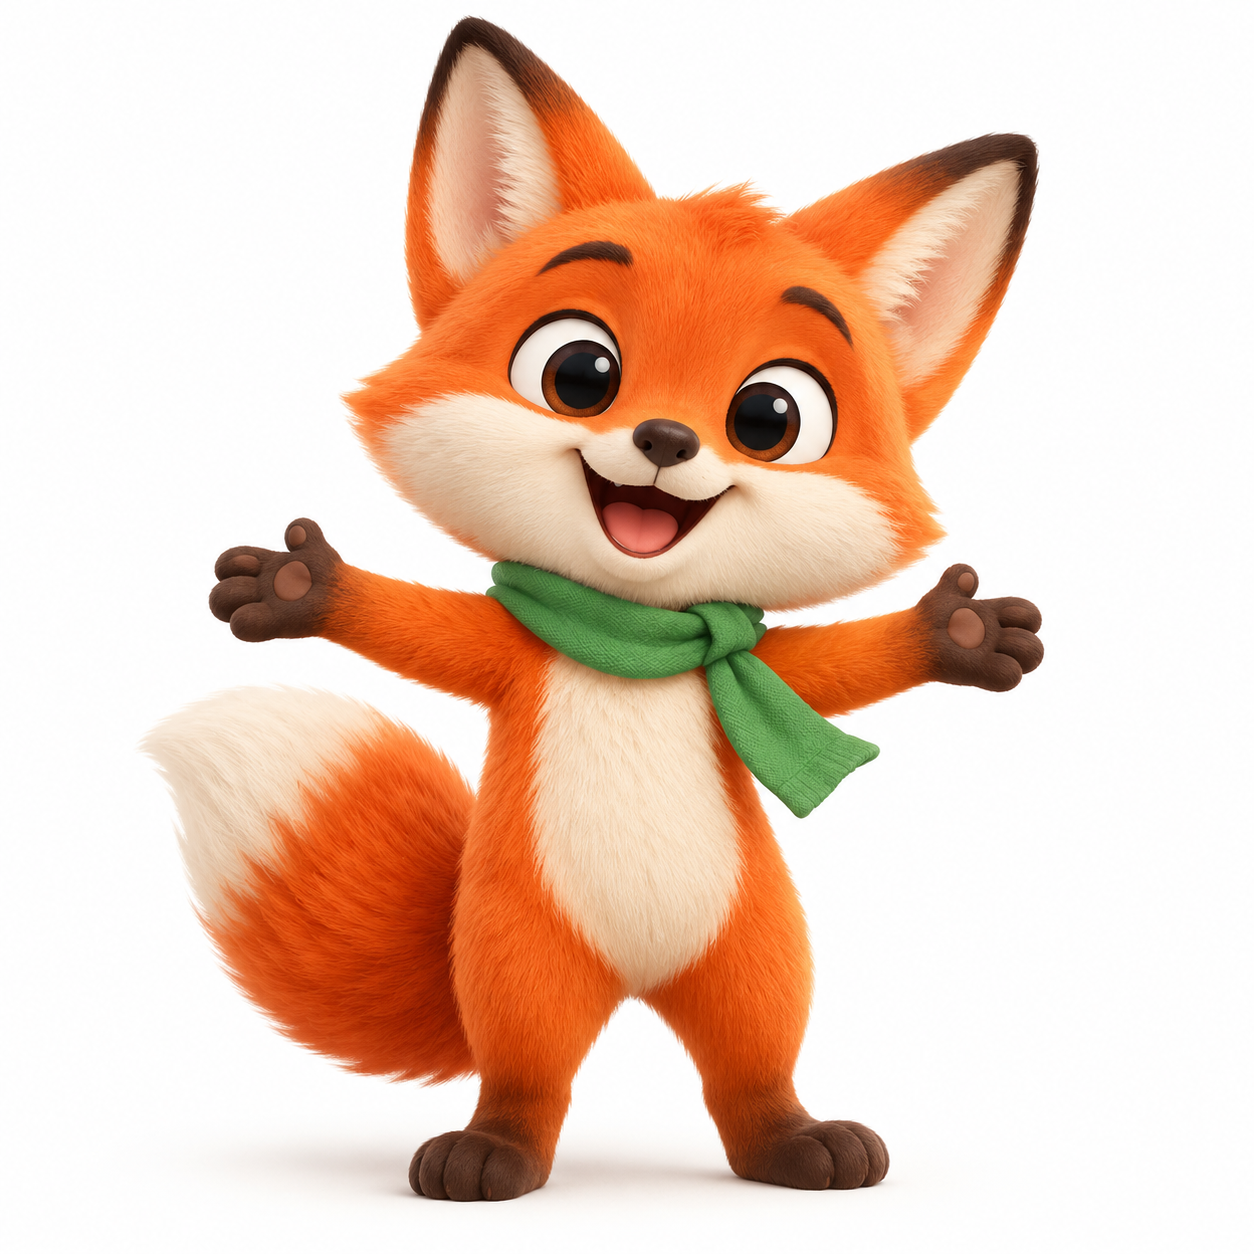
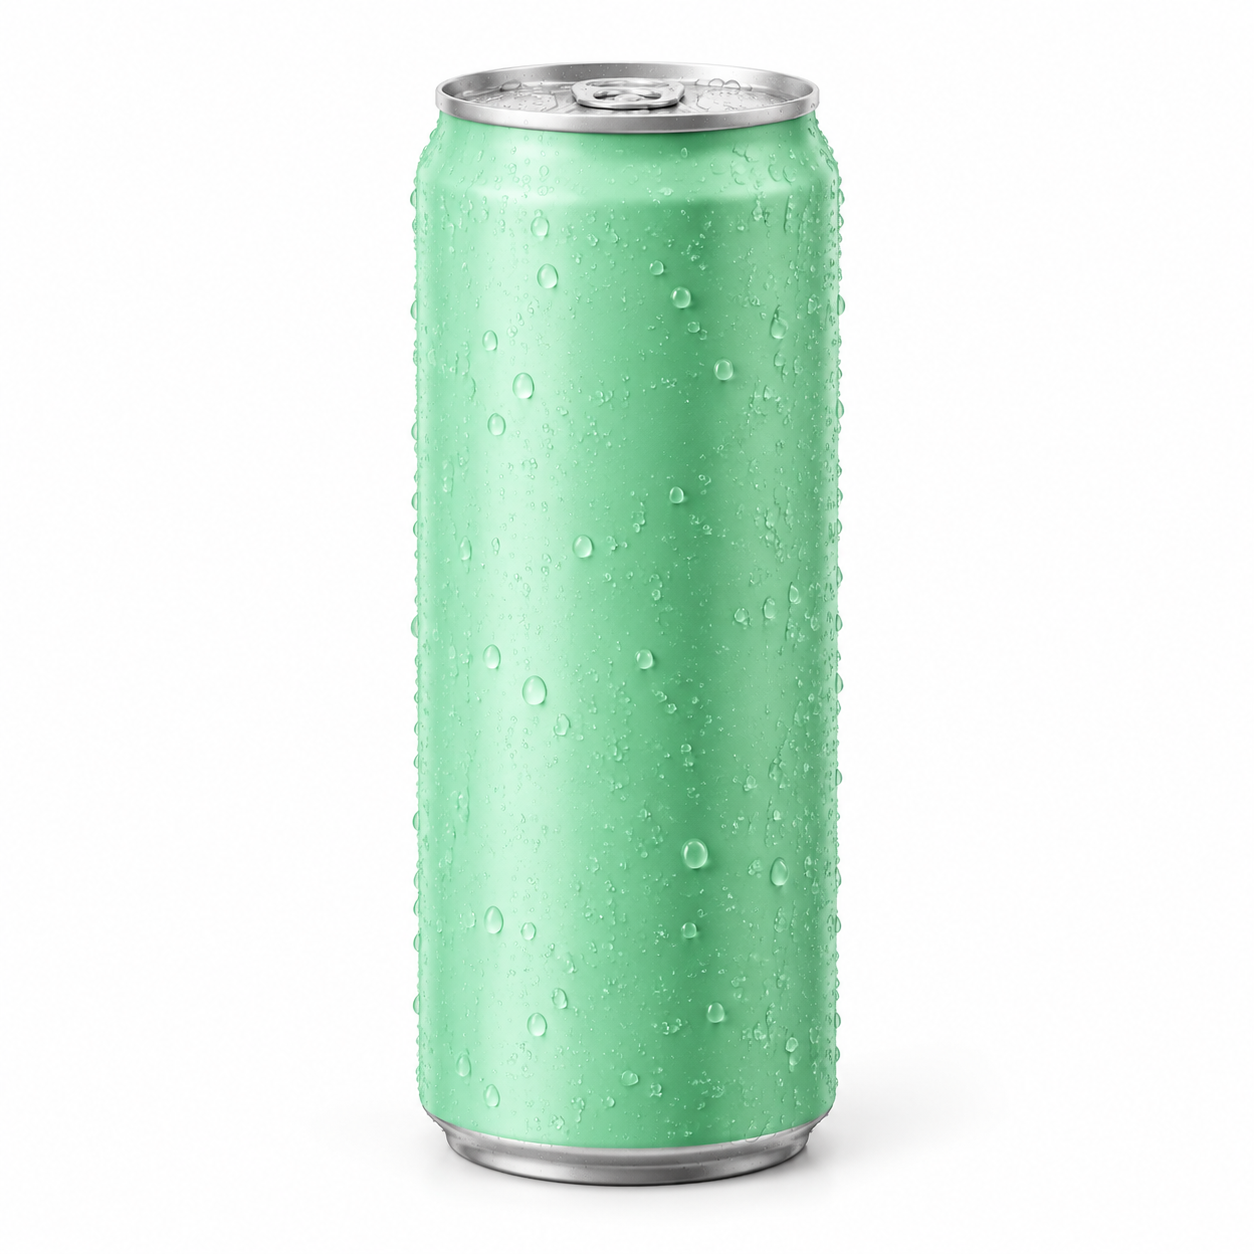
Plano vertical. O mascote de raposa cartunesca laranja da imagem de referência 1 levanta a lata de água com gás verde-menta da imagem de referência 2, exibindo-a para a câmera com um pequeno salto alegre, fundo de estúdio em cores pop vibrantes, confete caindo. Anúncio social divertido, iluminação forte e alegre, som animado de borbulhas.
O que foi misturado e o que o modelo inventou. A raposa manteve o design da imagem 1 (pelo laranja, cachecol verde, olhos grandes), a lata manteve o acabamento verde-menta fosco da imagem 2, e as patas do personagem a envolvem — o verbo “levantar… exibir para a câmera” vincula as duas referências em uma única ação, em vez de dois objetos dividindo o quadro. O fundo pop e o confete são inventados. Escolher um size vertical (720*1280) é o que o torna vertical; não há campo aspect_ratio (detalhes abaixo). 4 segundos, cerca de $0.62.
O que aprendi ao executar estas receitas
Cinco coisas que vale saber antes de gastar créditos, todas provenientes deste lote de testes:
- A vinculação por índice é o ponto crítico. Todo clipe aqui respeitou “o X da imagem de referência N”. Quando quiser que dois sujeitos interajam, dê à ação um verbo que os conecte (“levantar”, “apoiar sobre”), em vez de listá-los lado a lado.
- Você ancora os objetos; o modelo inventa o tecido conectivo. A bancada, a iluminação do cômodo inteiro, o confete, o pó giratório — nada disso está nas referências. Isso é uma característica para “sujeito entrando na cena”, mas também significa que qualquer coisa que você precise preservar deve vir das imagens de referência.
- Os pixels entregues ficam ligeiramente abaixo do
sizenominal.1920*1080retorna como 1914×1084,1280*720como 1276×722,720*1280como 722×1276. Perto o bastante para a web, mas não fixe dimensões exatas no código a jusante. - A saída é H.264, pronta para incorporar. Diferente do nível 4K, que entrega HEVC, esses clipes reproduzem inline diretamente, sem recodificação — cada vídeo nesta página é o arquivo retornado diretamente pela API.
- “Áudio nativo” não produziu áudio. Cada um dos quatro clipes retornou como um MP4 silencioso, apenas vídeo — apesar de o modelo ter o rótulo “áudio nativo” e de meus prompts incluírem pistas sonoras (“ambiente sonoro suave de cafeteria”, “som potente de whoosh”). Os clipes de exemplo do próprio Q3 Mix da plataforma também são silenciosos. Planeje adicionar som na pós-produção, ou, se uma faixa de voz for indispensável, use um nível com entrada de áudio explícita — as receitas do Vidu Q4 Preview cobrem o fluxo de trabalho com referência de voz.
Reproduza qualquer receita com /v1/tasks
A referência para vídeo roda na API de tarefas assíncronas: envie a tarefa, consulte até o status ser success e então baixe o clipe em output[0].url (essa URL tem validade curta — salve o arquivo imediatamente).
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-mix/reference-to-video",
    "input": {
      "prompt": "O porta-filtro da imagem de referência 1 apoiado sobre a jarra de vidro da imagem de referência 2……",
      "reference_image_urls": [
        "https://your-host/dripper.png",
        "https://your-host/carafe.png"
      ],
      "duration": 5,
      "size": "1920*1080"
    }
  }'
# -> {"data":{"taskId":"tk-..."}}   depois GET /v1/tasks/tk-... até status == "success"
import requests, time

H = {"Authorization": f"Bearer {TOKEN}"}
job = requests.post("https://api.hiapi.ai/v1/tasks", headers=H, json={
    "model": "vidu-q3-mix/reference-to-video",
    "input": {"prompt": PROMPT, "reference_image_urls": REFS,
              "duration": 5, "size": "1920*1080"},
}).json()["data"]["taskId"]

while True:
    t = requests.get(f"https://api.hiapi.ai/v1/tasks/{job}", headers=H).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("clip.mp4", "wb").write(requests.get(t["output"][0]["url"]).content)
Regras de campos que vale conhecer antes de copiar as receitas:
reference_image_urlsaceita 1–7 imagens. Uma oitava retorna400 maxItems: want 7.durationé um inteiro de 1 a 16 segundos. Valores fracionários como4.5ou99são rejeitados no envio.- A forma é definida por
size, não poraspect_ratio— passaraspect_ratio(ouresolution) retorna400 additional properties not allowed. Os dez valores desizesão cinco proporções de tela em dois níveis, 720 e 1080; escolha um valor vertical para vertical e um horizontal para 16:9. - Não há campo de referência de áudio —
reference_audio_urlsé rejeitado. Se você precisar usar uma amostra de áudio para orientar a voz, esse é o nível Q4 Preview, não o Q3 Mix. - A cobrança por segundo (nível 720 vs nível 1080) está na página de preços; os quatro clipes aqui custaram cerca de $0.62–$0.93 cada. Itere a composição no
sizede nível 720 e depois reexecute a versão final em 1080.
Perguntas frequentes
Quantas imagens de referência o Q3 Mix consegue misturar? De uma a sete. Duas é o caso comum (sujeito + cenário); três ainda compõem de forma limpa, desde que cada imagem tenha um papel claramente distinto, como na receita do tênis acima. Acima de quatro, atribua tarefas explícitas e não sobrepostas a cada referência, ou o modelo começará a descartar a mais fraca.
Como controlar qual imagem é o sujeito e qual é o fundo?
Referencie-as por índice e atribua os papéis na mesma frase: “o tênis da imagem de referência 1…… contra o fundo da imagem de referência 3.” A ordem das URLs em reference_image_urls é a ordem dos índices — a imagem 1 é a primeira URL.
O Q3 Mix adiciona som automaticamente? Nos meus testes, não. Apesar do rótulo “áudio nativo”, todos os quatro clipes — e os exemplos do próprio Q3 Mix da plataforma — retornam como MP4 silencioso, mesmo quando os prompts incluem termos sonoros. Trate o Q3 Mix como um gerador apenas de imagem, adicione áudio na pós-produção ou mude para um nível com entrada de áudio explícita.
É possível obter 4K ou proporções de tela personalizadas?
Não há 4K — o Q3 Mix vai até valores de size de nível 1080. A proporção de tela é uma das cinco formas que você escolhe em size (horizontal, vertical, quadrada). Se precisar de 4K ou referência de voz, use o Vidu Q4 Preview.
Q3 Mix ou Q3 Ad — qual escolher?
A interface de chamada é quase idêntica (1–7 imagens, os mesmos dez valores de size, sem entrada de áudio), então os prompts podem ser portados quase sem alteração. Escolha o Q3 Ad quando a necessidade for um anúncio de produto — ele é ajustado para edição inteligente e movimentos de câmera de marketing; escolha o Q3 Mix para mistura genérica de múltiplos sujeitos. As tarifas por segundo são próximas, mas não idênticas; consulte a página de preços.
Por que minha mistura ignorou uma imagem de referência? Quase sempre é um problema de vinculação no prompt, não um limite do modelo. Se uma referência não tem um papel explícito na frase, ela compete com as outras e perde. Dê a ela um verbo e uma posição (“levanta a lata da imagem de referência 2”) e mantenha referências conflitantes separadas em escala.
Pronto para tentar? Abra a página do modelo vidu-q3-mix/reference-to-video, obtenha uma chave no início rápido e cole uma das receitas acima, substituindo pelas suas próprias URLs de referência. Quer planejar movimentos de câmera nas suas misturas? Os prompts de movimentos de câmera cinematográficos podem ser usados diretamente em qualquer uma delas.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores