
Guía de uso
Recetas de prompts de referencia a vídeo de Vidu Q3 Mix: fusiona varias imágenes en un solo plano
Cuatro prompts de referencia a vídeo listos para copiar y pegar, cada uno mezcla de 2 a 3 imágenes independientes —sujeto, escena y accesorios— en un único clip de q3-mix, con la salida real que generó en hiapi.
Resumen
- Cuatro prompts de referencia a vídeo listos para copiar y pegar para vidu-q3-mix/reference-to-video, cada uno acompañado del clip que generó realmente en hiapi —sin material de archivo ni una imagen fija en lugar del vídeo.
- Q3 Mix es el nivel de mezcla multiimagen: le das de 1 a 7 imágenes de referencia (personajes, objetos, escenas) y las combina en un plano en movimiento. Las recetas siguientes mezclan dos y tres imágenes fijas cada vez.
- Una regla que decide si la mezcla funciona: numera las imágenes de referencia y asigna a cada una una tarea explícita —«el goteador de la referencia 1 sobre la jarra de la referencia 2»—, nunca digas de forma vaga «combina estas».
- Verificado en esta ejecución: la mezcla de tres imágenes (sujeto + efecto + fondo) se compone de forma limpia, la salida tiene unos píxeles menos que el
sizenominal, el clip es H.264 (se reproduce directamente en el navegador, sin transcodificar) y —a pesar de la etiqueta «audio nativo»— cada clip se devuelve en silencio. - Copia un prompt, sustituye tus propias URL de referencia y haz POST a
/v1/tasks.
Por qué «mezclar» es un trabajo de prompts distinto
Vidu Q3 Mix (de ShengShu) es el nivel de referencia a vídeo pensado para mezclar varias imágenes a la vez —hasta siete—, combinando personajes, objetos y escenas en un solo clip. Si el prompt no le dice al modelo qué aporta cada imagen, esa capacidad se desperdicia.
Un hábito que separa una mezcla limpia de una turbia: numera las imágenes de referencia y asigna a cada una una tarea explícita. Escribe «el goteador de la referencia 1 sobre la jarra de cristal de la referencia 2», no «combina estas dos en una escena de café». El modelo vincula cada sujeto con su índice; «combina estas» es justo donde la mezcla se desvía: pierde una referencia, promedia dos sujetos en uno o pega algo con la escala equivocada. La imagen 1 es la primera URL de reference_image_urls, la imagen 2 es la segunda, y así sucesivamente.
Todo lo siguiente usa este patrón. Cada receta enumera las imágenes fijas de referencia exactas que generé, el prompt completo que envié y el clip que generó en hiapi.
Receta 1 — dos productos, una escena principal (mezcla de dos imágenes)
La tarea clásica de «mezclar»: dos tomas de producto independientes que deben compartir un mismo encuadre. Le di a Q3 Mix un goteador de café de color negro mate y una jarra de cristal vacía —dos imágenes, dos objetos— y le pedí que se apilaran y prepararan la infusión.
Referencia 1 (goteador) y referencia 2 (jarra de cristal):
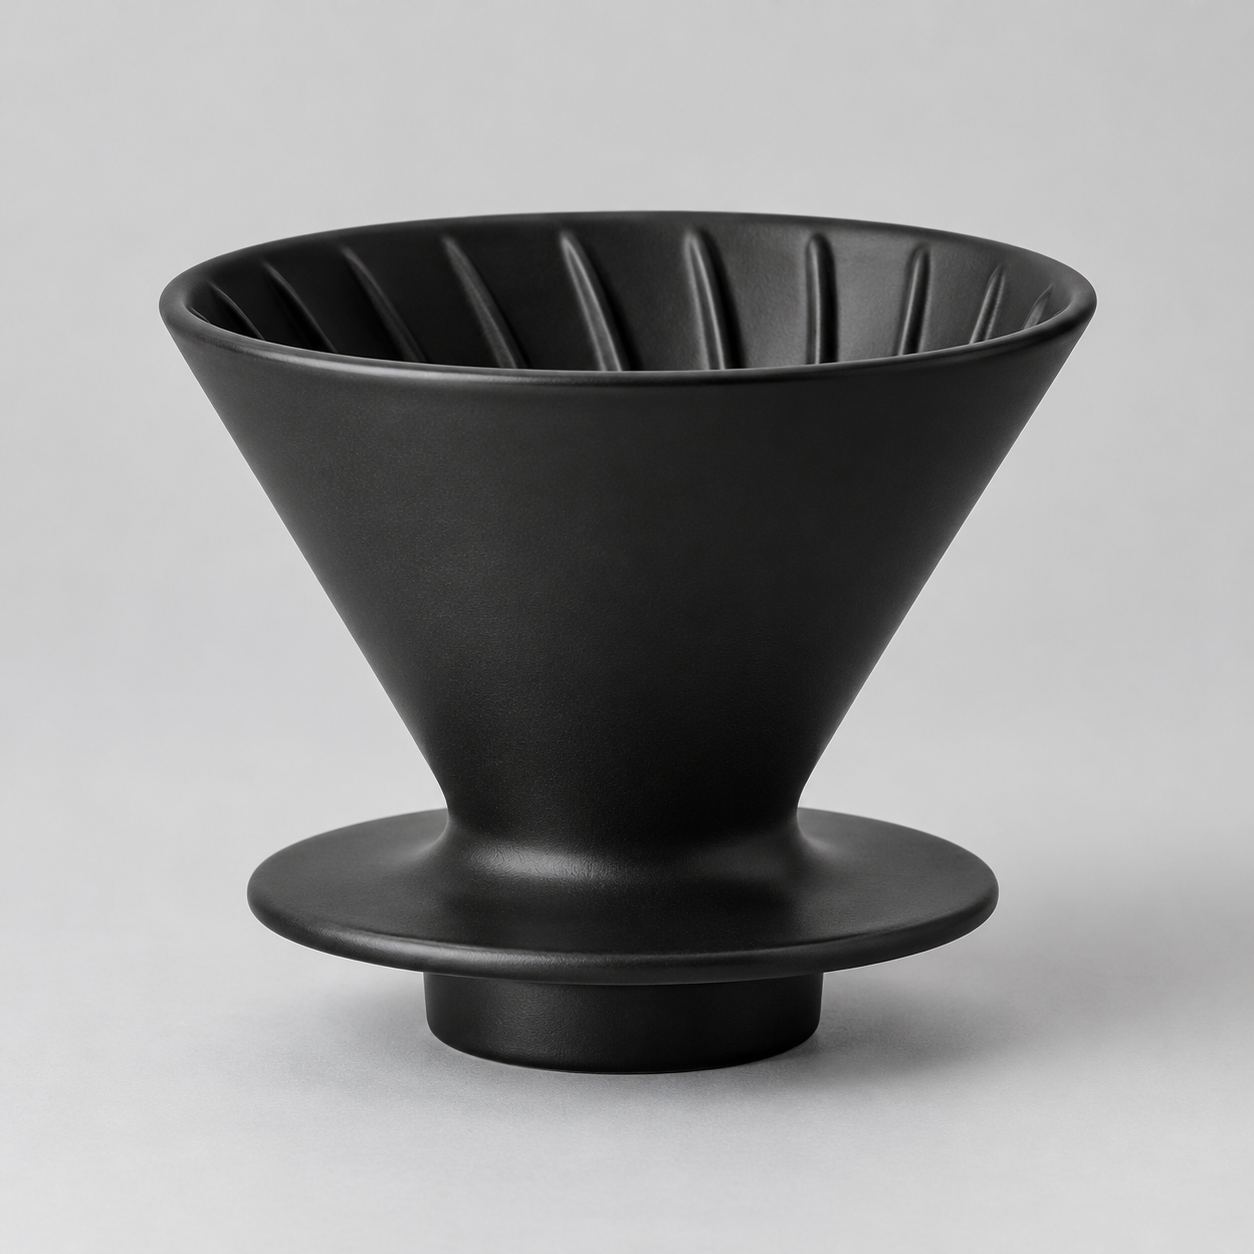
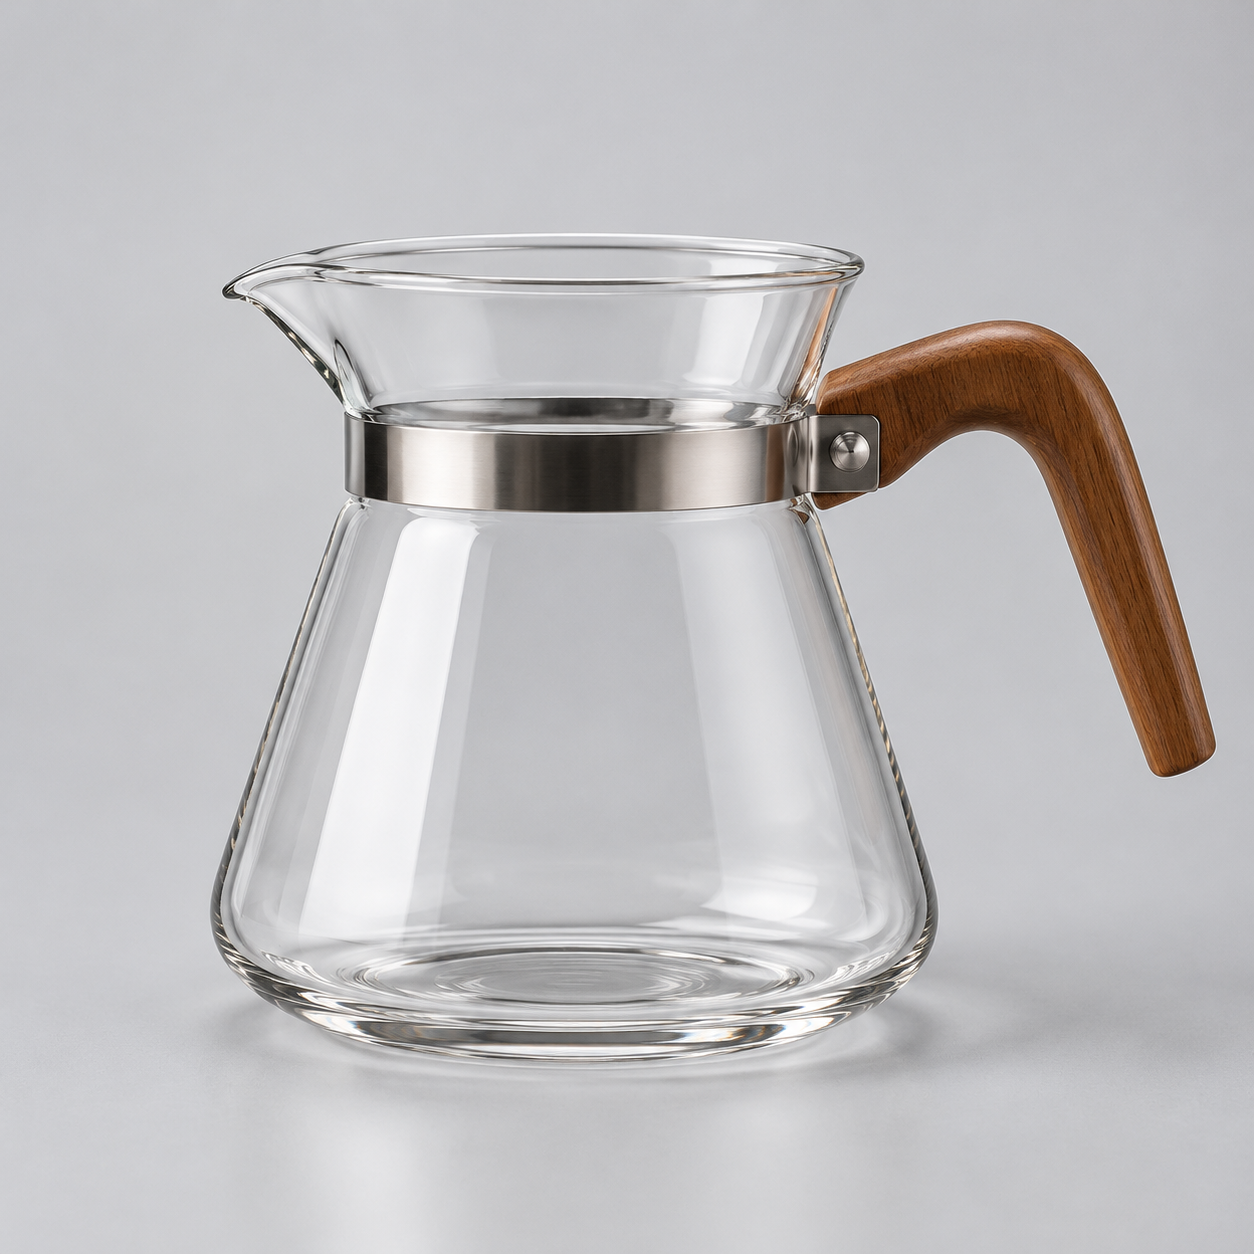
El goteador de café de cerámica negra mate de la referencia 1 se apoya con estabilidad sobre la jarra de café de cristal transparente de la referencia 2, ambas juntas sobre una barra de cafetería de hormigón claro. Lento acercamiento de cámara, un fino chorro de café recién hecho empieza a gotear del goteador en la jarra, el vapor asciende en espirales y la cálida luz de la mañana entra en diagonal por la ventana de la izquierda. Calidad de anuncio de producto premium, profundidad de campo reducida, suave ambiente sonoro de cafetería.
Qué se mezcló y qué inventó el modelo. Ambos objetos quedaron colocados correctamente: el goteador de la imagen 1 se apoya sobre la jarra de la imagen 2, con la proporción relativa bien y unas formas muy fieles a las imágenes fijas. Todo lo que hay entre los dos productos —la barra de hormigón, la cafetería desenfocada al fondo, la luz de la ventana, el café que cae en la jarra, el vapor— lo inventó el modelo; ninguna de las dos referencias lo contenía. Ese es el modelo mental útil de Q3 Mix: tú anclas los objetos, él rellena el mundo que los rodea. La cámara ejecutó el único acercamiento que pedí. Renderizado a 1920*1080 durante 5 s; el archivo entregado es 1914×1084 (mira «por debajo del tamaño nominal» más abajo); esta generación costó unos $0.93.
Receta 2 — colocar un personaje en una habitación nueva (sujeto + escena)
La segunda mezcla habitual es sujeto más entorno: una imagen aporta quién y otra aporta dónde. Rendericé un peluche robótico sobre fondo blanco puro y un dormitorio infantil luminoso sin personajes, y luego le pedí al modelo que colocara el primero en el segundo.
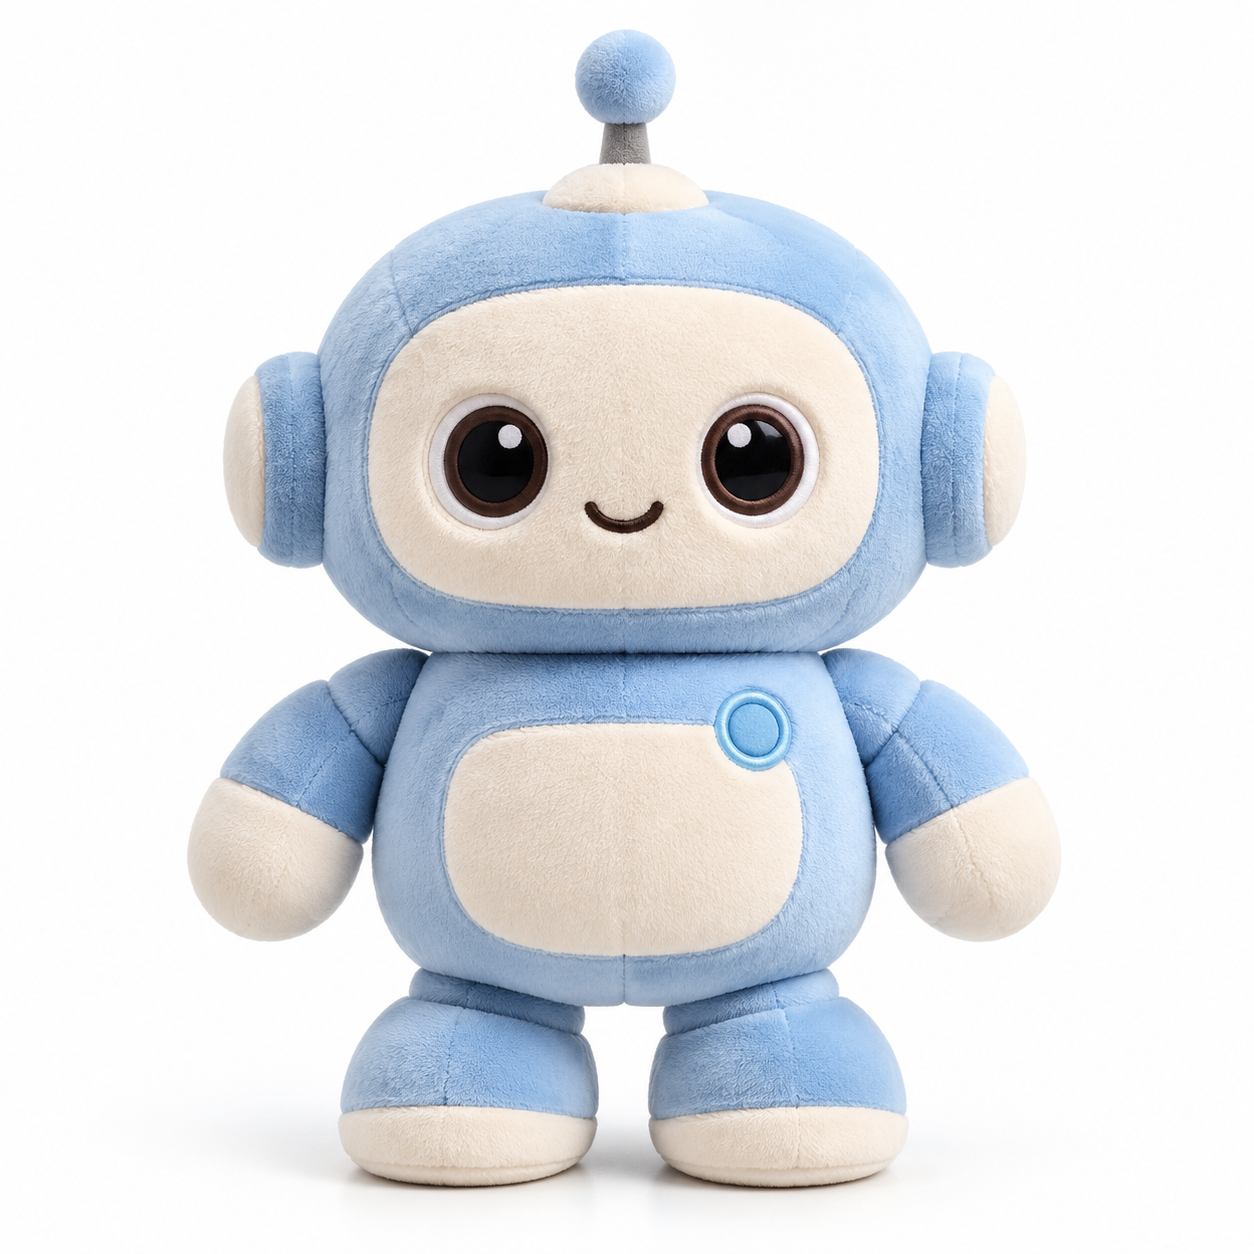
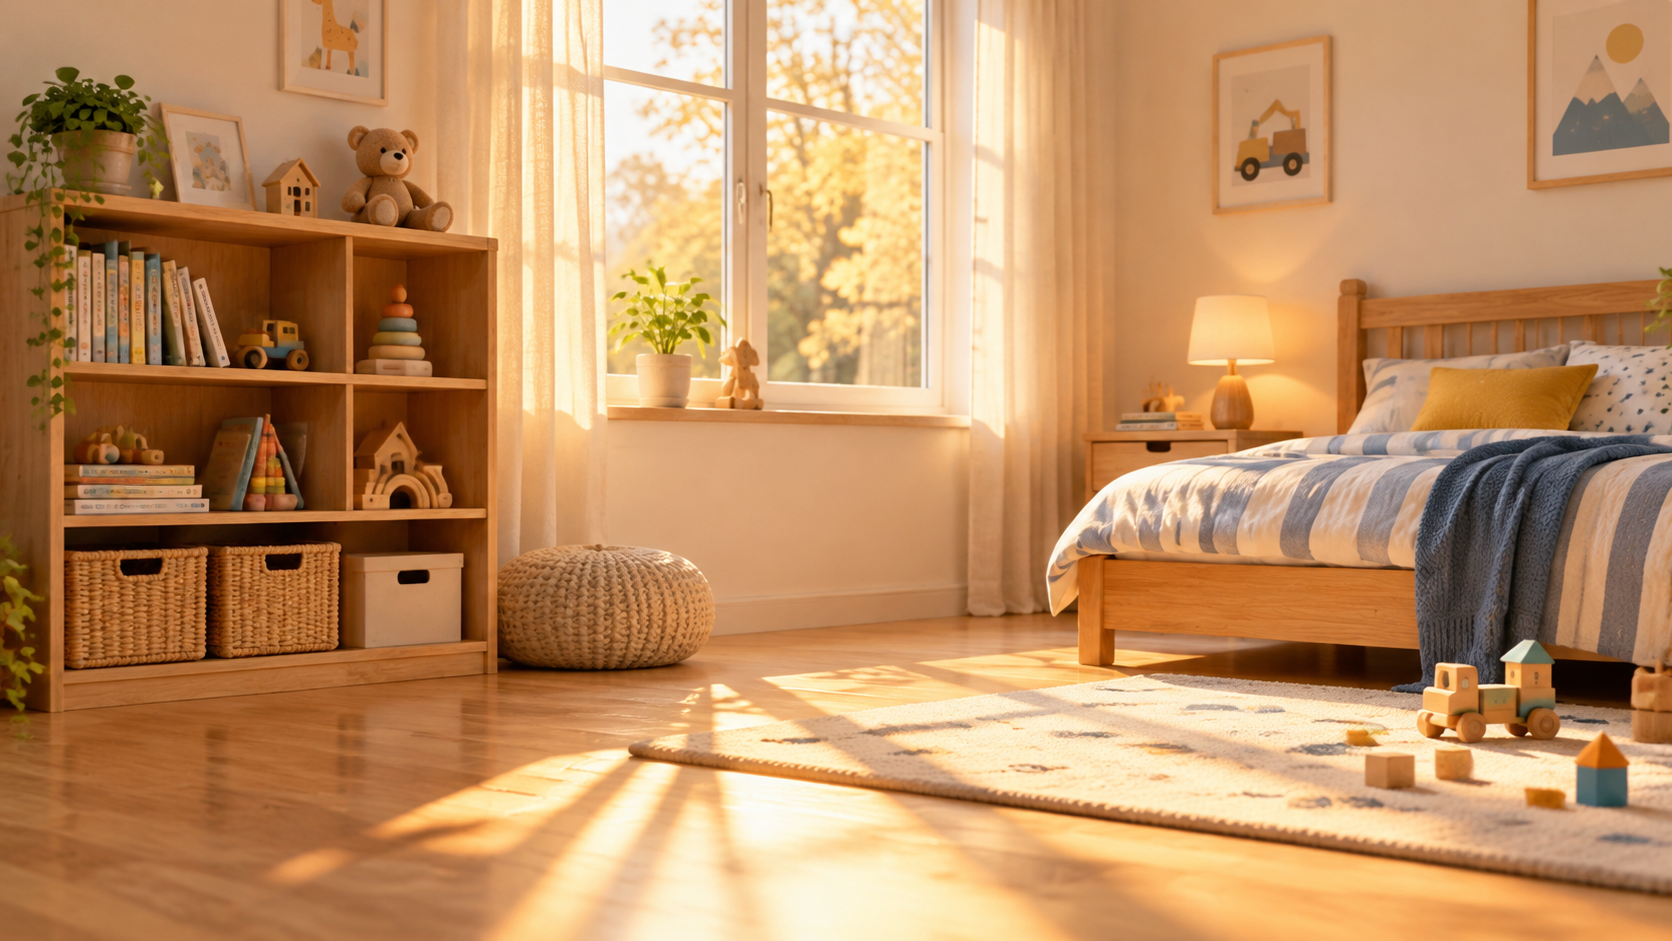
El peluche robótico de color azul claro de la referencia 1 está sentado en el suelo de madera del dormitorio infantil luminoso de la referencia 2. Inclina lentamente la cabeza y levanta un brazo corto para saludar a la cámara, partículas de polvo flotan en la cálida luz de la ventana, suave acercamiento de cámara en mano. Ambiente suave, alegre y cinematográfico, leve sonido de fondo de la habitación.
Qué se mezcló y qué inventó el modelo. El dormitorio de la imagen 2 se conservó casi tal cual: la estantería, la cama de rayas, la ventana y su luz, los bloques de construcción sobre la alfombra, todo permaneció en la composición. El robot de la imagen 1 se colocó en ese suelo y se adaptó a la luz cálida, de modo que parece estar dentro de la habitación y no superpuesto. Ejecutó la acción que especifiqué (inclinar la cabeza y levantar el brazo para saludar) y la cámara hizo el acercamiento en mano. Este es el patrón «personaje en escena»: deja que una referencia cargue con todo el entorno y el modelo volverá a iluminar al sujeto para que encaje. 1280*720, 5 s, unos $0.78.
Receta 3 — tres imágenes, un plano: sujeto + efecto + fondo
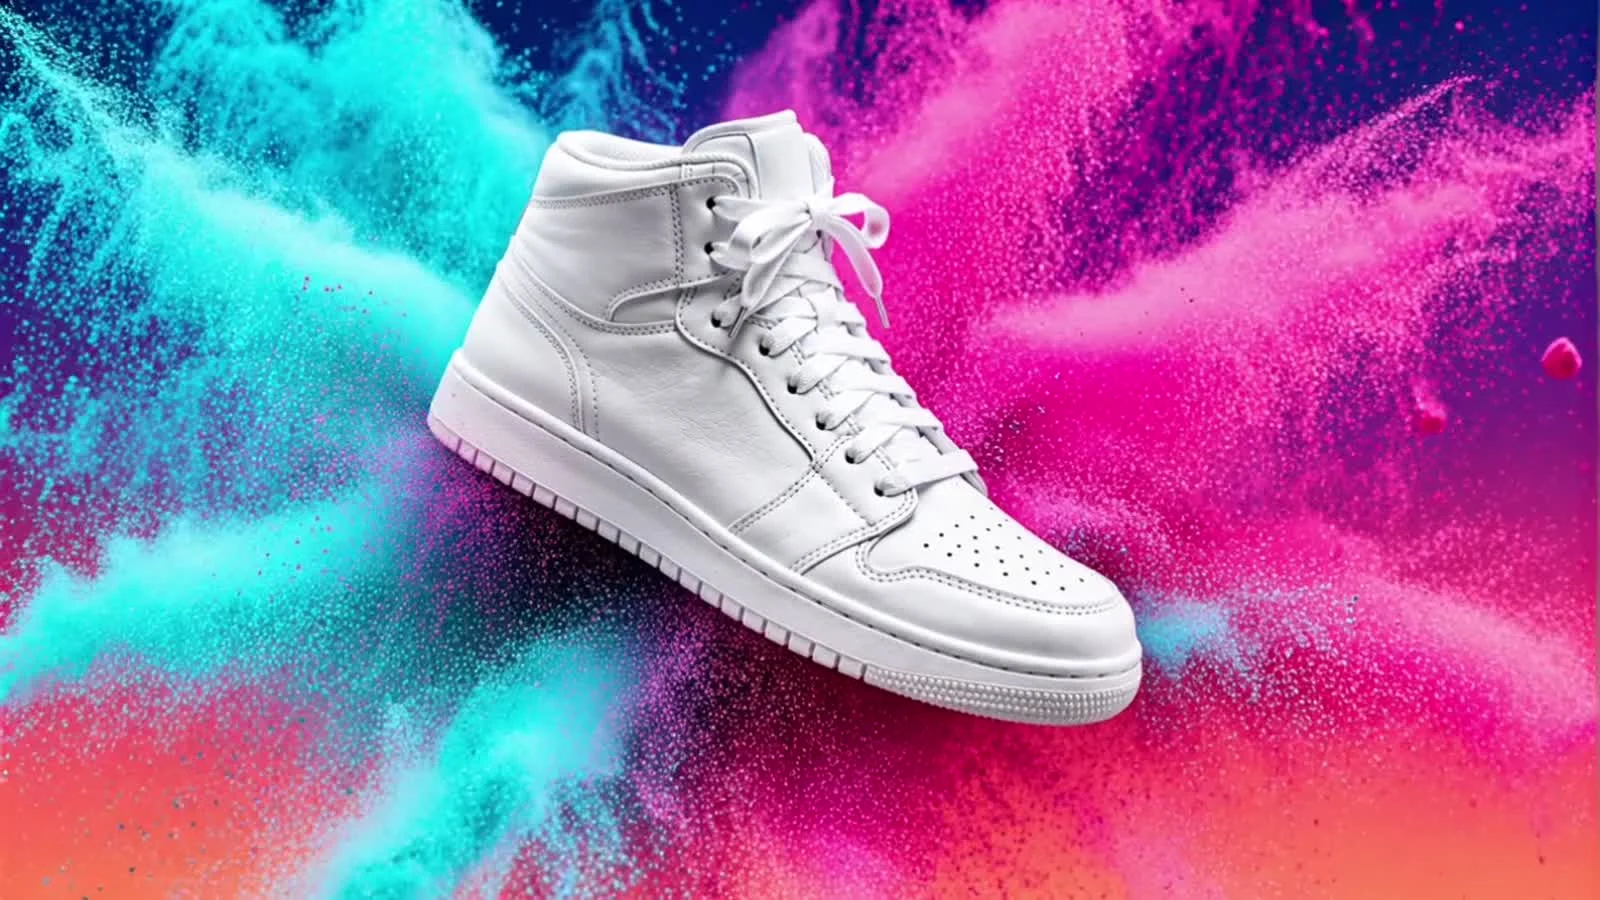
Esta receta justifica el nombre de «mezclar». Tres imágenes fijas independientes —una zapatilla deportiva, una explosión de polvo de color y un fondo degradado—, cada una con una tarea marcadamente distinta, se mezclan en una enérgica toma de producto.
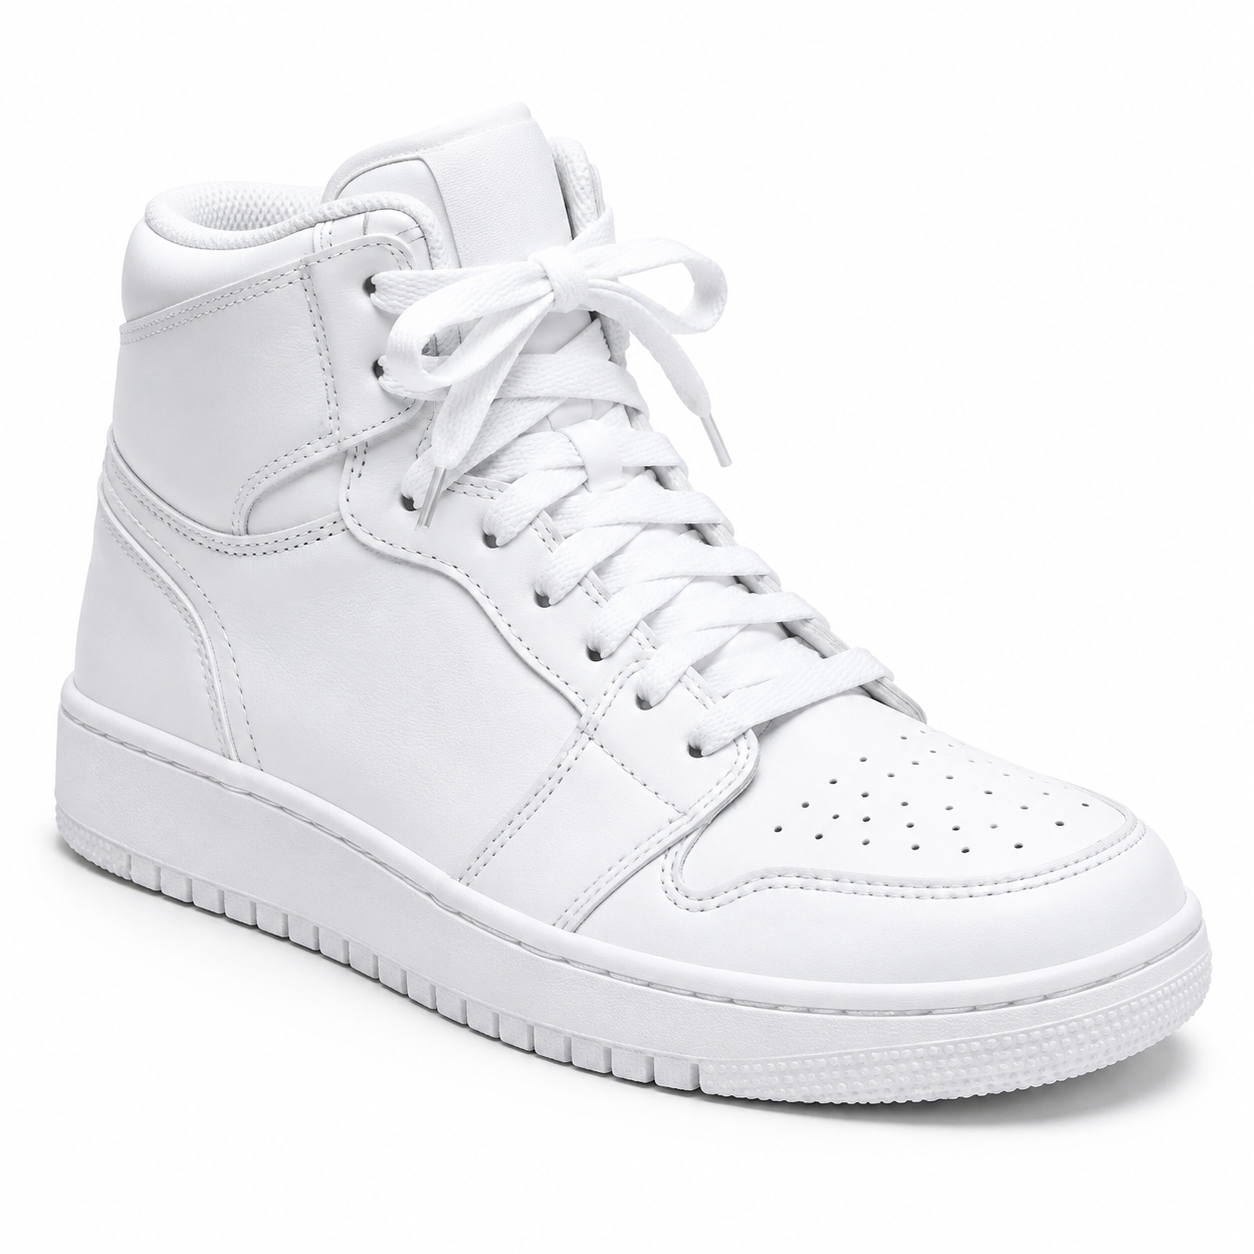
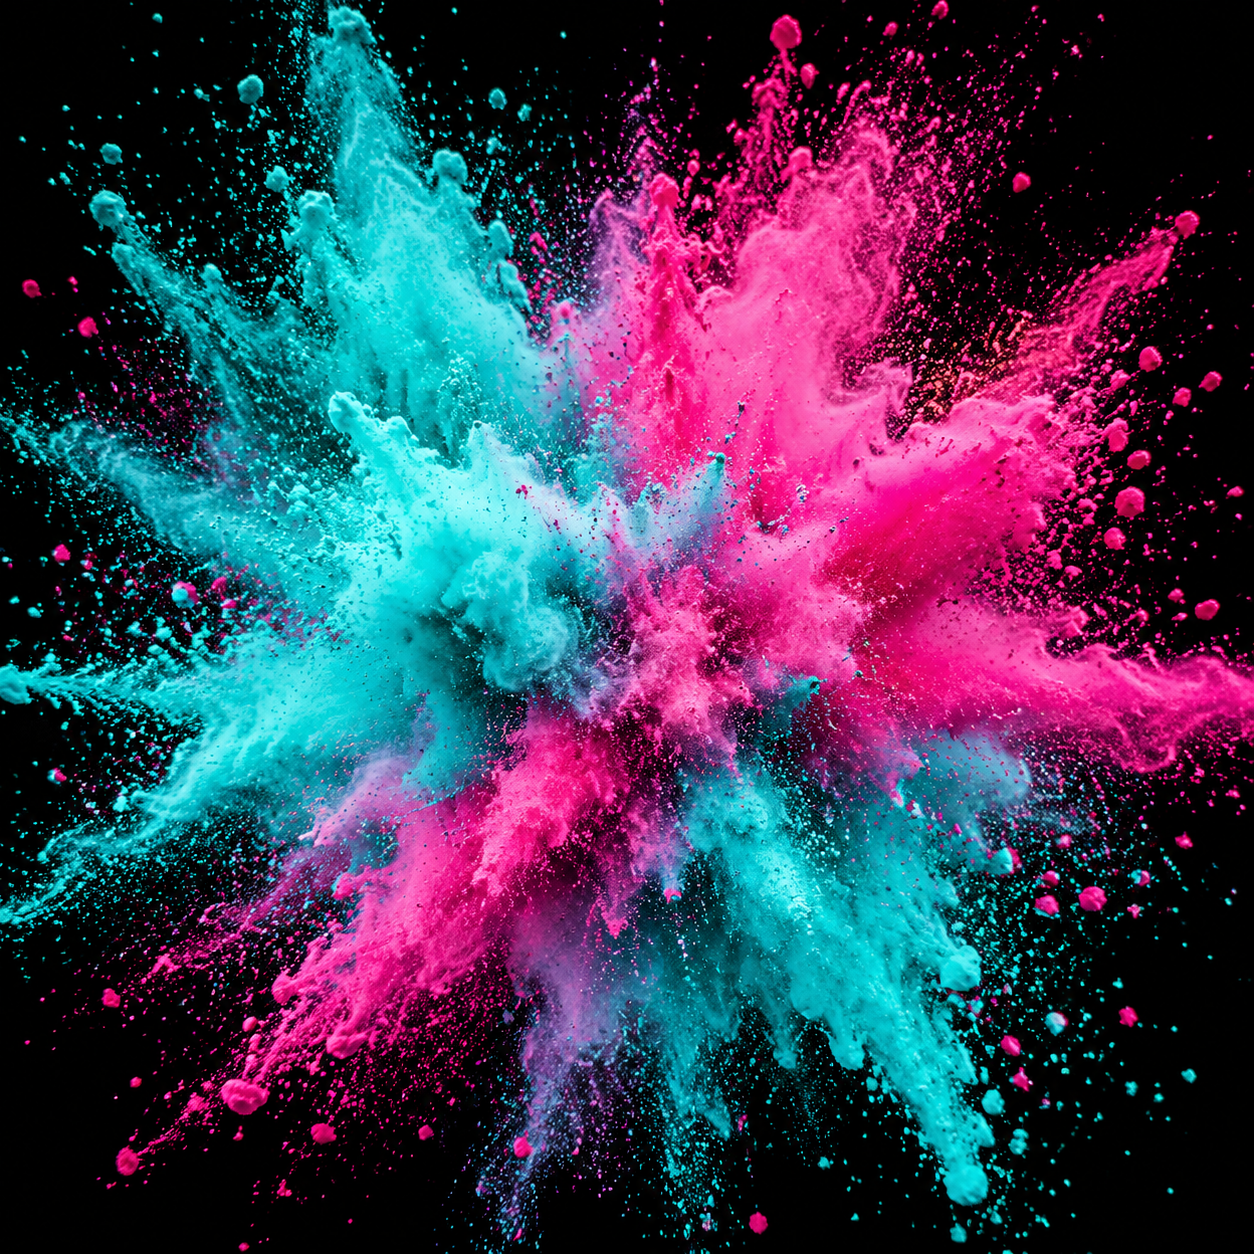
La zapatilla deportiva blanca de caña alta de la referencia 1 flota en el centro sobre el fondo degradado de índigo a coral de la referencia 3, mientras el polvo turquesa y magenta de la referencia 2 estalla hacia fuera a cámara lenta. La cámara se desplaza en arco cuarenta y cinco grados alrededor de la zapatilla y la estela de polvo gira y cae. Anuncio de zapatilla deportiva lleno de energía, iluminación de estudio dramática, potente silbido.
Qué se mezcló y qué inventó el modelo. Las tres referencias aparecen y mantienen su papel: la zapatilla es el sujeto, el polvo turquesa y magenta es el efecto que la envuelve y el degradado de índigo a coral es inequívocamente el fondo. El arco de cámara que pedí se ve: la zapatilla gira respecto al encuadre a lo largo de cinco segundos. La razón por la que tres imágenes se mantienen juntas aquí, mientras que un prompt más vago las habría enturbiado, es que cada referencia asume una tarea no solapada en la frase (sujeto / efecto / fondo) y las cito por índice, incluida la referencia 3 para el fondo, citada fuera de orden. A partir de tres o cuatro referencias, esta disciplina deja de ser opcional: asigna a cada imagen una tarea clara o el modelo descartará en silencio la más débil. 1280*720, 5 s, unos $0.78. (Este fotograma es la portada del artículo.)
Receta 4 — vertical para redes: una mascota presenta el producto
La última es una mezcla 9:16 para redes: una imagen es la mascota de la marca y la otra es el producto que va a vender. La tarea es que el personaje sostenga el producto, en vertical, listo para el feed.
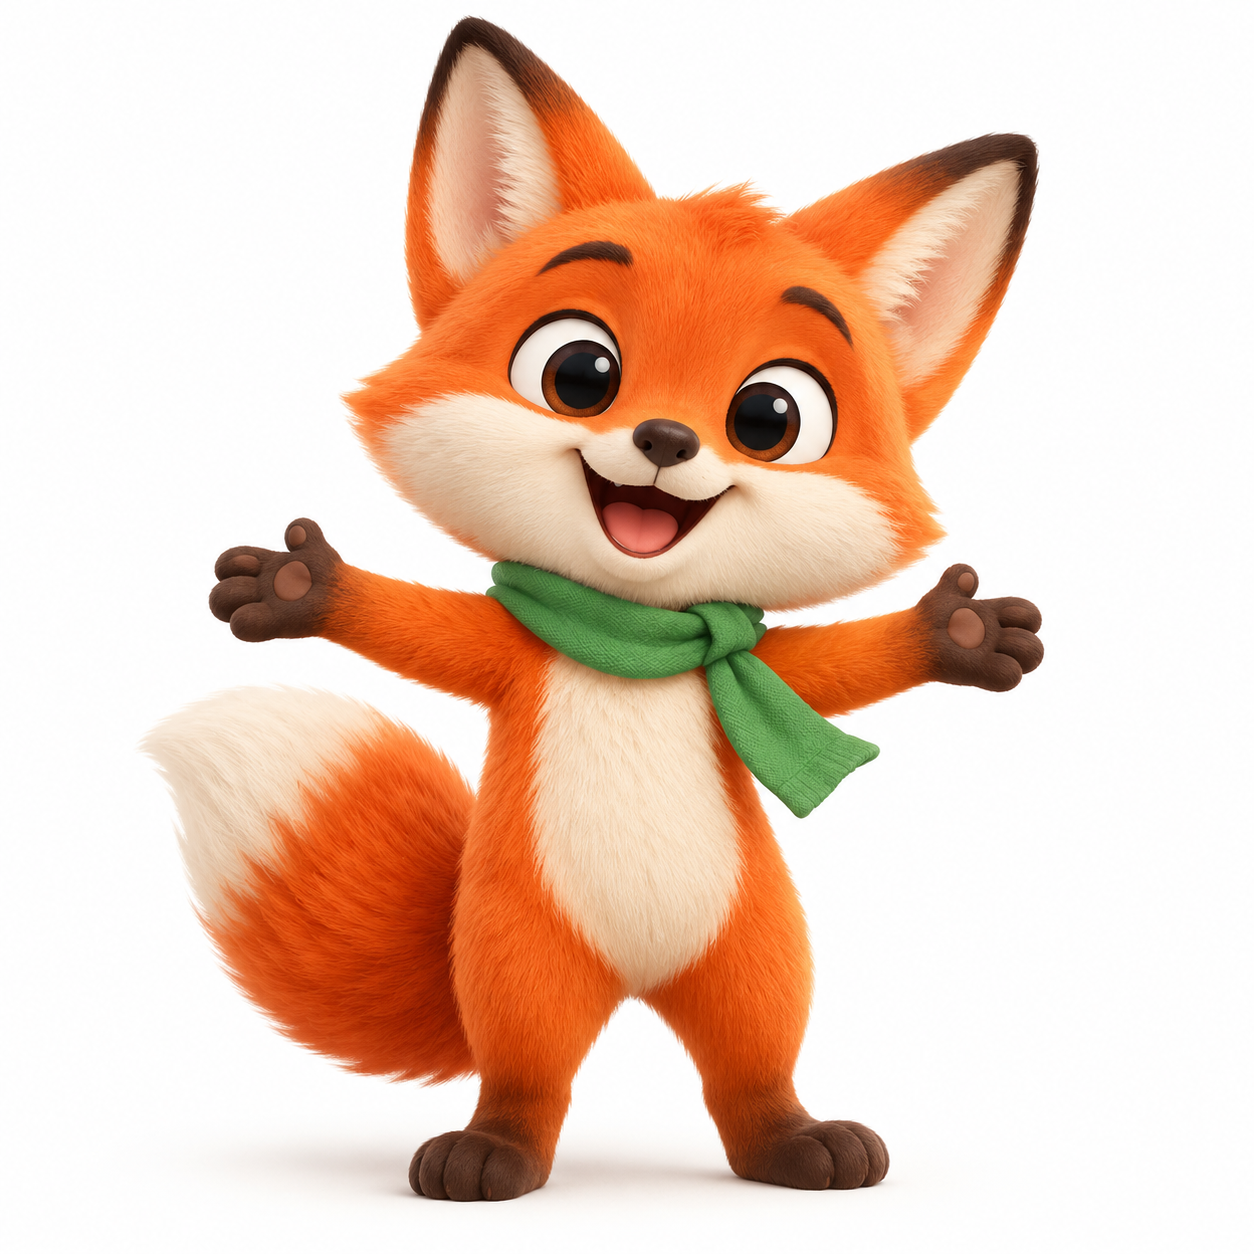
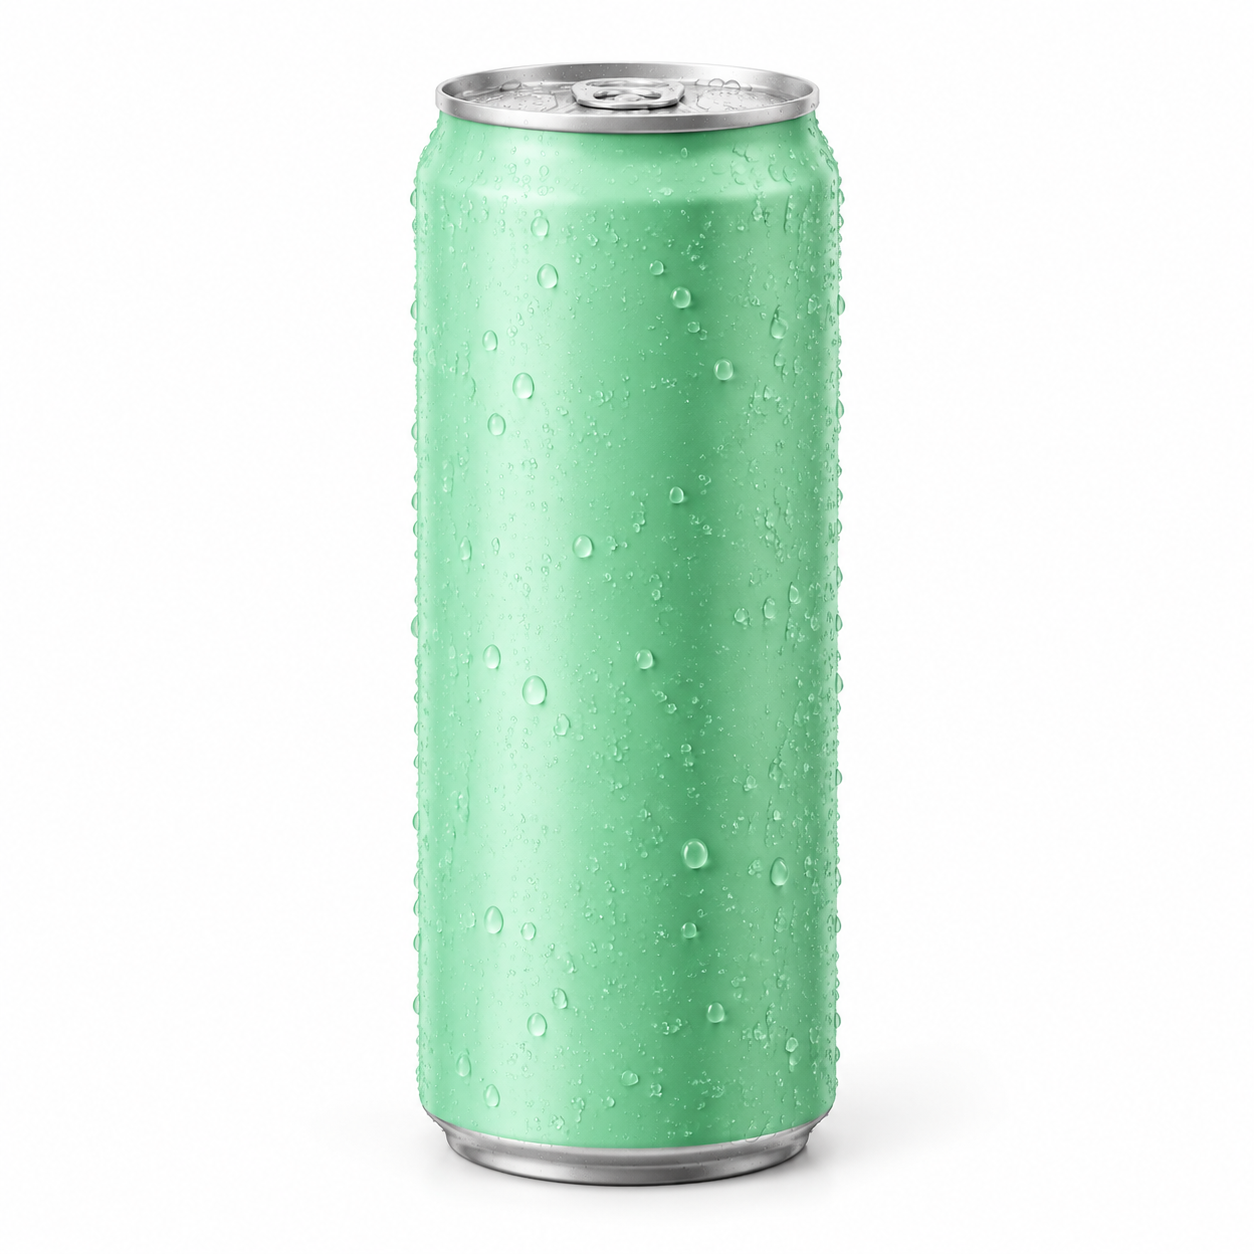
Plano vertical. La mascota de zorro de dibujos animados naranja de la referencia 1 levanta la lata de agua con gas de color verde menta de la referencia 2 y se la muestra a la cámara con un pequeño salto alegre, fondo de estudio de colores pop brillantes, confeti cayendo. Anuncio social desenfadado, iluminación potente y alegre, alegre sonido de burbujas.
Qué se mezcló y qué inventó el modelo. El zorro mantuvo el diseño de la imagen 1 (pelaje naranja, bufanda verde, ojos grandes), la lata conservó el acabado verde menta mate de la imagen 2 y las patas del personaje la rodean: el verbo «levantar… mostrar a la cámara» vincula ambas referencias en una sola acción en lugar de dos objetos que comparten encuadre. El fondo de colores pop y el confeti son inventados. Hay que elegir un size vertical (720*1280) para que sea vertical; no existe un campo aspect_ratio (más detalles abajo). 4 s, unos $0.62.
Lo que aprendí al ejecutar estas recetas
Cinco cosas que conviene saber antes de gastar créditos, todas sacadas de esta tanda de pruebas:
- El vínculo por índice es la clave. Cada clip de aquí respetó «X de la referencia N». Cuando quieras que dos sujetos interactúen, dale a la acción un verbo que los conecte («levantar», «colocar sobre»), en lugar de enumerarlos uno al lado del otro.
- Tú anclas los objetos; el modelo inventa el tejido conector. La barra de la cocina, la luz de toda la habitación, el confeti, el polvo giratorio: nada de eso está en las referencias. Para «sujeto en escena» eso es una virtud, pero también significa que todo lo que necesites conservar tiene que venir de las imágenes de referencia.
- Los píxeles entregados son algo menores que el
sizenominal.1920*1080se devuelve como 1914×1084,1280*720como 1276×722 y720*1280como 722×1276. Suficientemente cerca para la web, pero no fijes medidas exactas en código aguas abajo. - La salida es H.264, lista para incrustar. A diferencia del nivel 4K, que entrega HEVC, estos clips se reproducen en línea directamente, sin recodificar: cada vídeo de esta página es el archivo que devolvió la API tal cual.
- El «audio nativo» no produjo audio. Los cuatro clips se devolvieron como MP4 solo de vídeo y en silencio, a pesar de que el modelo lleva la etiqueta «audio nativo» y de que mis prompts incluían indicaciones sonoras («suave ambiente sonoro de cafetería», «potente silbido»). Los clips de ejemplo de Q3 Mix de la propia plataforma también están en silencio. Prevé añadir el sonido en posproducción, o usa un nivel con entrada de audio explícita si la pista de voz es innegociable: las recetas de Vidu Q4 Preview cubren el flujo de trabajo con referencia de voz.
Reproduce cualquier receta con /v1/tasks
La referencia a vídeo funciona con la API de tareas asíncronas: envía la tarea, consulta hasta que el estado sea success y luego descarga el clip desde output[0].url (esa URL caduca pronto: guarda el archivo de inmediato).
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-mix/reference-to-video",
    "input": {
      "prompt": "El goteador de la referencia 1 se apoya sobre la jarra de la referencia 2...",
      "reference_image_urls": [
        "https://your-host/dripper.png",
        "https://your-host/carafe.png"
      ],
      "duration": 5,
      "size": "1920*1080"
    }
  }'
# -> {"data":{"taskId":"tk-..."}}   luego GET /v1/tasks/tk-... hasta status == "success"
import requests, time

H = {"Authorization": f"Bearer {TOKEN}"}
job = requests.post("https://api.hiapi.ai/v1/tasks", headers=H, json={
    "model": "vidu-q3-mix/reference-to-video",
    "input": {"prompt": PROMPT, "reference_image_urls": REFS,
              "duration": 5, "size": "1920*1080"},
}).json()["data"]["taskId"]

while True:
    t = requests.get(f"https://api.hiapi.ai/v1/tasks/{job}", headers=H).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("clip.mp4", "wb").write(requests.get(t["output"][0]["url"]).content)
Reglas de campos que conviene conocer antes de copiar una receta:
reference_image_urlsacepta de 1 a 7 imágenes. Una octava devuelve400 maxItems: want 7.durationes un entero de 1 a 16 segundos. Los decimales como4.5o valores como99se rechazan al enviar.- La forma se define con
size, no conaspect_ratio: enviaraspect_ratio(oresolution) devuelve400 additional properties not allowed. Los diez valores desizeson cinco relaciones de aspecto en dos niveles, 720 y 1080; elige un valor vertical para vertical y uno horizontal para 16:9. - No hay campo de referencia de audio:
reference_audio_urlsse rechaza. Si necesitas que una muestra de audio impulse la voz, ese es el nivel Q4 Preview, no Q3 Mix. - La facturación por segundo (nivel 720 frente a 1080) está en la página de precios; los cuatro clips de aquí costaron entre $0.62 y $0.93 cada uno. Itera la composición primero con un
sizede nivel 720 y luego vuelve a ejecutar la versión final en 1080.
Preguntas frecuentes
¿Cuántas imágenes de referencia puede mezclar Q3 Mix? De una a siete. Dos es el caso habitual (sujeto + escena); tres todavía se componen de forma limpia siempre que cada imagen asuma un papel claramente distinto, como en la receta de la zapatilla de arriba. A partir de cuatro, asigna a cada referencia tareas explícitas y no solapadas, o el modelo empezará a descartar la más débil.
¿Cómo controlo qué imagen es el sujeto y cuál el fondo?
Cítalas por índice y asigna los papeles en la misma frase: «la zapatilla de la referencia 1… sobre el fondo de la referencia 3». El orden de las URL en reference_image_urls es el orden de los índices: la imagen 1 es la primera URL.
¿Q3 Mix añade sonido automáticamente? En mis pruebas, no. A pesar de la etiqueta «audio nativo», los cuatro clips —y los propios ejemplos de Q3 Mix de la plataforma— se devolvieron como MP4 en silencio, incluso con palabras sonoras en el prompt. Trata Q3 Mix como un generador solo de imagen, añade el audio en posproducción o cambia a un nivel con entrada de audio explícita.
¿Se puede obtener 4K o una relación de aspecto personalizada?
No hay 4K: Q3 Mix llega como máximo a valores de size de nivel 1080. La relación de aspecto es una de las cinco formas que eliges en size (horizontal, vertical, cuadrada). Si necesitas 4K o referencia de voz, usa Vidu Q4 Preview.
Q3 Mix frente a Q3 Ad: ¿cuál elegir?
La interfaz de llamada es casi idéntica (de 1 a 7 imágenes, los mismos diez valores de size, sin entrada de audio), así que los prompts se pueden trasladar casi tal cual. Elige Q3 Ad cuando la necesidad sea un anuncio de producto: está ajustado para montaje inteligente y movimientos de cámara publicitarios; elige Q3 Mix para mezclas genéricas de varios sujetos. La tarifa por segundo es parecida, pero no idéntica; consulta la página de precios.
¿Por qué mi mezcla ignora una imagen de referencia? Casi siempre es un problema de vinculación en el prompt, no una limitación del modelo. Si una referencia no tiene un papel explícito en la frase, compite con las demás y pierde. Dale un verbo y una posición («levanta la lata de la referencia 2») y mantén alejadas en escala las referencias que compiten.
¿Listo para probarlo? Abre la página del modelo vidu-q3-mix/reference-to-video, consigue una clave en el inicio rápido y luego pega una receta de arriba sustituyendo tus propias URL de referencia. ¿Quieres planificar el movimiento de cámara dentro de una mezcla? Los prompts de movimientos de cámara cinematográficos encajan directamente en cualquiera de ellas.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores