
使用ガイド
Vidu Q3 Mix リファレンス動画生成プロンプトレシピ:複数の画像を単一のショットに融合する
そのままコピー&ペーストできるリファレンス動画生成プロンプト集。各プロンプトは 2〜3 枚の独立した画像——被写体、シーン、小道具——を 1 つの q3-mix クリップに混合するもので、hiapi 上で実際に生成した出力も併記しています。
概要
- vidu-q3-mix/reference-to-video 用の、そのままコピー&ペーストできるリファレンス動画生成プロンプト 4 つ。それぞれに hiapi 上で実際に生成したクリップを添付しています——ストック素材ではなく、静止画 1 枚で動画の代用をしたものでもありません。
- Q3 Mix は複数画像の混合階層です。1〜7 枚のリファレンス画像(キャラクター、物体、シーン)を渡すと、それらを 1 つの動的なショットに組み合わせます。以下のレシピはいずれも2 枚および 3 枚の静止画を混合します。
- 混合が成立するかどうかを決める 1 つのルール:リファレンス画像に番号を振り、各画像に明確な役割を割り当てること——「リファレンス画像 1 のドリッパーをリファレンス画像 2 のガラスポットの上に置く」のように書き、「これらを組み合わせて」のような曖昧な表現は決して使わないこと。
- 今回の実行で検証できたこと:3 枚混合(被写体 + エフェクト + 背景)はきれいに合成でき、出力ピクセルは公称の
sizeよりやや小さく、クリップは H.264(トランスコード不要でブラウザで直接再生可能)であり、さらに——「ネイティブオーディオ」タグがあるにもかかわらず——各クリップは無音で返ってきました。 - プロンプトを 1 つコピーし、自分のリファレンス URL に置き換えて
/v1/tasksに POST するだけです。
なぜ「混合」が別種のプロンプト作業なのか
Vidu Q3 Mix(ShengShu 製)は、複数の画像を同時に混合するために特化したリファレンス動画生成階層です——最大 7 枚まで、キャラクター、物体、シーンを 1 つのクリップに混合します。プロンプトがどの画像が何を提供するかをモデルに伝えなければ、この能力は無駄になります。
きれいな混合と濁った混合を分ける習慣が 1 つあります:リファレンス画像に番号を振り、各画像に明確な役割を割り当てること。「この 2 枚を組み合わせてコーヒーシーンにして」ではなく、「リファレンス画像 1 のドリッパーをリファレンス画像 2 のガラスポットの上に置く」と書きます。モデルは各被写体をそのインデックスに紐づけます。「これらを組み合わせて」こそが混合がずれる場所です——リファレンス画像を 1 枚失ったり、2 つの被写体を平均化して 1 つにしたり、誤った比率で何かを貼り付けたりします。画像 1 は reference_image_urls の最初の URL、画像 2 は 2 番目、以降同様です。
以下はすべてこのパターンを使っています。各レシピには、私が生成した正確なリファレンス静止画、送信した完全なプロンプト、そして hiapi 上で生成されたクリップを記載します。
レシピ 1 — 2 つの製品、1 つのキービジュアルシーン(2 枚混合)
古典的な「混合」タスク:2 つの独立した製品ショットが 1 つの画面を共有する必要があります。Q3 Mix にマットブラックのハンドドリップ用ドリッパーと空のガラスポット——2 枚の画像、2 つの物体——を渡し、それらを重ねて抽出するよう指示しました。
リファレンス画像 1(ドリッパー)と リファレンス画像 2(ガラスポット):
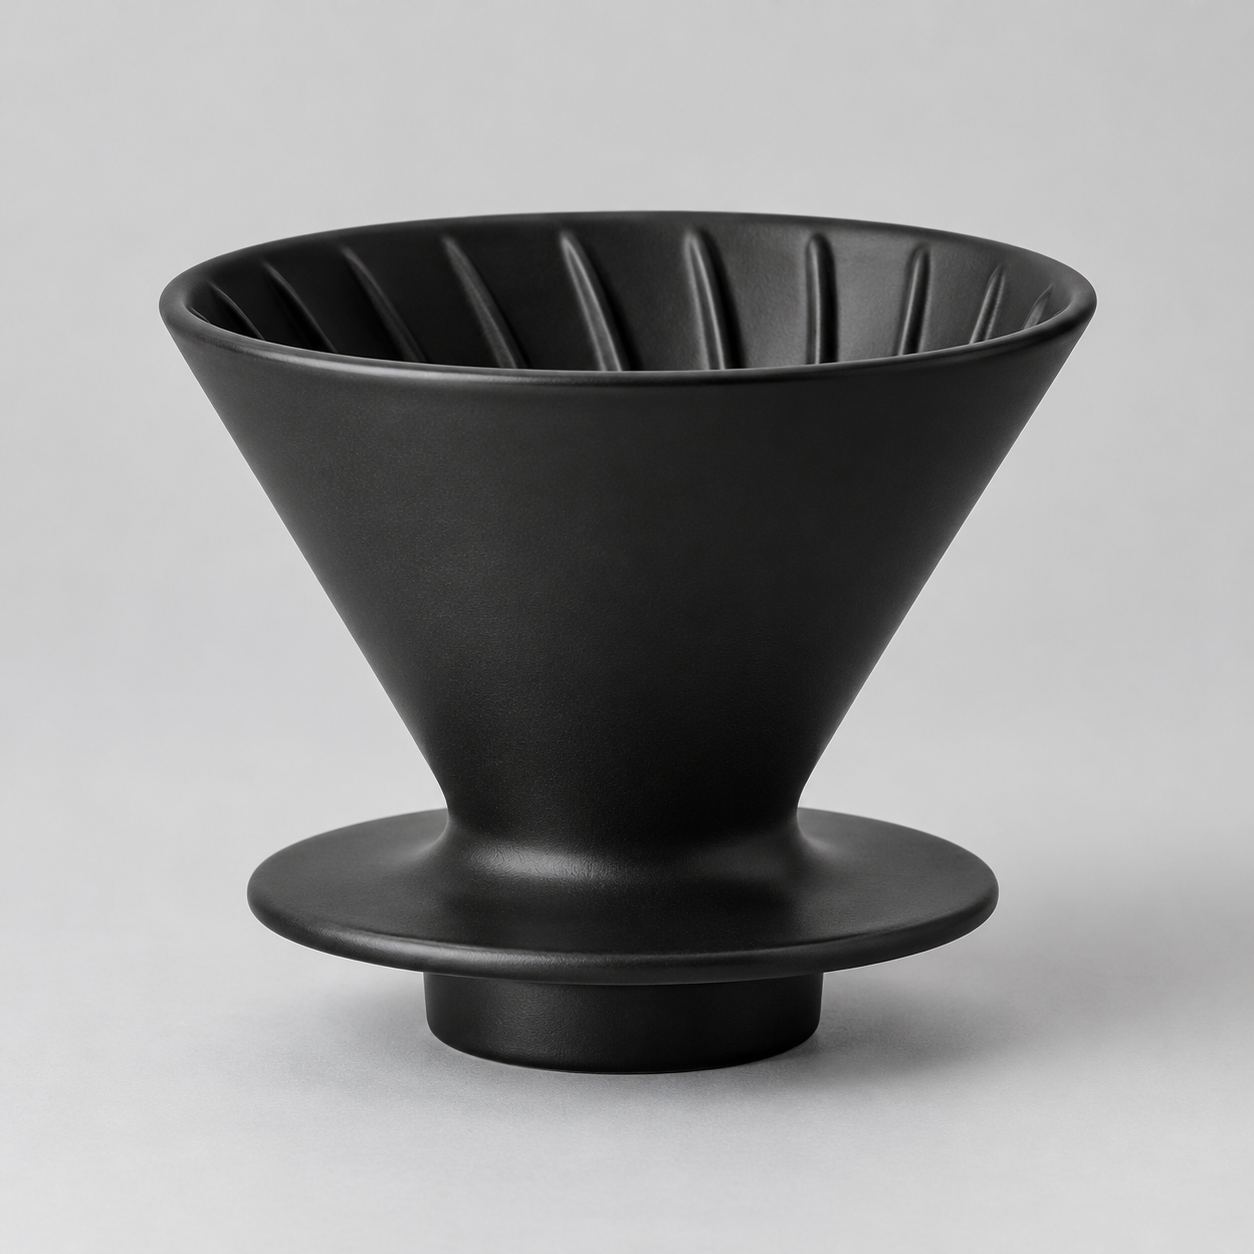
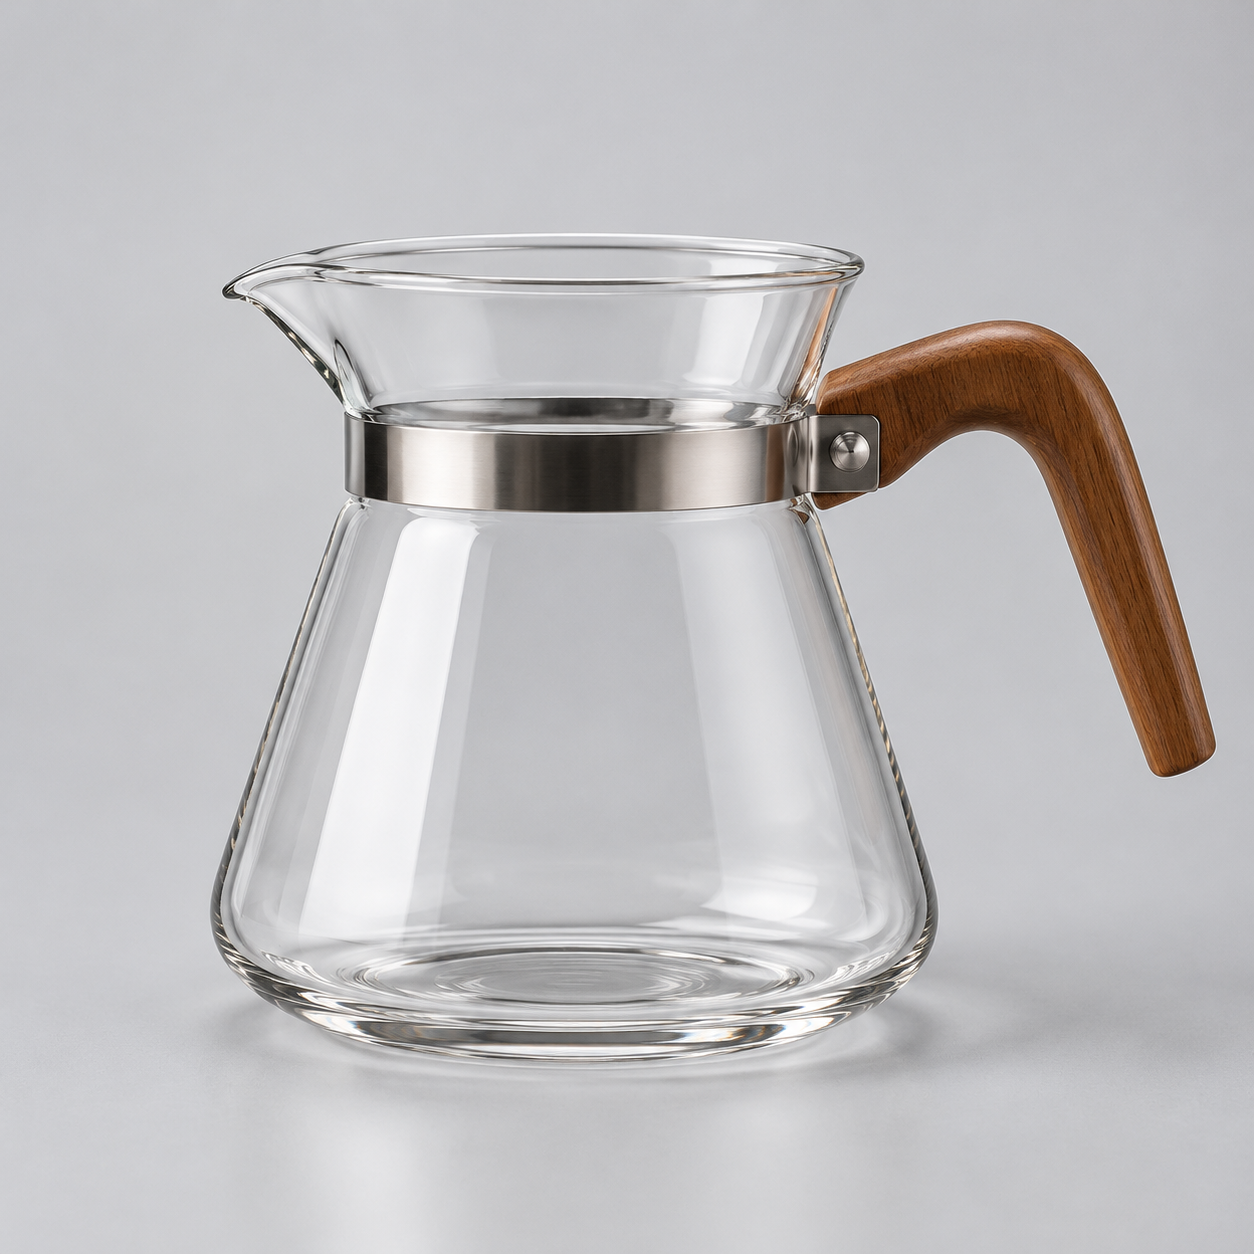
リファレンス画像 1 のマットブラックのセラミック製ハンドドリップ用ドリッパーが、リファレンス画像 2 の透明なガラス製コーヒーポットの上に安定して置かれ、両者は明るい色のコンクリート製カフェカウンターの上にある。ゆっくりとプッシュインするカメラ、ドリッパーから細いコーヒーの流れがポットに滴り始め、湯気が立ち上り、暖かな朝の光が左側の窓から斜めに差し込む。高級製品広告の質感、浅い被写界深度、穏やかなカフェの環境音。
何が混合され、モデルが何を発明したか。両方の物体が正しく配置されました:画像 1 のドリッパーが画像 2 のガラスポットの上に座り、相対的な比率も正しく、形状は静止画によく一致しています。2 つの製品の間にあるすべて——コンクリートのカウンター、奥にぼけたカフェ、窓の光、ポットに注がれるコーヒー、湯気——はモデルが発明したもので、どちらのリファレンス画像にも含まれていません。これが Q3 Mix の有用なメンタルモデルです:あなたが物体を固定し、モデルが周囲の世界を埋める。カメラは私が指示した 1 回のプッシュインを実行しました。1920*1080 で 5 秒レンダリングされ、納品ファイルは 1914×1084(後述の「公称サイズより小さい」を参照)、この生成のコストは約 $0.93 でした。
レシピ 2 — キャラクターを全く新しい部屋に配置する(被写体 + シーン)
2 つ目のよくある混合は被写体と環境です:1 枚の画像が誰を、もう 1 枚がどこを担当します。私は真っ白な背景のぬいぐるみロボットのおもちゃと、キャラクターのいない日当たりの良い子供部屋をレンダリングし、前者を後者に配置するようモデルに指示しました。
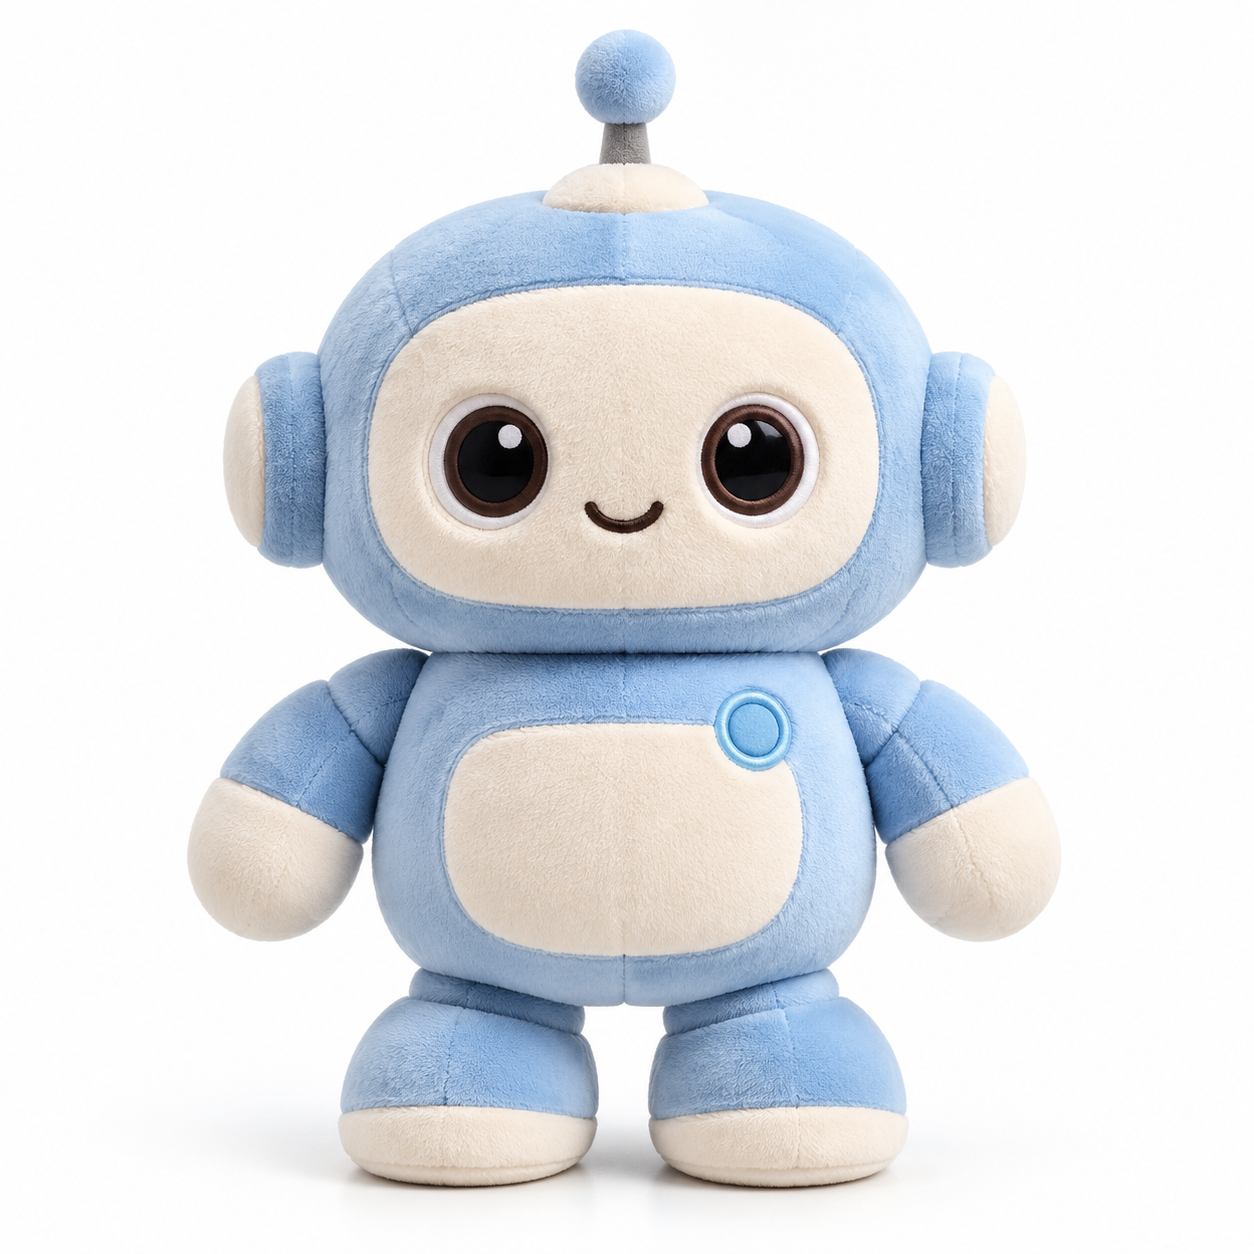
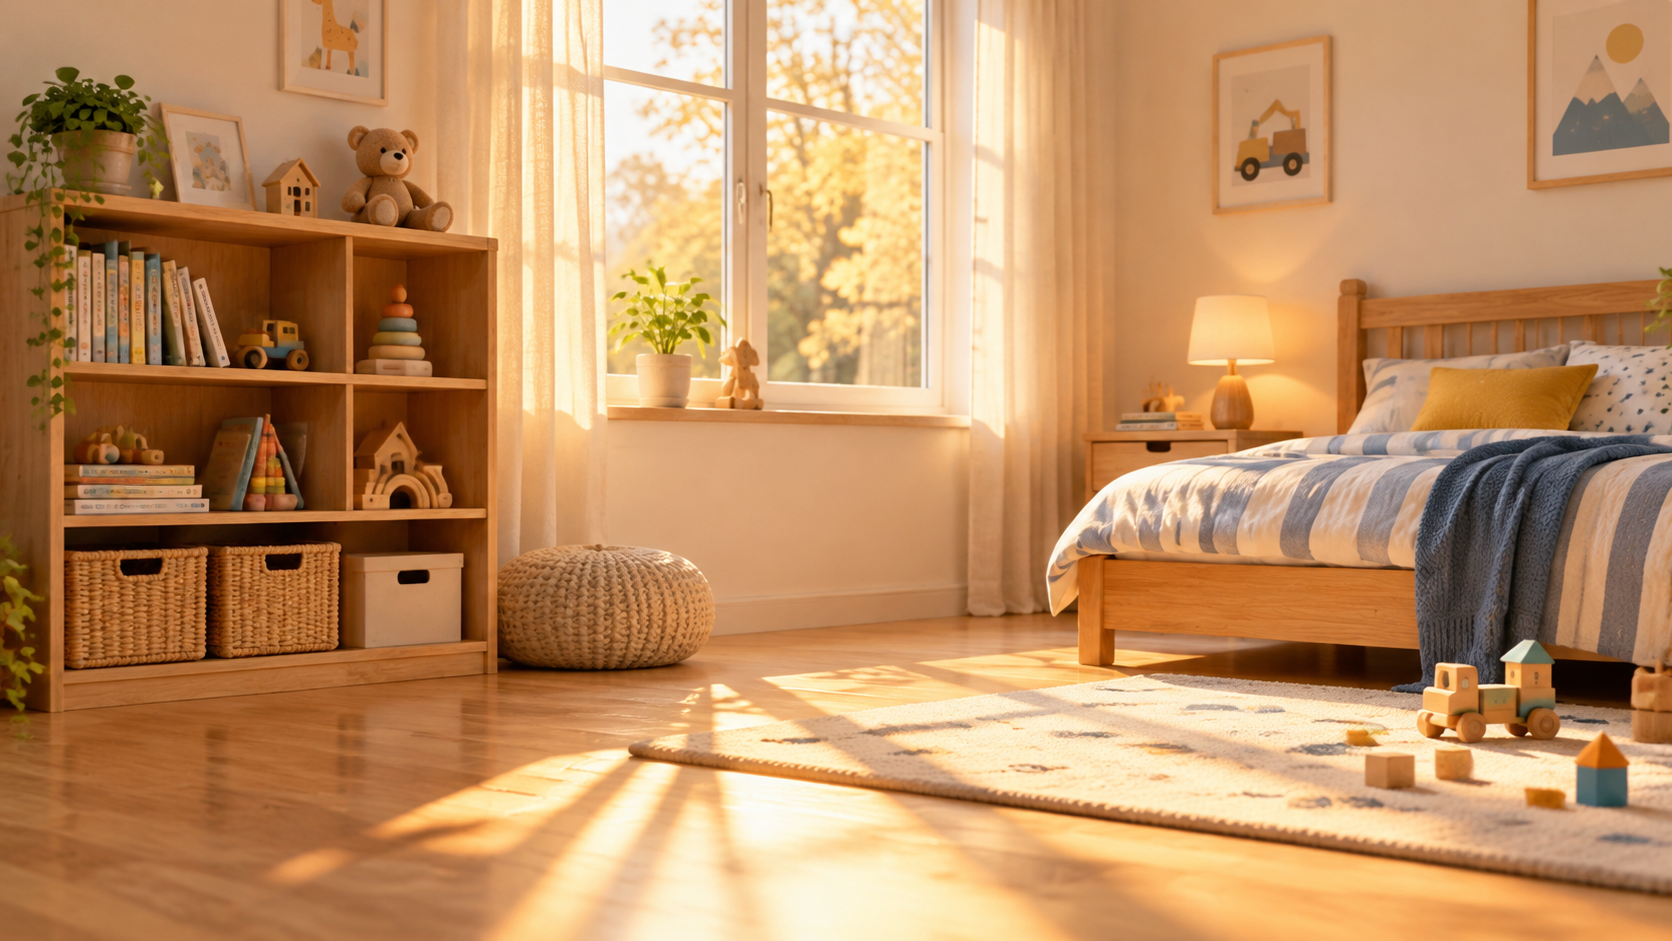
リファレンス画像 1 の淡いブルーのぬいぐるみロボットのおもちゃが、リファレンス画像 2 の日当たりの良い子供部屋の木の床に座っている。ゆっくりと首をかしげ、短い片腕を上げてカメラに向かって手を振り、暖かな窓の光の中で塵が漂い、柔らかな手持ちのプッシュイン。柔らかく、明るく、映画のような質感、かすかな室内の環境音。
何が混合され、モデルが何を発明したか。画像 2 の子供部屋はほぼそのまま保たれました——本棚、縞模様のベッド、窓とその光、ラグの上の積み木がすべて合成に残っています。画像 1 のロボットはその床に配置され、暖かな光に合わせて照射され、部屋の中にいるように見え、貼り付けたようには見えません。私が指定した動作(首をかしげ、腕を上げて手を振る)を実行し、カメラは手持ちのプッシュインを完了しました。これが「キャラクターをシーンに配置する」パターンです:1 枚のリファレンス画像に環境全体を背負わせれば、モデルは環境に合わせて被写体の照明を再調整します。1280*720、5 秒、約 $0.78。
レシピ 3 — 3 枚の画像、1 つのショット:被写体 + エフェクト + 背景
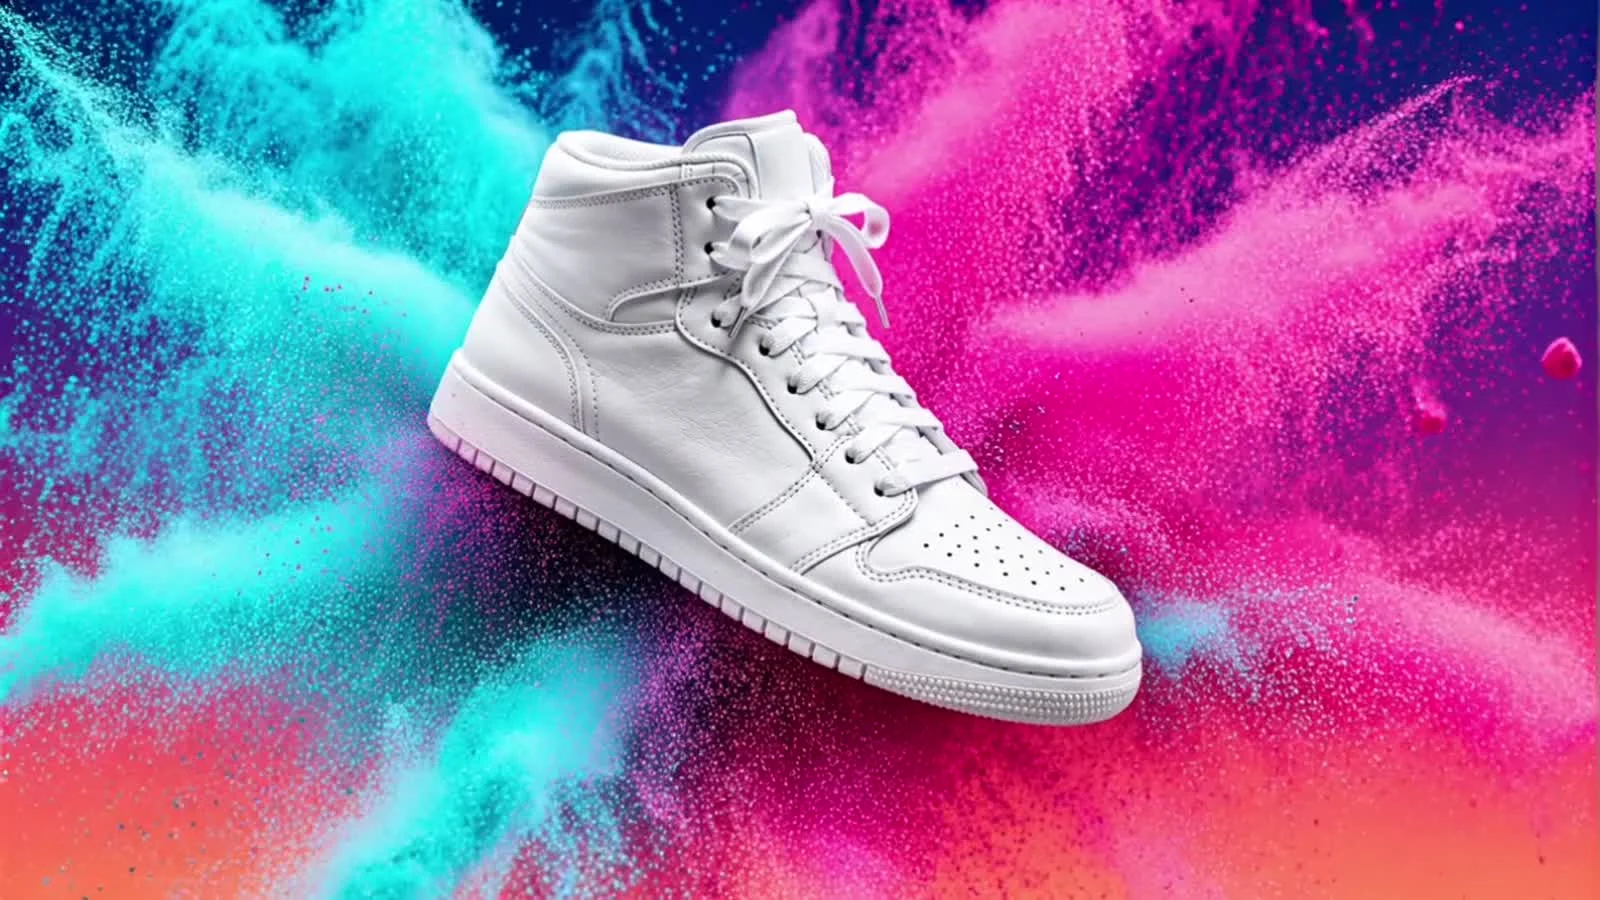
このレシピは「混合」の名を証明します。3 枚の独立した静止画——スニーカー、カラーパウダーの爆発、グラデーション背景——がそれぞれ明確に異なる役割を持ち、1 つの迫力ある製品ショットに混合されます。
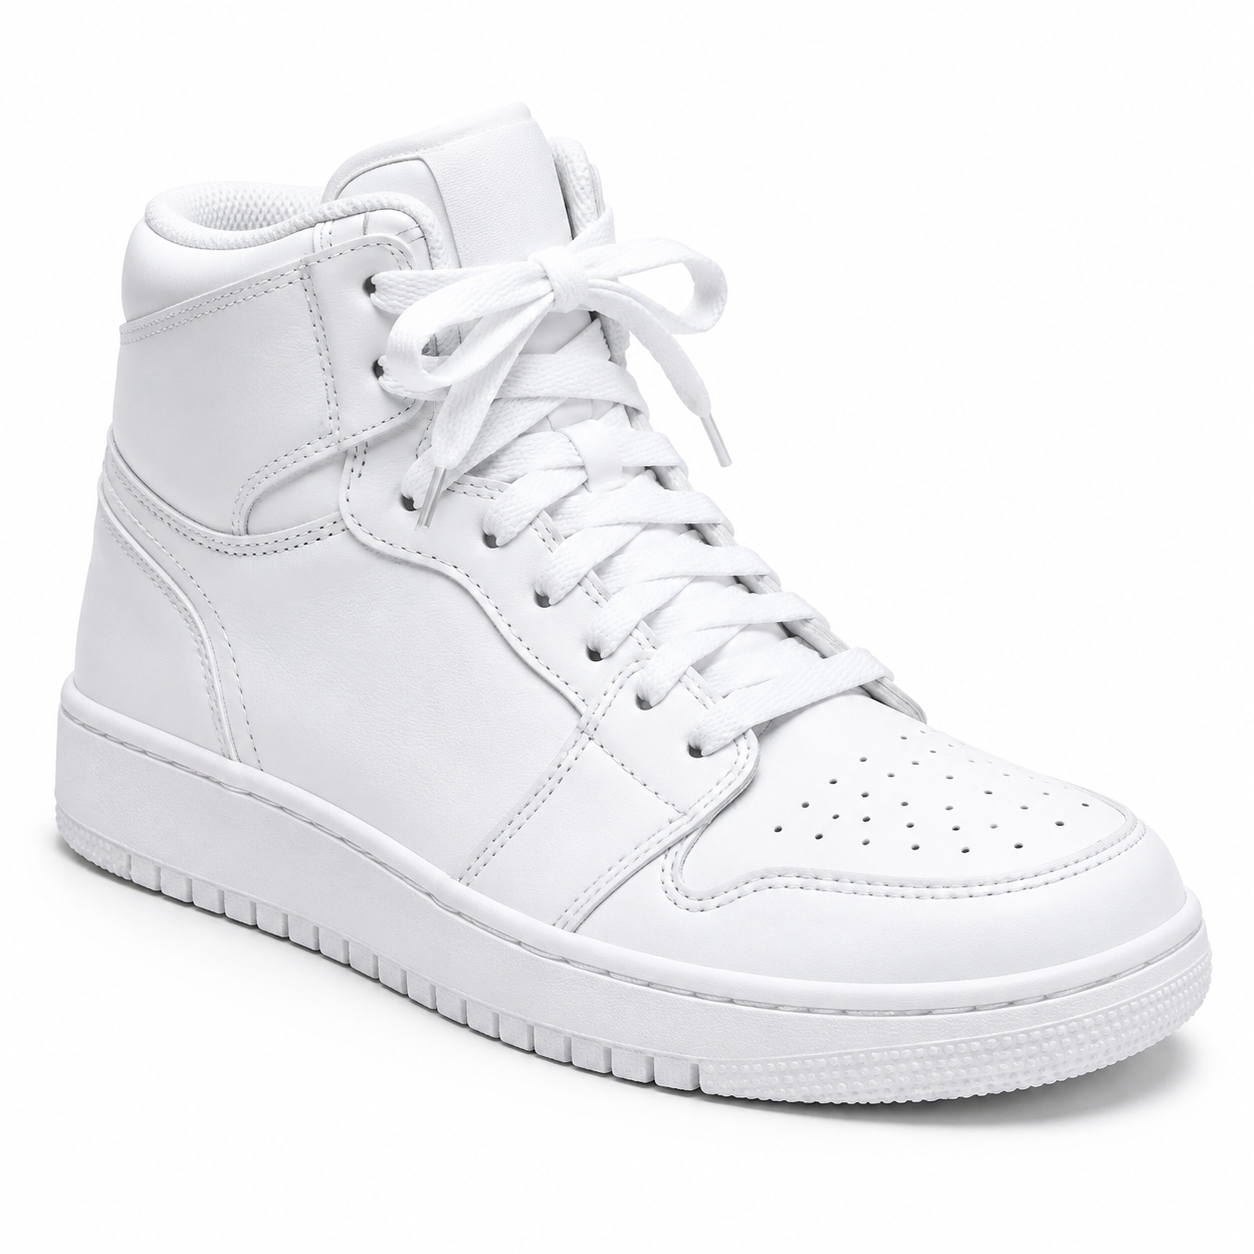
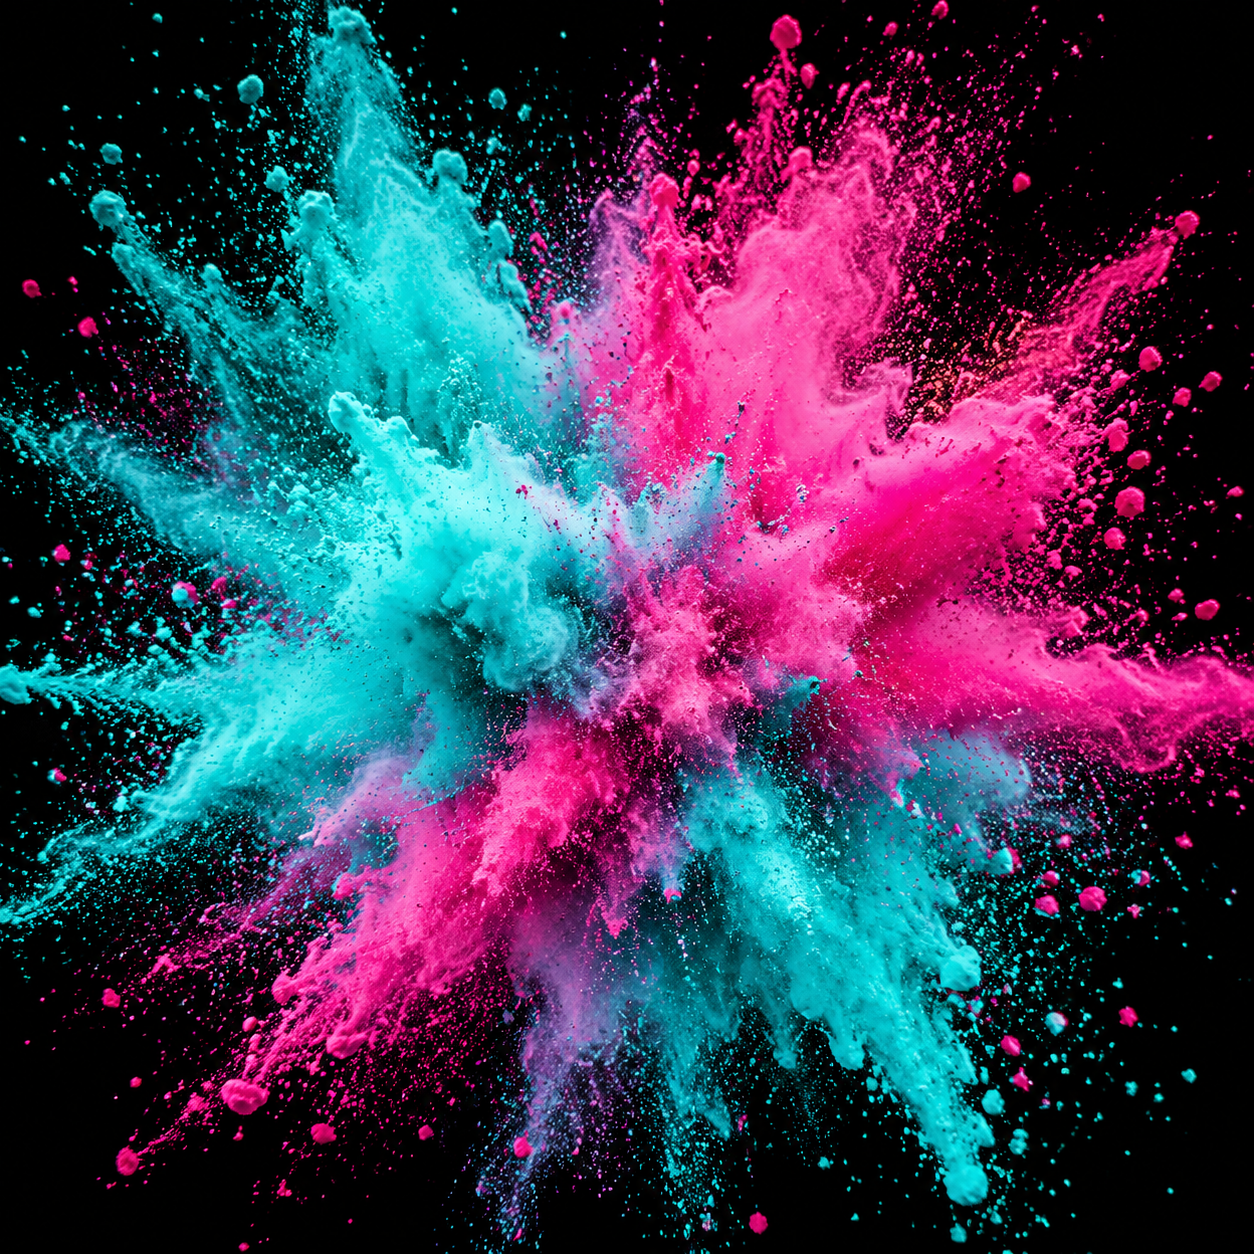
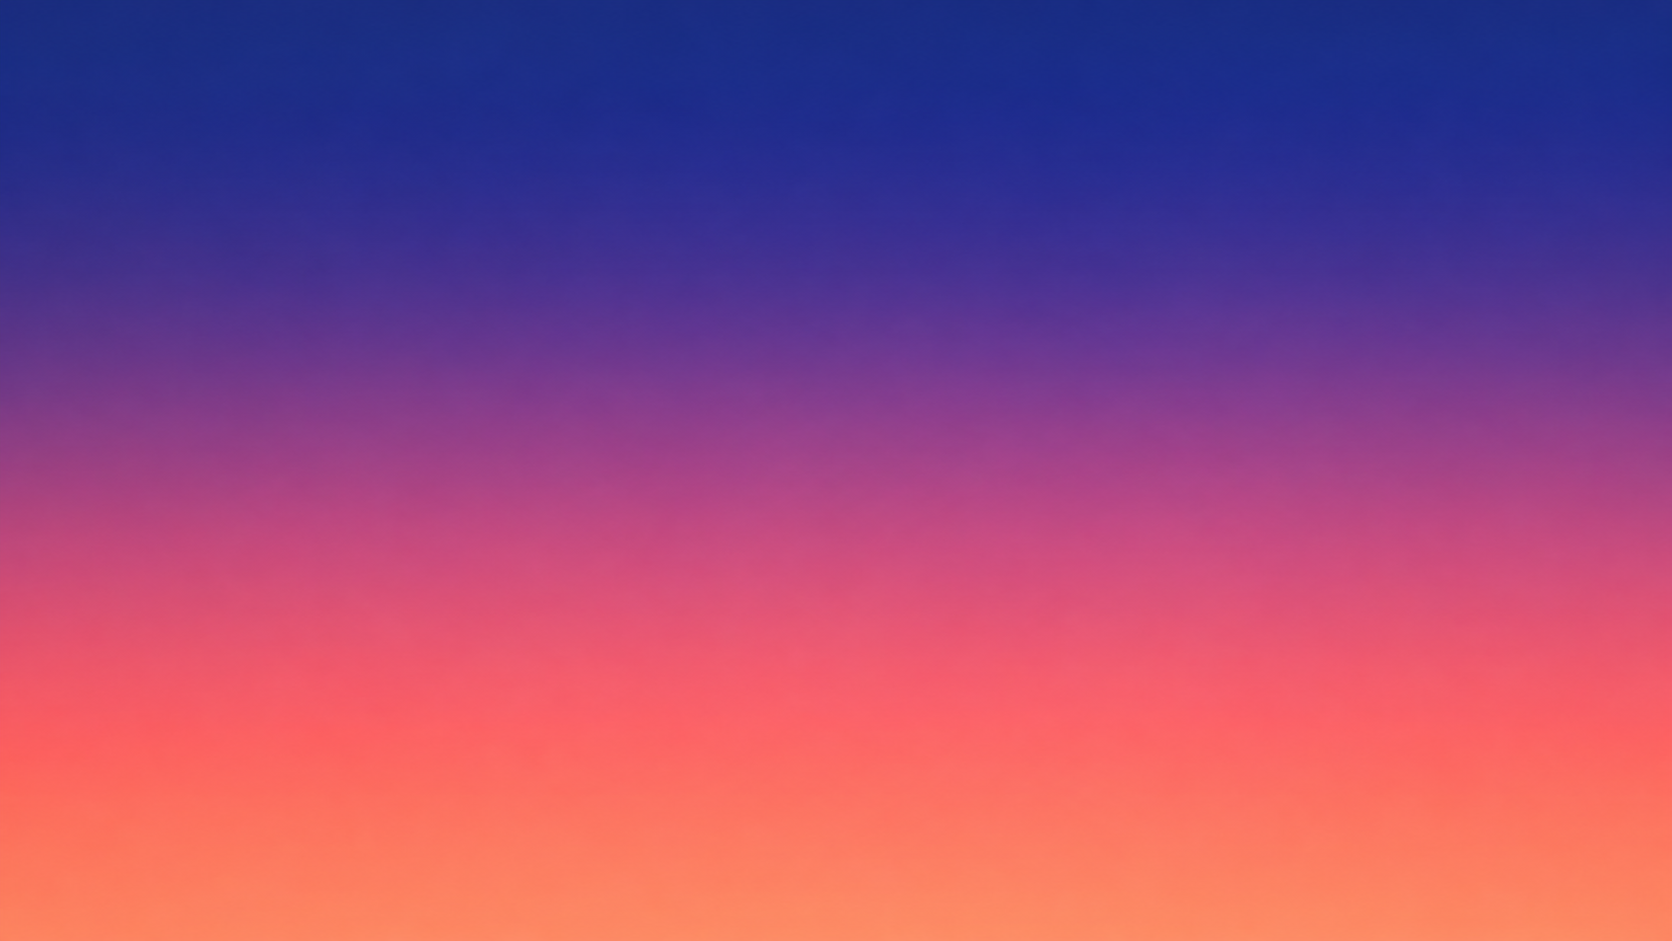
リファレンス画像 1 の白いハイカットスニーカーが中央に浮かび、背景はリファレンス画像 3 のインディゴからコーラルへのグラデーション、同時にリファレンス画像 2 のティールとマゼンタのパウダーがスローモーションで外側へ爆発する。カメラは靴の周りを 45 度にわたって弧を描いて移動し、パウダーの軌跡が回転しながら落ちていく。迫力のあるスニーカー広告、ドラマチックなスタジオライティング、力強い風切り音。
何が混合され、モデルが何を発明したか。3 枚のリファレンス画像すべてが登場し、それぞれの役割を保っています:スニーカーは被写体、ティールとマゼンタのパウダーはそれを包むエフェクト、インディゴからコーラルへのグラデーションは紛れもなく背景です。私が指示したカメラの弧は見て取れます——靴は 5 秒間で画面に対して回転しています。3 枚の画像がここでまとまりを保ち、より曖昧なプロンプトなら濁ってしまう理由は:各リファレンス画像が文中で重複しない役割(被写体 / エフェクト / 背景)を担い、しかも背景では順番を飛ばして「画像 3」として参照するなど、インデックスで参照しているからです。4 枚を超えると、この規律はもはや任意ではなくなります——各画像に明確な役割を与えなければ、モデルは最も弱い 1 枚を静かに捨てます。1280*720、5 秒、約 $0.78。(このフレームが記事のカバーです。)
レシピ 4 — 縦型ソーシャル:マスコットが製品を紹介する
最後はソーシャル向けの 9:16 混合です:1 枚の画像がブランドマスコット、もう 1 枚がそれが売る製品。役割はキャラクターに製品を持たせ、縦型で、フィードにそのまま使える形にすることです。
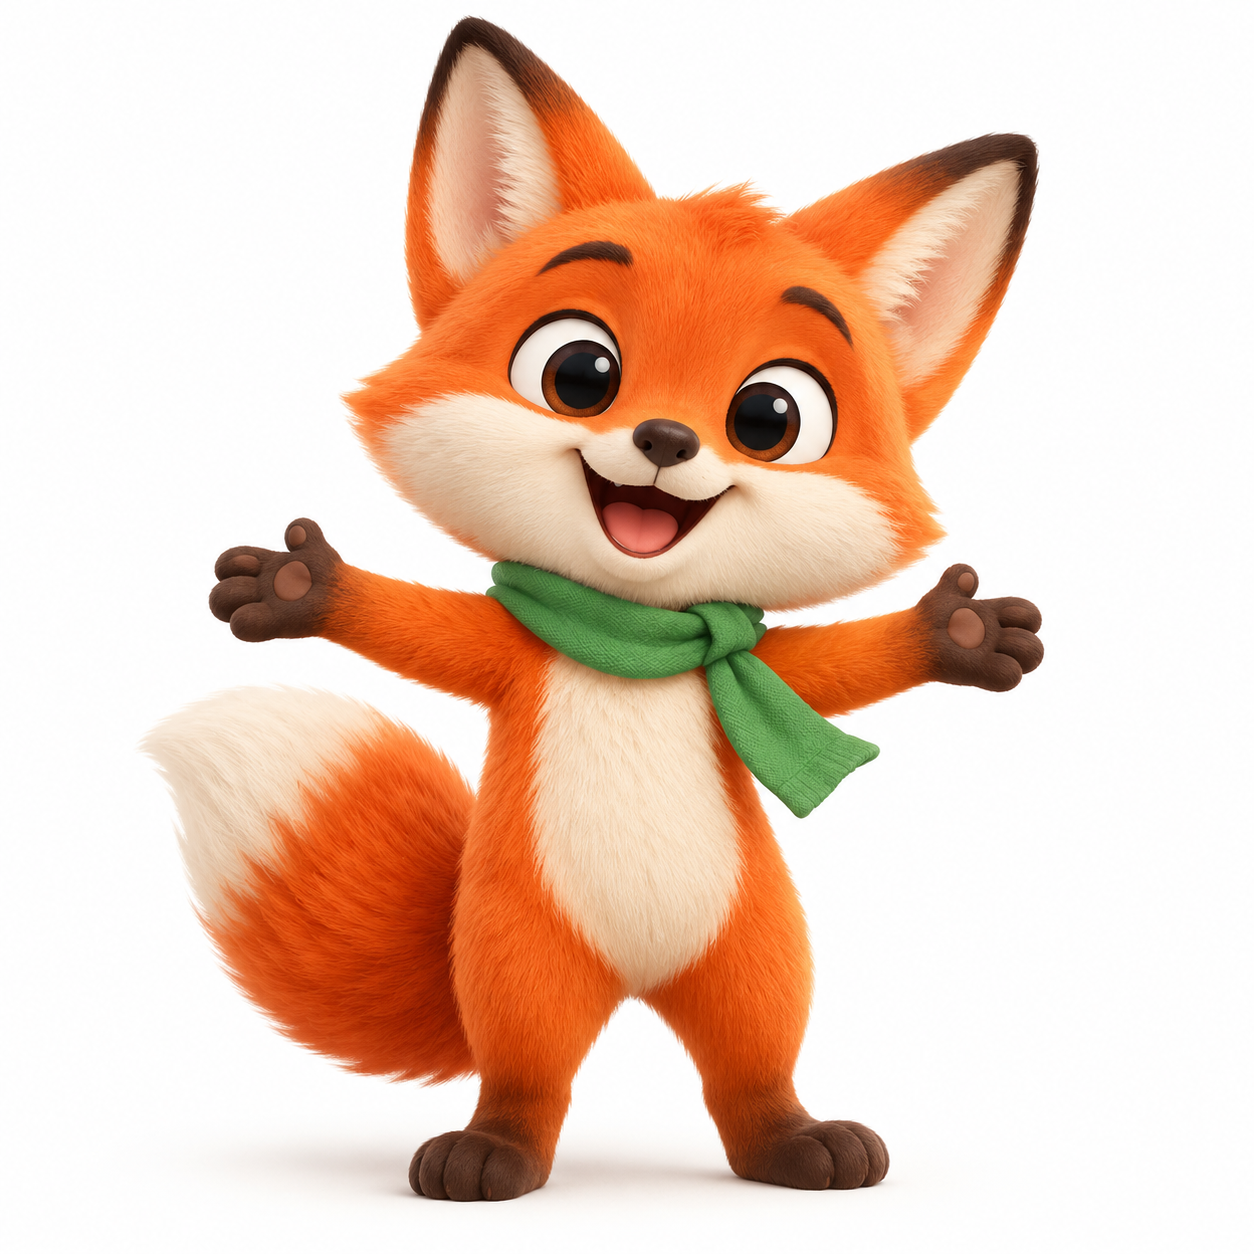
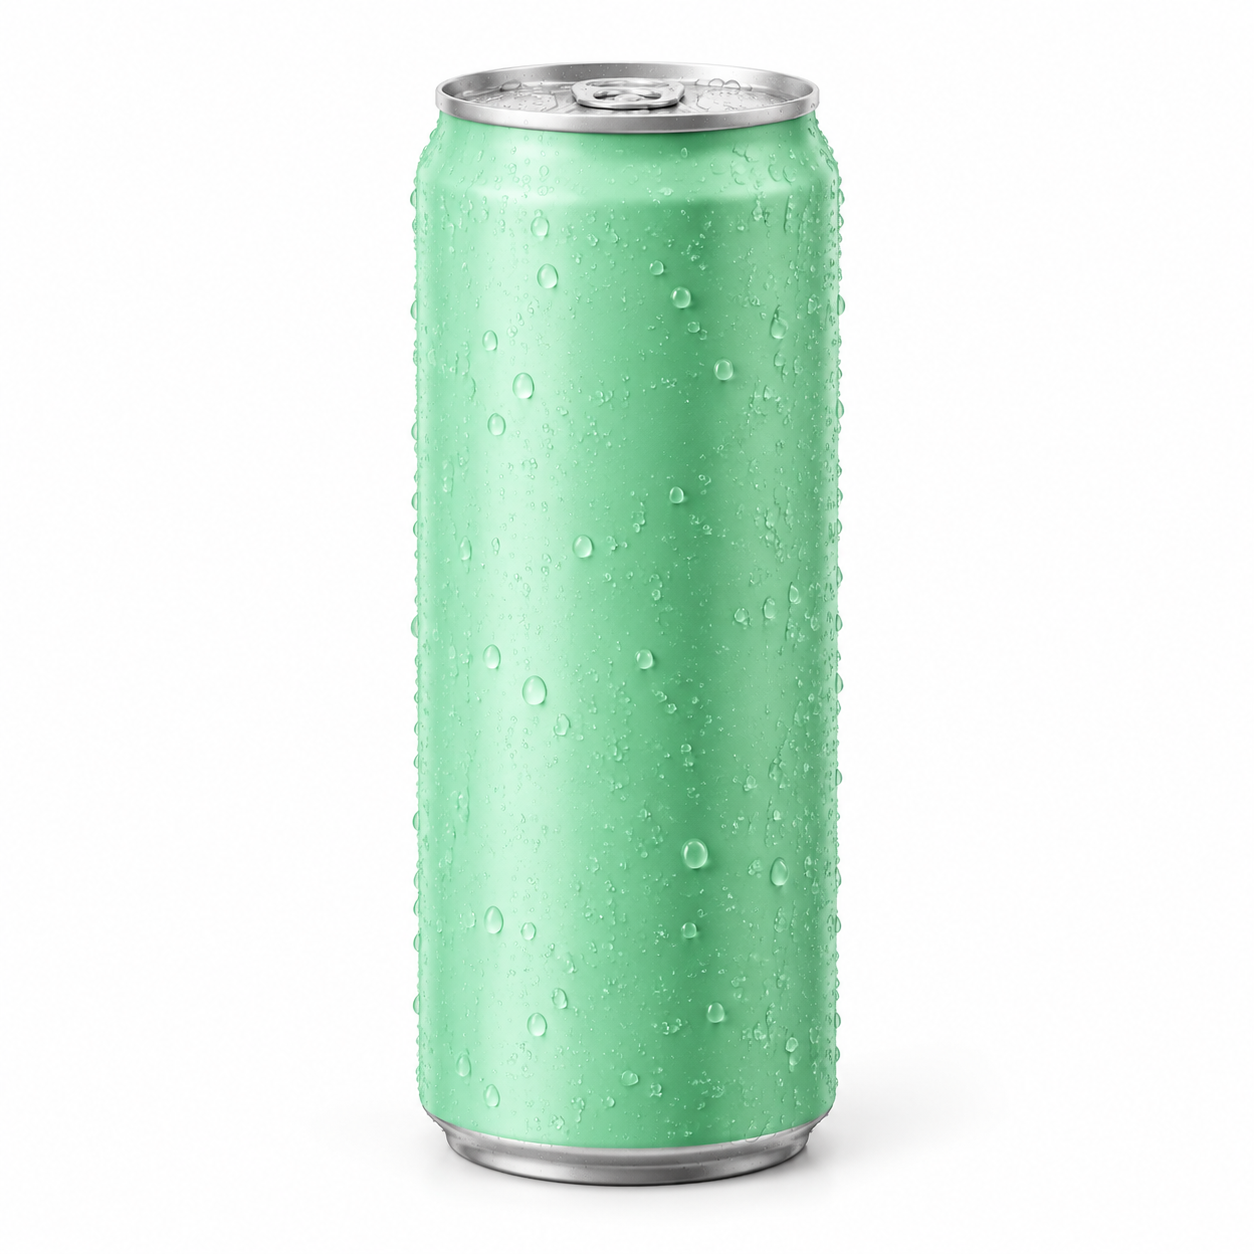
縦型ショット。リファレンス画像 1 のオレンジ色のカートゥーンキツネのマスコットが、リファレンス画像 2 のミントグリーンの炭酸水の缶を持ち上げ、元気な小さな跳ねでカメラに見せ、明るいポップカラーのスタジオ背景、紙吹雪が舞い落ちる。遊び心のあるソーシャル広告、力強く明るいライティング、活気ある炭酸の音。
何が混合され、モデルが何を発明したか。キツネは画像 1 のデザイン(オレンジの毛、緑のスカーフ、大きな目)を保ち、缶は画像 2 のマットなミントグリーンの表面を保ち、キャラクターの前足がそれを包み込んでいます——「持ち上げて……カメラに見せる」という動詞が 2 枚のリファレンス画像を 1 つの動作に結びつけ、2 つの物体が画面を共有するだけではありません。ポップカラーの背景と紙吹雪は発明されたものです。縦型にするには縦型の size(720*1280)を選ぶ必要があります;aspect_ratio フィールドはありません(詳細は後述)。4 秒、約 $0.62。
これらのレシピを実行して学んだこと
クレジットを使う前に知っておく価値のある 5 つのこと、すべてこの一連のテストから:
- インデックスによるバインドが鍵。ここでの各クリップは「リファレンス画像 N の X」に従いました。2 つの被写体を相互作用させたいときは、それらを並べて列挙するのではなく、動作に両者を結びつける動詞(「持ち上げる」「……の上に置く」)を与えましょう。
- あなたが物体を固定し、モデルがつなぎの組織を発明する。カウンター、部屋全体の光、紙吹雪、回転するパウダー——これらはどれもリファレンス画像にありません。「被写体がシーンに入る」場合にはこれは特性ですが、逆に、保持したいものは必ずリファレンス画像から来なければならないことも意味します。
- 納品ピクセルは公称の
sizeよりやや小さい。1920*1080は 1914×1084 で返り、1280*720は 1276×722、720*1280は 722×1276 です。ウェブには十分近いですが、下流で正確なサイズをハードコードしないでください。 - 出力は H.264 で、そのまま埋め込める。HEVC で納品する 4K 階層とは異なり、これらのクリップは再エンコードせずにインラインで再生できます——このページの各動画は API が直接返したファイルです。
- 「ネイティブオーディオ」は音声を生成しなかった。4 つのクリップはどれも無音、映像のみの MP4 で返りました——モデルに「ネイティブオーディオ」タグがあり、私のプロンプトに音の手がかり(「穏やかなカフェの環境音」「力強い風切り音」)が含まれていてもです。プラットフォーム自身の Q3 Mix サンプルクリップも無音です。音はポストで追加するか、音声トラックが譲れないなら明示的な音声入力を持つ階層を使ってください——Vidu Q4 Preview レシピ では音声リファレンスのワークフローを扱っています。
/v1/tasks であらゆるレシピを再現する
リファレンス動画生成は非同期タスク API で動作します:タスクを送信し、ステータスが success になるまでポーリングし、output[0].url からクリップをダウンロードします(この URL は短命です——すぐにファイルを保存してください)。
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-mix/reference-to-video",
    "input": {
      "prompt": "リファレンス画像 1 のドリッパーをリファレンス画像 2 のガラスポットの上に置く……",
      "reference_image_urls": [
        "https://your-host/dripper.png",
        "https://your-host/carafe.png"
      ],
      "duration": 5,
      "size": "1920*1080"
    }
  }'
# -> {"data":{"taskId":"tk-..."}}   その後 GET /v1/tasks/tk-... で status == "success" まで
import requests, time

H = {"Authorization": f"Bearer {TOKEN}"}
job = requests.post("https://api.hiapi.ai/v1/tasks", headers=H, json={
    "model": "vidu-q3-mix/reference-to-video",
    "input": {"prompt": PROMPT, "reference_image_urls": REFS,
              "duration": 5, "size": "1920*1080"},
}).json()["data"]["taskId"]

while True:
    t = requests.get(f"https://api.hiapi.ai/v1/tasks/{job}", headers=H).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("clip.mp4", "wb").write(requests.get(t["output"][0]["url"]).content)
レシピをコピーする前に知っておく価値のあるフィールドのルール:
reference_image_urlsは1〜7 枚の画像を受け付けます。8 枚目は400 maxItems: want 7を返します。durationは整数で、1 から 16 秒です。4.5や99のような浮動小数点数は送信時に拒否されます。- 形状は
aspect_ratioではなくsizeで設定します——aspect_ratio(またはresolution)を渡すと400 additional properties not allowedが返ります。10 個のsize値は 720 級と 1080 級の 2 階層にわたる 5 つのアスペクト比です;縦型には縦型の値、16:9 には横型の値を選んでください。 - 音声リファレンスのフィールドはありません——
reference_audio_urlsは拒否されます。音声サンプルで音声を駆動する必要があるなら、それは Q4 Preview 階層であり、Q3 Mix ではありません。 - 秒単位の課金(720 級 vs 1080 級)は 料金ページ にあります;ここでの 4 つのクリップはそれぞれ約 $0.62〜$0.93 かかりました。まず 720 級の
sizeで構図を反復し、その後 1080 で最終版を再実行してください。
よくある質問
Q3 Mix は何枚のリファレンス画像を混合できますか? 1 枚から 7 枚です。2 枚がよくあるケース(被写体 + シーン)です;上のスニーカーのレシピのように、各画像が明らかに異なる役割を担うなら、3 枚でもきれいに合成できます。4 枚を超えると、各リファレンス画像に明確で重複しない役割を与えなければ、モデルは最も弱い 1 枚を捨て始めます。
どの画像が被写体でどれが背景かをどう制御しますか?
インデックスで参照し、同じ文の中で役割を割り当てます:「リファレンス画像 1 のスニーカー……背景はリファレンス画像 3 の背景」。reference_image_urls 内の URL の順序がインデックス順です——画像 1 は最初の URL です。
Q3 Mix は自動で音を追加しますか? 私のテストでは追加しません。「ネイティブオーディオ」タグがあるにもかかわらず、4 つのクリップすべて——そしてプラットフォーム自身の Q3 Mix サンプルも——プロンプトに音の語彙が含まれていても無音の MP4 で返ってきました。Q3 Mix は映像のみの生成器として扱い、ポストで音声を追加するか、明示的な音声入力を持つ階層に切り替えてください。
4K やカスタムアスペクト比は可能ですか?
4K はありません——Q3 Mix は最高で 1080 級の size 値です。アスペクト比は size で選ぶ 5 つの形状(横型、縦型、正方形)のうちの 1 つです。4K や音声リファレンスが必要なら、Vidu Q4 Preview を使用してください。
Q3 Mix と Q3 Ad——どちらを選ぶべきですか?
呼び出しインターフェースはほぼ同じ(1〜7 枚の画像、同じ 10 個の size 値、音声入力なし)なので、プロンプトはほぼそのまま移植できます。製品広告が要件なら Q3 Ad を選んでください——スマートな編集とマーケティング向けのショットモーションにチューニングされています;汎用的な複数被写体の混合には Q3 Mix を選んでください。秒単位の料率は近いですが同一ではありません;料金ページを確認してください。
なぜ私の混合ではリファレンス画像が 1 枚無視されたのですか? ほぼ常にモデルの制限ではなくプロンプトのバインドの問題です。リファレンス画像が文中で明確な役割を持たないと、他のリファレンス画像と競合して負けます。動詞と位置を与え(「リファレンス画像 2 の缶を持ち上げる」)、競合するリファレンス画像は比率の点で距離を置きましょう。
試す準備はできましたか?vidu-q3-mix/reference-to-video モデルページ を開き、クイックスタートでキーを取得し、上のレシピを貼り付けて自分のリファレンス URL に置き換えてください。混合でカメラワークを計画したいですか?映画的なカメラムーブメントのプロンプト はそのままどれにも使えます。


